AI для финансиста
ChatGPT вместо ВПР и XLOOKUP: объединяем таблицы Excel и ищем данные в справочниках без формул

Каждый месяц я вижу одну и ту же картину: в таблице стоит ВПР, ссылка на справочник правильная, а часть строк возвращает #Н/Д. Начинается ручная чистка: лишний пробел в названии, ИНН числом вместо текста, дубль в справочнике. На это уходит полдня, а отчёт уже ждёт собственник. Меня зовут Натали Васильева, я эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO». С февраля 2023 года я помогаю финансистам и бухгалтерам внедрять нейросети в работу, через курс «AI-навыки финансиста» прошли 800+ выпускников, наши каналы читают 45 000 подписчиков в Telegram и 13 000 в канале «АИ с Софьей и Натали». Материал актуален на 31 августа 2026 года.
В этой статье показываю, как ChatGPT заменяет ВПР и XLOOKUP в объединении таблиц и поиске в справочниках. Внутри: принцип работы, шесть шагов подготовки, тринадцать готовых промптов, три кейса с реальными часами и рублями, сравнение моделей и жёсткие правила проверки результата.
Что такое ВПР и XLOOKUP и почему таблицы всё равно не сходятся
ВПР это функция вертикального поиска: она ищет значение в первом столбце диапазона и возвращает значение из указанной колонки той же строки. XLOOKUP это её более новая версия: ищет ключ в любом столбце, в любом направлении, умеет возвращать массив значений и не ломается, если в таблицу добавили столбец слева. Обе функции решают одну задачу: подтянуть данные из справочника в рабочую таблицу по ключу.
Формула ВПР выглядит так: =ВПР(B2;Справочник!$A$2:$D$100;3;ЛОЖЬ). Она берёт значение из B2, ищет его в первом столбце диапазона на листе «Справочник» и возвращает значение из третьего столбца. XLOOKUP записывается короче и устойчивее: =XLOOKUP(B2;Справочник!$A$2:$A$100;Справочник!$C$2:$C$100). Официальное описание обеих функций есть в документации Microsoft: VLOOKUP и XLOOKUP.
Проблема не в формулах. Проблема в данных. ВПР ищет точное совпадение, а в реальных выгрузках точных совпадений мало. Я разбирала с учениками сотни таблиц за последние три года, и вот что повторяется чаще всего:
- Лишний пробел или символ. «ООО Ромашка» в одной таблице и «ООО Ромашка» с двойным пробелом в другой. ВПР не видит разницы между ними и возвращает #Н/Д.
- Разный формат ключа. ИНН записан числом в одной выгрузке и текстом с пробелами в другой. Число 7701234567 и текст «7701234567» это разные значения для точного поиска.
- Разные написания названий. «Ромашка» и «Ромашка ООО», «ЗАО Ромашка» и «АО Ромашка» после перерегистрации. ВПР считает их разными строками.
- Дубли в справочнике. В справочнике контрагентов два раза встречается один ИНН. ВПР берёт первое совпадение, и неизвестно, какое из них верное.
- Поиск по нескольким условиям. Нужно подтянуть цену по паре «артикул + период», а ВПР умеет искать только по одному ключу.
Каждая из этих ситуаций превращает «поставить формулу за 15 минут» в «чистить данные полдня». В итоге люди либо вручную проставляют значения, либо строят вспомогательные колонки с СЖПРОБЕЛЫ, ПОДСТАВИТЬ и ЕСЛИОШИБКА. Формула вырастает в монстра, который через месяц никто не может прочитать.
ChatGPT решает эту задачу иначе. Вместо формулы вы даёте модели файлы и правило соединения, а она возвращает готовую объединённую таблицу. Она не ищет точное совпадение, а понимает смысл: нормализует ключи, находит пары по описанию, показывает несовпадения. Подробный разбор того, как ChatGPT сжимает похожие операции до минуты, я делала в статье про семь операций в Excel, там объединение таблиц стоит первой в списке.
Когда ВПР и XLOOKUP остаются нужны
Честная позиция, которую я повторяю на каждом разборе: нейросеть не отменяет формулы полностью. Есть задачи, где ВПР и XLOOKUP остаются лучшим инструментом.
- Живые отчёты с обновлением. Если справочник меняется каждую неделю, а отчёт должен пересчитываться сам, формула нужна. ChatGPT возвращает результат на момент запроса, а формула обновляется при каждом открытии файла.
- Постоянная связь между листами. Когда контрагент добавился в справочник, ВПР в отчёте подтянет его автоматически. С нейросетью такое объединение придётся запускать заново.
- Маленькие таблицы на десятки строк. Поставить ВПР за минуту проще, чем грузить файлы в диалог. Нейросеть окупается там, где строк сотни и больше, или где есть грязные данные.
- Работа в офлайн-контуре. Если файлы нельзя выгружать наружу, остаются формулы и локальные инструменты.
Правило простое: формула для повторяющегося процесса, нейросеть для разовой задачи и сложных данных. В 2026 году связка «формулы в Excel + ChatGPT для объединений и проверки» закрывает оба случая. Сравнение подходов сведено в таблицу.
| Параметр | ВПР | XLOOKUP | ChatGPT |
|---|---|---|---|
| Что делает | Ищет в первом столбце, берёт из заданной колонки | Ищет в любом столбце и направлении | Читает таблицы как данные, соединяет по правилу |
| Точное совпадение | Требует | Требует | Может искать по смыслу |
| Разный формат ключа | Ошибка | Ошибка | Нормализует ключ |
| Дубли в справочнике | Берёт первое совпадение | Берёт первое совпадение | Показывает все варианты |
| Несовпадения | Возвращает #Н/Д | Возвращает #Н/Д | Собирает в список с причиной |
| Обновление данных | Автоматическое | Автоматическое | Нужен повторный запуск |
| Несколько условий | Только через вложенность | Только через вложенность | Описываются словами |
| Где уместен | Живые отчёты | Живые отчёты | Разовые объединения, грязные данные |
Как ChatGPT заменяет ВПР и XLOOKUP: принцип работы без формул
ChatGPT работает с таблицами как аналитик, а не как калькулятор. Он загружает файлы Excel, CSV и PDF, читает их содержимое и выполняет задачу, которую вы описали словами. Для объединения таблиц схема такая: вы прикрепляете две таблицы, объясняете, что лежит в каждой колонке и по какому ключу соединять, и модель возвращает третью таблицу, где строки одной дополнены данными из другой.
Принцип работы в четырёх шагах:
- Загрузка. Прикрепляете к диалогу на chatgpt.com файлы .xlsx или .csv. Можно приложить до нескольких файлов сразу, модель читает их как данные, а не как картинки.
- Описание структуры. Одним абзацем пишете, что в первой таблице (например, выписка за месяц) и что во второй (справочник контрагентов с реквизитами). Называете ключ: ИНН, артикул, номер договора.
- Правило соединения. Указываете, какие колонки переносить и что делать с несовпадениями: помечать отдельно, заполнять пустотой или искать по похожему написанию.
- Результат. Модель возвращает объединённую таблицу с колонками из обеих исходных и список строк, которые не нашли пару.
Разница с ВПР видна сразу на типовом примере. ВПР требует, чтобы ключи совпадали точно, иначе #Н/Д. ChatGPT при объединении по ИНН сам приводит ключи к единому формату: убирает пробелы, переводит числа в текст, находит дубли. Если написания контрагентов отличаются, вы можете отдельной инструкцией попросить сопоставить по нормализованному названию.
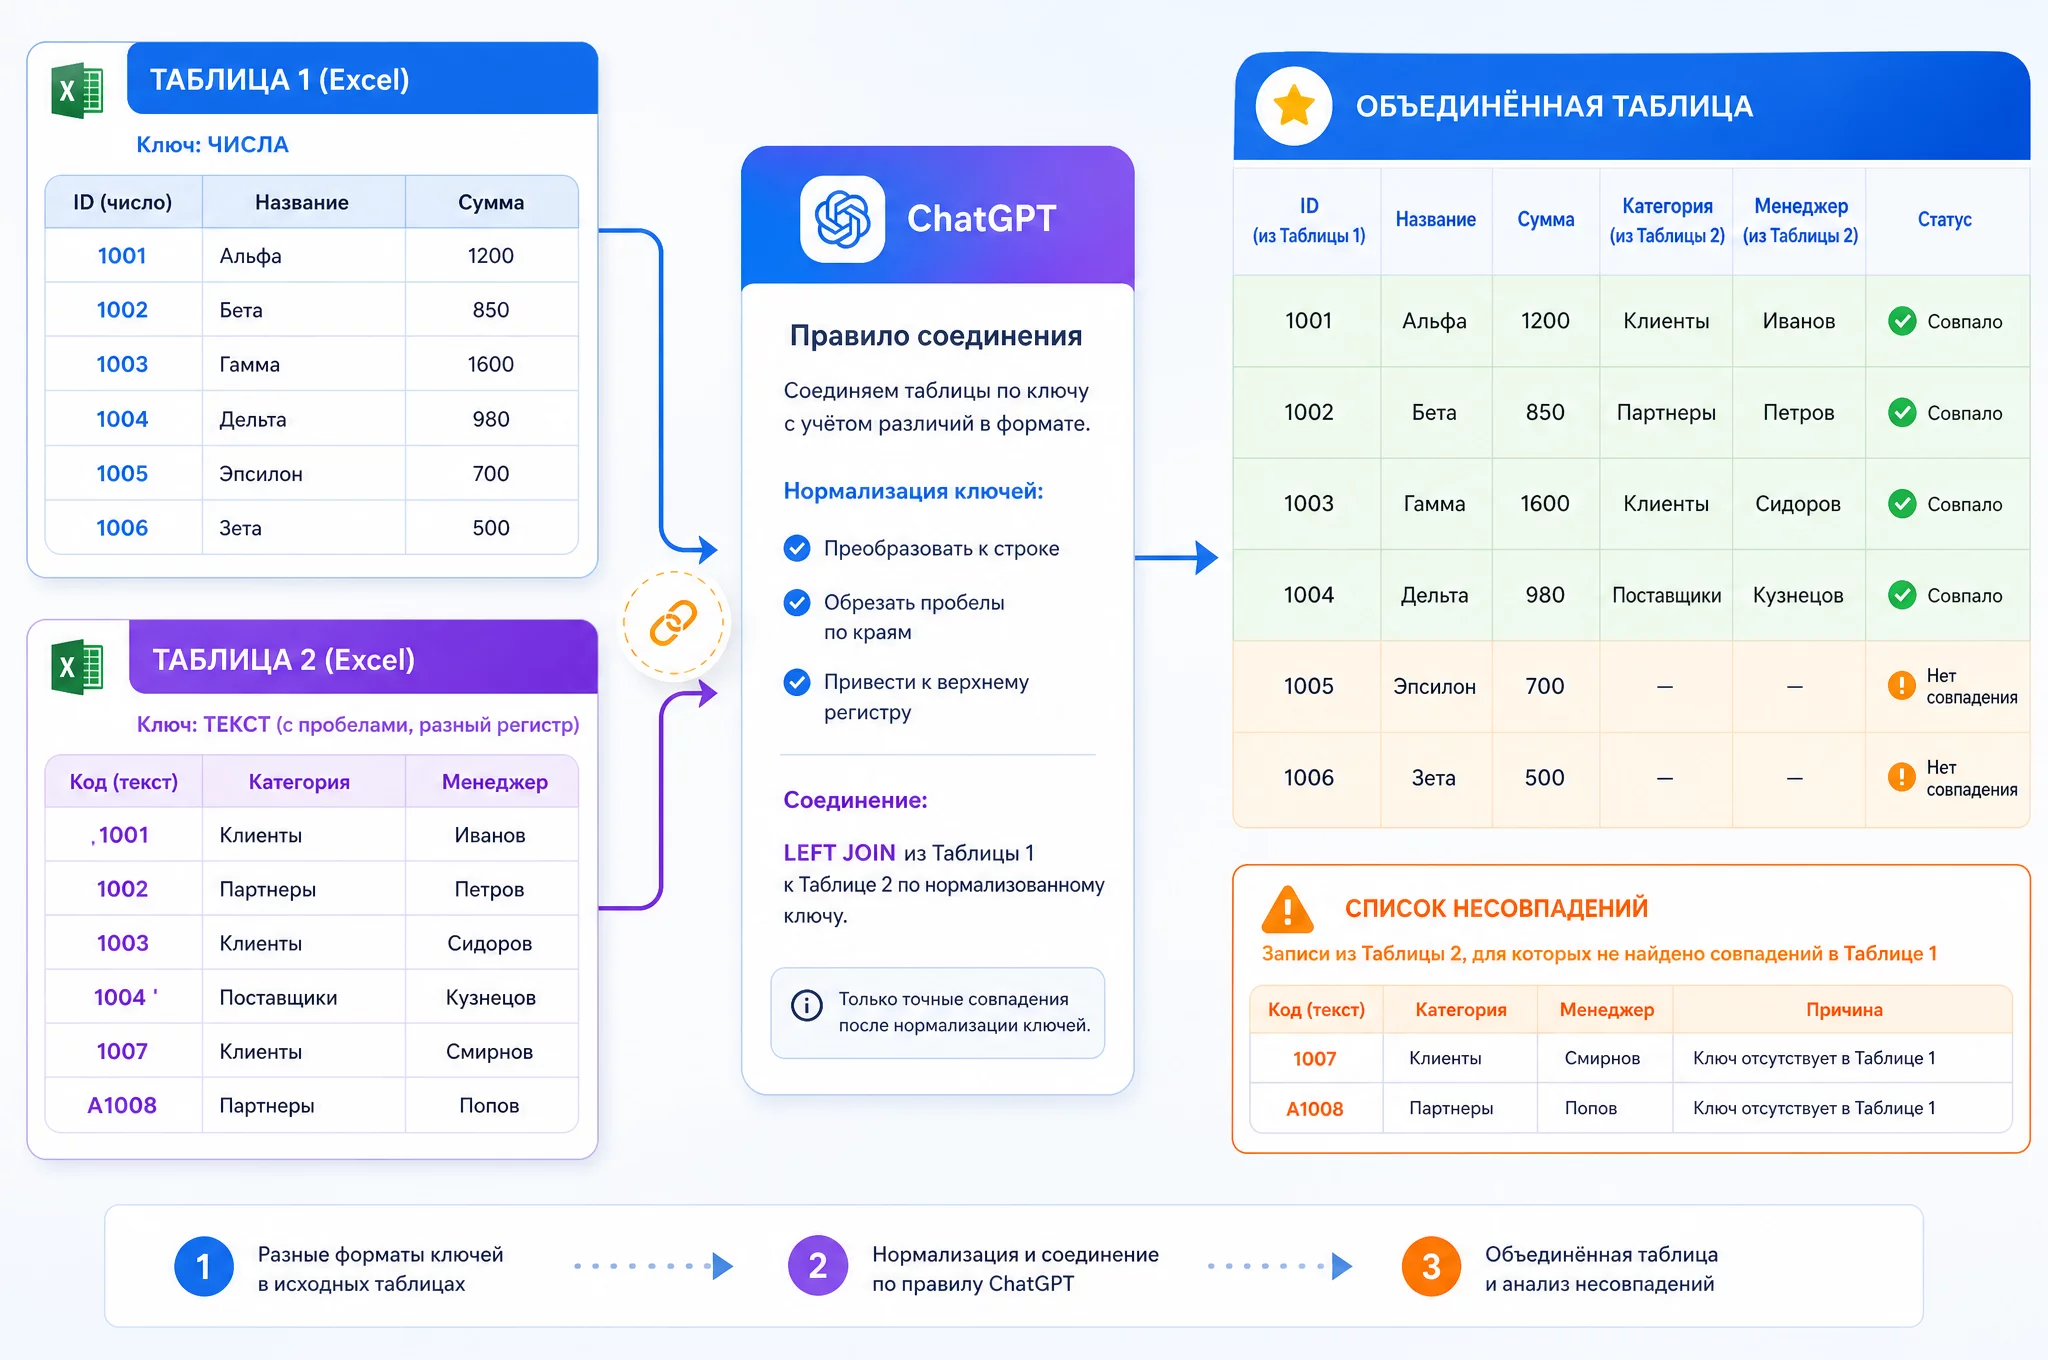
Встроенные формулы не исчезают. Для постоянных отчётов, где связь между листами должна обновляться автоматически, ВПР и XLOOKUP остаются рабочим инструментом. ChatGPT закрывает разовые задачи, сложные случаи с грязными данными и проверку результата. То есть нейросеть не отменяет формулы, а снимает с них самую болезненную часть: подготовку данных и разбор несовпадений.
Дальше показываю подготовку таблиц, от которой зависит 80 процентов качества результата.
Как подготовить таблицы к объединению: ключ, нормализация, обезличивание
Половина успеха объединения решается до загрузки файлов в нейросеть. Три вещи: чистый ключ, нормализованные данные, обезличенные поля. Каждая закрывает свой тип ошибок, и все три вместе делают результат предсказуемым.
Чистый ключ. Ключ это поле, по которому вы соединяете таблицы: ИНН, артикул, номер договора, код клиента. В обеих таблицах ключ должен лежать в отдельной колонке и в одном формате. ИНН везде текстом с одинаковым количеством цифр, даты в формате ГГГГ-ММ-ДД, артикулы без пробелов. Если ключ в одной таблице число, а в другой текст, ВПР выдаст ошибку, и ChatGPT тоже споткнётся, пока вы не приведёте формат. За пять минут в Excel убираем пробелы функцией СЖПРОБЕЛЫ и проверяем дубли через условное форматирование.
Нормализация. Одинаковые сущности должны называться одинаково. «Выручка» и «Реализация», «ООО Ромашка» и «Ромашка ООО», «ИП Иванов» и «Иванов И.И.». Если названия не сведены к общему виду, ни формула, ни нейросеть не найдут пару. Для справочника контрагентов я советую добавить колонку «Ключ поиска»: единый вид названия без организационно-правовой формы, или ИНН, если он есть. Тогда объединение идёт по колонке «Ключ поиска», а не по названию.
Обезличивание. Суммы оставляем, названия контрагентов, ИНН, счета и ФИО заменяем масками. Название «ООО Ромашка» становится «Контрагент 1», ИНН «7701234567» становится «ИНН_1». В настройках платного тарифа выключаем обучение на данных. Документы под NDA и банковскую тайну в публичные тарифы не грузим, для них корпоративные тарифы или локальные модели. Отдельный материал по этой теме есть в статье про обезличивание данных, там пошаговая инструкция и шаблон маскирования.
Дубли в справочнике: главный враг ВПР
Отдельно про дубли, потому что это самая коварная проблема при поиске в справочнике. ВПР и XLOOKUP при дубле ключа молча берут первое совпадение. Никакой ошибки не возникает, просто может подтянуться не тот договор, не тот менеджер, не та цена. Вы узнаете о проблеме, только когда сверите результат с реальностью.
Как дубли попадают в справочник: контрагент зарегистрирован дважды с разными названиями, но одним ИНН; прайс поставщика содержит несколько строк с одним артикулом и разными ценами на разные периоды; в 1С после объединения баз остались повторные карточки. Всё это не видно на глаз, пока вы не посчитаете количество по каждому ключу.
Промпт для сплошной проверки дублей перед объединением:
Проверь справочник на дубли [загружаете файл].

Задачи:
1. По ключевой колонке [ИНН] сгруппируй все значения
2. Покажи ключи, которые встречаются больше одного раза
3. Для каждого дубля покажи все строки с этим ключом, чтобы
   было видно, чем они отличаются
4. Оцени, какой из дублей актуальный: по дате, по заполненности
   полей, по сумме договора
5. Дай рекомендацию: какой дубль оставить, какой удалить или
   пометить неактивным

Формат: таблица дублей с колонками ключ, число повторов, строки,
рекомендация. В конце сводка по количеству дублей.
Такой промпт превращает скрытую проблему в список задач. За десять минут вы знаете, сколько дублей в справочнике, чем они отличаются и какой оставить. Это закрывает половину ошибок объединения ещё до запуска главного промпта.
Промпт для нормализации ключей, который я запускаю до объединения:
Перед тобой таблица со справочником [загружаете файл].

Подготовь ключ для объединения:
1. Найди колонку с ИНН или названием контрагента
2. Приведи ИНН к единому формату: только цифры, без пробелов
   и дефисов, все значения текстом
3. В названиях убери лишние пробелы и кавычки
4. Найди дубли по ИНН: выведи список повторяющихся значений
   и количество повторов
5. Добавь колонку «Ключ поиска»: ИНН без форматирования,
   а если ИНН нет, то название в нижнем регистре без пробелов

Формат ответа: таблица с колонками исходное значение, ключ поиска,
статус (ок, дубль, нет ИНН). Дубли и пропуски выведи отдельным блоком.
Этот промпт готовит справочник за пару минут и сразу показывает, сколько дублей и пропусков в данных. Всё, что он нашёл, чинится до объединения, а не после. Для полного разбора того, как ChatGPT чистит грязные выгрузки из 1С и банка, смотрите статью про подготовку данных к объединению, там тот же принцип на регистрах бухгалтерии.
Настройка ChatGPT под объединение таблиц за 10 минут
Перед первым объединением стоит настроить персонализацию. Это влияет на качество всех последующих задач, а пропускают этот шаг почти все, кто начинает с разовых промптов.
Идём в Settings → Personalization → Custom Instructions и вставляем такой текст:
Я финансовый специалист. Работаю с таблицами Excel: объединяю данные,
ищу значения в справочниках, сверяю выгрузки.

Правила работы:
- при объединении таблиц всегда показывай число строк до и после
- если ключ не совпал, не выдумывай пару, выведи в несовпадения
- нормализуй ключи перед соединением, но показывай, что изменил
- никогда не выдумывай цифры, которых нет в загруженных файлах
- для проверки итогов используй Python и показывай ход расчёта
- если данных не хватает, перечисли, чего именно не хватает
- язык ответа: деловой русский, без канцелярита
Этот текст закрывает главный риск работы с нейросетью в финансах: фабрикацию данных. Модель честно сигнализирует о пробелах, а не дозаполняет их воображением. Второй шаг в настройке это отключение обучения на данных: Settings → Data Controls, выключаем тумблер «улучшить модель для всех». Обязательно до любой работы с корпоративными файлами.
Доступ к chatgpt.com из России требует специальных средств подключения. Какой способ выбрать, каждый решает с учётом требований своей компании и службы безопасности. Работайте напрямую через официальный сайт, а не через сторонние боты, которые часто под видом ChatGPT используют дешёвые модели и не дают гарантий по данным. Пользоваться нейросетями из России не запрещено.
Живой пример: прайс поставщика и заказ на закупку
Разберу процесс на двух таблицах, чтобы стало видно, как промпты работают вместе. Таблица 1 это прайс поставщика на 8 000 строк: артикул, наименование, цена, наличие. Таблица 2 это заказ на закупку на 350 строк: артикул, количество, менеджер. Задача: подтянуть в заказ цену и наличие из прайса, потом найти позиции, где цена в заказе не совпадает с прайсом.
Сначала нормализация. В прайсе артикулы записаны как «A-1047», в заказе как «A1047». Без приведения ключа не соединится ни одна строка. Промпт нормализации убирает дефис из всех артикулов и выводит список из 12 дублей в прайсе: два раза повторяется артикул «B-2100» с разными ценами. Дубли убираем до объединения, оставляем актуальную цену.
Потом объединение. Промпт соединения по артикулу возвращает таблицу, где у 338 строк из 350 есть цена и наличие, а 12 строк не нашли пару. Несовпадения разбираются промптом группировки: 9 артикулов в заказе сняты с производства и отсутствуют в прайсе, 3 артикула в заказе записаны с опечаткой.
Дальше критический промпт. Пересчёт на Python показывает, что сумма заказа по прайсу равна 1 847 500 рублей, а сумма по ценам из заказа 1 761 400 рублей. Разница 86 100 рублей это те самые 12 позиций без пары и 4 позиции, где менеджер вручную занизил цену. Находят четыре строки с заниженной ценой на общую сумму 86 000 рублей, это кейс 3 из раздела ниже.
Весь цикл занимает час: десять минут нормализация, двадцать минут объединение, десять минут разбор несовпадений, двадцать минут проверка на Python. Без нейросети ручное объединение прайса и заказа через ВПР заняло бы полдня, и часть расхождений осталась бы незамеченной, потому что ВПР просто не вернул бы значения по позициям с разным форматом артикула.
Готовый промпт для объединения двух таблиц по ключу
Когда таблицы подготовлены, запускаем объединение. Это главный промпт статьи, он заменяет ВПР и XLOOKUP в типовой задаче. Сохраните его в заметки, в следующий раз просто подставите названия колонок.
Объедини две таблицы [загружаете файл 1 и файл 2].

Таблица 1: [опишите, что лежит в колонках, например выписка банка
за июль: дата, контрагент, ИНН, назначение, сумма]
Таблица 2: [опишите, что лежит в колонках, например справочник
контрагентов: ИНН, название, договор, менеджер]

Правило объединения:
1. Ключ соединения: колонка [ИНН] в обеих таблицах
2. Приведи ключ к единому формату перед соединением
3. Для каждой строки таблицы 1 найди пару в таблице 2
4. Перенеси в результат колонки из таблицы 2: [название, договор,
   менеджер]
5. Строки без пары не теряй, помести в отдельный лист «Несовпадения»
   с причиной: нет в справочнике, дубль, разный формат ключа
6. Если по одному ключу несколько совпадений в справочнике, выведи
   все варианты в отдельный блок

Формат ответа:
- сводка: сколько строк в таблице 1, сколько нашло пару, сколько нет
- объединённая таблица
- лист «Несовпадения» с причинами

Не выдумывай значения, которых нет в файлах.
Если данных не хватает, перечисли, чего именно не хватает.
Этот промпт делает три вещи, которых ВПР не умеет: приводит ключ к единому формату, не теряет строки без пары и показывает причины несовпадений. Вместо #Н/Д вы получаете список «нет в справочнике, 14 строк» и понимаете, что с ним делать.
Важный момент: промпт требует описать структуру таблиц. Без описания модель гадает, что означают колонки, и может соединить не то. Пять минут на описание структуры окупаются точностью результата. Если вы не знаете, как правильно описать колонки, сначала попросите модель саму описать файлы:
Опиши оба загруженных файла:
1. Сколько строк и колонок в каждом
2. Названия колонок и пример значений из первых трёх строк
3. Какая колонка может быть ключом для объединения
4. Есть ли дубли и пустые значения в колонке-ключе

Не выполняй объединение. Только опиши структуру.
Этот приём экономит итерации: вы видите, как модель поняла файлы, и при необходимости уточняете до объединения. Он же помогает найти ошибки, которые вы сами не заметили: пустую колонку, дубль в ключе, лишний лист. Работа с таблицей на русском языке через вопросы подробно разобрана в статье про вопросы по таблице без формул.
Как искать данные в справочниках без формул
Объединение двух таблиц это частный случай более широкой задачи: поиск данных в справочнике. Вместо ВПР, который тянет значение из справочника по точному ключу, вы формулируете запрос словами, и ChatGPT возвращает ответ таблицей.
Типовые запросы, которые закрывают 90 процентов задач поиска:
- Подтянуть реквизиты. «Возьми ИНН из выписки, найди в справочнике контрагентов и верни название, договор и менеджера». Это прямой аналог ВПР.
- Найти по нескольким условиям. «Найди цену, где артикул такой-то и период такой-то». XLOOKUP с вложенным условием, только без формулы.
- Сопоставить по похожему написанию. «В одной таблице контрагент „Ромашка“, в другой „ООО Ромашка“. Соедини по смыслу и покажи пары». Там, где ВПР даёт #Н/Д, нейросеть находит пару.
- Проверить, чего не хватает. «Какие контрагенты из реестра отсутствуют в справочнике?» Это обратный поиск, который руками делается редко и долго.
Промпт для поиска в справочнике по нескольким условиям:
В справочнике [загружаете файл] хранятся цены поставщиков.
Колонки: артикул, период, цена, наличие.

Задачи:
1. Для списка запросов [загружаете файл с артикулами и периодами]
   найди цену и наличие по паре артикул + период
2. Если по паре нет точного совпадения, ищи ближайший период
   в пределах того же месяца
3. Если артикула нет вообще, помести строку в список «Нет в
   справочнике»
4. Проверь, что для каждого запроса найдено не больше одного
   значения, дубли покажи отдельно

Формат: таблица с колонками артикул, период, цена, наличие, статус.
В конце сводка: сколько найдено, сколько нет, сколько дублей.
Поиск по нескольким условиям это самая частая причина, по которой люди отказываются от ВПР и строят многоступенчатые конструкции. ChatGPT решает её одним промптом. Сложные формулы и Lambda-функции, которые остаются нужны для постоянных отчётов, я разбирала в статье про продвинутую автоматизацию Excel.
Для поиска с нечётким совпадением, когда названия различаются, добавьте в промпт правило приведения:
Соедини две таблицы по названию контрагента [загружаете файл 1
и файл 2].

Правила приведения названий перед соединением:
1. Убери организационно-правовую форму: ООО, ЗАО, АО, ИП, ОАО
2. Приведи к нижнему регистру
3. Убери пробелы, кавычки, скобки и знаки препинания
4. Сократи слова-маркеры: «Общество с ограниченной
   ответственностью» к «ооо» и так далее
5. Соедини по приведённому названию

Покажи пары, которые соединились по приведённому ключу, отдельным
списком, чтобы человек мог проверить. Несовпадения выведи с
причиной: разное название, нет пары, дубль.
Такой промпт закрывает ситуацию, ради которой раньше строились отдельные макросы. Пять минут на описание правил приведения, и справочник сходится даже при вольных написаниях. Подробнее про то, как нейросеть понимает и чистит такие данные, в статье про промпты для бухгалтера.
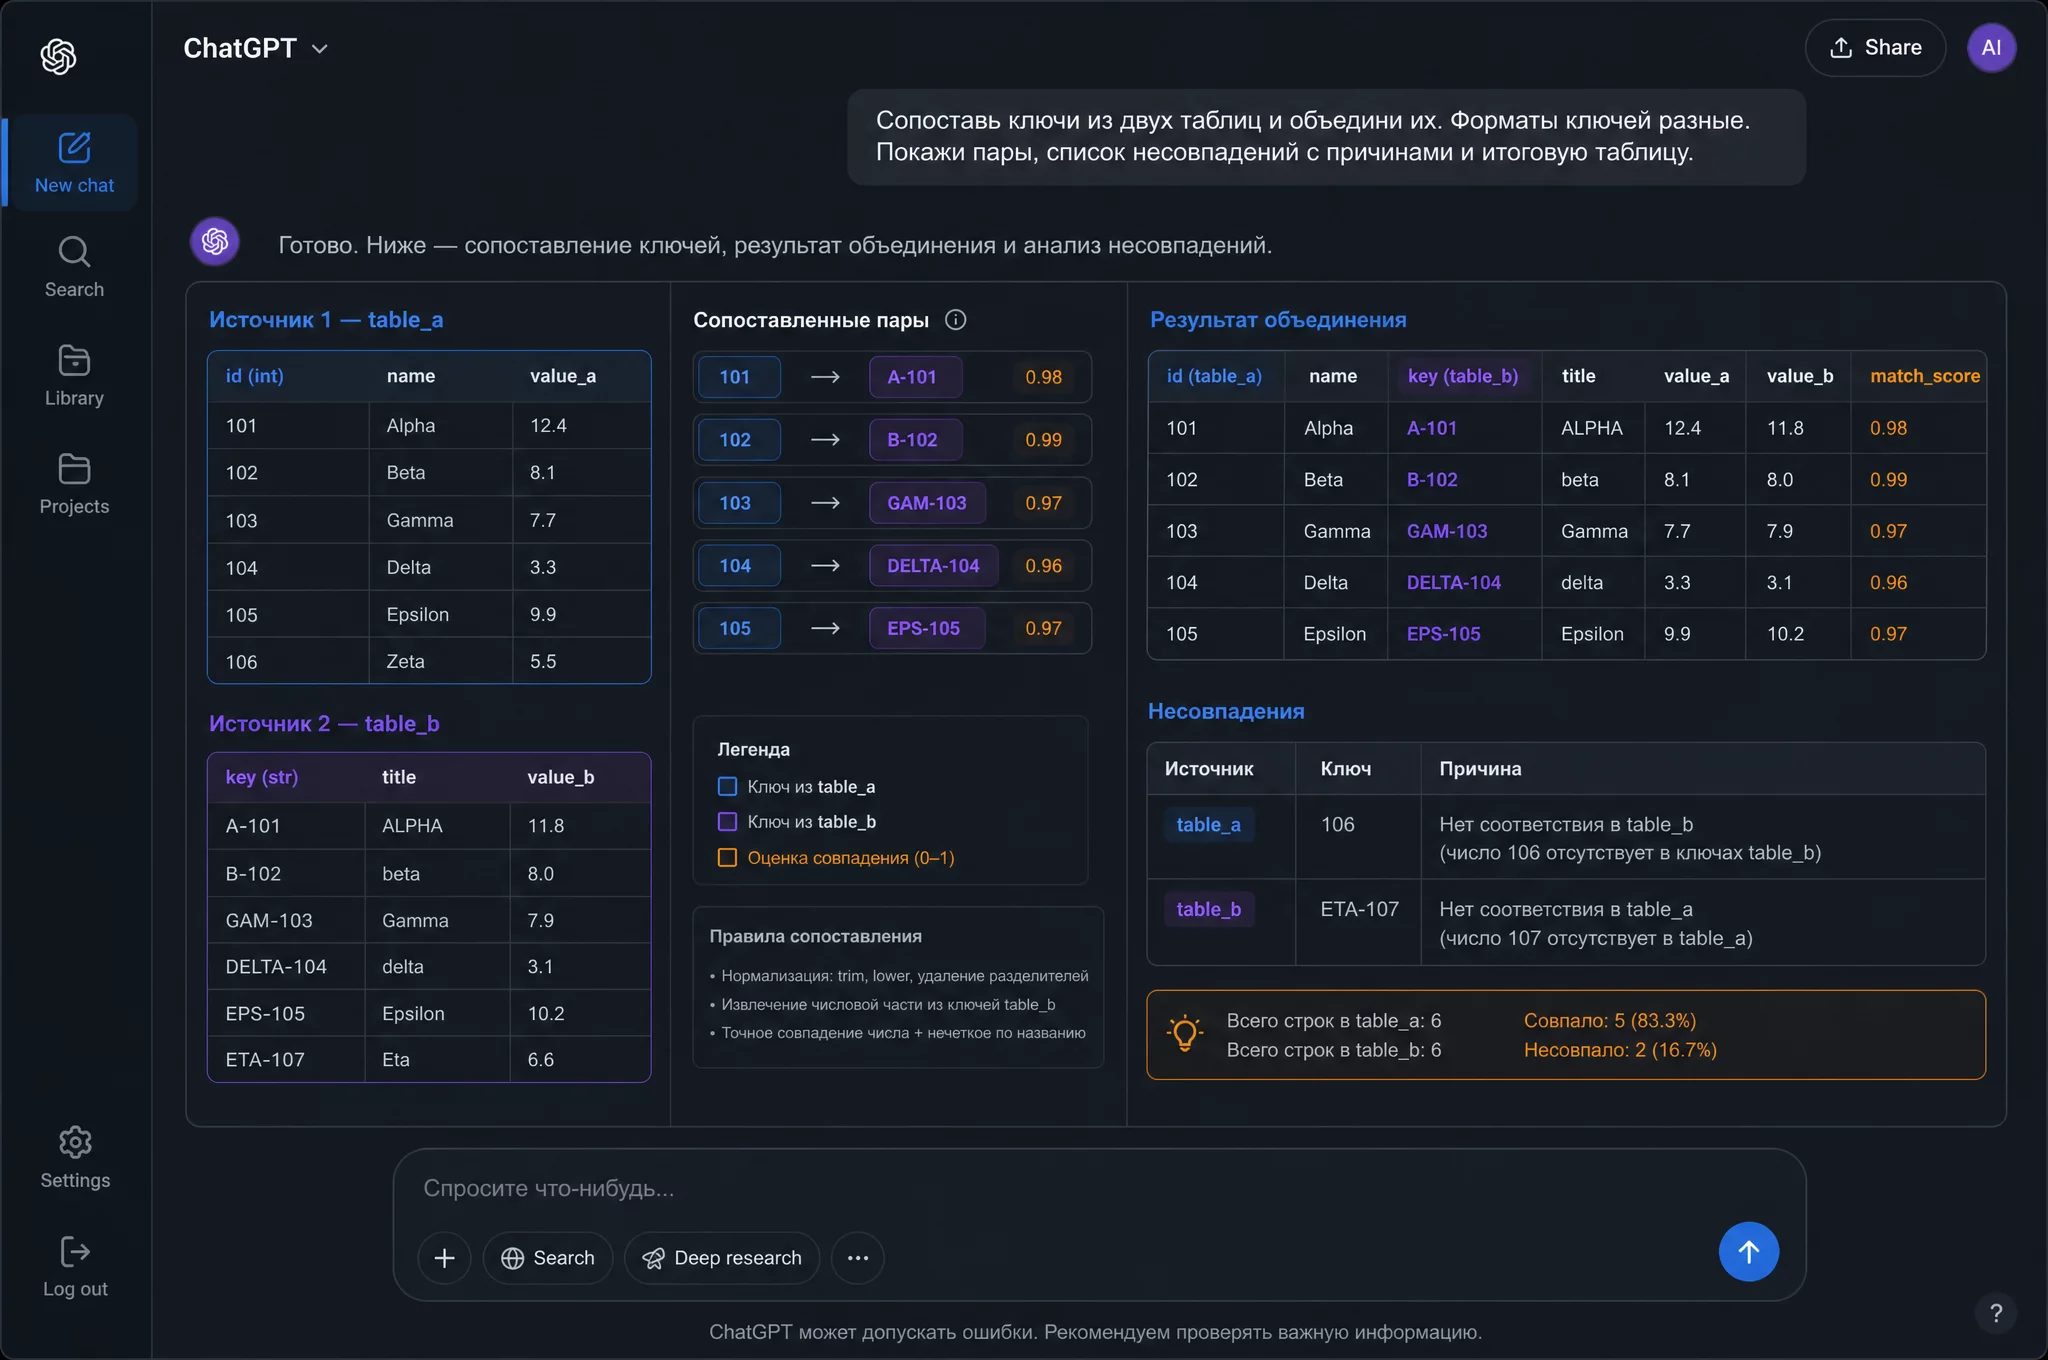
Готовый промпт объединения не требует точного совпадения ключей, если вы задали правила приведения. В этом его главное отличие от ВПР, который пасует перед любой мелочью вроде лишнего пробела.
Как работать с большими справочниками: нарезка и лимиты
Вопрос, который я слышу на каждом разборе: а если справочник на 50 000 строк, нейросеть потянет? Отвечаю честно: современные модели принимают файлы с десятками тысяч строк, но чем больше данных в одном запросе, тем выше риск, что модель потеряет фокус или упрётся в лимит. Поэтому для больших справочников я использую нарезку.
Принцип нарезки простой: режем файл на части по осмысленному признаку, обрабатываем каждую часть отдельно, потом собираем результаты. Осмысленный признак это период, первая буква названия, диапазон ИНН или филиал. Нарезка сохраняет структуру колонок, чтобы потом можно было склеить результаты в одну таблицу.
Промпт для нарезки справочника перед объединением:
Файл справочника слишком большой для одного запроса [загружаете файл].
Проверь, можно ли разделить его на части без потери данных.

Задачи:
1. Посчитай число строк и колонок
2. Предложи признаки для нарезки: период, диапазон ИНН, первая
   буква названия, регион, филиал
3. Покажи, сколько строк попадает в каждую часть
4. Проверь, что ключевая колонка не разрывается: один ключ должен
   целиком лежать в одной части
5. Дай инструкцию, как разрезать файл в Excel на части
   (сводная по фильтру или Power Query)

Формат: таблица признаков нарезки с количеством строк в каждой
части и рекомендация, какой признак выбрать.
Для справочника на 50 000 строк нарезка по диапазону ИНН даёт пять частей по 10 000. Каждая часть объединяется с рабочей таблицей отдельным промптом, результаты склеиваются, и критический промпт проверяет, что общее число строк сошлось. Это прибавляет полчаса к процессу, но позволяет работать с файлами любого размера.
Второй способ упростить большие файлы это выгрузка в CSV без оформления. Файл CSV в несколько раз меньше по размеру, чем xlsx с форматами и стилями, и модель читает его быстрее и точнее. Для справочника достаточно одного листа с колонками, всё лишнее оформление в расчёт не берём.
Третий приём это работа по одному ключевому полю. Если в большой таблице нужно подтянуть только одну колонку из справочника, не тащим весь справочник в диалог. Выгружаем из него только ключ и нужную колонку, объединяем по ним, потом результат переносим обратно в исходник. Меньше данных, меньше шансов на ошибку, быстрее ответ.
Как объединить выгрузки из 1С, банка и CRM
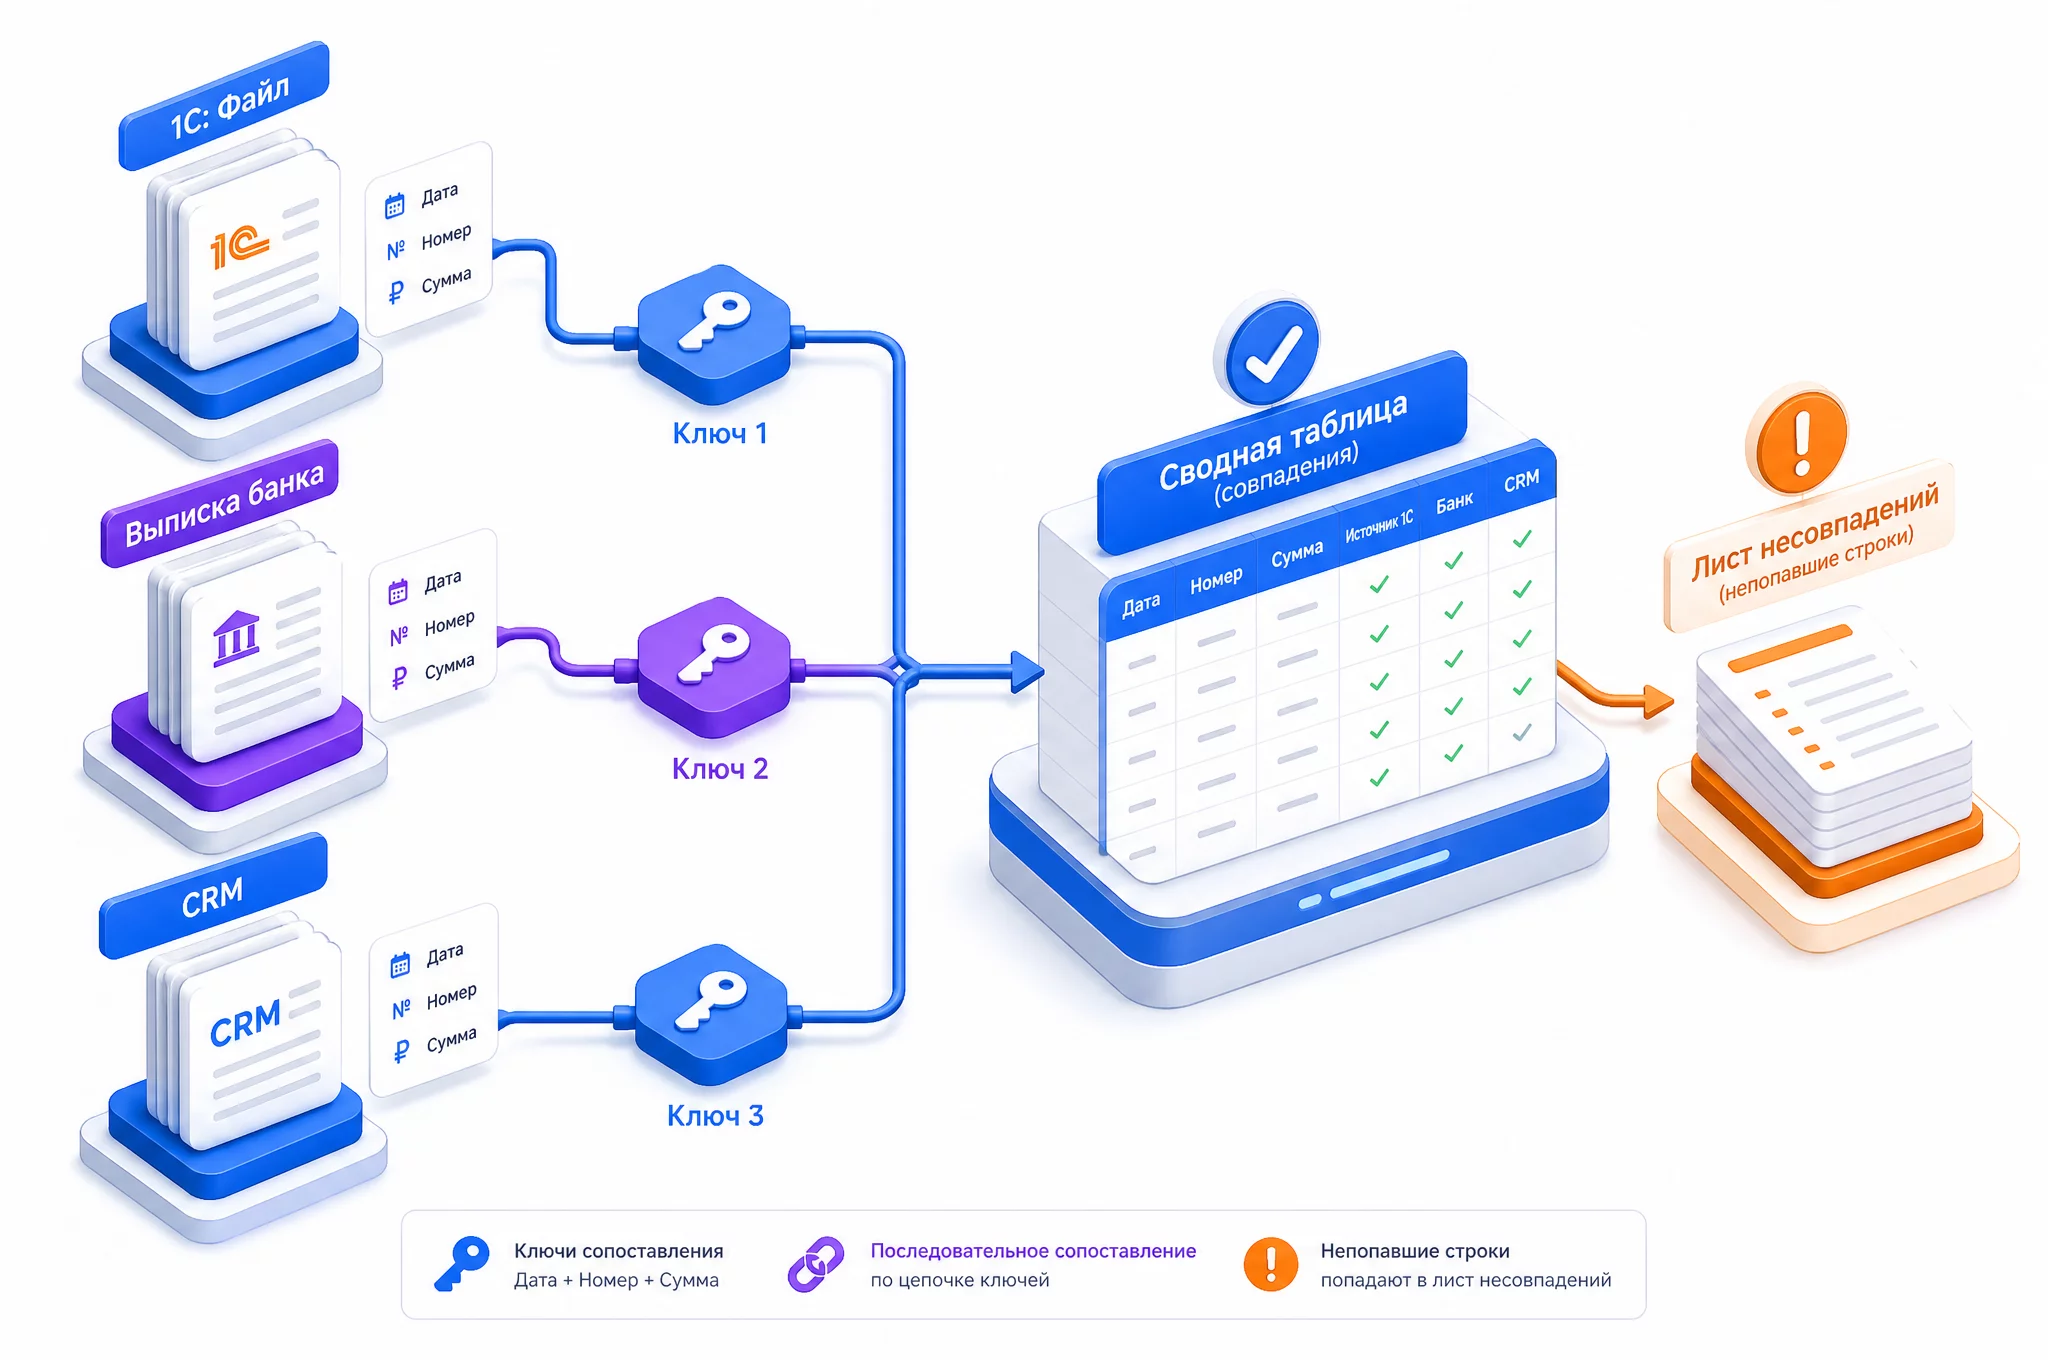
Самый частый сценарий в моей практике это объединение трёх источников: выгрузка из 1С, банковская выписка и CRM с договорами. В каждом своя структура, свой формат ключа и свои грязные данные. ВПР здесь работает хуже всего, потому что ключи в трёх системах не совпадают ни форматом, ни написанием.
Что обычно нужно сделать: взять выписку банка, для каждой операции найти договор из CRM и реквизиты контрагента из 1С, потом собрать единую таблицу для сверки. Раньше это занимало день, потому что сначала чистишь ИНН в трёх местах, потом три раза делаешь ВПР, потом разбираешь несовпадения.
ChatGPT собирает эту задачу в два промпта: первый нормализует ключи во всех трёх файлах, второй объединяет по цепочке. Промпт для объединения трёх источников:
Объедини данные из трёх файлов [загружаете файл 1С, файл выписки
банка, файл CRM].

Что в файлах:
- Файл 1 (1С): контрагент, ИНН, договор, сумма отгрузки
- Файл 2 (банк): дата, ИНН, назначение платежа, сумма
- Файл 3 (CRM): контрагент, менеджер, статус договора

Задача: собрать единую таблицу по каждой отгрузке из 1С:
1. Ключ для соединения 1С и банка: ИНН + сумма
2. Ключ для соединения с CRM: приведённое название контрагента
3. ИНН приведи к единому формату: цифры, без пробелов, текстом
4. Суммы сравнивай с точностью до рубля
5. Строки без пары выводи на отдельный лист с причиной

Формат: единая таблица, потом лист несовпадений, потом сводка
по количеству строк на каждом шаге соединения.
Цепочка из трёх источников показывает, чем ChatGPT сильнее ВПР: он соединяет последовательно, на каждом шаге показывая, сколько строк нашло пару и сколько нет. Вы видите, где именно рвётся цепочка: не сошёлся ИНН, или сумма отличается на копейки, или контрагент в CRM называется иначе.
Отдельная боль в таких задачах это сверка по сумме, когда в банке и в 1С одна операция разбита на несколько строк или наоборот. Промпт для поиска таких расхождений:
В выписке банка 1 200 операций, в реестре 1С 980 отгрузок.
Найди расхождения [загружаете оба файла].

Шаг 1. Соедини по ИНН контрагента
Шаг 2. Внутри каждой пары сравни суммы по операциям
Шаг 3. Найди:
- операции в банке, которых нет в 1С
- отгрузки в 1С, которых нет в банке
- операции, где сумма различается
- операции, где в 1С сумма разбита на несколько строк,
  а в банке одна (или наоборот)
Шаг 4. Для разбитых сумм собери группы и сравни итог

Формат: список расхождений по типам, таблица с колонками дата,
ИНН, сумма банка, сумма 1С, разница, комментарий.
Итоговую сводку по суммам всех расхождений выведи отдельно.
Похожий кейс с банковской выпиской и разбором расхождений я разбирала в статье про банковскую сверку через ChatGPT, там больше про сам процесс сверки, а здесь фокус на объединении таблиц.
Как проверить результат объединения критическим промптом
Главный риск объединения таблиц через нейросеть не в том, что она ошибётся в арифметике. Арифметику она считает точно. Главный риск в том, что модель может потерять строку или задвоить сумму, и это не будет видно на глаз. Поэтому после каждого объединения я запускаю критический промпт с пересчётом на Python.
Почему внешний расчёт сильнее самопроверки: модель, проверяя собственный ответ, идёт по той же цепочке рассуждений, где могла ошибиться. Код на Python считает заново по правилам и не знает, что модель собиралась ответить. Если в объединении пропала строка или сумма не сходится, код это покажет. Принцип тот же, что в проверке любых финансовых расчётов через нейросеть, подробно разобран в статье про аудит формул в Excel.
Проверь результат объединения таблиц [загружаете исходные файлы
и файл с результатом].

Задачи:
1. Посчитай на Python число строк в каждой исходной таблице
   и в результате объединения
2. Сверь, что сумма по ключевой колонке в результате равна сумме
   по ключевой колонке в первой исходной таблице
3. Проверь, что ни одна строка не задвоена: сгруппируй по ключу
   и покажи ключи с количеством больше одного
4. Проверь, что все колонки из второй таблицы заполнились:
   посчитай пустые значения по каждой перенесённой колонке
5. Выведи построчно: таблица, число строк, сумма, число пустых

Формат:
- код на Python полностью
- таблица сравнения исходные данные против результата
- список расхождений с пояснением

Не подгоняй расчёт под результат объединения.
Считай по исходным данным.
Этот промпт закрывает три классические ошибки объединения: потерянную строку, задвоенную сумму и пустую колонку. Прогон занимает пять минут, а без него вы узнаете о проблеме уже в отчёте у собственника.
Вторая линия проверки это контроль несовпадений. Строки, которые не нашли пару, должны быть осмысленными: контрагент реально новый, или ИНН действительно не совпадает. Промпт, который помогает разобрать несовпадения:
В файле несовпадений после объединения [загружаете файл] лежат
строки без пары. Разбери их по причинам.

Для каждой строки:
1. Покажи ключ и значение
2. Попробуй найти похожее значение в справочнике: по первым
   символам ИНН или по части названия
3. Определи причину:
   - нет в справочнике
   - разный формат ключа (текст и число)
   - дубль в справочнике
   - опечатка в названии
   - сумма не совпала при соединении по ИНН + сумме
4. Предложи действие для каждой группы: добавить в справочник,
   исправить формат, разобрать вручную

Формат: таблица по группам причин, внутри каждой группы строки
с ключами и предложенным действием. В конце сводка по количеству
строк в каждой группе.
Несовпадения это не мусор, а список задач. Промпт группирует их по причинам, и вы за десять минут понимаете, что чинить: три контрагента добавить в справочник, у пяти строк поправить формат ИНН, две строки проверить руками. Без группировки на разбор несовпадений уходит полдня.
Тема ошибок нейросетей и того, как не подписать неверный результат, подробно разобрана в статье про галлюцинации и проверку данных, рекомендую прочитать её вместе с этим материалом.
Контроль по контрольным суммам: сверка до подписи
Третья линия проверки это контрольные суммы. Если объединение меняет итоговые цифры, а вы этого не ждали, надо понять, почему. Контрольные суммы это простой способ поймать проблему до того, как таблица уйдёт в отчёт.
Что проверяем: сумму по ключевой колонке в исходной таблице и в результате, сумму по перенесённым колонкам, количество строк по категориям, выборочные строки с максимальными значениями. Всё это пересчитывается на Python в диалоге и сравнивается построчно.
Сверь контрольные суммы после объединения таблиц [загружаете
исходные файлы и результат].

Задачи:
1. Сумма по колонке [Сумма] в первой исходной таблице
2. Сумма по этой же колонке в результате объединения
3. Сумма по перенесённой колонке [Цена] из второй таблицы
   в результате
4. Количество строк в первой таблице, во второй таблице
   и в результате
5. Количество пустых значений в каждой перенесённой колонке

Если любая сумма или количество не совпадает, разбери причину:
потеряна строка, задвоена строка, не заполнилась колонка,
ключ не нашёл пару. Выведи расхождение построчно, не подгоняй
расчёт под результат.
Контрольные суммы особенно важны, когда результат объединения передаётся дальше: в управленческую модель, в отчёт собственнику, в налоговый регистр. Ошибка в одной строке справочника может исказить итог на сотни тысяч рублей, а контрольная сумма покажет это за пять минут.
Если в объединении участвовали две версии одной таблицы, например вчерашняя и сегодняшняя выгрузка, сравнение версий делается отдельным промптом. Он показывает, какие строки добавлены, удалены и изменены, а критический пересчёт подтверждает, что итог по версиям сходится с учётом изменений. Сверка выписок и реестров это отдельная большая тема, я разбирала её в статье про сверку регистров через ChatGPT, там есть свои промпты и кейсы.
Сравнение моделей для объединения таблиц: что выбрать в 2026 году
Для объединения таблиц и поиска в справочниках выбор модели заметно влияет на результат. Я сравнивала их на одинаковых задачах: объединение двух таблиц по ИНН, поиск по нескольким условиям, нормализация названий, пересчёт на Python.
| Модель | Сильные стороны | Слабые стороны | Для каких задач |
|---|---|---|---|
| GPT-5.5 | Массовое объединение, работа с файлами, Python в диалоге, русские названия | На очень длинных книгах теряет фокус | Основная рабочая модель |
| Claude Sonnet 4.6 | Длинные книги, вложенная логика, большие справочники | Реже умеет считать на Python в чате | Сложные справочники и длинные документы |
| Gemini 2.5 | Работа прямо в Google Таблицах, расширения | Менее предсказуем на многошаговом объединении | Google Sheets |
| DeepSeek V3.2 | Бесплатный, работает без обхода блокировок | Только обезличенные данные, черновые задачи | Черновик и разовые проверки |
Актуально на август 2026 года. Цены подписок меняются, актуальные тарифы смотрите на официальных сайтах: chatgpt.com, claude.ai, gemini.google.com. Для большинства финансовых задач рабочая связка такая: GPT-5.5 как основной инструмент, Claude Sonnet 4.6 для больших справочников, DeepSeek бесплатно для черновиков на обезличенных данных. Детальнее про выбор бесплатных нейросетей для Excel в статье про сравнение бесплатных моделей, а про DeepSeek отдельно в статье про таблицы и формулы в DeepSeek.
Если ваши таблицы живут в Google Таблицах, попробуйте Gemini 2.5: он работает прямо в Google Sheets через расширения и не требует выгрузки файлов. Промпты из этой статьи работают без изменений, только файл прикрепляете не Excel, а ссылкой на таблицу или экспортом в CSV.
Надстройки для Excel, такие как Copilot in Excel, тоже закрывают часть задач объединения, но у них другой подход: они автоматизируют привычные действия внутри Excel, а не читают файлы как данные. Для разовых объединений с грязными ключами ChatGPT даёт больше контроля: вы видите, как модель поняла структуру, и можете задать правила приведения. Для постоянных отчётов с регулярной структурой Copilot внутри Excel удобнее, потому что не требует выгрузки данных за пределы книги. Сравнение надстроек и нейросетей разобрано в статье про Excel Copilot и Claude for Excel, там есть и таблица, и кейсы на одинаковых задачах.
Выбор рабочей связки зависит от того, где живут ваши данные и как часто вы объединяете таблицы. Если раз в месяц сверяете выписку, достаточно GPT-5.5 и промптов из этой статьи. Если объединение стоит в ежедневном процессе, стоит посмотреть в сторону автоматизации через агентов, про которые я писала в статье про AI-агентов для финдира.
Три кейса с часами и рублями
Показываю на реальных задачах, которые разбирали с учениками. Цифры честные, из замеров, а не из рекламных обещаний.
Кейс 1. Сверка выписки на 1 200 операций за 25 минут вместо 4 часов.
Финансист торговой компании ежемесячно сверял банковскую выписку с реестром отгрузок из 1С. Через ВПР по ИНН находил пары, потом часами разбирал несовпадения: у части операций ИНН был числом, у части текстом, у части контрагент назывался иначе. В один из месяцев расхождение на 340 000 рублей не находилось три дня.
Что сделали: подготовили ключи, привели ИНН к единому формату, прогнали объединение по промпту из этой статьи, потом критический промпт с пересчётом на Python. Нашли, что 14 операций в выписке не имели пар в реестре, из них три были оплатами новым контрагентам, а одна операция на 340 000 рублей была задвоена в реестре из-за ручного ввода. Итог: 25 минут вместо 4 часов, расхождение найдено до сдачи отчёта.
Кейс 2. Объединение справочника контрагентов на 5 800 строк за 40 минут вместо двух дней.
Главный бухгалтер получила задачу объединить справочник контрагентов из трёх баз: 1С, CRM и старый Excel-справочник. ВПР не работал, потому что названия в базах различались, а в старом справочнике половина ИНН была с пробелами. Раньше такую задачу делали вручную, на это уходило два дня.
Что сделали: нормализовали ключи промптом из статьи, добавили колонку «Ключ поиска» по приведённому названию и ИНН, объединили по цепочке три файла, разобрали несовпадения по причинам. Нашли 47 дублей в старом справочнике и 12 контрагентов, которых не было ни в одной базе. Итог: 40 минут вместо двух дней, справочник сходится, дубли переданы в 1С на исправление.
Кейс 3. Проверка закупок за час вместо полдня.
Финансовый директор проверял закупки за квартал: в прайсе поставщика 8 000 позиций, в заказе 350 строк. Нужно было подтянуть цены по артикулам и найти позиции, где цена в заказе отличается от прайса. Ручная работа с ВПР давала 60 несовпадений, половина из которых была ошибками формата.
Что сделали: объединили по артикулу через нейросеть, привели артикулы к единому виду, критическим промптом пересчитали суммы. Осталось 9 реальных расхождений, из них 4 позиции с завышенной ценой на общую сумму 86 000 рублей. Итог: час вместо полдня, переплата найдена до оплаты счёта.
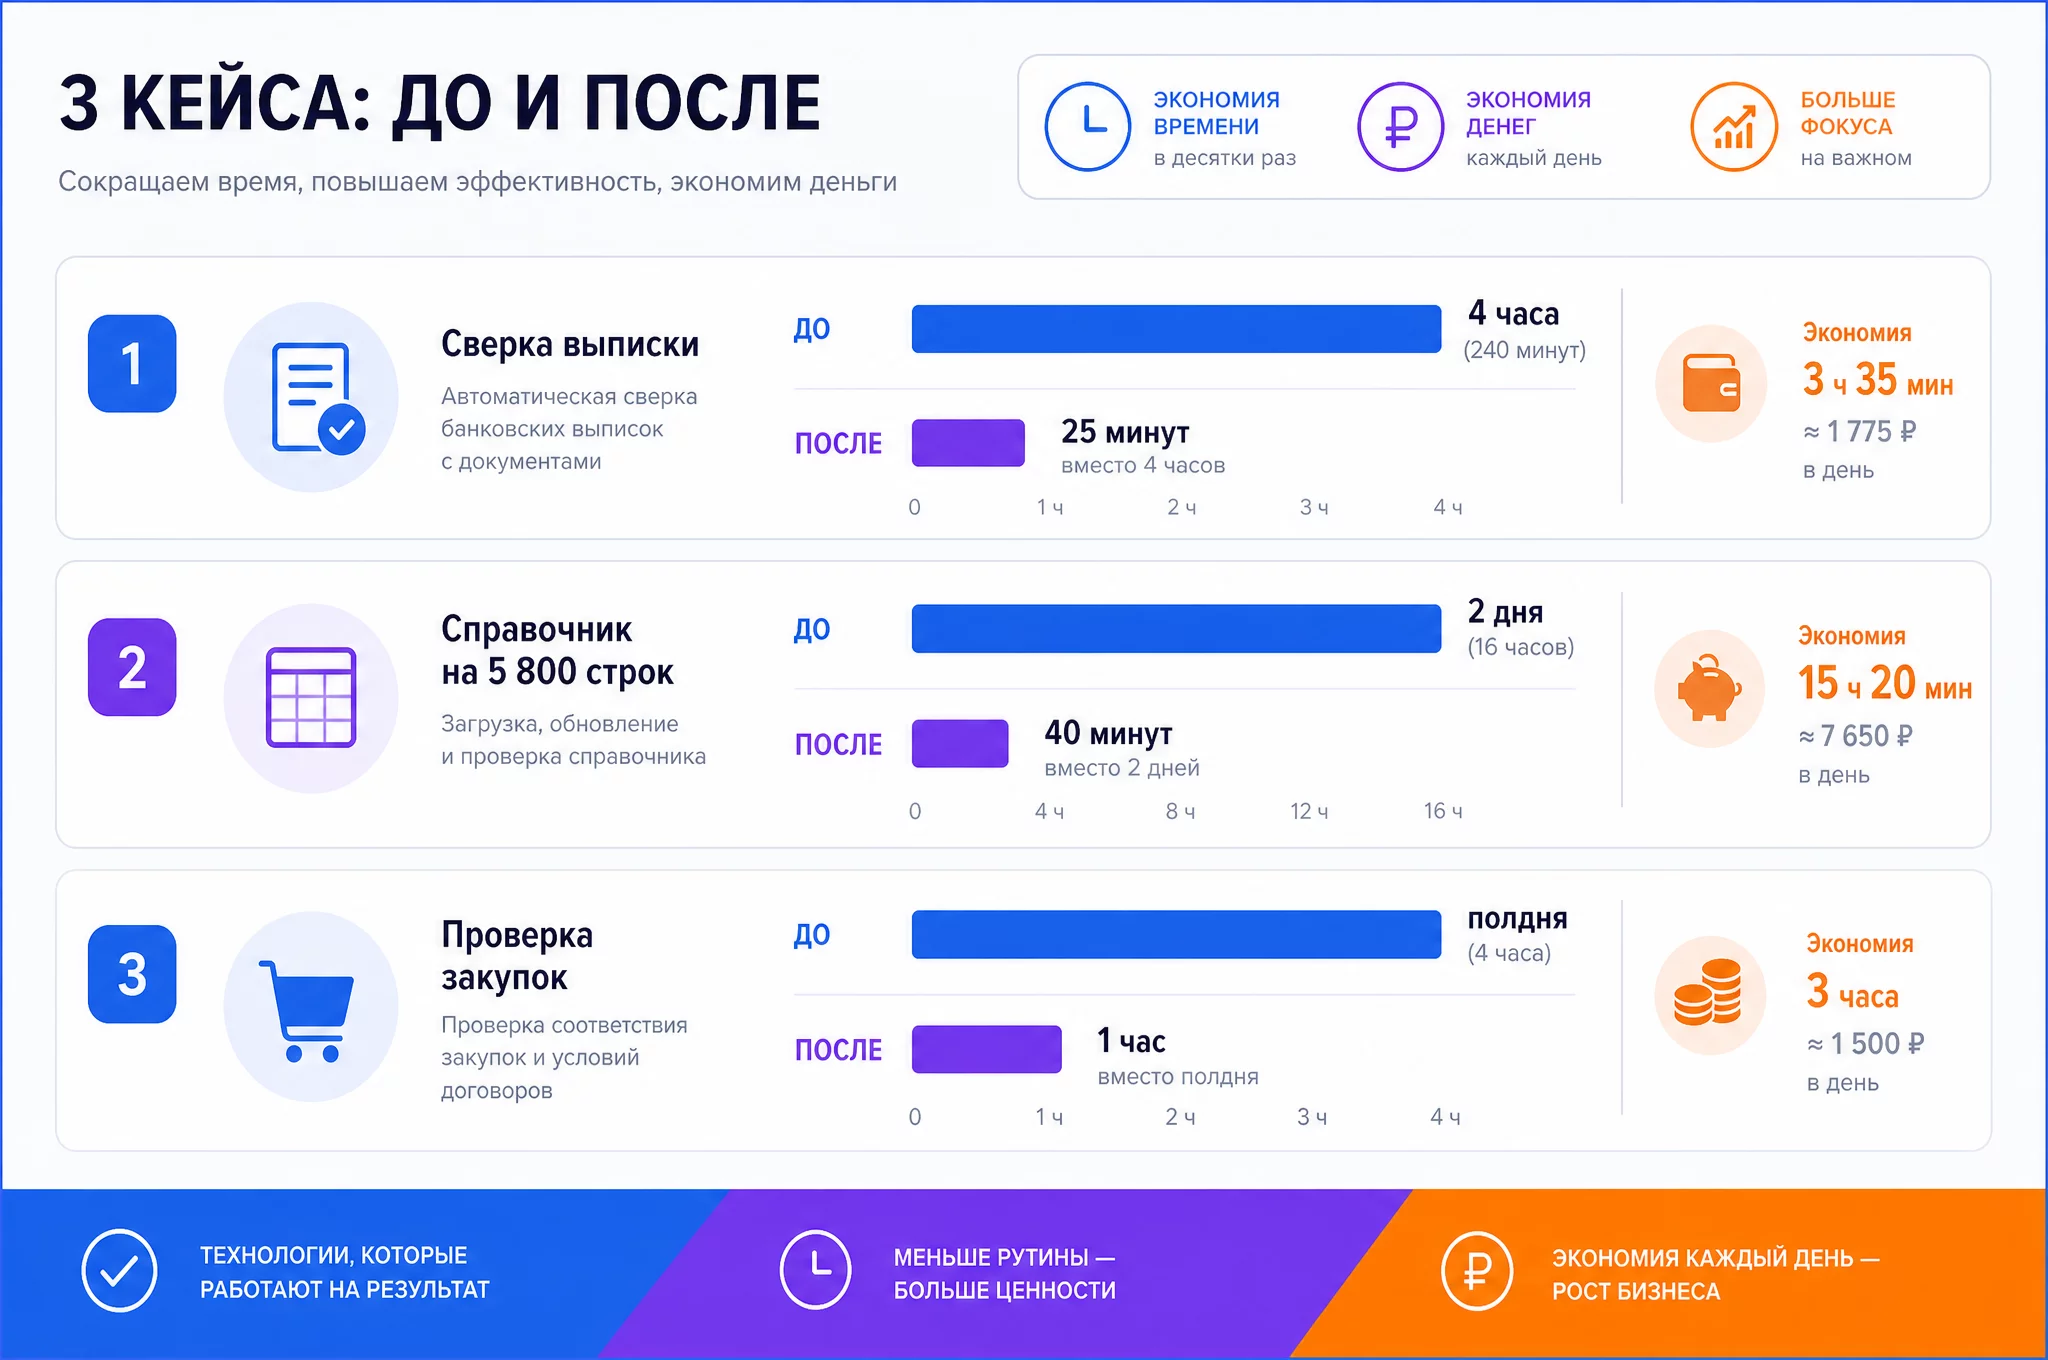
Общий вывод по кейсам: экономия от 75 до 90 процентов времени на объединении таблиц и поиске в справочниках, а главная ценность не в часах, а в том, что расхождения находятся до того, как попадут в отчёт.
Частые ошибки и мифы про ChatGPT вместо ВПР
Вижу одни и те же ошибки у тех, кто начинает объединять таблицы через нейросеть. Пять штук, все легко обходятся.
1. Грузить файлы без описания структуры. Модель без правил не знает, что в колонках, и соединяет не то. Описание структуры это 50 процентов качества объединения.
2. Не чистить ключи до загрузки. Если ИНН в одной таблице число, а в другой текст, нейросеть справится, но потратит на это итерацию. Пять минут на приведение формата в Excel экономят десять минут переспрашивания.
3. Принимать результат объединения без проверки. Модель может потерять строку или задвоить сумму, и на глаз это не видно. Критический промпт с пересчётом на Python обязателен после каждого объединения.
4. Загружать чувствительные данные без обезличивания. Названия контрагентов, ИНН, счета и ФИО в публичный тариф не грузятся. Только маски, только после отключения обучения.
5. Доверять несовпадениям как приговору. Строка без пары не значит, что данных нет. Возможно, в справочнике дубль, опечатка или разный формат. Промпт группировки несовпадений по причинам экономит полдня разбора.
Есть ещё одна ошибка, которую я замечаю у опытных пользователей: они дают модели задачу без контекста бизнеса. Промпт «объедини по ИНН» сработает, но модель не будет знать, что в этой компании один контрагент может иметь несколько договоров и нужно выбрать действующий. Контекст в два предложения, например «у одного контрагента может быть несколько договоров, бери только действующие, статус в колонке E», меняет результат сильнее любого уточнения формата. Описание бизнес-правил это не прихоть, а половина качества объединения, и это то, что отличает промпт финансиста от промпта новичка.
Теперь про мифы, которые мешают начать.
Миф: ChatGPT только для простых таблиц, большие справочники не тянет. На больших файлах модель работает, если разбить задачу на этапы: нормализация ключей, объединение, проверка. Claude Sonnet 4.6 с длинным контекстом держит большие книги целиком, а для файлов с десятками тысяч строк есть нарезка по периодам.
Миф: нейросеть заменит формулы полностью, Excel станет не нужен. Для разовых и сложных задач да, для постоянных отчётов формулы остаются: они обновляются автоматически при изменении данных. Разумная связка в 2026 году: ВПР и XLOOKUP для живых отчётов, ChatGPT для разовых объединений, грязных данных и проверки.
Миф: если итоги сошлись, объединение верное. Итоги могут сойтись, даже если внутри потеряны две строки и добавлены две чужие. Поэтому проверяется не только итог, но и число строк, и отсутствие дублей. Сходимость итогов это необходимое условие, но не достаточное.
Когда ChatGPT не поможет: честные границы
Нейросеть сильный инструмент, но не волшебная палочка. Говорю прямо, где ChatGPT не заменяет ВПР и XLOOKUP, чтобы вы не тратили время впустую.
- Секретные данные. Если файл нельзя выносить за периметр компании, никакой публичный чат не подходит. Для таких задач остаются корпоративные тарифы с контуром безопасности или локальные модели на своём компьютере.
- Автоматическое обновление. ChatGPT не держит живую связь между листами. Если отчёт должен пересчитываться при каждом изменении справочника, это задача формулы, а не диалога.
- Тонкая настройка форматов. Когда объединённая таблица должна попасть в строгий регламент с фиксированным оформлением, проще сделать объединение формулой и руками, чем перекладывать результат из диалога.
- Полностью неструктурированные данные. Если в выгрузке нет ни одной стабильной колонки-ключа, ни формула, ни нейросеть не соединят таблицы осмысленно. Сначала нужна нормализация, и это работа человека.
- Решение о цене данных. Модель найдёт пару по ключу, но не знает бизнес-контекст: какое из двух совпадений в справочнике правильное. Решение остаётся за человеком, который знает смысл каждой строки.
Граница честная: нейросеть снимает механическую часть объединения и поиска, а смысловую часть оставляет человеку. Там, где данные чистые и процесс повторяющийся, формула справляется сама. Там, где данные грязные и задача разовая, ChatGPT экономит часы. Умение выбрать между ними это и есть навык, который я развиваю на курсе.
Как превратить разовые промпты в повторяемый процесс
Разовое объединение таблиц это хорошо, а системный процесс ещё лучше. Когда одна и та же сверка повторяется каждый месяц, повторяемый процесс экономит больше, чем разовая акция. Три шага, чтобы превратить разовое объединение в ежемесячный ритуал.
Первый шаг: сохранить мастер-промпты. Проверенные промпты из этой статьи сохраните в заметки или в отдельный документ. В следующем месяце вы не вспомните формулировку, а с сохранённым шаблоном объединение начинается с места, где закончилось.
Второй шаг: завести шаблон ключей. Колонку «Ключ поиска» в справочнике и правила приведения названий храните как файл-шаблон. Каждый месяц копируете его в новую выгрузку и применяете. Это половина качества объединения, и её не нужно перепридумывать.
Третий шаг: собрать библиотеку промптов под свои процессы. Отдельные промпты для сверки выписки, объединения прайсов, проверки закупок, разбора несовпадений. Каждый отлаживается один раз и потом переиспользуется. Со временем у вас появится своя библиотека, которая закрывает именно ваши типовые отчёты.
Первый час с ChatGPT: с чего начать новичку
Если вы никогда не объединяли таблицы через нейросеть, не начинайте со сложных трёхфайловых задач. Первый час лучше потратить на простой сценарий, который сразу даст результат и покажет, как работает связка «файлы, описание, промпт, проверка».
План первого часа:
- Десять минут на подготовку. Возьмите две небольшие таблицы: прайс на 200 строк и заказ на 30 строк. Приведите артикулы к одному виду, обезличьте названия.
- Десять минут на настройку. Вставьте персонализацию из статьи, отключите обучение на данных, откройте chatgpt.com.
- Десять минут на первое объединение. Загрузите обе таблицы, опишите структуру и ключ, отправьте промпт объединения. Посмотрите, как модель вернёт результат и список несовпадений.
- Пятнадцать минут на проверку. Прогоните результат через критический промпт с пересчётом на Python. Сравните число строк и суммы.
- Пятнадцать минут на разбор. Посмотрите, какие строки не нашли пару и почему. Это самый полезный шаг: вы увидите, где в ваших данных реальные проблемы, которые мешают и ВПР.
К концу часа у вас будет объединённая таблица, проверенная двумя промптами, и понимание, что в ваших данных грязное. Дальше каждый следующий запуск будет быстрее, потому что промпты и настройки уже готовы. Этот же план в формате пошагового чек-листа я собрала в статье про первую работу с Excel через нейросети, там акцент на бесплатных моделях для старта.
Промпт для оформления результата объединения, чтобы был след для руководителя:
Составь отчёт по итогам объединения таблиц.

В отчёте:
1. Какие файлы объединялись и по какому ключу
2. Сколько строк в каждой исходной таблице и в результате
3. Сколько строк нашло пару и сколько нет
4. Причины несовпадений по группам
5. Что было исправлено до объединения: дубли, форматы, пробелы
6. Рекомендации по данным: что добавить в справочник, что
   исправить в выгрузках

Язык: деловой, без канцелярита. Формат: документ для руководства,
который можно приложить к сдаче отчёта.
Отчёт по итогам объединения закрывает вопрос «а что вы проверяли?». Когда собственник или коллега видит документ с количеством строк и причинами несовпадений, доверие к процессу растёт. Для более сложных автоматизаций поверх Excel, включая макросы, смотрите статью про VBA и макросы через ChatGPT.
Чек-лист: объединение таблиц через ChatGPT
Шесть шагов, по одному на каждое объединение. Сохраните в заметки и гоняйте таблицы через него каждый месяц.
- Подготовьте таблицы и выберите ключ. Решите, по какому полю соединять: ИНН, артикул, номер договора. В обеих таблицах ключ в отдельной колонке.
- Нормализуйте ключи. Единый формат ИНН и дат, без пробелов и кавычек, дубли убраны. Это аналог подготовки первого аргумента ВПР.
- Обезличьте данные. Контрагенты, ИНН, счета и ФИО заменяются масками. Выключите обучение на данных. Документы под NDA в публичные тарифы не грузим.
- Загрузите файлы и опишите структуру. Прикрепите обе таблицы на chatgpt.com, напишите, что в каждой колонке и по какому ключу соединять.
- Запустите промпт объединения. Возьмите готовый промпт из статьи, получите объединённую таблицу и список несовпадений.
- Проверьте критическим промптом. Пересчёт на Python: число строк, суммы, дубли, пустые колонки. Исправления вносите руками.
Этот чек-лист стоит держать под рукой не потому, что процесс сложный, а потому, что в разгар закрытия месяца проще свериться со списком из шести пунктов, чем вспоминать логику с нуля.
FAQ: частые вопросы про ChatGPT вместо ВПР и XLOOKUP
Можно ли заменить ВПР и XLOOKUP на ChatGPT? Можно для разовых объединений и сложных случаев с грязными данными. Для постоянных отчётов с живой связью между листами формулы остаются, они обновляются автоматически.
Как объединить две таблицы в ChatGPT? Загрузите оба файла, опишите структуру колонок и ключ соединения, отправьте промпт объединения из статьи. Результат проверьте критическим промптом с пересчётом на Python.
В чём разница между ВПР, XLOOKUP и ChatGPT? ВПР ищет слева направо по первому столбцу, XLOOKUP ищет в любом направлении и возвращает массив. ChatGPT не применяет формулу, а читает таблицы как данные и соединяет по описанному правилу, справляясь с грязными ключами.
Не потеряет ли модель строки при объединении? Может, поэтому после объединения обязателен контроль: число строк, суммы, дубли. Строки без пары попадают в отдельный лист несовпадений с причиной.
Безопасно ли загружать справочники в ChatGPT? Только после обезличивания и отключения обучения. Контрагенты, ИНН и ФИО маскируются, документы под NDA в публичные тарифы не грузятся.
Какая нейросеть лучше для объединения таблиц? GPT-5.5 для основной работы, Claude Sonnet 4.6 для длинных книг и больших справочников, Gemini 2.5 для Google Таблиц, DeepSeek V3.2 бесплатно для черновиков на обезличенных данных.
Нужно ли уметь программировать? Нет. Код на Python модель пишет сама для проверки результата. Достаточно уметь описать словами, что лежит в таблицах и по какому ключу их соединять.
Что делать, если ChatGPT не находит пару по ИНН? Проверьте формат ключа в обеих таблицах: ИНН должен быть текстом, без пробелов и дефисов. Посмотрите, нет ли дублей в справочнике. Запустите промпт нормализации ключей из статьи, он покажет, что именно мешает: формат, дубль, скрытый символ. Если причина в названии, добавьте колонку «Ключ поиска» с приведённым названием без организационно-правовой формы.
Как объединить больше двух таблиц одновременно? По цепочке: сначала объединяете первую и вторую по одному ключу, потом результат с третьей по другому ключу. Промпт для трёх источников есть в разделе про выгрузки из 1С, банка и CRM. На каждом шаге просите модель показывать число строк до и после, чтобы видеть, где рвётся цепочка.
Можно ли использовать ChatGPT для поиска в справочнике на постоянной основе? Для разовых запросов да, для постоянного обновления нет. Живая связь между листами остаётся за ВПР и XLOOKUP. Оптимальная схема в 2026 году: формулы для регулярных отчётов, ChatGPT для разовых объединений, проверки и сложных случаев с грязными данными.
Какие файлы принимает ChatGPT для объединения? Excel (xlsx, xls), CSV, PDF и скриншоты таблиц. Лучше всего работают xlsx и CSV с чистой структурой: одна таблица на лист, без объединённых ячеек и многоэтажных шапок. Для больших файлов используйте нарезку из статьи.
Чем отличается объединение через ChatGPT от сводной таблицы? Сводная агрегирует данные внутри одной таблицы: группирует, суммирует, считает доли. Объединение соединяет две разные таблицы по ключу, дополняя строки одной данными из другой. ChatGPT умеет и то и другое, но в этой статье фокус на объединении, то есть на том, что делает ВПР и XLOOKUP.
Что дальше
Объединение таблиц и поиск в справочниках через нейросеть закрывает конкретную боль: часы на ВПР, несовпадения, ручную чистку. Но это один приём из целой системы. Следующий шаг собрать вокруг нейросетей весь контур финансовой работы: от выгрузок из 1С до отчёта собственнику. На курсе «AI-навыки финансиста» онлайн-школы «Финансовый директор | Мастер CFO» разбираю, как выстроить такую систему: от обезличивания данных до библиотеки промптов под ваши процессы. 10 модулей, 800+ выпускников, диплом установленного образца с лицензией и налоговый вычет 13%. Начать можно с бесплатного эфира-экскурсии, где показываю процесс на живых файлах.
Записаться на курс «AI-навыки финансиста»
Для тех, кто хочет продолжить самостоятельно: посмотрите статью про Excel-автоматизацию через ChatGPT, там больше про работу с таблицами на русском языке, и статью про консолидацию отчётности, где объединение данных разобрано на уровне целых компаний.
Наши каналы для финансистов
@findir_pro. Основной Telegram-канал «Финансовый директор | Мастер CFO». 45 000 подписчиков. Ежедневно: практические разборы, кейсы выпускников, обновления инструментов, новые промпты для финансистов.
«АИ с Софьей и Натали». Канал об AI для финансистов. 13 000 подписчиков. Вместе с Софьей Бурцевой, основателем школы, разбираем новые модели, делаем живые тесты и публикуем обновлённые промпты сразу после выхода новых версий.
MAX. Закрытое сообщество для действующих финансовых директоров. 5 000+ участников. Кейсы коллег, шаблоны, закрытые эфиры по AI и стратегии CFO.
Об авторе
Натали Васильева. Эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO». С нейросетями в работе финансиста с февраля 2023 года. Через курс «AI-навыки финансиста» прошли 800+ финансистов, главбухов и финдиров. Веду Telegram-канал @findir_pro (45 000 подписчиков) и MAX-канал «Финансовый директор» (5 000+).