AI для финансиста
ChatGPT читает ваш Excel: задаём вопросы по таблице на русском и получаем ответы без формул и сводных

Половина моих учеников на первой встрече говорит: «Я не программист, со сводными мучаюсь, а тут ещё нейросети». Потом я показываю один приём, и через час человек задаёт своей таблице вопросы на русском и получает ответы, на которые раньше уходил вечер. Меня зовут Натали Васильева, я эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO». С февраля 2023 года я помогаю финансистам и бухгалтерам внедрять нейросети в работу, через курс «AI-навыки финансиста» прошли 800+ выпускников, наши каналы читают 45 000 подписчиков в Telegram и 13 000 в канале «АИ с Софьей и Натали». Материал актуален на 27 августа 2026 года.
В этой статье показываю, как ChatGPT читает вашу таблицу Excel и отвечает на вопросы на русском: без формул, без сводных, без программирования. Внутри: одиннадцать готовых промптов, подготовка файлов, три кейса с часами и рублями, сравнение моделей и правила безопасности.
Что такое вопросы по таблице через ChatGPT и почему это работает
Вопросы по таблице это когда вы не пишете формулу и не строите сводную, а спрашиваете нейросеть на русском языке: «сколько выручки в мае по регионам», «где самый большой рост к прошлому месяцу», «найди поставщиков с подорожавшими ценами». ChatGPT читает файл, считает сам и возвращает ответ.
Работает это так. Вы загружаете файл Excel, CSV или PDF. ChatGPT разбирает структуру: видит колонки, строки, типы данных. Дальше вы задаёте вопрос обычным языком, и модель либо считает по файлу напрямую, либо запускает встроенный анализ данных с кодом Python и пересчитывает сама. Ответ приходит текстом, таблицей или списком, как вы попросите.
Почему это меняет работу финансиста. Раньше на каждый вопрос к данным уходило время: построить сводную, настроить срезы, проверить, перестроить под другой период. Теперь вопрос формулируется за десять секунд, а ответ приходит за минуту. Разница не в том, что вы перестали думать. В том, что механическую часть выборки и группировки берёт на себя нейросеть, а вы остаётесь с решением.
В 2026 году это уже не экзотика, а базовая практика. Модели нового поколения принимают файлы, держат большой контекст и умеют запускать код. GPT-5.5, Claude Sonnet 4.6, Gemini 2.5 и DeepSeek V3.2 все справляются с таблицами, вопрос в том, какой инструмент под какую задачу. Про сравнение моделей подробно в отдельном разделе ниже.
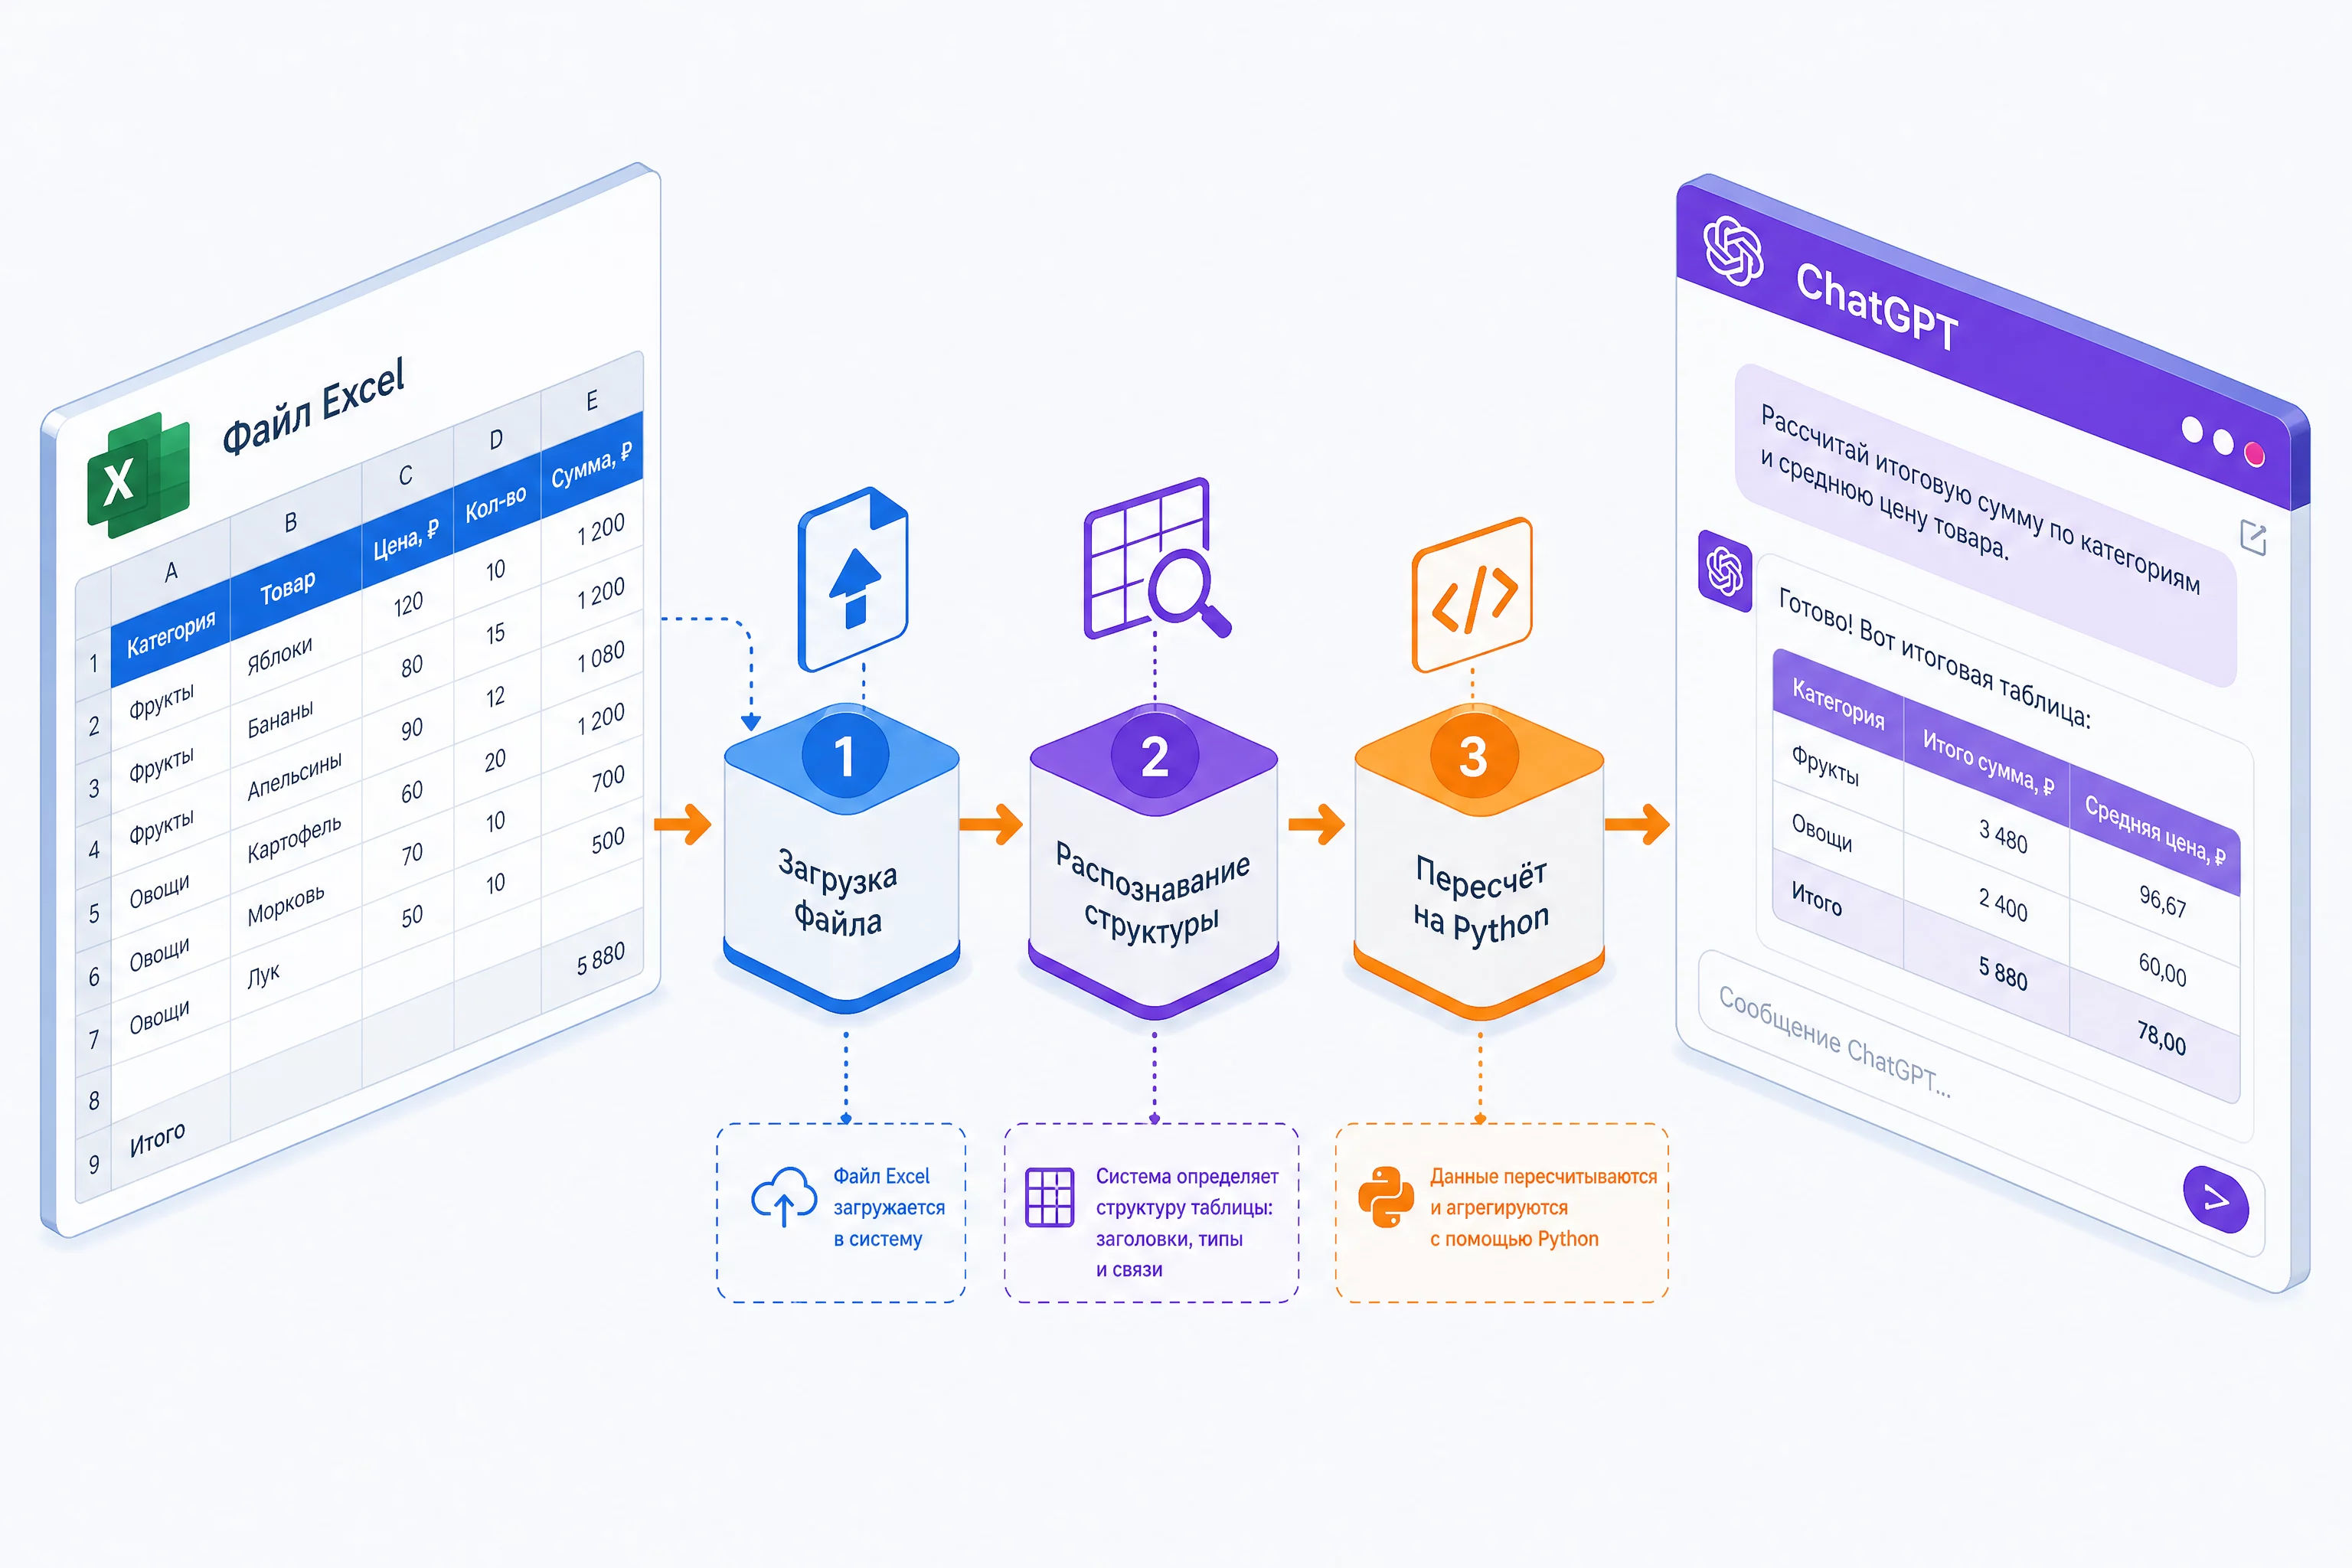
Если вы только начинаете работать с нейросетями, не пугайтесь терминов. Всё, что нужно, это зарегистрированный аккаунт ChatGPT, файл с данными и желание спросить. Дальше по шагам разбираю, как подготовить таблицу, какие вопросы задавать и как проверять ответы. Для старта с нуля у нас есть бесплатный эфир-экскурсия, ссылка в конце статьи.
Какие файлы Excel принимает ChatGPT и какие есть лимиты
ChatGPT принимает файлы Excel в форматах .xlsx и .xls, а также CSV, текстовые файлы и PDF. Для таблиц с формулами важный момент: нейросеть читает значения ячеек, а не пересчитывает формулы. Если в ячейке стоит формула, ChatGPT видит её результат, а саму формулу может посмотреть, только если попросить. Для вопросов по данным это не мешает, а для проверки формул есть отдельный процесс, про него я писала в статье про аудит формул Excel через ChatGPT.
Лимиты по размеру файлов зависят от тарифа и меняются, точные цифры смотрите на официальной странице chatgpt.com. По практике: бесплатный тариф спокойно принимает таблицы с десятками тысяч строк, платная подписка позволяет загружать заметно больше. Если файл не открылся, чаще всего виновата структура, а не размер: объединённые ячейки, сложные шапки в несколько уровней, вставленные картинки и диаграммы.
Что делать с большими книгами, я разбираю в отдельном разделе ниже. А короткая инструкция для первого запуска такая:
- Откройте chatgpt.com и войдите в аккаунт.
- Нажмите значок скрепки или кнопку загрузки файла.
- Выберите файл .xlsx или .csv.
- Напишите в одном предложении, что лежит в таблице: период, строки, колонки.
- Отправьте и задайте первый вопрос.
Если вы из России, учтите оговорку про доступ: для входа в ChatGPT нужен способ обхода блокировки, например корпоративный VPN или прокси. Сам ChatGPT отлично понимает и отвечает на русском. Если обходить блокировку нельзя, работает DeepSeek, он доступен без VPN, но загружать туда можно только обезличенные данные.
После загрузки файла не ждите, что нейросеть сама всё поймёт. Она поймёт структуру, но не вашу бизнес-логику. Поэтому следующий шаг подготовка таблицы, и от него зависит половина качества ответов.
Как подготовить таблицу к вопросам: нормализация и обезличивание
Качество ответов нейросети напрямую зависит от того, что вы ей отдали. Чистая таблица даёт точные ответы, грязная превращает любую модель в источник странных цифр. Подготовка занимает десять минут и делается один раз, дальше вы просто переиспользуете правила.
Три обязательных действия перед загрузкой.
Первое: нормализуйте названия. Одна и та же статья должна называться одинаково во всех строках. «Выручка», «Реализация» и «Продажи» это три разных значения для нейросети, пока вы не дадите ей справочник соответствий. Приведите названия к одному виду, и вопросы начнут работать как надо.
Второе: приведите даты и числа к единому формату. Даты лучше в виде «01.05.2026» или «2026-05-01», а не «май» и «мая». Числа без пробелов и валютных символов в ячейке: «1250000», а не «1 250 000 ₽». Форматирование оставьте Excel, данные должны быть чистыми.
Третье: уберите объединённые ячейки и лишние листы. Объединённые ячейки ломают чтение диапазонов, многоэтажные шапки мешают распознать колонки, служебные листы отвлекают модель. Оставьте в файле только то, что нужно для анализа.
Отдельно про обезличивание. Названия контрагентов, ИНН, расчётные счета и ФИО заменяйте масками: «Контрагент 1», «Контрагент 2». Суммы можно оставлять, они без контекста никого не идентифицируют. В платном тарифе выключите в настройках использование ваших данных для обучения. Документы под NDA и банковскую тайну в публичные тарифы не грузим. Подробная схема в статье про обезличивание данных перед загрузкой в ChatGPT.
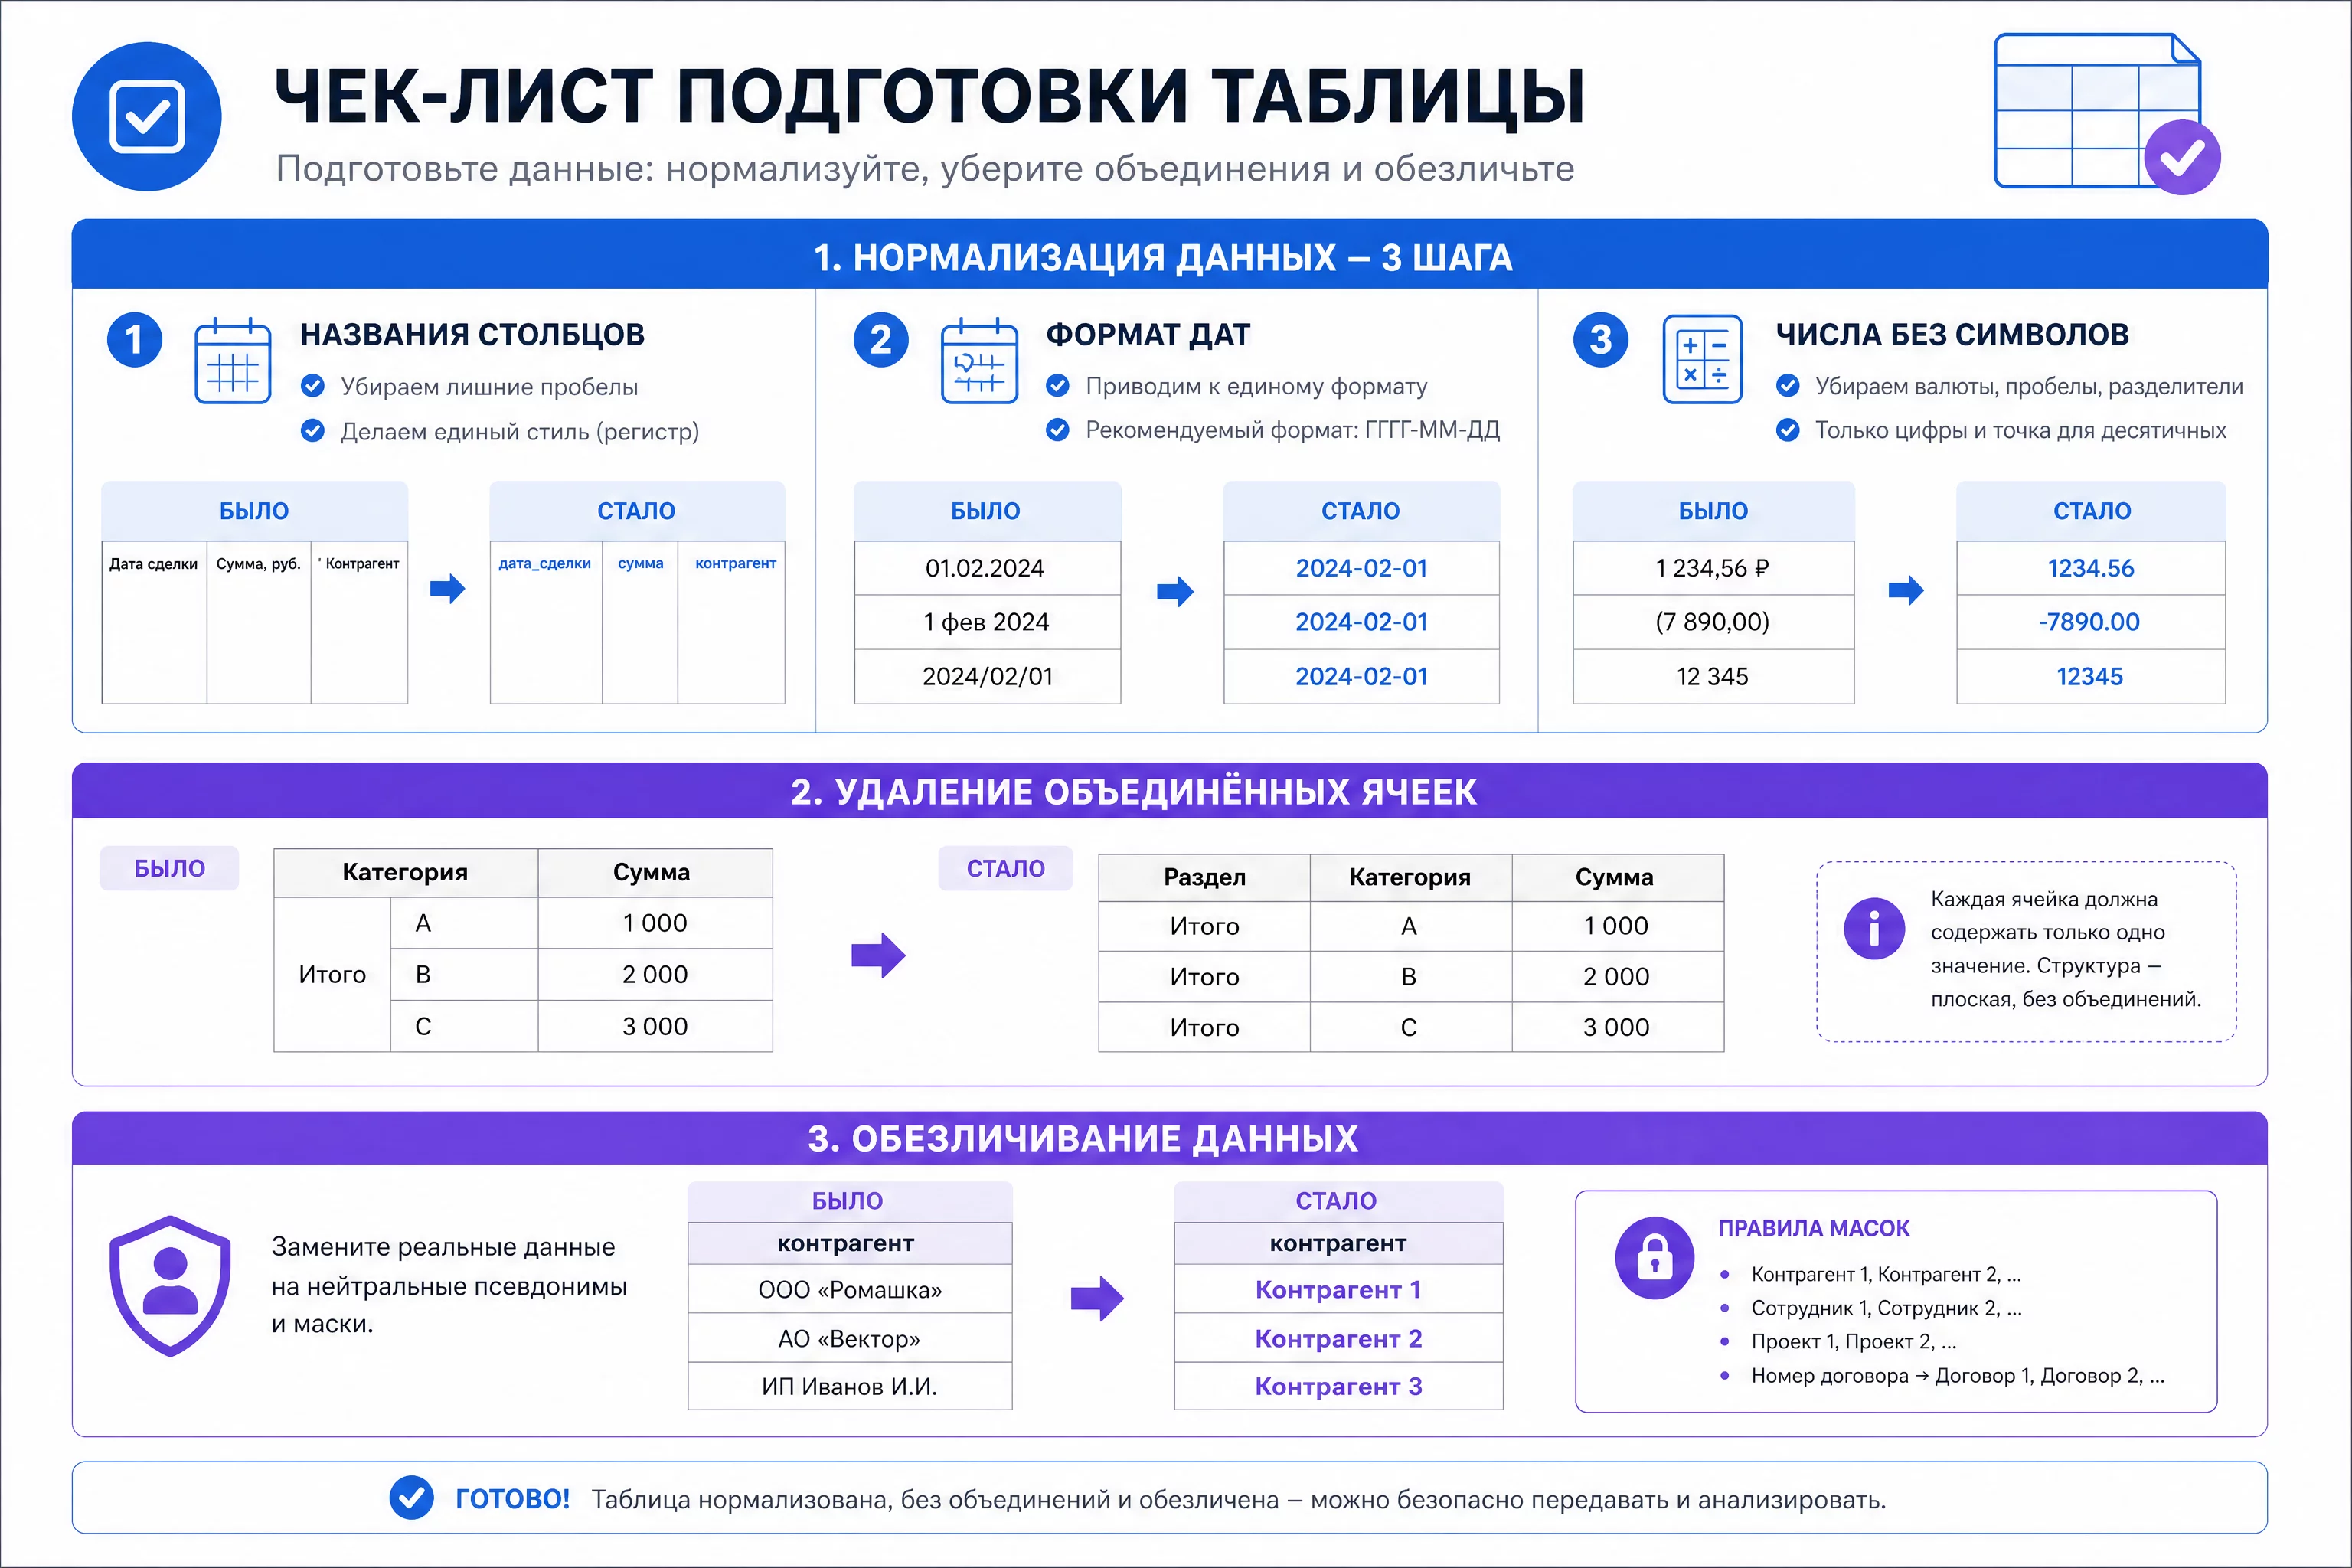
Когда таблица готова, приходит время вопросов. Дальше показываю, как формулировать их на русском, чтобы ChatGPT понимал с первого раза.
Первые промпты: как задавать вопросы по таблице на русском
Самый простой способ начать это загрузить таблицу и написать вопрос как живому аналитику. Чем конкретнее вопрос, тем точнее ответ. Уточняйте колонку, период и формат результата.
Первый промпт для знакомства с таблицей, его полезно отправлять перед любыми вопросами, чтобы нейросеть назвала структуру своими словами:
Перед тобой таблица [загружаете файл].

Расскажи, что в ней лежит:
1. какие колонки и что означает каждая
2. сколько строк и за какой период
3. какие типы данных в каждой колонке (числа, даты, текст)
4. есть ли пропуски, дубли и странные значения

Потом предложи 5 вопросов, на которые можно ответить
по этим данным, и ответь на первый из них.
Формат ответа: краткое описание структуры, список вопросов,
потом первый ответ с расчётом.
Этот промпт даёт две вещи. Вы видите, как нейросеть поняла таблицу, и сразу получаете список готовых вопросов. Если в описании структуры есть ошибка, значит таблица подготовлена плохо, вернитесь к шагу нормализации.
Второй промпт для конкретных вопросов с числами:
По таблице [загружаете файл] ответь на вопросы.

1. Какая общая выручка за период?
2. Сколько выручки в каждом месяце?
3. Какой месяц был лучшим, а какой худшим?
4. На сколько процентов вырос май по сравнению с апрелем?

Считай по данным из файла.
Каждый ответ покажи с расчётом: что суммировал,
какие строки брал, какой получился итог.
Если данных для ответа не хватает, скажи прямо.
Формат: таблица с колонками вопрос, ответ, расчёт.
Слово «покажи с расчётом» здесь ключевое. Оно заставляет нейросеть не выдавать голую цифру, а объяснить, откуда она взялась. Если расчёт не совпадает с вашим ожиданием, вы сразу увидите, что модель поняла данные не так.
Не пытайтесь сформулировать идеальный промпт с первого раза. Это диалог: спросили, получили, уточнили. Если ответ сомнительный, скажите «пересчитай по данным, а не по итогам файла» или «покажи построчно, что ты суммировал». Уточняющие вопросы это нормальная часть работы, а не признак ошибки.
Как формулировать вопросы, чтобы ChatGPT понимал с первого раза
Хороший вопрос к таблице это половина ответа. Я видела, как один и тот же файл давал разные результаты в зависимости от формулировки. Три правила превращают расплывчатый вопрос в точный запрос.
Правило первое: называйте колонку, период и формат. Вместо «сколько у нас денег» скажите «какая сумма в колонке „Поступления“ за второй квартал, таблицей с разбивкой по месяцам». Нейросеть перестаёт гадать и считает точно по вашим полям.
Правило второе: указывайте, что считать и как показывать. Сумма, количество, доля, среднее, динамика. Ответ нужен таблицей, списком или текстом. Когда вы задаёте формат, ответ приходит готовым к использованию, а не требует переделки.
Правило третье: один вопрос в одном сообщении. Сложный вопрос из трёх частей нейросеть отвечает хуже, чем три отдельных вопроса. Разбили на части, получили три точных ответа, собрали сами. Это быстрее, чем переспрашивать.
Примеры слабого и сильного вопроса к одной таблице:
| Слабый вопрос | Сильный вопрос |
|---|---|
| Сколько выручки? | Какая общая выручка в колонке «Сумма» за май 2026 года? |
| Где проблемы? | Найди строки, где сумма закупки выросла более чем на 30% к прошлому месяцу, покажи таблицей |
| Собери отчёт | Сгруппируй по регионам: регион, сумма, доля, отсортируй по убыванию суммы |
| Что не так с дебиторкой? | Разбей задолженность на группы по срокам и покажи сумму и количество в каждой |
Разница видна сразу. Сильный вопрос содержит три элемента: колонка, период, формат ответа. На слабый вопрос модель отвечает общими словами, на сильный конкретными цифрами.
Когда вопрос сформулирован правильно, дальше работает техника уточнения. Нейросеть может не понять, что в вашей таблице «Начисления» это выручка, а «Списания» это расходы. Тогда добавьте одну строку в начало промпта: «Обрати внимание: колонка „Начисления“ это выручка, колонка „Списания“ это расходы. Считай по этим правилам».
Такое уточнение экономит кучу времени. Нейросеть не знает вашу бизнес-логику, но легко принимает её, если вы объяснили. Подробно про технику промптов для финансовых задач я писала в статье про продвинутый промпт-инжиниринг для финансиста.
Когда базовые вопросы пошли, переходим к главному приёму: замене сводных таблиц. Сначала короткое определение, чтобы дальше было проще.
Что такое сводная таблица и когда она нужна
Сводная таблица это инструмент Excel, который группирует данные по выбранным полям и считает итоги: суммы, количества, средние, доли. Вы выбираете строки, колонки и значения, и Excel собирает таблицу-срез. Классический пример: выручка по месяцам и регионам из общей таблицы продаж.
Сводные остаются нужным инструментом, спору нет. Но у них есть ограничения. Построение занимает время, настройка полей требует практики, а каждый новый срез это новая операция: добавить поле, передвинуть, пересчитать. Когда вопросов к данным много, сводные превращаются в цепочку ручных действий, которую хочется упростить.
ChatGPT закрывает эту нишу. Вы задаёте вопрос на русском, и нейросеть возвращает готовый срез, который раньше собирался в сводную. Подробная документация по сводным есть у Microsoft: Create a PivotTable to analyze worksheet data.
Мой подход такой. Сводные оставляю для постоянных отчётов, которые открываю регулярно и кручу вживую. А для разовых вопросов, которых у финансиста бывает десятки в день, использую нейросеть. Дальше показываю, как именно.
Как заменить сводные таблицы обычным вопросом
Классика сводных: выручка по месяцам и регионам, продажи по менеджерам, закупки по поставщикам. В 2026 году большую часть таких срезов можно получить вопросом к нейросети, и это работает быстрее.
Разница на практике. Сводную нужно построить, настроить поля, добавить проценты, обновить при изменении данных. Вопрос к ChatGPT формулируется за десять секунд, а ответ возвращается с готовой группировкой, долями и динамикой.
Вот промпт, который заменяет типовую сводную по выручке:
По таблице [загружаете файл] собери выручку по срезам.

1. Сгруппируй выручку по месяцам: месяц, сумма,
   доля от общей выручки, рост к предыдущему месяцу.
2. Сгруппируй выручку по регионам: регион, сумма,
   доля от общей выручки.
3. Сделай таблицу месяц x регион: строки месяцы,
   колонки регионы, в ячейках суммы.

Формат: три таблицы, потом краткий вывод,
какой регион и месяц дают больше всего выручки.
Все расчёты покажи в таблицах, без округления до целых.
Такой промпт возвращает три готовых среза, которые раньше собирались в три сводные. Проценты и динамику нейросеть считает сама, вам остаётся прочитать вывод и принять решение.
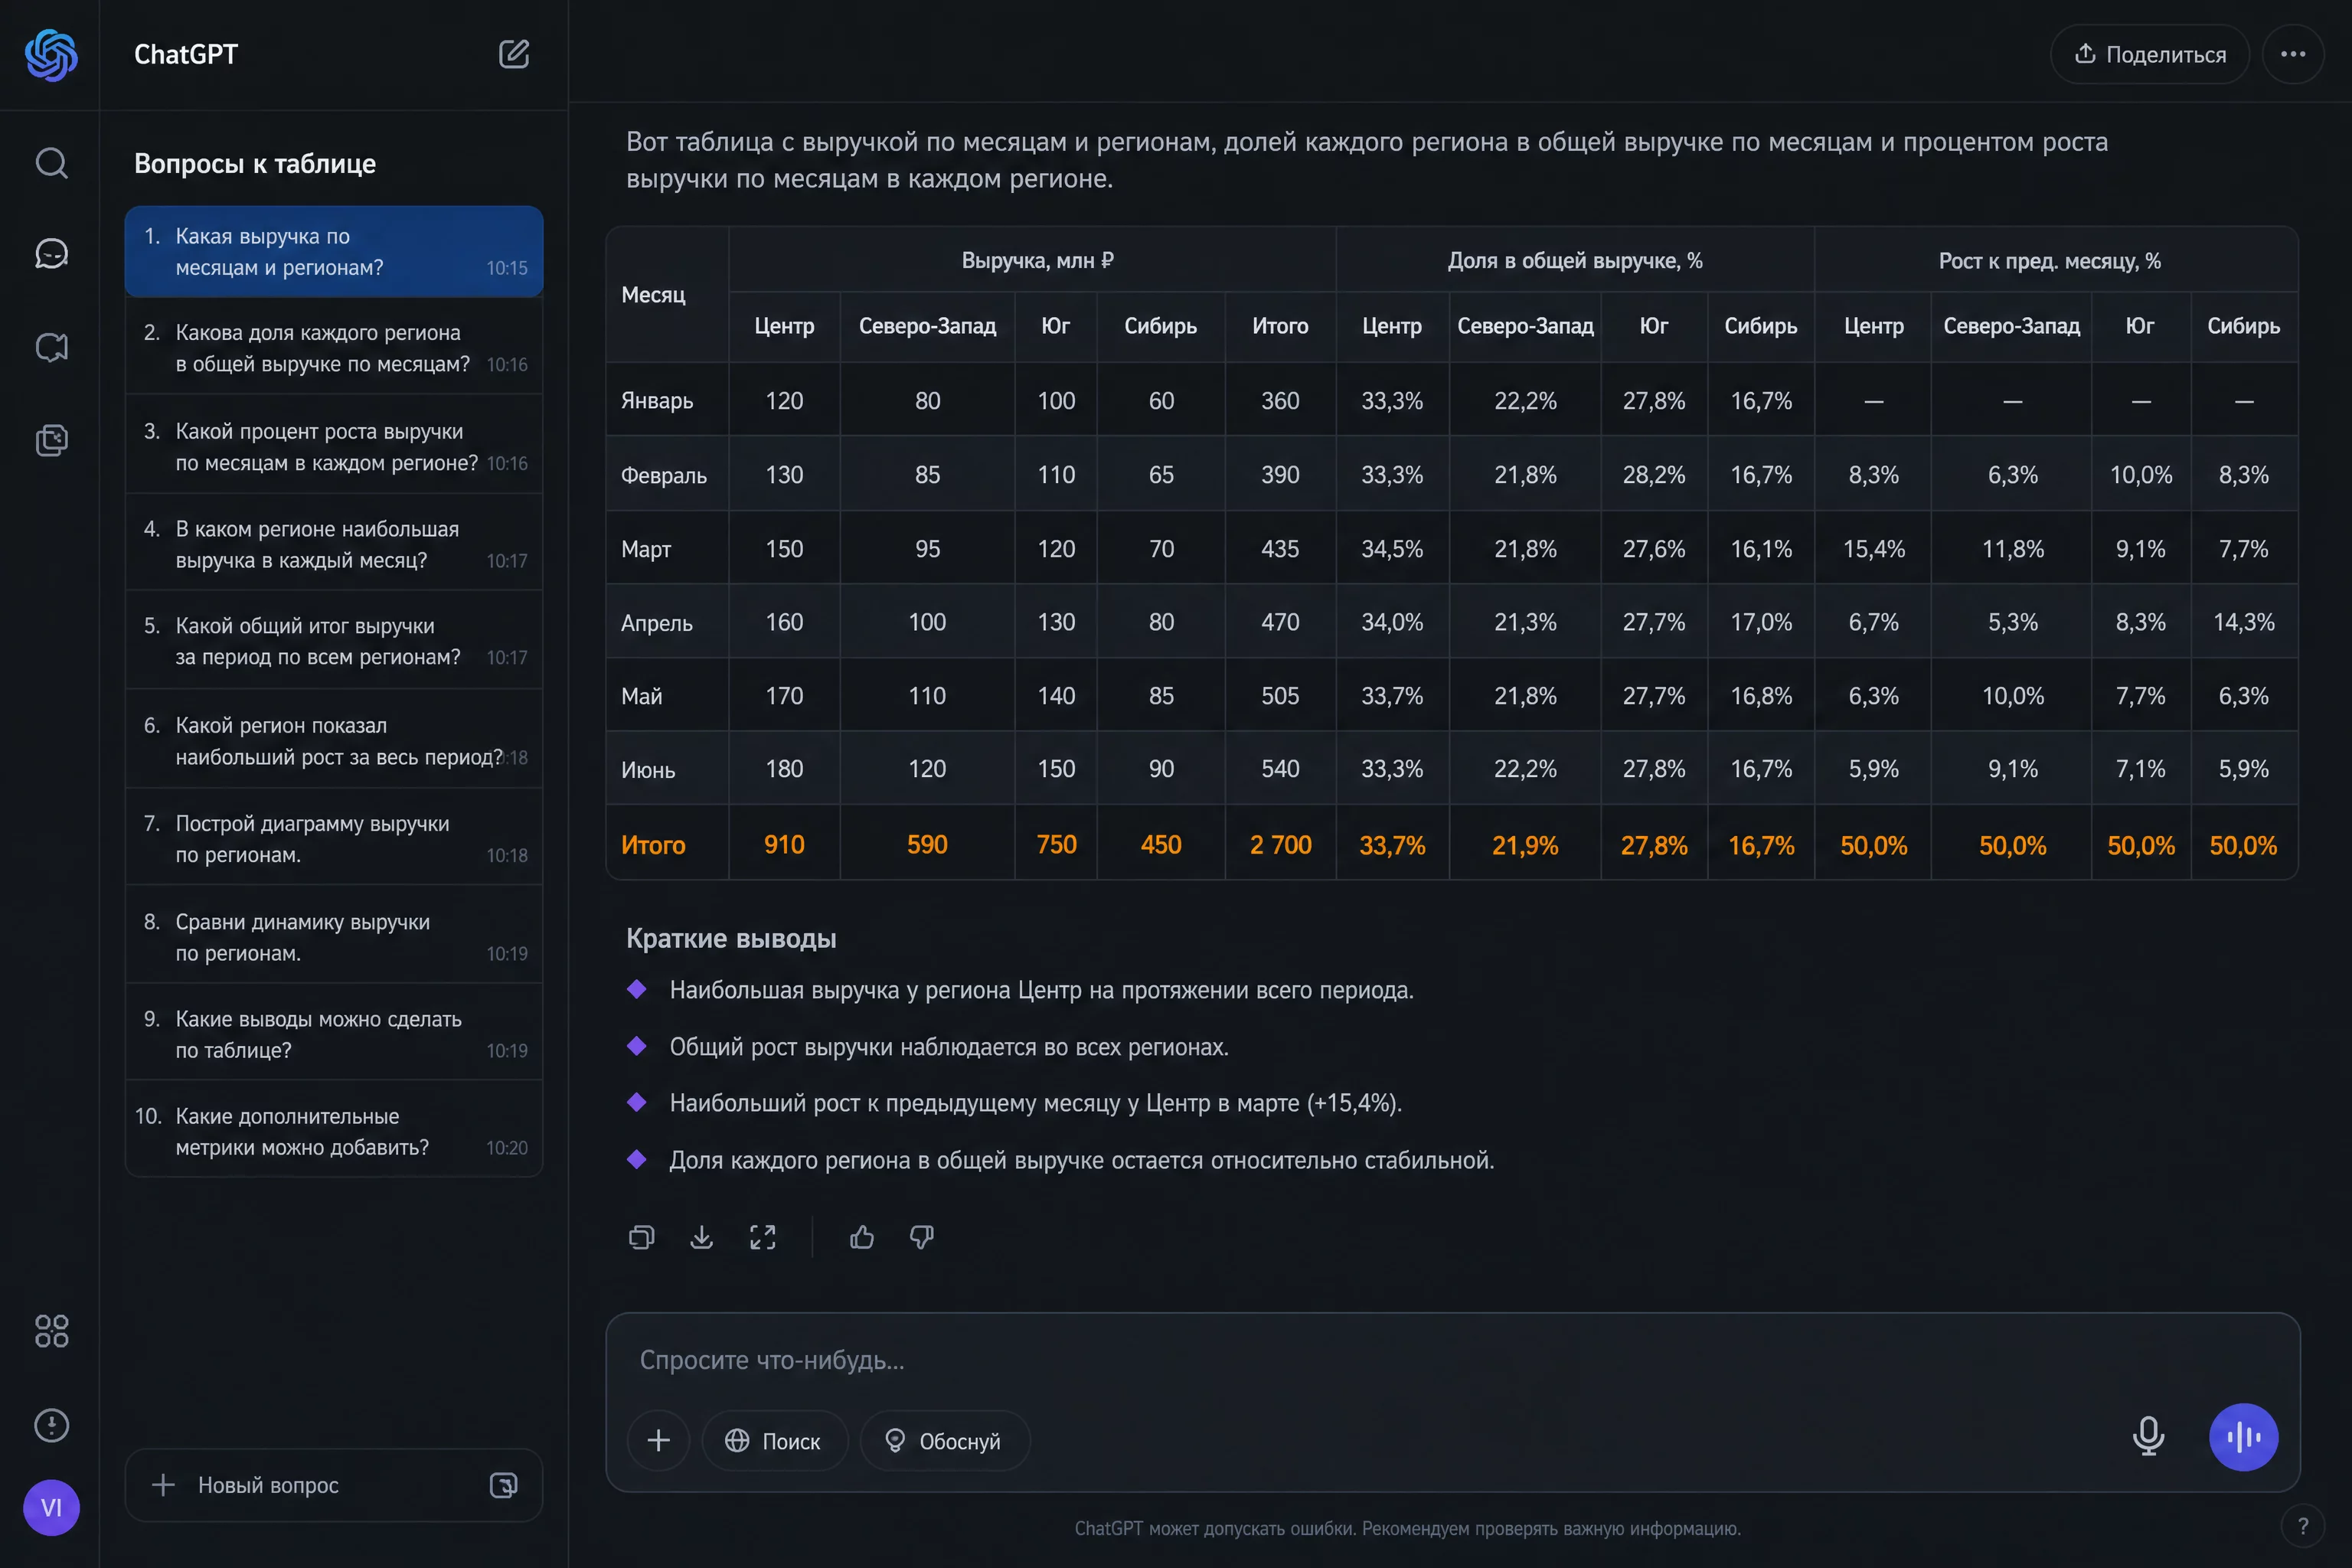
Важный нюанс. ChatGPT не заменяет сводные для постоянных отчётов, которые вы открываете каждый месяц и крутите вживую. Он незаменим для разовых срезов и нестандартных вопросов: быстро спросили, получили, пошли дальше. Для регулярных дашбордов оставляйте Excel, а для решений используйте вопросы.
Сравнение в таблице, когда что использовать:
| Задача | Сводная в Excel | Вопрос к ChatGPT |
|---|---|---|
| Постоянный отчёт, который смотрите ежемесячно | Да, раз настроили и обновляете | Редко, каждый раз заново |
| Разовый срез «сколько было в мае по регионам» | Минуты на настройку | Десять секунд на вопрос |
| Нестандартный вопрос «найди аномалии» | Сводная не ответит | Вопрос решает за раз |
| Глубокий анализ с несколькими уровнями | Удобно, всё на одном листе | Работает, но диалог длиннее |
| Дашборд для руководителя | Да, это его инструмент | Как источник цифр для слайда |
Сводные бывают с несколькими уровнями: по регионам внутри месяцев, по продуктам внутри филиалов. Такие вопросы тоже работают, достаточно попросить «двухуровневую группировку: выручка по месяцам, внутри каждого месяца по каналам продаж, с итогами на каждом уровне и процентами к общему итогу». Сводные с фильтрами по времени, например «по кварталам и внутри по продуктам», собираются одним вопросом: добавьте в промпт строку про вложенность и нужные итоги, и нейросеть вернёт структуру, которую раньше настраивали полями в сводной.
Теперь про самый частый страх: а что делать, если таблица огромная и не помещается в окно ChatGPT.
Большие таблицы: что делать, если файл не влезает в окно
Лимит у ChatGPT не только по размеру файла, но и по практической пользе: чем больше данных в одном сообщении, тем выше шанс, что модель что-то упустит. Поэтому для больших таблиц я использую нарезку. Процесс простой и надёжный.
Шаг первый: режьте по периодам или листам. Если в книге выгрузка за год, разбейте на четыре квартала или на двенадцать месяцев. Сохраните структуру колонок без изменений, чтобы вопросы к каждой части были одинаковыми.
Шаг второй: выгружайте в CSV. Файл CSV без оформления весит в разы меньше Excel с форматированием. Если таблица не помещается, конвертируйте лист в CSV, и проблема часто уходит сама.
Шаг третий: задавайте одинаковые вопросы к каждой части. Спросили по первому кварталу, получили, спросили по второму. Потом соберите результаты одним промптом:
Перед тобой результаты по четырём кварталам [вставляете
каждый ответ отдельным блоком или прикладываете файлы].

Собери их в единую таблицу:
1. месяц, сумма выручки за месяц, квартал
2. добавь долю каждого месяца в квартале
3. добавь рост к предыдущему месяцу

Формат: итоговая таблица на весь год, потом вывод
о динамике по месяцам.
Есть и другой путь для больших файлов: оставить в таблице только нужные колонки. Часто в выгрузке десятки служебных полей, которые раздувают файл и путают модель. Удалите всё лишнее, оставьте то, что относится к вопросу, и файл резко похудеет.
Для сверхбольших данных, которые не режутся, есть отдельная техника: вы описываете структуру таблицы словами, а нейросеть пишет код для расчёта, который вы запускаете сами. Например, вы рассказываете, что в колонках, и просите написать скрипт, который посчитает нужные итоги. Это уже ближе к программированию, но нейросеть пишет код за вас, остаётся только запустить.
Как понять, что таблицу пора резать. Три признака: загрузка файла занимает больше минуты, нейросеть отвечает общими фразами вместо конкретных цифр, ответы на одинаковые вопросы различаются от раза к разу. Если заметили хотя бы один признак, режьте файл. Подробнее про автоматизацию Excel через нейросети, включая генерацию формул и макросов, я писала в статьях про Excel и ChatGPT и про написание VBA-макросов.
Теперь главный приём против ошибок в цифрах.
Как заставить ChatGPT пересчитывать цифры и проверять себя
Нейросеть может ошибаться в арифметике, и самый надёжный способ это ловить пересчётом на Python прямо в диалоге. Вы просите модель пересчитать итоги независимым способом, с построчным выводом промежуточных результатов. Внешний код проверяет внутреннюю логику модели: если она ошиблась в рассуждении, код покажет расхождение.
Почему это работает. Когда модель отвечает текстом, она выдаёт вероятный результат, а не точный расчёт. Когда она запускает код, расчёт выполняется машиной по правилам. Два независимых способа, которые сходятся, почти наверняка верны. Это как сделать расчёт двумя разными способами в Excel.
Критический промпт для проверки итогов:
Перед тобой таблица [загружаете файл].

Пересчитай все ключевые суммы на Python независимо.
Для каждой:
1. собери нужные строки из исходных данных
2. посчитай сумму, среднее, долю
3. сравни с ответом, который ты дал раньше
4. выведи построчно: что считал, какие строки брал,
   результат, разница

Потом выведи список расхождений, если они есть.
Не подгоняй расчёт под предыдущие ответы.
Считай по данным, а не по своим итогам.
Используйте этот промпт после каждого важного расчёта перед тем, как цифра уйдёт в отчёт. На практике он ловит большинство арифметических ошибок, потому что заменяет вероятностный ответ точным вычислением.
Есть и более простой приём, который я советую всем: проверять контрольные суммы в Excel. Нейросеть дала ответ, вы свернули к нужному листу, посмотрели сумму по колонке, сравнили. Пять секунд на один итог, зато никакой магии.
Полная схема проверки данных, включая логические ошибки, когда расчёт верен, но считает не то, разобрана в статье про галлюцинации нейросетей в финансовых данных. Рекомендую прочитать вместе с этим материалом.
Как ChatGPT считает внутри: анализ данных и код Python
Чтобы понимать, где нейросети доверять, а где проверять, полезно знать, как устроен расчёт. В ChatGPT есть два режима работы с таблицами, и разница между ними объясняет большинство странных ответов.
Первый режим: модель считает по данным напрямую. ChatGPT читает файл, видит таблицу и выдаёт ответ текстом, опираясь на прочитанные значения. Этот режим быстрый, но на больших данных и сложных группировках возможны ошибки, потому что модель выдаёт вероятный результат, а не точное вычисление.
Второй режим: модель запускает код Python. В платной подписке есть встроенный анализ данных, который выполняет код прямо в диалоге. Модель пишет скрипт, машина его исполняет, и ответ строится на реальном расчёте. Этот режим точнее на порядок, поэтому для ключевых цифр я всегда прошу пересчёт на Python.
Как понять, какой режим сработал. Если под ответом есть блок с кодом и выводом, значит, был запущен Python. Если ответ пришёл просто текстом без кода, это вероятностный расчёт, и его стоит проверить. Для ответственных цифр всегда просите пересчёт явно, промпт из раздела про проверку это делает.
В 2026 году работа с кодом внутри чата стала стандартом для серьёзных моделей. GPT-5.5 запускает Python в диалоге, Claude Sonnet 4.6 умеет работать с файлами и большими документами, Gemini 2.5 удобен в Google Таблицах. Даже бесплатный DeepSeek справляется с простыми расчётами. Поэтому навык «попросить модель проверить себя кодом» сейчас важнее, чем знание конкретной модели.
Когда код запущен, вы можете просить не только суммы, но и более сложные вещи: проверить выборку, посчитать средние по группам, найти выбросы, построить простую визуализацию. Модель генерирует код, запускает его и показывает результат. Всё, что от вас нужно, это правильно сформулировать задачу на русском языке.
Про построение отчётов и визуализаций через нейросети я писала в статье про Power BI и DAX с ChatGPT. Там показано, как нейросеть помогает собирать дашборды и писать формулы мер, это логичное продолжение работы с данными.
Банк готовых промптов для финансовых таблиц
Здесь собрала промпты, которые закрывают типовые финансовые задачи. Копируйте, подставляйте свои данные, меняйте формулировки под свои таблицы. Каждый промпт проверен в работе с учениками.
Дебиторка по срокам. Вместо ручной разбивки на просрочку:
По таблице дебиторской задолженности [загружаете файл]
сгруппируй долги по срокам:
1. до 30 дней
2. 31-60 дней
3. 61-90 дней
4. 91-180 дней
5. более 180 дней

Для каждой группы: количество дебиторов, сумма,
доля от общей задолженности.
Потом выдели топ-5 дебиторов с самой большой
просрочкой свыше 90 дней.
Формат: таблица групп, потом список топ-5 с суммами.
Аномалии в данных. Когда нужно найти странное до того, как оно ударит по отчёту:
Найди аномалии в таблице [загружаете файл].
Проверь по каждому столбцу с числами:
1. выбросы, которые сильно отличаются от среднего
2. резкие скачки к предыдущему периоду
3. отрицательные значения там, где их не должно быть
4. дубли строк
5. пропуски в ключевых колонках

Для каждой аномалии: строка, значение, почему это
подозрительно. Потом отдельно список того, что стоит
проверить человеку в первую очередь.
Сверка двух таблиц. Когда привезли две выгрузки и нужно понять, где разошлось:
У меня две таблицы [загружаете файлы].
Найди расхождения между ними:
1. строки, которые есть в одной, но нет в другой
2. суммы, которые не совпадают по одинаковым ключам
3. итоги по каждой таблице отдельно и разницу

Формат: три таблицы, потом вывод, где именно разошлось.
Ключ для сопоставления: [название колонки].
Объяснение непонятной таблицы. Когда прислали файл от аналитика, а вы видите его первый раз, попросите нейросеть объяснить: «Перед тобой таблица, которую сделал другой человек. Объясни, что означают колонки и строки, какая логика в значениях, есть ли итоги и как они считаются, какие выводы из неё можно сделать. Если что-то нелогично, скажи прямо, разбор по пунктам, потом вывод».
Проверка себестоимости. Когда нужно быстро понять, где маржа уходит в минус:
По таблице с себестоимостью [загружаете файл] посчитай:
1. себестоимость по каждому продукту и маржу
2. маржинальность в процентах к цене
3. продукты с отрицательной маржой
4. динамику маржинальности по кварталам

Формат: таблица продуктов с маржой, список убыточных,
потом вывод, какие продукты тянут прибыль вниз.
Прогноз по тренду. Когда нужно быстро прикинуть, куда идёт показатель, попросите: «По таблице помесячных значений построй простой прогноз на 3 месяца вперёд: покажи динамику за период, посчитай средний темп роста, экстраполируй на следующие 3 месяца, отметь, где прогноз может быть неточным. Формат: таблица с историей и прогнозом, потом список допущений».
Сверка прайса поставщика. Когда привезли новый прайс и нужно найти изменения, используйте промпт: «Сравни два прайса по ключу [артикул или название]. Найди позиции, которых не было в старом прайсе, позиции, которых нет в новом, позиции с изменённой ценой (старая, новая, разница) и позиции с ростом цены более чем на 15%. Формат: таблица изменений, потом список позиций с критичным ростом цены».
Подготовка ответа руководителю. Когда вопрос задали, а данных в голове нет, попросите: «По таблице подготовь ответ руководителю на вопрос [вставляете вопрос]. Ответ должен содержать прямую цифру в первой строке, обоснование с расчётом, динамику к прошлому периоду, один вывод и одну рекомендацию. Формат: текст на 5-7 предложений, готовый к отправке в мессенджере, без воды».
Эти промпты закрывают почти все повседневные задачи: долги, аномалии, сверки, чужие файлы, себестоимость, прогнозы, прайсы и ответы руководителю. Дальше в разделе про сравнение моделей показываю, какой инструмент выбрать, если таблицы сложные и большие.
Короткий словарь: CSV, нормализация, пересчёт на Python
В статье встречаются термины, которые могут звучать страшно. Разберу главные простыми словами, чтобы дальше не было вопросов.
CSV это текстовый формат таблицы, где значения разделены запятыми или точками с запятой. Excel открывает такие файлы без проблем, а весят они меньше, чем xlsx с оформлением. Для загрузки в нейросеть CSV часто удобнее именно из-за лёгкости.
Нормализация это приведение данных к единому виду: одинаковые названия, один формат дат, числа без символов. Нормализованная таблица отвечает на вопросы точно, ненормализованная даёт случайные ответы.
Пересчёт на Python это способ заставить нейросеть проверить себя кодом. Модель пишет скрипт, скрипт исполняется, и ответ строится на реальном расчёте, а не на вероятности. Для ключевых цифр это обязательный шаг.
Сводная таблица это инструмент Excel для группировки данных: вы выбираете строки и колонки, Excel считает итоги. Понятие подробно разобрано в разделе выше.
Обезличивание это замена названий контрагентов, ИНН, счетов и ФИО на маски. Суммы остаются, привязка к компаниям и людям уходит. Это главное правило безопасности при загрузке данных в нейросеть.
Эти пять терминов закрывают девяносто процентов словаря, который встречается в работе с таблицами через нейросети. Остальное вы будете добавлять по ходу, когда столкнётесь с конкретной задачей.
Сравнение моделей: ChatGPT, Claude, Gemini, DeepSeek
Для вопросов по таблицам выбор модели заметно влияет на результат. Я сравнивала их на одинаковых задачах: загрузка файла, группировка, расчёт процентов, проверка итогов на Python.
| Модель | Файлы и Python | Сильные стороны | Слабые стороны | Для каких задач |
|---|---|---|---|---|
| GPT-5.5 | Загрузка Excel, CSV, PDF, код Python в диалоге | Лучший универсал, понимает русские вопросы, работает с файлами из коробки | На очень длинных книгах может терять фокус | Основная рабочая модель для вопросов по таблицам |
| Claude Sonnet 4.6 | Загрузка файлов, большой контекст | Точнее на сложных многошаговых вопросах, держит длинные документы | Реже удобен для кода Python в чате | Сложные вопросы и длинные книги |
| Gemini 2.5 | Работает с Google Таблицами напрямую | Удобен, когда данные живут в Google Sheets | Менее предсказуем на многошаговой логике | Вопросы прямо в Google Таблицах |
| DeepSeek V3.2 | Загрузка файлов, бесплатный | Бесплатный, работает без обхода блокировок | Только обезличенные данные, черновые расчёты | Черновик и разовые задачи |
Актуально на август 2026 года. Цены подписок меняются, актуальные тарифы смотрите на официальных сайтах: chatgpt.com, claude.ai, gemini.google.com. Подробнее про выбор бесплатных моделей для таблиц в статье про сравнение бесплатных нейросетей для Excel, про DeepSeek отдельно в материале про DeepSeek для Excel.
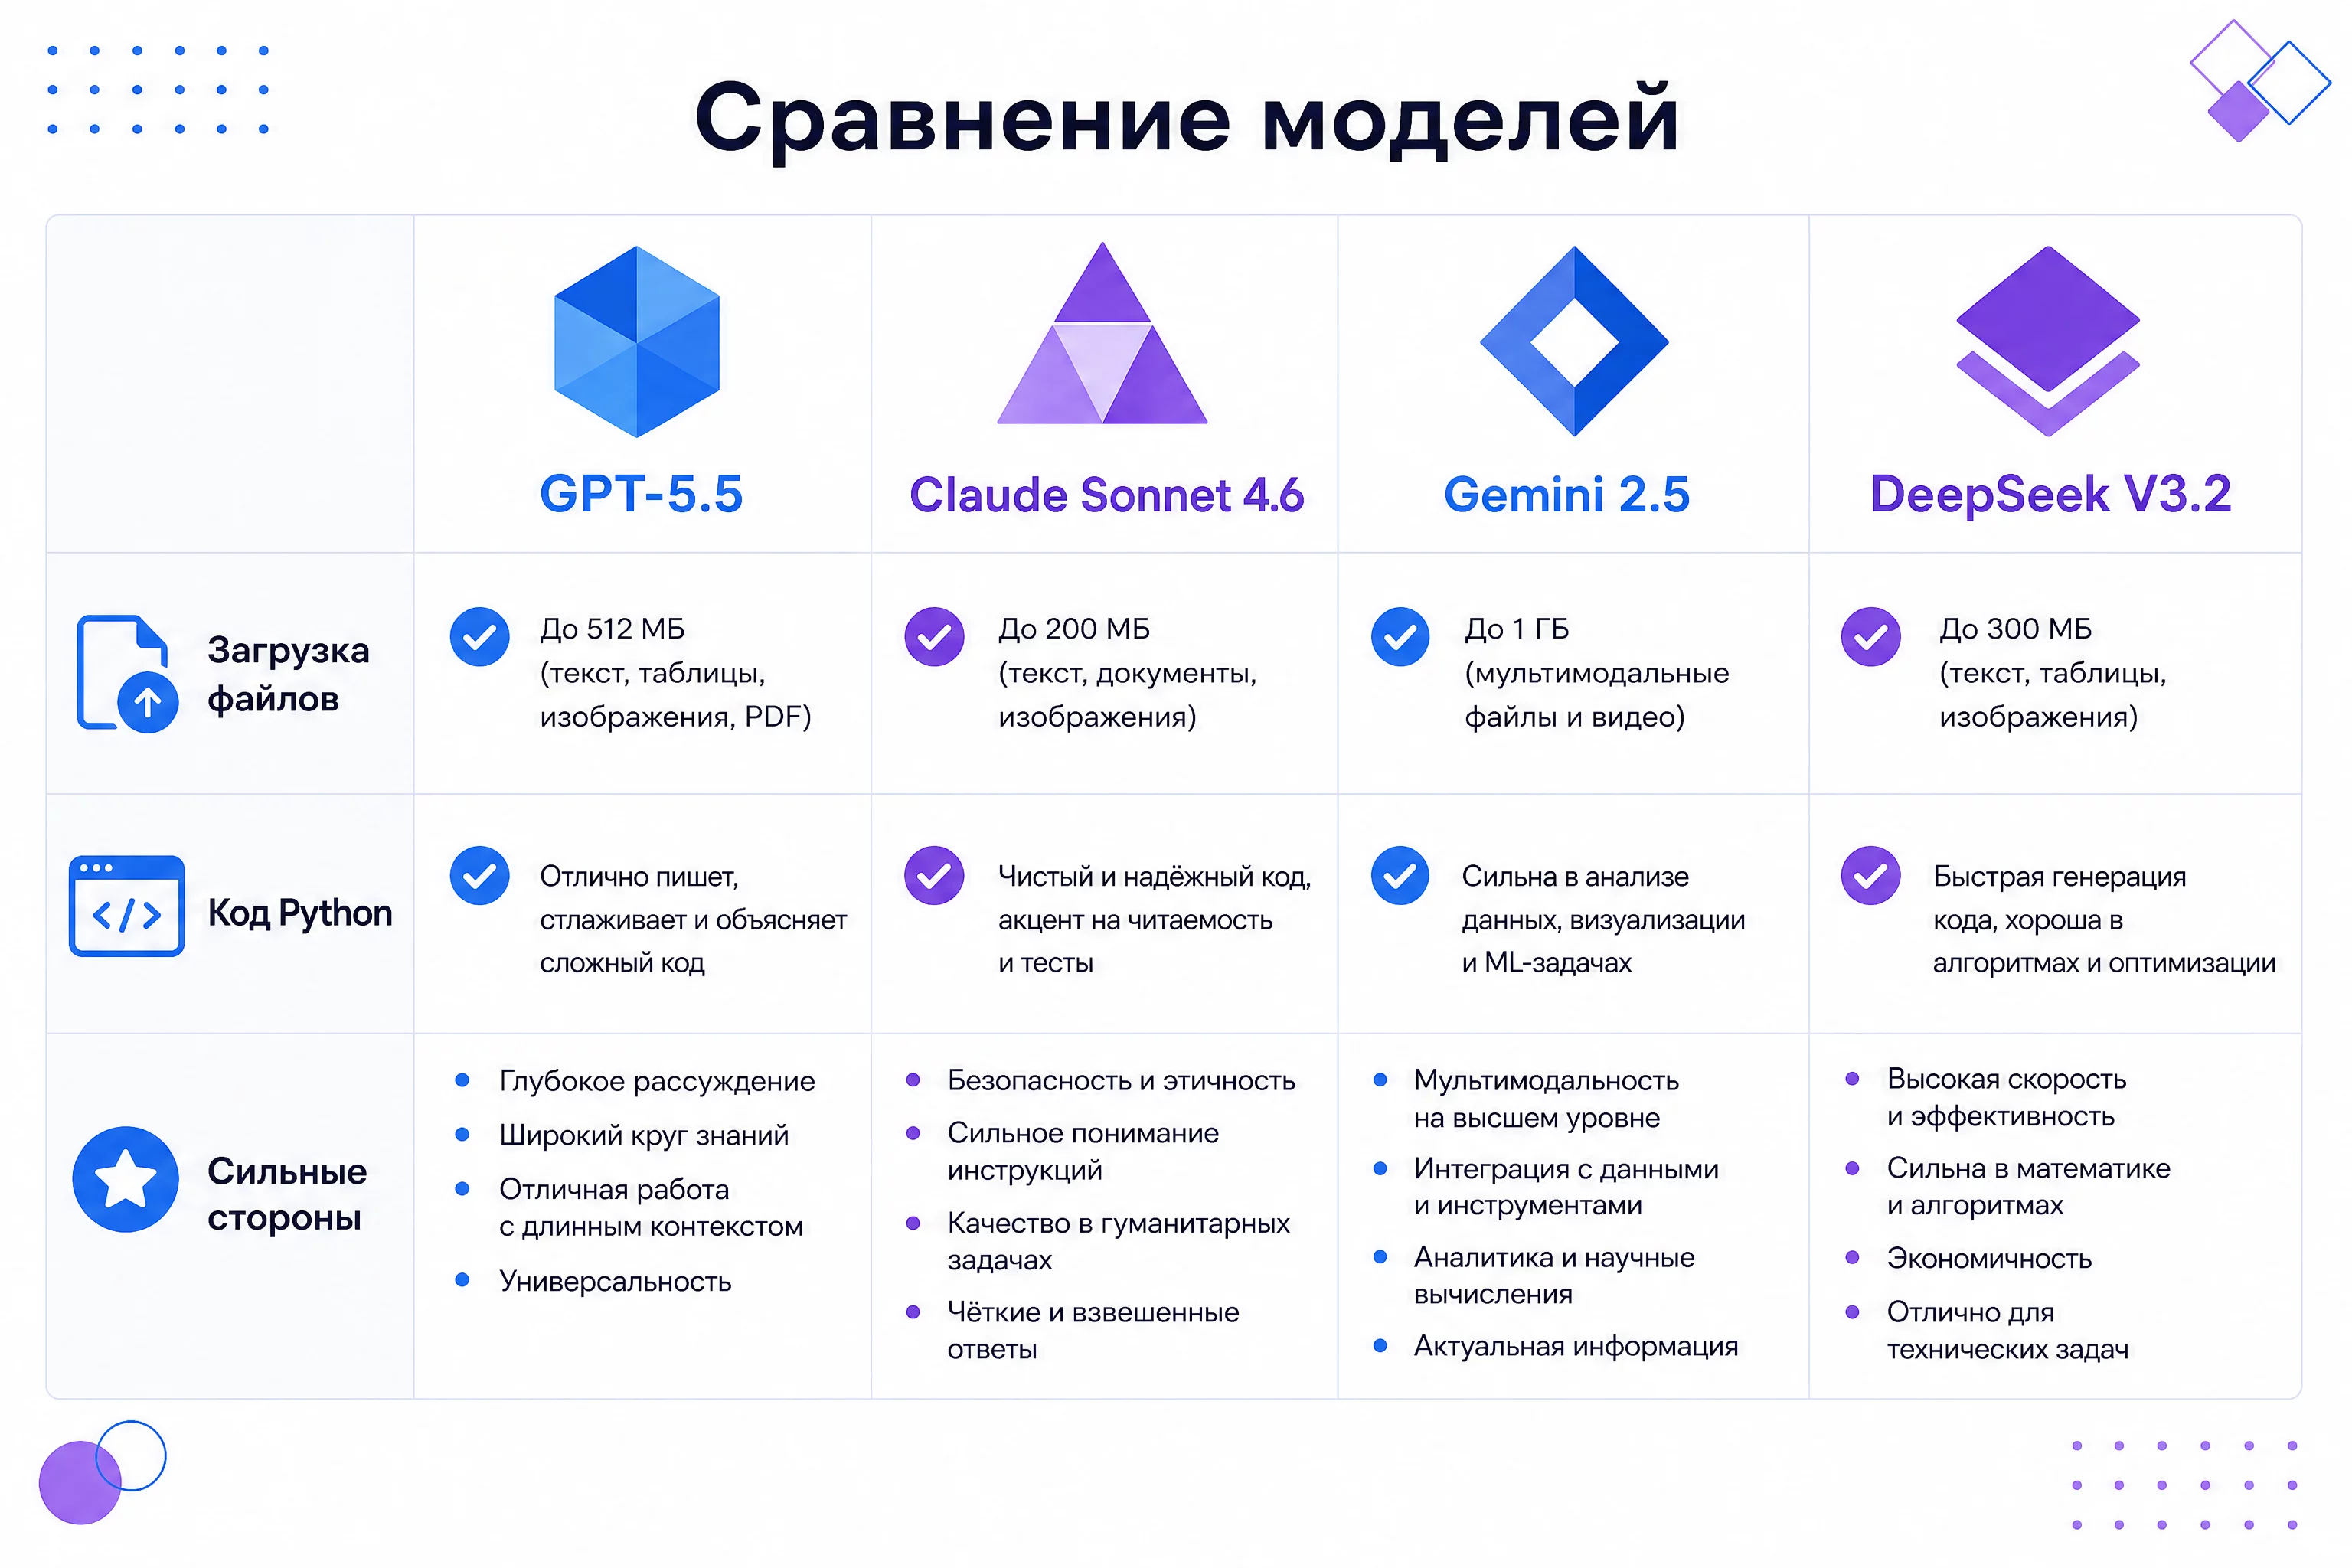
Для большинства финансовых задач рабочая связка такая: GPT-5.5 как основной инструмент, Claude Sonnet 4.6 для сложных книг, Gemini 2.5 если данные в Google Таблицах, DeepSeek бесплатно для черновиков на обезличенных данных. Если ваши таблицы живут в Google Sheets, попробуйте Gemini напрямую: он работает в таблице без выгрузки файлов. Подробнее в статье про автоматизацию Google Таблиц через ChatGPT.
Три кейса из практики: часы, рубли, проценты
Показываю на реальных задачах, которые разбирали с учениками. Цифры честные, из замеров, а не из рекламных обещаний.
Кейс 1. Управленческий отчёт за 25 минут вместо 6 часов.
Финансовый директор торговой компании перед встречей с собственником собирал отчёт по продажам: выручка по месяцам, регионам и каналам, динамика, доли. Раньше он строил три сводные, вручную добавлял проценты и готовил слайды. На это уходило примерно полдня.
Что сделали: подготовили таблицу, обезличили, загрузили в ChatGPT и задали три вопроса: свод по месяцам с долями, свод по регионам, таблица месяц на регион. Нейросеть вернула три готовые таблицы за несколько минут. Осталось перенести их в презентацию. Итог: 25 минут вместо 6 часов. Экономия более 90 процентов времени на подготовку отчёта.
Кейс 2. Проверка закупок за 30 минут вместо полного дня.
Главный бухгалтер перед закрытием месяца проверяла выгрузку закупок: около 9 000 строк по поставщикам, товарам и ценам. Вопрос был простой: нет ли дублей, завышенных цен и странных скачков по сравнению с прошлым месяцем.
Загрузили таблицу, задали вопрос про аномалии, потом отдельно про сверку с прошлым месяцем. Нейросеть нашла 14 дублей на общую сумму около 47 000 рублей и три поставщика, у которых цены выросли более чем на 30 процентов за месяц. Проверка заняла 30 минут вместо полного дня выборочного просмотра строк. Дубли ушли в пересчёт с поставщиками, переплату вернули.
Кейс 3. Разбор маржинальности за час вместо двух дней.
Финансовый директор производственной компании готовил решение по ассортименту: какие продукты тянут прибыль, а какие убыточны. В таблице было 40 продуктов с себестоимостью, ценами и объёмами продаж за полгода.
Вопросы к таблице: маржинальность по каждому продукту, динамика по кварталам, продукты с отрицательной маржой. ChatGPT собрал расчёт за несколько минут. Выяснилось, что продукт Б давал отрицательную маржу на протяжении трёх месяцев подряд и тянул вниз общий результат примерно на 100 000 рублей в месяц. Решение об отказе от направления сэкономило около 1,2 миллиона рублей в год. На разбор ушёл час вместо двух дней ручных расчётов.
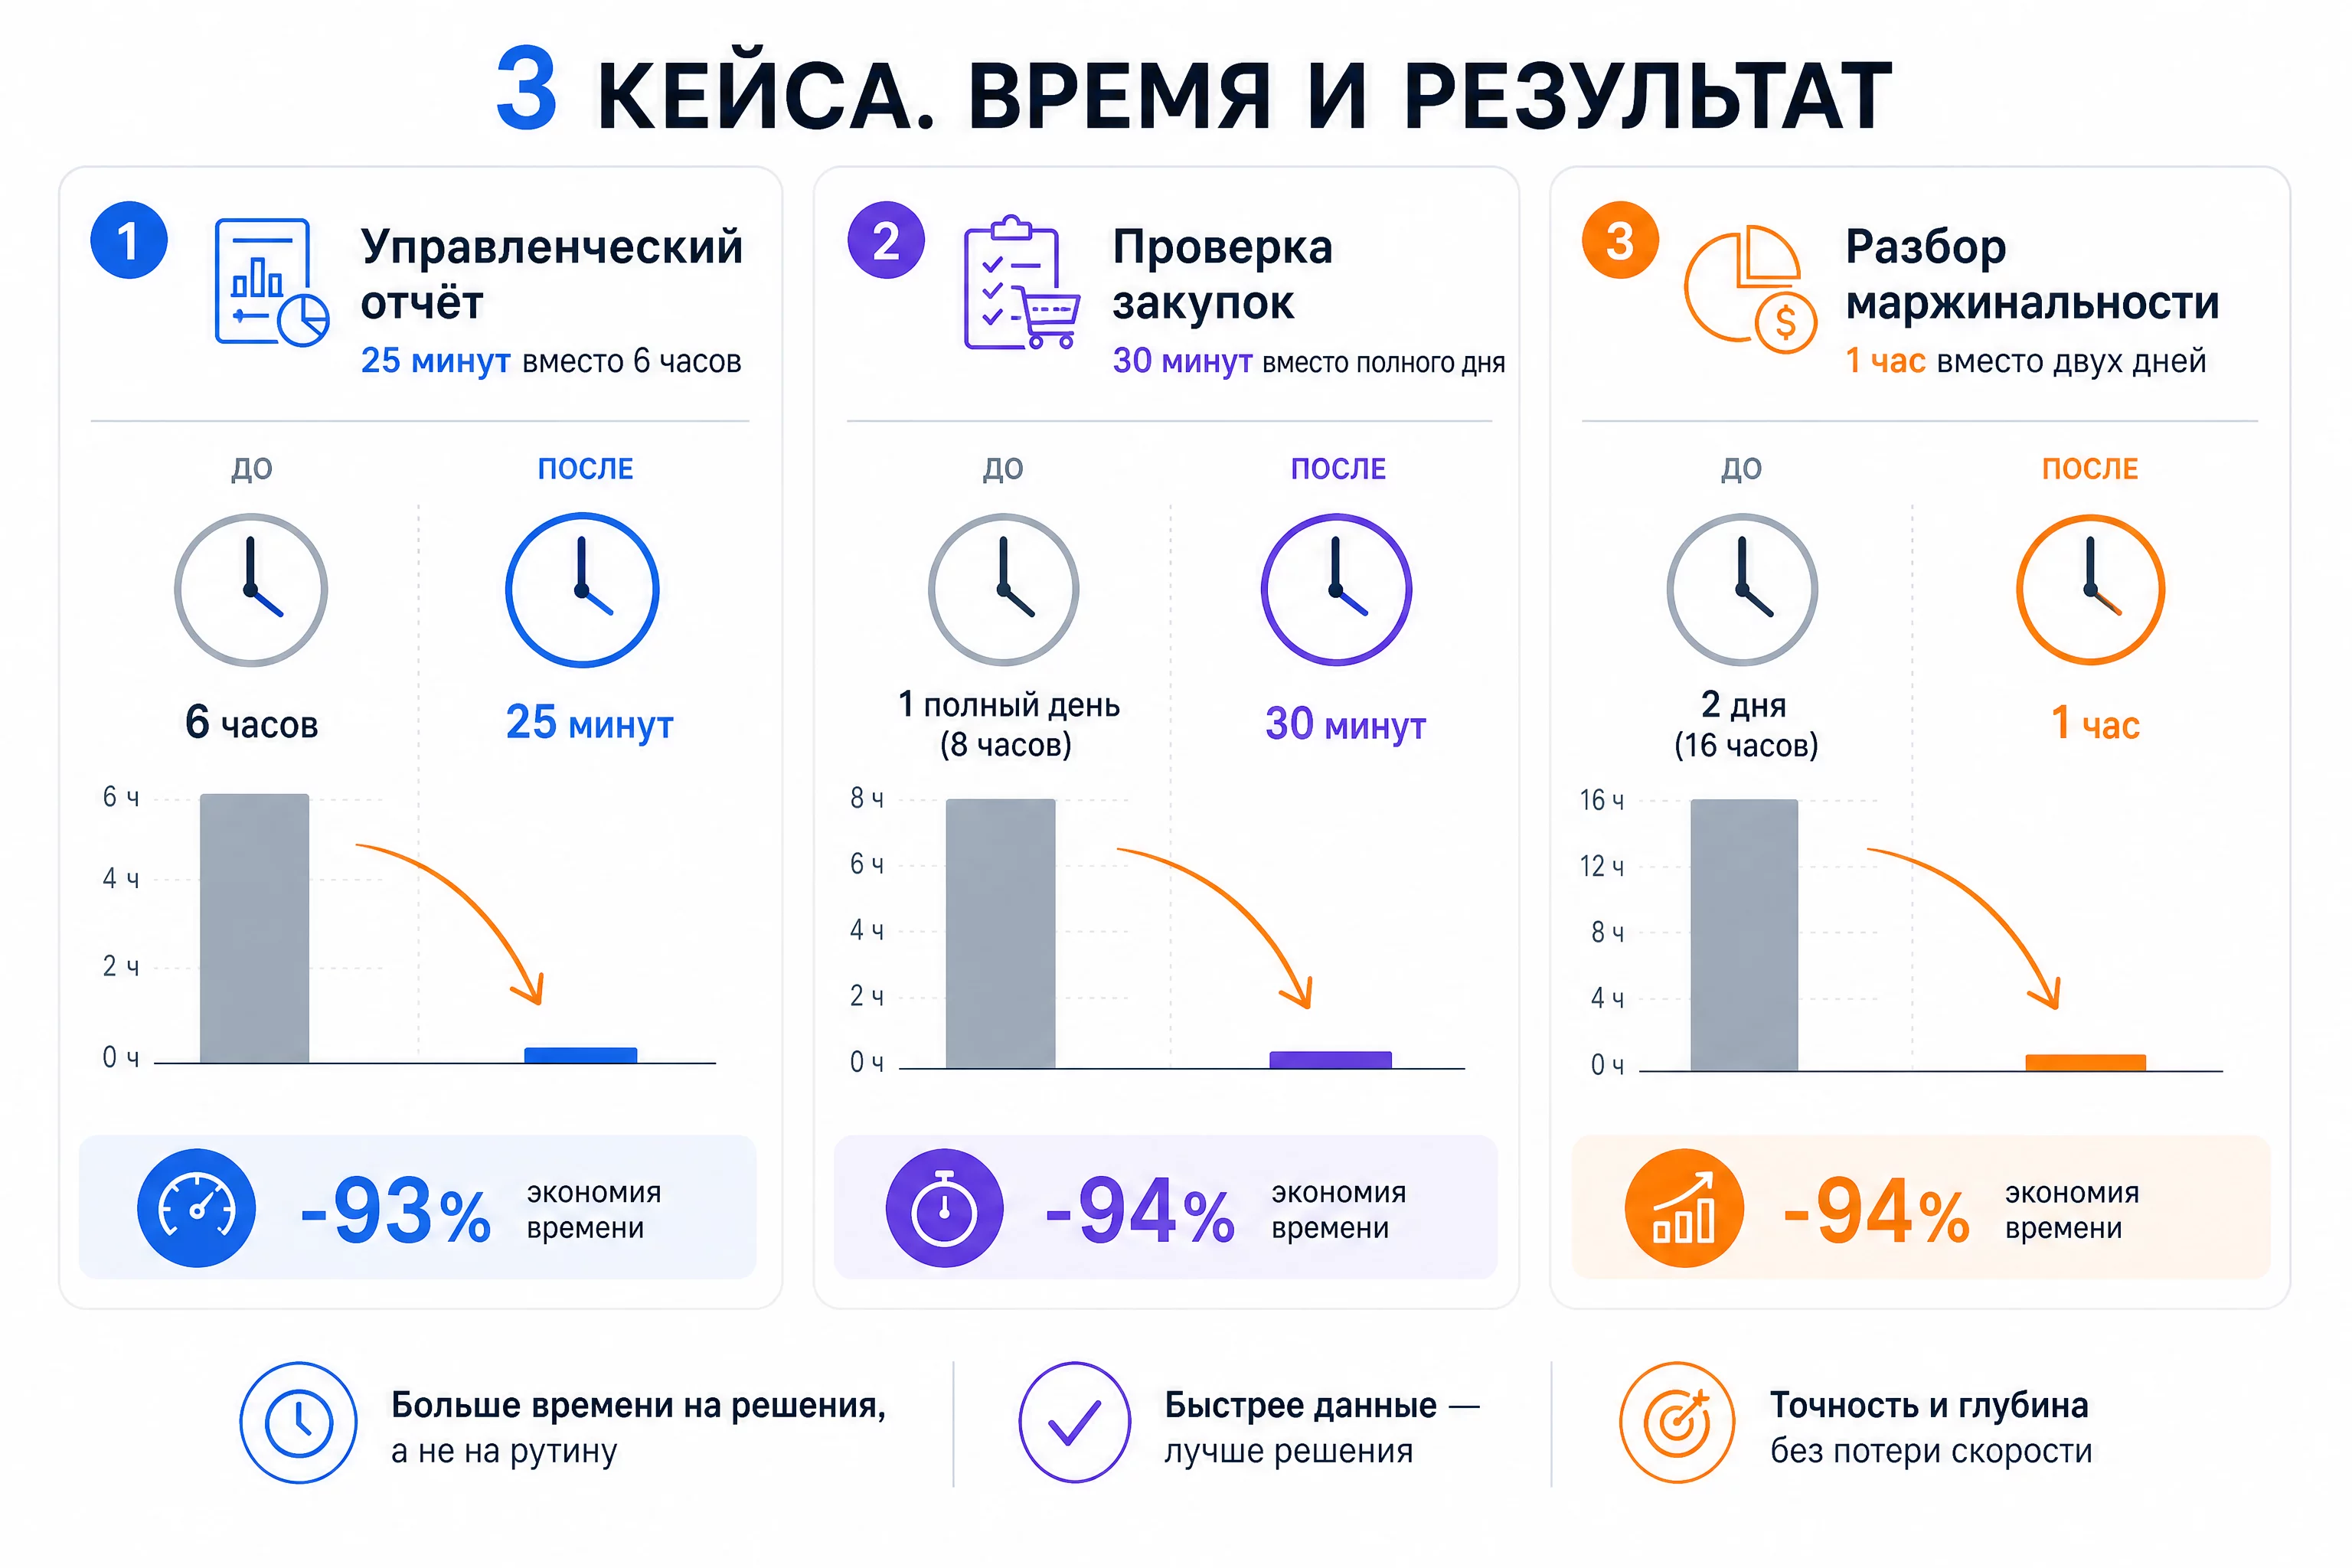
Общий вывод по кейсам. Экономия от 80 до 95 процентов времени на подготовку данных, а главная ценность в том, что решения принимаются на свежих цифрах, а не на вчерашних выгрузках. Про полный цикл закрытия месяца через нейросети я писала в статье про закрытие месяца с ChatGPT.
Когда нейросеть бесполезна: границы метода
Честно про ограничения, чтобы не было ложных ожиданий. Есть задачи, где вопросы к нейросети не работают или работают плохо.
Точные данные с подписью. Если таблица уходит в налоговую или банк и за неё расписывается человек, нейросеть может помогать с подготовкой, но не с подписью. Финальная проверка и ответственность всегда на человеке.
Сложные межлистовые расчёты. Книги, где листы ссылаются друг на друга и итоги зависят от порядка пересчёта, нейросеть читает как набор значений. Для анализа связей между листами лучше использовать встроенные инструменты Excel и аудит формул, про это статья про аудит формул.
Данные в реальном времени. ChatGPT отвечает по тому файлу, который вы загрузили. Живые курсы, котировки и обновляемые данные он не подтягивает сам. Для этого есть сервисы с подключением к источникам, а нейросеть работает со снимком данных.
Распознавание с фото низкого качества. Плохой скан, размытое фото, рукописный почерк дают ошибки распознавания. Итоги по таким данным нужно перепроверять построчно.
Понимание границ экономит больше времени, чем сами промпты. Когда вы знаете, где нейросеть сильна, а где нет, вы не тратите время на проверку ненужного и не пропускаете то, что проверить обязательно.
Ошибки и мифы: где ChatGPT в таблицах врёт
Вижу одни и те же ошибки у тех, кто начинает работать с таблицами через нейросеть. Пять штук, все легко обходятся.
1. Грузить грязную таблицу и ждать точных ответов. Разные названия, даты вперемешку, объединённые ячейки. Нейросеть делает лучшее, что может, но ответ получается примерным. Подготовка это половина результата.
2. Задавать один общий вопрос и верить первой цифре. «Сколько у нас выручки?» без указания периода и колонки даст случайный срез. Конкретный вопрос с периодом и форматом ответа даёт конкретный результат.
3. Не проверять итоги пересчётом. Текст ответа это вероятностный результат. Проверка на Python и контрольные суммы в Excel занимают минуты, а защищают от ошибок в отчёте.
4. Загружать чувствительные данные без обезличивания. Названия контрагентов, ИНН, счета и ФИО в публичный тариф не грузятся. Только маски, только после отключения обучения в настройках.
5. Путать ответ нейросети с финальным решением. ChatGPT это быстрый аналитик, а не подпись под документом. Ключевые цифры сверяются, решения принимает человек.
Теперь про мифы, которые мешают начать.
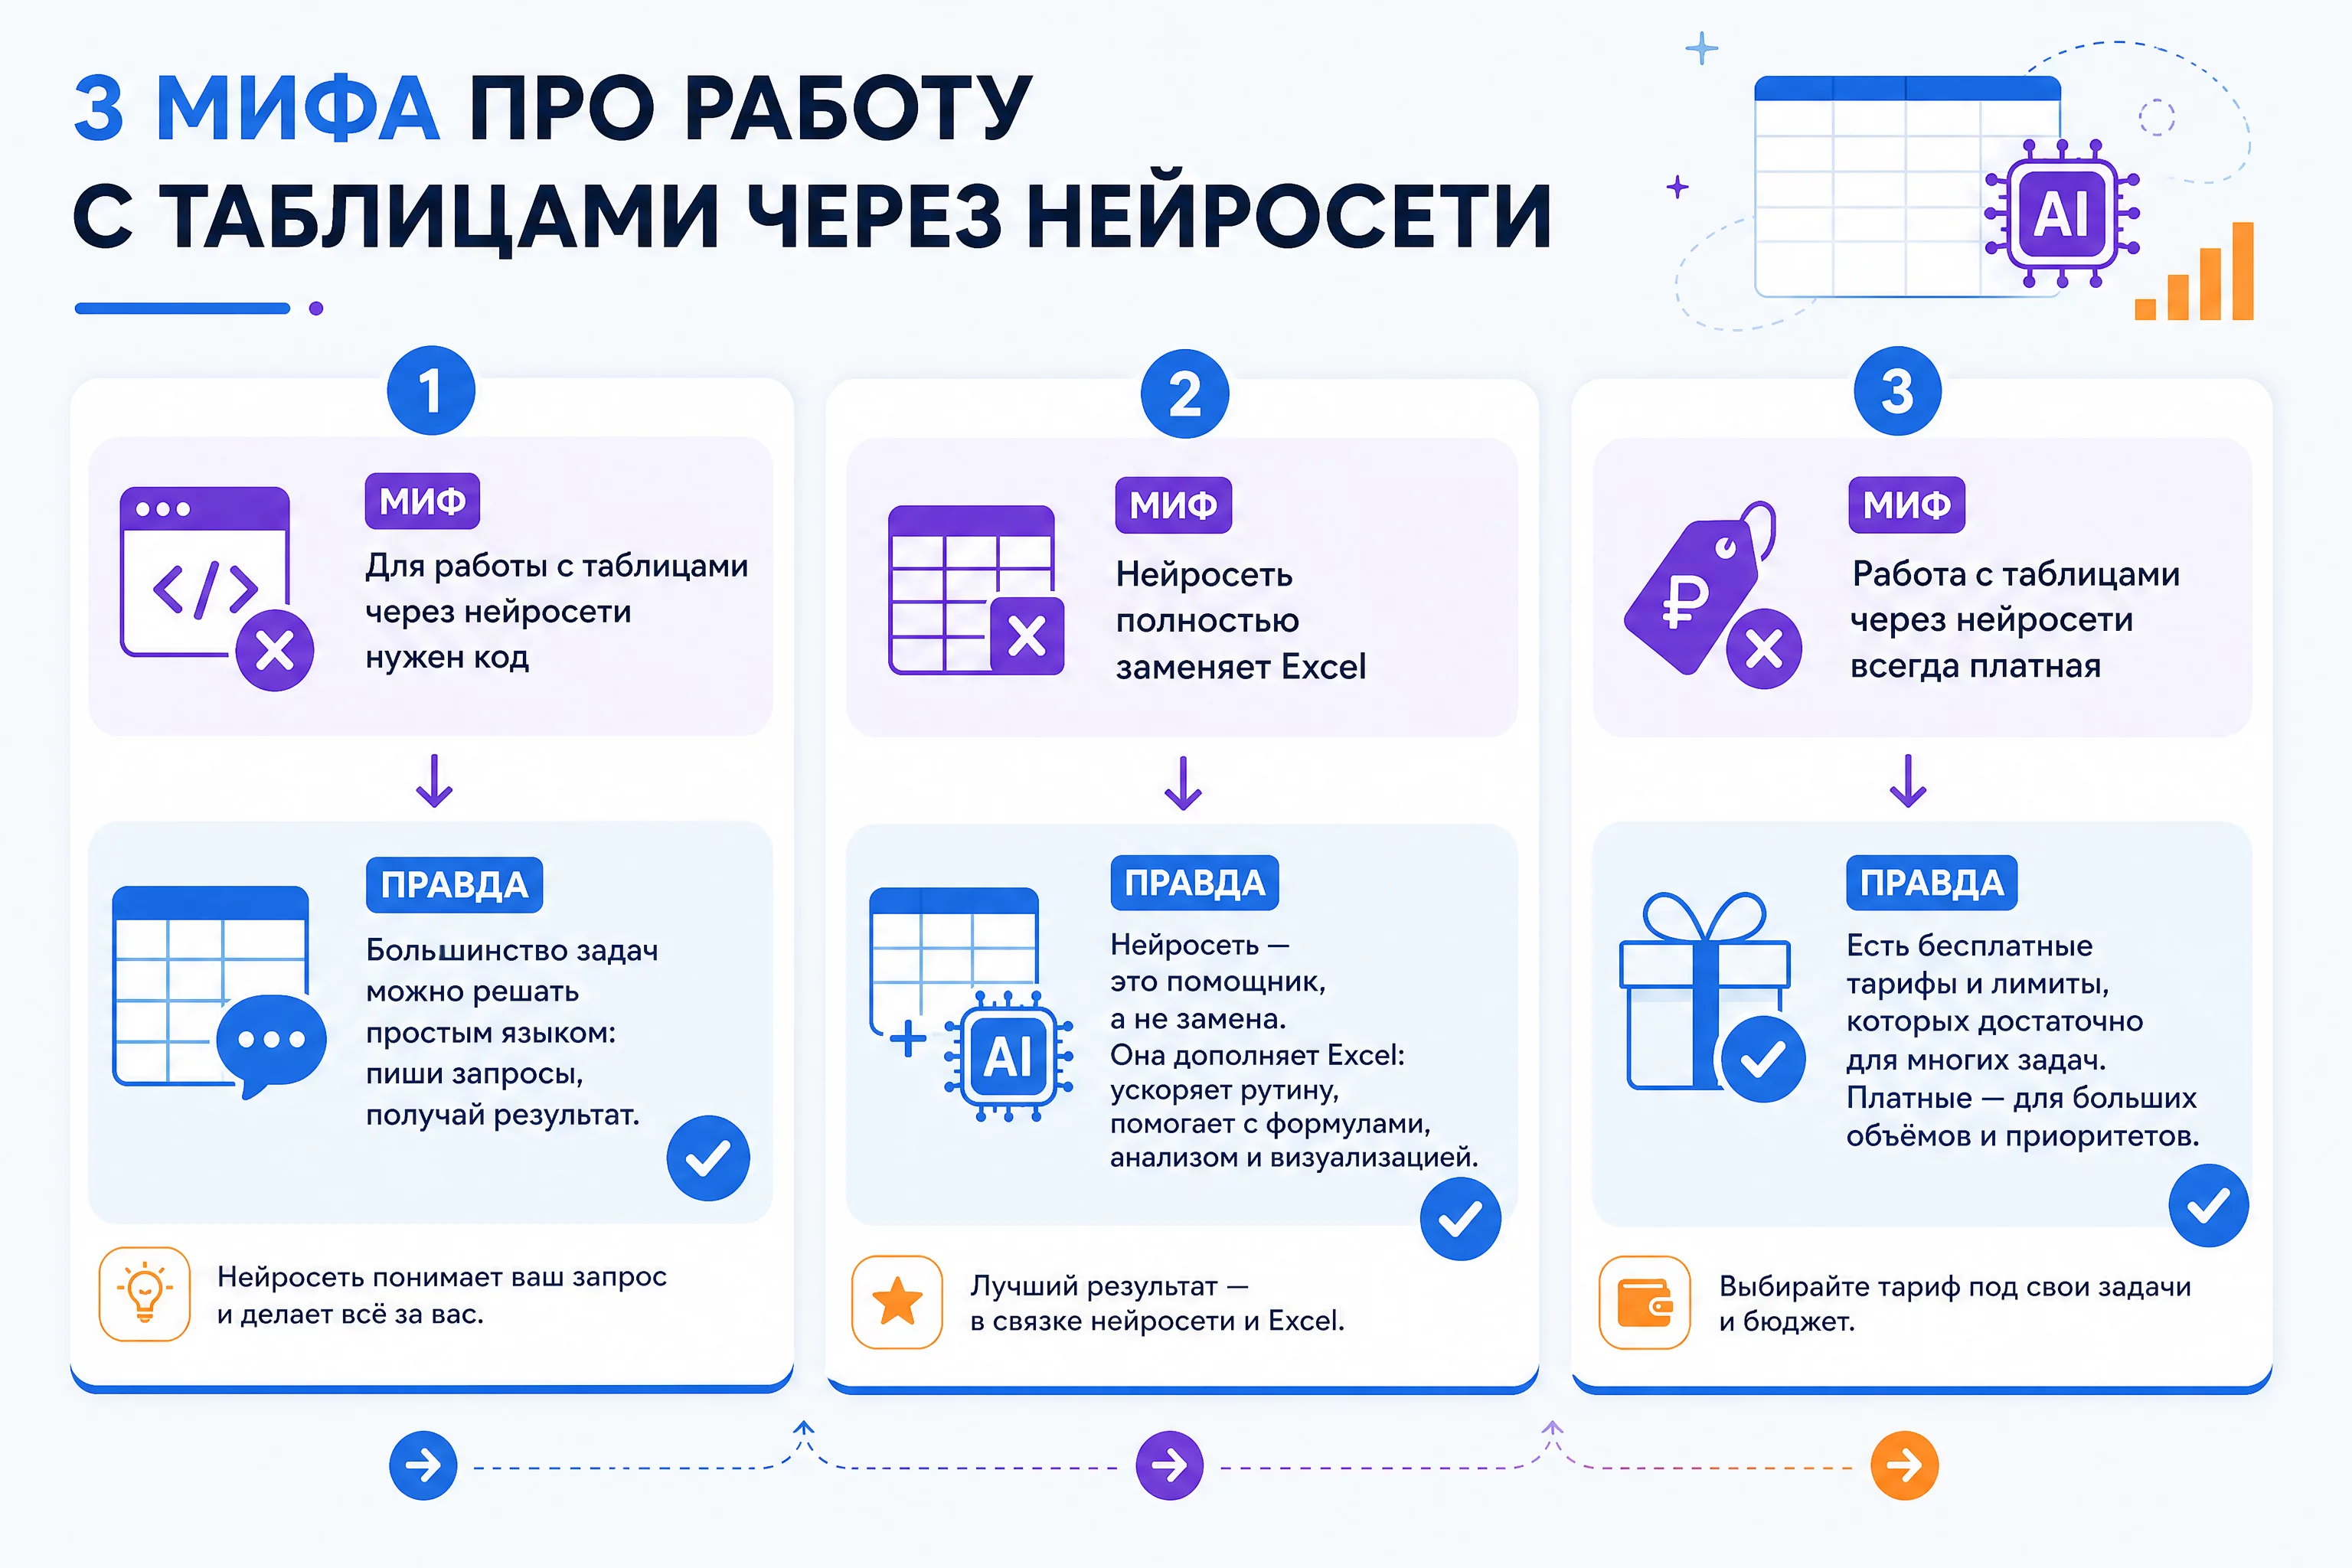
Миф: нужно уметь программировать, чтобы работать с таблицами через нейросеть. Нет. Промпты из этой статьи не требуют кода, ChatGPT сам запускает Python, когда нужен пересчёт. Ваша задача сформулировать вопрос на русском и проверить ответ.
Миф: нейросеть заменит Excel полностью. Не заменит. Excel остаётся для хранения данных, постоянных отчётов и дашбордов. ChatGPT берёт на себя разовые срезы, объяснения и расчёты, которые раньше делались вручную. Это дополнение, а не замена.
Миф: бесплатно это не работает, нужно покупать подписку. Для старта хватает бесплатного тарифа. Загрузили обезличенную таблицу, задали вопросы, получили ответы. Платная подписка нужна для больших файлов и частых запросов.
Как работать с выгрузками из 1С, банка и другими нестандартными файлами
Половина таблиц, которые приходят ко мне на разбор, это выгрузки из учётных систем: 1С, банков, CRM, маркетплейсов. Плюс отдельный класс это PDF, фото и рукописные таблицы. У них своя специфика, и вопросы к ним работают чуть иначе, чем к ручным таблицам. Разберу оба случая.
Вопросы по выгрузкам из 1С, банка и других систем
Выгрузка из 1С обычно содержит служебные колонки, внутренние коды, счета учёта, периоды и суммы. Первое, что я делаю, это прошу нейросеть описать структуру и сказать, какие колонки служебные, а какие содержат данные. Потом задаю вопросы по фактам: итоги, обороты, остатки, сальдо.
Выгрузка из 1С обычно содержит служебные колонки, внутренние коды, счета учёта, периоды и суммы. Первое, что я делаю, это прошу нейросеть описать структуру и сказать, какие колонки служебные, а какие содержат данные. Потом задаю вопросы по фактам: итоги, обороты, остатки, сальдо.
Промпт для выгрузки из 1С:
Перед тобой выгрузка из 1С [загружаете файл].

Сначала опиши структуру:
1. какие колонки есть и что в них
2. какие колонки служебные, а какие содержат данные
3. за какой период данные и сколько строк

Потом ответь:
1. обороты по счёту за период
2. остатки на начало и конец периода
3. суммы по субконто, если есть

Формат: описание структуры, потом таблица ответов.
Считай по данным из файла.
Выгрузки из банка приходят в форматах, которые не всегда дружат с нейросетью: PDF-выписки, Excel с несколькими листами, CSV с разделителями. Для PDF-выписок лучше конвертировать в текст или Excel перед загрузкой, тогда вопросы работают без сбоев. Подробно про распознавание и работу с первичными документами я писала в статье про первичку и нейросети.
Выгрузки с маркетплейсов содержат колонки с внутренними названиями, валютой, комиссиями и удержаниями. Здесь важно дать нейросети расшифровку: «колонка „Комиссия“ это комиссия площадки, „Удержание“ это штрафы». Без расшифровки модель будет считать по названиям, а не по смыслу.
Общее правило для всех выгрузок: дайте нейросети словарь соответствий до того, как зададите вопросы. Одна строка «колонка X это выручка, колонка Y это расходы» меняет качество ответов кардинально. Это тот случай, когда подготовка данных важнее выбора модели.
PDF, фото и рукописные таблицы
Кроме Excel, ChatGPT принимает PDF и изображения с таблицами. Это снимает ещё один слой рутины: не нужно перепечатывать данные из бумажного отчёта или скана, чтобы задать вопрос.
PDF с таблицей загружается напрямую. ChatGPT распознаёт текст и структуру и отвечает на вопросы по содержимому. Для сканов и фотографий работает распознавание изображений: модель видит картинку, читает таблицу и считает по ней. Качество зависит от чёткости снимка и аккуратности оригинала.
Промпт для фотографии таблицы:
Перед тобой фотография таблицы [загружаете фото].

Распознай данные:
1. перенеси таблицу в структурированный вид
2. назови колонки и сколько строк
3. посчитай итоги по числовым колонкам

Если какие-то цифры на фото нечитаемы, отметь это
и не выдумывай значения.
Формат: распознанная таблица, потом итоги.
Важное ограничение. Распознавание с фото это не стопроцентная точность, особенно с рукописными цифрами и печатями. Проверяйте распознанные значения по оригиналу, а итоги сверяйте. Для ответственных документов лучше работать с электронными выгрузками, а фото использовать как быстрый предпросмотр.
Рукописные таблицы нейросеть читает хуже печатных, но базовые суммы и количество строк обычно распознаёт. Если в таблице почерк неразборчивый, попросите модель выделить сомнительные ячейки отдельным списком. Это сэкономит время на выборочной проверке.
Про то, как нейросети переводят фото таблиц в готовые Excel-файлы, отдельная большая тема. Ей посвящён материал про фото таблиц в Excel, там показан весь процесс от снимка до готового файла с формулами.
Безопасность: что можно загружать, а что нельзя
Безопасность это не про запреты, а про понятные правила. Разделяю данные на три группы и по-разному работаю с каждой.
Первая группа: обезличенные данные. Суммы, количества, периоды, категории без привязки к компаниям и людям. Можно загружать в любой тариф после обезличивания и отключения обучения. Это девяносто процентов задач по анализу.
Вторая группа: данные под NDA. Финмодели с реальными названиями, договоры, банковская тайна. В публичные тарифы не грузим. Варианты: корпоративный тариф с конфиденциальным режимом, локальные модели на своём компьютере, либо жёсткое обезличивание до уровня, когда данные ничего не раскрывают.
Третья группа: персональные данные. ФИО, ИНН, паспортные данные, счета. Маскируем всегда, независимо от тарифа. Схема обезличивания разобрана в статье про обезличивание данных.
Два практических правила, которые закрывают почти все вопросы:
- Перед загрузкой спросите себя: если этот файл уйдёт в открытый доступ, что я потеряю? Если ответ «ничего страшного», грузите. Если «будет плохо», обезличьте или не грузите.
- В настройках платного тарифа отключите использование ваших данных для обучения. Это делается в разделе настроек конфиденциальности за пару кликов.
Как организовать рабочий процесс: диалоги, память и ежемесячный шаблон
Когда вопросы к таблицам становятся регулярными, их удобно держать в одном месте. В ChatGPT есть функции, которые для этого созданы: отдельные диалоги под задачи и память, которая запоминает ваши правила.
Проекты и отдельные диалоги
Заведите отдельный диалог под каждый регулярный отчёт: «Выручка по месяцам», «Закупки и прайсы», «Дебиторка». В начале диалога один раз опишите структуру своих данных и правила, дальше каждый месяц просто прикрепляйте новый файл и задавайте вопросы. Нейросеть помнит контекст внутри диалога и не требует повторных объяснений.
Когда вопросы к таблицам становятся регулярными, их удобно держать в одном месте. В ChatGPT есть функции, которые для этого созданы: отдельные диалоги под задачи и память, которая запоминает ваши правила.
Проекты и отдельные диалоги. Заведите отдельный диалог под каждый регулярный отчёт: «Выручка по месяцам», «Закупки и прайсы», «Дебиторка». В начале диалога один раз опишите структуру своих данных и правила, дальше каждый месяц просто прикрепляйте новый файл и задавайте вопросы. Нейросеть помнит контекст внутри диалога и не требует повторных объяснений.
Промпт для настройки такого диалога простой: «Запомни правила работы с моими таблицами: колонка „Начисления“ это выручка, „Списания“ это расходы; все суммы в рублях без НДС; даты в формате ДД.ММ.ГГГГ; при расчётах показывай итоги с разбивкой по периодам. Вопросы задаю по загруженным файлам, если данных не хватает, спрашивай, а не выдумывай». Отправьте этот промпт один раз в начале диалога, и дальше все ответы будут учитывать ваши правила. Это экономит время на каждом новом вопросе.
Память модели
В настройках ChatGPT есть функция памяти, которая сохраняет факты между диалогами. Ей можно объяснить, что вы финансовый специалист, работаете с таблицами в рублях и предпочитаете ответы с расчётом. Память работает в платной подписке, настройки доступны в профиле.
Осторожно с памятью. Если вы загружаете данные разных клиентов, не позволяйте модели запоминать конкретные цифры и названия. Лучше, чтобы в памяти жили только общие правила, а данные оставались в рамках одного диалога. Про память ChatGPT для финансовых задач я писала отдельно в статье про память нейросетей для финансиста.
Когда рабочее место настроено, весь процесс становится предсказуемым: подготовили файл, загрузили в нужный диалог, задали вопросы, проверили пересчётом.
Ежемесячный шаблон: как настроить постоянный процесс
Разовый разбор таблицы это хорошо, а системный процесс экономит больше. Когда вопросы к данным входят в ежемесячную рутину, повторяемый шаблон закрывает задачу быстрее, чем каждый раз придумывать с нуля. Три шага, чтобы превратить разовый приём в ежемесячный.
Первый шаг: сохранить мастер-промпт. Проверенные формулировки сохраните в заметки или в отдельный документ. В следующем месяце вы не вспомните точные слова, а с сохранённым шаблоном процесс начинается с того места, где закончился.
Второй шаг: завести шаблон подготовки. Список правил нормализации и обезличивания храните как чек-лист. Каждый месяц копируете, проверяете таблицу по пунктам и загружаете. Десять минут подготовки, которые окупаются точностью ответов.
Третий шаг: собрать библиотеку вопросов. Отдельные промпты под ваши отчёты: выручка, закупки, дебиторка, маржинальность. Каждый отлаживается один раз и потом переиспользуется.
Финальный промпт для регулярного отчёта:
По таблице [загружаете файл] собери стандартный отчёт:
1. итоги периода: выручка, расходы, прибыль
2. динамика к прошлому периоду в процентах
3. группировка по направлениям с долями
4. топ-5 отклонений, которые стоит разобрать
5. готовый вывод для руководителя

Формат: таблица итогов, таблица динамики,
список отклонений, вывод на 3-5 предложений.
Такой отчёт собирается за один запрос и идёт в переписку с руководителем почти без правок. Если цифры вызывают сомнения, прогоните через пересчёт на Python из раздела выше.
Чек-лист на каждый месяц:
- Подготовить таблицу: нормализовать названия, даты, числа.
- Обезличить: заменить названия, ИНН, счета и ФИО.
- Выключить обучение на данных в настройках.
- Загрузить файл и описать структуру.
- Задать стандартные вопросы из библиотеки.
- Проверить ключевые суммы пересчётом на Python.
- Сверить контрольные суммы в Excel.
- Собрать отчёт и отправить руководителю.
Сценарий «первые 15 минут с новой таблицей»
Когда вы получили незнакомый файл, не спешите задавать вопросы наугад. Рабочий сценарий из 15 минут выглядит так.
Первые 3 минуты: опишите структуру. Загрузите файл и отправьте промпт «расскажи, что в таблице» из раздела про первые промпты. Вы получите карту колонок, типов данных и подозрительных мест.
Следующие 5 минут: проверьте базу. Уточните у нейросети, есть ли пропуски, дубли и странные значения. На этом этапе вы решаете, можно ли анализировать файл как есть или нужна чистка.
Последние 7 минут: задайте главные вопросы. Сформулируйте два-три ключевых вопроса, ради которых вам вообще прислали таблицу. Получите ответы с расчётом, проверьте один итог в Excel и принимайте решение.
Этот сценарий экономит часы, потому что не даёт утонуть в деталях чужого файла. Вы быстро получаете суть, а глубокое погружение остаётся для тех случаев, когда действительно нужно.
Сколько времени экономит такой подход: расчёт на цифрах
Когда я считаю экономию для учеников, получаются стабильные цифры, потому что замеряю на одинаковых задачах до и после. Возьмите типовую неделю финансиста и посмотрите, что меняется.
Ручная работа с данными в неделю:
- Построение сводных и срезов для трёх отчётов: 3-4 часа.
- Подготовка ответов руководителю с расчётами: 2-3 часа.
- Проверка выгрузок на аномалии и дубли: 2-3 часа.
- Сверка двух версий таблицы после правок: 1-2 часа.
- Объяснение чужих таблиц и формул: 1-2 часа.
Итого от 9 до 14 часов в неделю на механическую работу с данными. Это время, которое уходит не на решения, а на выборки, группировки и проверки.
С нейросетью то же самое выглядит так:
- Вопросы вместо сводных: 30-40 минут на все отчёты.
- Ответ руководителю одним промптом: 10-15 минут.
- Проверка на аномалии: 20-30 минут.
- Сверка таблиц: 15-20 минут.
- Объяснение чужой таблицы: 10-15 минут.
Итого от 1,5 до 2 часов вместо 9-14. Экономия от 6 до 12 часов в неделю, это 25-50 часов в месяц. При ставке финансиста от 2 000 до 4 000 рублей в час речь идёт о 50-200 тысячах рублей сэкономленного рабочего времени ежемесячно.
Важная оговорка. Это не значит, что вы будете работать на 10 часов меньше. Высвободившееся время уходит на анализ и решения, на проверку важных цифр, на подготовку к встречам. Именно это и есть работа финансового директора, ради которой его нанимают. Автоматизация не убирает работу, она меняет её состав.
Кому этот подход даёт больше всего: три профиля
Вопросы по таблицам через нейросеть полезны не всем одинаково. По моей практике, больше всего выигрывают три профиля.
Финансовый директор, который готовит решения собственнику. У него много вопросов к данным и мало времени на выборки. Нейросеть превращает часы сводных в минуты вопросов, а высвободившееся время уходит на анализ и рекомендации. Это самый быстрый возврат инвестиций в навык.
Бухгалтер на закрытии месяца. Сверки, выгрузки, поиск аномалий, объяснение чужих таблиц. Всё это рутина, которую нейросеть снимает с плеч, оставляя человеку контроль над итогами. Бухгалтеру подход даёт не часы, а снижение ошибок, потому что проверка на аномалии становится регулярной.
Аналитик, который собирает данные из нескольких систем. Ему постоянно приходится сопоставлять выгрузки из 1С, банка, CRM и маркетплейсов. Вопросы и сверки через нейросеть сокращают ручную склейку и ускоряют подготовку управленческих отчётов.
Кому подход помогает меньше: тем, кто работает с одним и тем же постоянным дашбордом без новых вопросов. Если вы месяцами открываете один отчёт и не задаёте ему новых вопросов, настройте один раз и забудьте, нейросеть здесь не нужна. Она нужна там, где вопросы разные и данные меняются.
Общее правило: чем больше разовых вопросов к данным у вас в неделю, тем выше отдача. Посчитайте, сколько вопросов вы задаёте своим таблицам за день, умножьте на время на каждый, и станет понятно, стоит ли внедрять подход.
Куда движется работа с таблицами в 2026 году
Тренд 2026 года очевиден: от ручного построения отчётов к диалогу с данными. Модели становятся точнее в работе с файлами, контекст растёт, код выполняется прямо в чате. Ещё два года назад загрузка Excel в нейросеть была экзотикой, сейчас это базовый приём.
Через год-два, по моим ожиданиям, вопросы к таблицам станут таким же привычным действием, как поиск в интернете. Нейросети научатся держать целые книги без нарезки, сами проверять свои расчёты кодом и возвращать не просто цифры, а готовые выводы с рекомендациями.
Это значит, что навык «правильно спросить данные» будет цениться выше, чем навык «быстро построить сводную». Механическую часть возьмёт машина, а умение сформулировать вопрос, проверить ответ и принять решение останется за человеком. Именно эти навыки я учу на курсе «AI-навыки финансиста», и они уже сейчас дают участникам преимущество.
FAQ: частые вопросы про вопросы по таблице Excel
Можно ли задавать ChatGPT вопросы по таблице Excel бесплатно? Можно. Бесплатный тариф принимает Excel и CSV и отвечает на вопросы. У платной подписки больше лимиты и встроенный анализ данных с кодом Python.
Как загрузить Excel в ChatGPT? Откройте chatgpt.com, нажмите скрепку, выберите файл и напишите вопрос. Для больших таблиц подготовьте заранее: уберите объединённые ячейки и лишние листы.
Какие вопросы можно задавать по таблице на русском? Любые, на которые отвечает анализ: суммы, средние, группировки, доли, динамика, аномалии, дубли, сравнения. Чем конкретнее вопрос, тем точнее ответ.
Как сделать, чтобы ChatGPT не ошибался в цифрах? Просите пересчитать на Python и показать строки, уточняйте «считай по данным, а не по итогам файла», сверяйте контрольные суммы в Excel.
Большая таблица не помещается: что делать? Режьте по периодам или листам, выгружайте в CSV, убирайте лишние колонки. Потом собирайте результаты одним промптом.
Заменит ли ChatGPT сводные таблицы? Для разовых срезов да, для постоянных дашбордов нет. Используйте вопросы для быстрых решений, а Excel для живых отчётов.
Безопасно ли загружать финансовые таблицы? Только после обезличивания и отключения обучения. Документы под NDA и банковскую тайну в публичные тарифы не грузим.
Какая модель лучше для вопросов по таблице? GPT-5.5 для файлов и Python, Claude Sonnet 4.6 для сложных книг, Gemini 2.5 для Google Таблиц, DeepSeek бесплатно для черновиков на обезличенных данных.
Что дальше
Вопросы по таблице через нейросеть закрывают конкретную боль: часы ручной работы с данными, которые можно получить за минуты. Но это один приём из целой системы. Следующий шаг собрать вокруг нейросетей весь контур финансовой работы: подготовка данных, анализ, проверка, отчётность, автоматизация рутины. На курсе «AI-навыки финансиста» онлайн-школы «Финансовый директор | Мастер CFO» разбираю, как выстроить такую систему: от обезличивания данных до готовых промптов под ваши процессы. 10 модулей, 800+ выпускников, диплом установленного образца с лицензией и налоговый вычет 13%. Начать можно с бесплатного эфира-экскурсии, где показываю весь процесс на практике.
Записаться на курс «AI-навыки финансиста»
Наши каналы для финансистов
@findir_pro. Основной Telegram-канал «Финансовый директор | Мастер CFO». 45 000 подписчиков. Ежедневно: практические разборы, кейсы выпускников, обновления инструментов, новые промпты для финансистов.
«АИ с Софьей и Натали». Канал об AI для финансистов. 13 000 подписчиков. Вместе с Софьей Бурцевой, основателем школы, разбираем новые модели, делаем живые тесты и публикуем обновлённые промпты сразу после выхода новых версий.
MAX. Закрытое сообщество для действующих финансовых директоров. 5 000+ участников. Кейсы коллег, шаблоны, закрытые эфиры по AI и стратегии CFO.
Об авторе
Натали Васильева. Эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO». С нейросетями в работе финансиста с февраля 2023 года. Через курс «AI-навыки финансиста» прошли 800+ финансистов, главбухов и финдиров. Веду Telegram-канал @findir_pro (45 000 подписчиков) и MAX-канал «Финансовый директор» (5 000+).