AI для финансиста
Задача «на 15 минут», а на деле 2 часа: 7 операций в Excel, которые ChatGPT сжимает до минуты

Задача «на 15 минут» в Excel выглядит безобидно: поставить ВПР, почистить выгрузку из банка, разобрать назначения платежей. Сама операция занимает 15 минут. А потом начинаются правки: не сходится, нашлось 30 несовпадений, в одной таблице «ООО Ромашка», в другой «Ромашка ООО». И вот уже двух часов нет как нет. В 2026 году я не считаю это нормой. Меня зовут Натали Васильева, я эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO». С 2023 года помогаю финансистам и бухгалтерам внедрять нейросети в работу, через курс «AI-навыки финансиста» прошли 800+ выпускников, наши каналы читают 45 000 подписчиков в Telegram и 13 000 в канале «АИ с Софьей и Натали». Материал актуален на 31 августа 2026 года.
В этой статье разбираю семь операций в Excel, которые ChatGPT сжимает до минуты. Для каждой даю готовый промпт, показываю разницу «руками и через нейросеть» на реальных цифрах и объясняю, где проходит граница, за которую модель лучше не пускать. Внутри: сравнительная таблица моделей, три кейса с часами и рублями, чек-лист на каждый месяц и ответы на частые вопросы.
Почему «пятнадцатиминутные» задачи в Excel отнимают два часа
Дело не в самой операции, а в том, что происходит вокруг неё. Я много раз наблюдала этот процесс в работе выпускников и клиентов: человек открывает файл, уверенный, что «тут на 15 минут», а через два часа с удивлением обнаруживает себя за поиском лишнего пробела в триста четвёртой строке.
Разложу эти два часа на части. Поставим в пример объединение двух таблиц по названию контрагента. Сама формула ВПР ставится за 10-15 минут. Дальше начинается настоящее: в одной таблице контрагент записан как «ООО Ромашка», в другой как «Ромашка ООО», у третьего в названии двойной пробел, у четвёртого невидимый символ после слова. ВПР честно пишет «Н/Д» по половине строк. Начинается ручная работа: открыть справочник, найти, кто это, поправить, протянуть формулу заново. Час пролетает незаметно.
Вторая часть времени уходит на проверку. Человек делает операцию, получает результат, но не доверяет ему: это правильно, в финансах иначе нельзя. Он начинает сверять выборочные строки, потом не выдерживает и проверяет все. На это уходит ещё 30-40 минут. Итог: 15 минут на операцию, полтора часа на правки и проверку.
Вот что реально съедает время в Excel:
- Разные написания одного и того же. «ООО Ромашка», «Ромашка», «ООО “Ромашка”», «РОМАШКА». Глазами вы это видите, формула ВПР не видит.
- Скрытые символы и пробелы. Невидимые символы из выгрузок ломают поиск, а найти их руками почти невозможно.
- Дубли строк. В выгрузке из 1С или CRM одна операция может попасть дважды, и итоги разъезжаются.
- Даты и числа «как текст». Колонка выглядит как даты, а на деле это текст: сортировка идёт не так, фильтры не работают.
- Объединённые ячейки. Красиво на экране, мучительно при протягивании формул и построении сводных.
- Разные форматы чисел. «1 234,56 руб.», «1234.56», «1 234,56 ₽» в одной колонке.
- Человеческая проверка по принципу «доверяй, но проверяй». Она нужна, но она медленная.
К этому добавляется то, что в 2026 году уже не обсуждается: большинство рутины с таблицами нейросеть делает быстрее и ровнее человека. Не потому что человек плохой. Потому что модель не устаёт на двухсотой строке, не пропускает невидимый символ и не считает задачу скучной.
Исследования качества электронных таблиц ведутся с конца восьмидесятых годов, и выводы стабильные: ошибки находят в большинстве реальных файлов, которые попадают под проверку. Ошибки в формулах, в ссылках, в логике расчётов. Человеческая проверка выборочна по своей природе, и это не лечится силой воли. Лечится сменой инструмента: операцию и чистку данных отдаём нейросети, а проверку и решение оставляем себе.
Дальше разберу, какие именно операции отдавать первой, и покажу, как ChatGPT сжимает каждую до минуты.
Семь операций в Excel, которые ChatGPT сжимает до минуты: обзор
Собрала семь операций, которые в моей практике встречаются чаще всего и дольше всего. Это не абстрактные приёмы, а задачи из закрытия месяца, подготовки отчёта собственнику и сдачи документов в банк.
| Операция | Руками | С ChatGPT | Что делает модель |
|---|---|---|---|
| Объединение таблиц по ключу | 1,5-2 часа | 2-3 минуты | Сопоставляет строки по ИНН или названию, чинит расхождения форматов |
| Чистка выгрузки из 1С и банка | 1-2 часа | 1-2 минуты | Убирает дубли, пробелы, чинит даты и числа «как текст» |
| Разбор назначений платежа | 2-3 часа | 2-3 минуты | Извлекает из текста счёт, дату, товар, признак НДС |
| Сложная формула | 1-2 часа с правками | 1 минута | Пишет формулу по правилам, объясняет каждую часть |
| Разбор чужой формулы | 1-2 часа | 2-3 минуты | Объясняет логику, находит, где формула врёт |
| Сверка двух таблиц и версий | 1-3 часа | 2-4 минуты | Находит расхождения по ключу, сводит в таблицу |
| Перекладка отчёта из 1С | 1-2 часа | 2-3 минуты | Разворачивает таблицу под формат собственника, собирает сводную |
Цифры в таблице честные, из практики, но с одной оговоркой: в колонку «С ChatGPT» я включаю загрузку файла и формулировку задачи, но не проверку. Проверка занимает ещё 5-10 минут, и она всегда остаётся за человеком. Итого типичная задача сжимается с двух часов до 15-20 минут. Согласитесь, это другая жизнь.
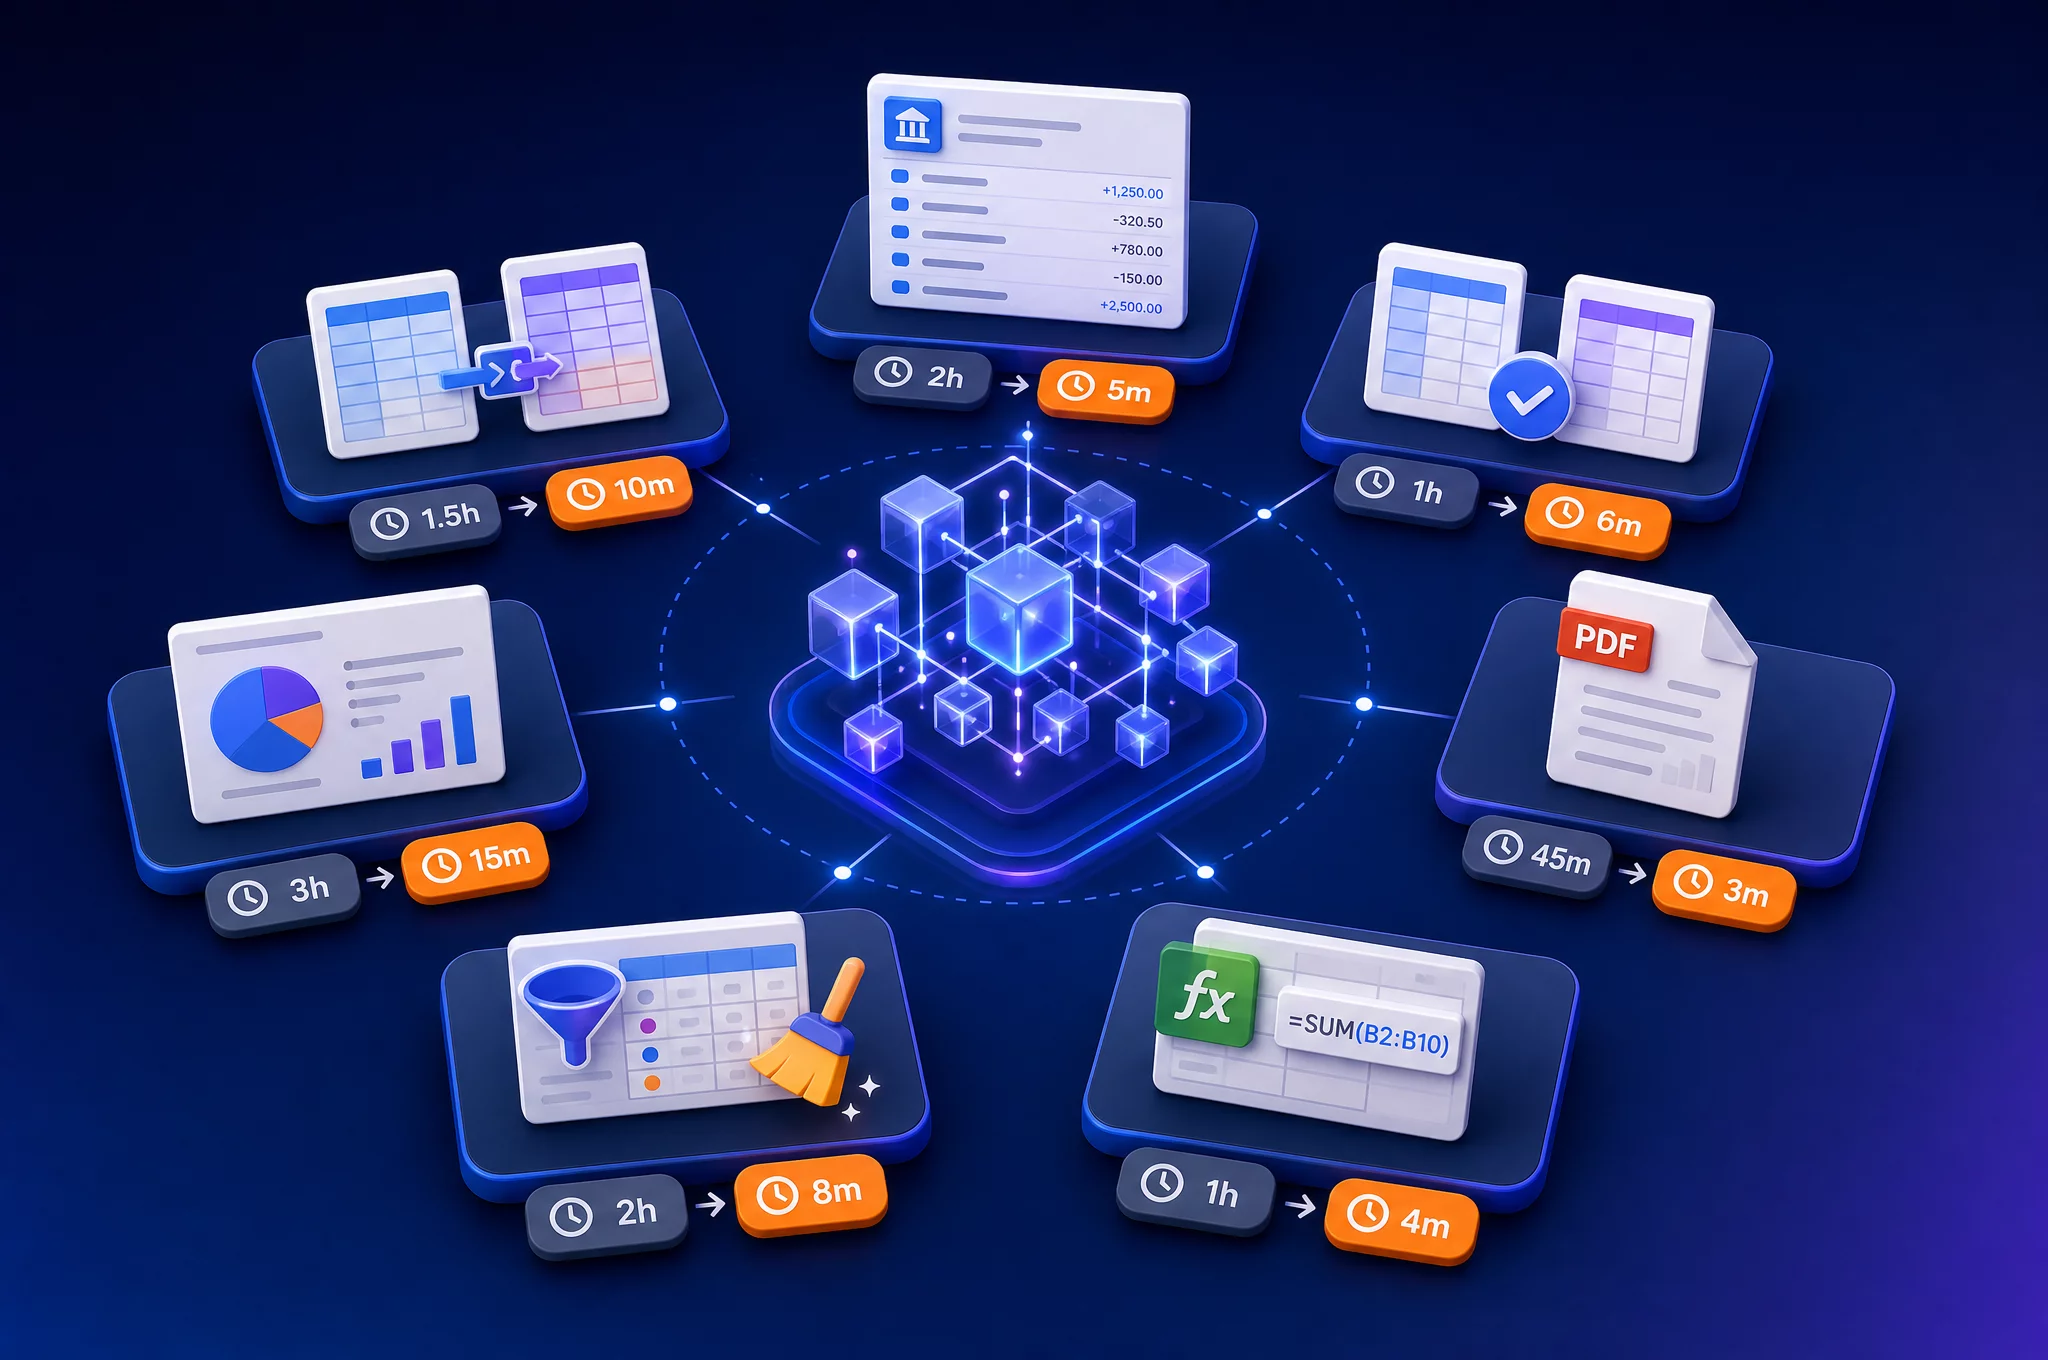
Почему модель справляется там, где человек тонет? Потому что ChatGPT работает не как калькулятор, а как ассистент, который видит файл целиком. Он читает колонки, понимает, что «Ромашка ООО» и «ООО Ромашка» это одно и то же, чинит форматы и делает это одинаково ровно на всех строках. Человек делает то же самое, но последовательно, по одной строке, с усталостью и ошибками.
Дальше разберу каждую операцию с готовым промптом. Но сначала базовые правила работы с таблицами в ChatGPT, без них промпты работают вполсилы.
Как ChatGPT работает с Excel: загрузка файлов и базовые правила
Прежде чем перейти к операциям, покажу, как технически устроена работа с таблицами. Это займёт у вас пять минут один раз, а дальше пойдёт на автомате.
ChatGPT принимает файлы прямо в диалоге на chatgpt.com. Загрузить можно xlsx, xls, csv и даже картинку со скриншотом таблицы. После загрузки модель открывает файл, читает содержимое и может вернуть исправленный файл обратно. Для большинства задач этого достаточно.
Базовые правила, которые я проверяю перед каждой загрузкой:
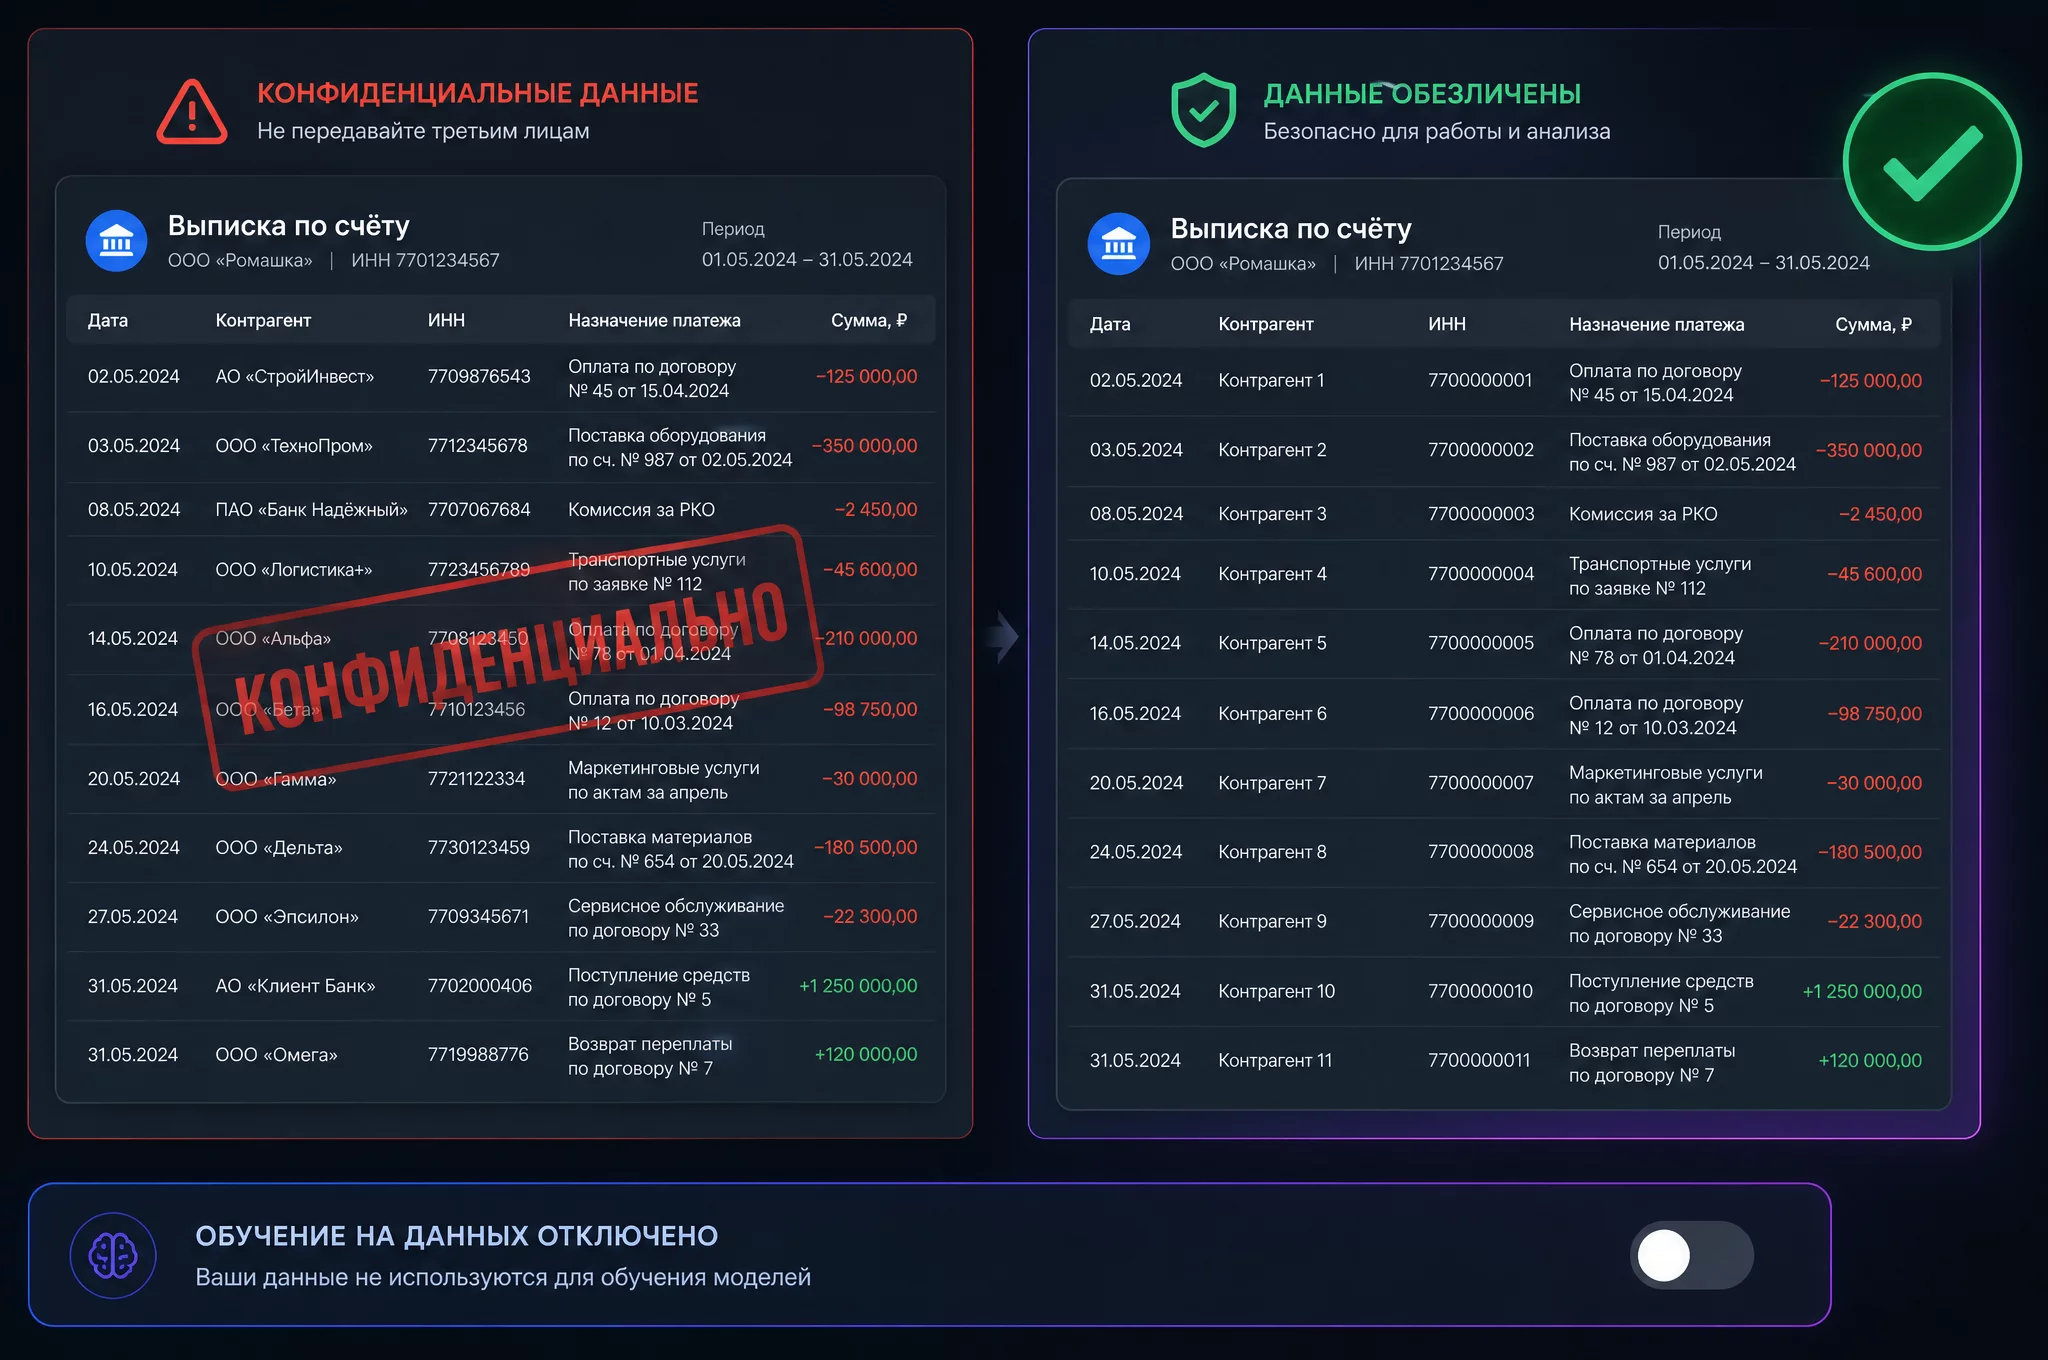
Правило 1. Обезличьте данные. Суммы оставляем, названия контрагентов, ИНН, счета и ФИО заменяем масками: «Контрагент 1», «Счёт 2», «Физлицо 3». Это не паранойя, а рабочая гигиена. Подробно про обезличивание я писала в отдельной статье про обезличивание данных для ChatGPT.
Правило 2. Выключите обучение на данных. В платном тарифе ChatGPT есть настройка, которая запрещает использовать ваши диалоги для обучения. Проверьте, что она выключена, до того, как загрузите первую выгрузку.
Правило 3. Не грузите документы под NDA. Договоры с конфиденциальными условиями, банковскую тайну, персональные данные в публичные тарифы не загружаем. Для них есть корпоративные тарифы или локальные модели на своём компьютере.
Правило 4. Скажите модели, что за файл перед ней. Перед серьёзной задачей попросите ChatGPT описать файл своими словами. Это как показать документ новому сотруднику до того, как дать ему считать итоги.
Отдельно про доступ. Доступ к chatgpt.com из России требует специальных средств подключения. Какой способ выбрать, каждый решает с учётом требований своей компании и службы безопасности. Работайте напрямую через официальный сайт, а не через сторонних посредников, которые часто под видом ChatGPT используют дешёвые модели и не дают гарантий по данным. Пользоваться нейросетями из России не запрещено. Если официальный доступ вам не подходит, для части задач из статьи подойдут альтернативы: DeepSeek V3.2 открывается из России без обходных средств и бесплатен для черновой работы, о чём я рассказывала в статье про DeepSeek для финансиста без VPN.
Первый промпт для знакомства с файлом:
Посмотри на приложенный файл и опиши его.

В описании укажи:
1. Что это за таблица и для чего она, судя по содержанию
2. Сколько строк и столбцов
3. Как называется каждая колонка и какой формат данных в ней
   (числа, даты, текст, валюта)
4. Есть ли пустые ячейки, объединённые ячейки, дубли строк
5. Есть ли подозрительные места: числа «как текст», лишние
   пробелы, разные форматы в одной колонке

Ничего не меняй и не исправляй, только опиши.
Если файл не открылся или открылся не полностью, скажи об этом
первым предложением.
Зачем этот шаг? Потому что половина неудачных промптов случается из-за того, что модель не поняла структуру файла. Когда ChatGPT описывает таблицу своими словами, вы за один экран видите, что он понял правильно, а что нет. Если он не увидел колонку с НДС, дальше можно не продолжать: нужно поправить загрузку.
Отдельно про память. ChatGPT запоминает контекст между диалогами: если вы месяц работаете с одними и теми же типами отчётов, модель уже знает, как устроена ваша выгрузка из 1С, и требует меньше объяснений. Чем чаще вы работаете с одним типом файлов, тем меньше слов нужно в промпте. Это и есть тот самый эффект, когда собранный контекст убирает секунды на «вспомнить и переключиться», о котором так много говорят в 2026 году. Про память ChatGPT подробно рассказала в статье про память ChatGPT для финансиста.
Как загрузить таблицу: файл, скриншот, фото
У новичков чаще всего возникает вопрос «а как же мне показать модели мою таблицу?». Вариантов три, и все они работают.
Файл целиком. Прикрепляете xlsx или csv прямо в диалоге на chatgpt.com, как вложение к письму. Модель открывает файл, читает содержимое и может вернуть исправленный файл обратно. Это основной способ для работы с большими таблицами.
Скриншот. Сделали снимок экрана с таблицей, прикрепили как картинку. ChatGPT прочитает цифры и текст с картинки. Годится для небольших фрагментов: одна вкладка, один диапазон, один график. Для пятисот строк скриншот не подойдёт, модель просто не разберёт мелкий текст.
Фото с телефона. Сфотографировали бумажный документ, прикрепили в приложение ChatGPT. Работает, если документ ровный и освещение нормальное. Качество распознавания ниже, чем у файла, поэтому результат обязательно проверять. Про распознавание таблиц с фото я писала отдельно в статье про фото таблиц и распознавание через нейросеть.
Для скриншота действует тот же промпт-знакомство, что и для файла: попросите модель описать, что она видит на картинке, какие колонки и сколько строк. Только без пункта про формат данных, по картинке его не определить. Если часть таблицы обрезана, модель честно скажет об этом, главное в промпте прописать «не додумывай данные, которых нет на картинке».
Скриншоты я советую использовать как быстрый способ «показать» модель, о чём речь, а не как способ передать полные данные. Для полноценной работы загружайте файл.
Как обезличить данные перед загрузкой
Обезличивание это та тема, где я не иду на компромиссы. Если делать его руками, это превращается в отдельную муку: выделил колонку, заменил, проверил, что не задел суммы. На это уходит 15-20 минут, и именно здесь люди чаще всего сдаются и грузят файл как есть.
Обезличивание тоже можно отдать ChatGPT. Модель проходит по колонкам и заменяет чувствительные поля масками, не трогая суммы и даты. Главное, задать правило: что считать чувствительным.
Промпт для обезличивания:
В приложении файл с финансовыми данными. Обезличь его:

1. Все названия контрагентов замени на «Контрагент 1»,
   «Контрагент 2» и так далее по порядку. Сохрани соответствие:
   один и тот же контрагент везде получает один и тот же номер.
2. ИНН, КПП, ОГРН замени на «ИНН_1», «ИНН_2» и так далее.
3. Расчётные счета и номера договоров замени на «Счёт_1»,
   «Договор_1» по тому же принципу.
4. ФИО замени на «Физлицо_1», «Физлицо_2».
5. Суммы, даты, периоды и назначения платежей НЕ меняй.
6. В конце приложи легенду соответствий отдельным файлом:
   «Контрагент 1 = ООО Ромашка». Легенду храни у себя,
   в ChatGPT не загружай.

Проверь, что ни одно чувствительное поле не осталось
в обезличенном файле. Если осталось, перечисли его отдельно.
Легенду соответствий держите у себя в защищённом месте. В диалог с моделью она не нужна: вам не понадобится расшифровка, пока вы не вернёте настоящие названия в финальный файл после проверки.
Небольшая хитрость: если файл слишком большой, обезличивайте только те колонки, которые реально нужны для задачи. Контрагенты и ИНН обычно нужны для сопоставления, а ФИО в назначениях платежа можно вычистить сразу. Чем меньше чувствительных данных в файле, тем спокойнее и быстрее работа.
Один раз в моей практике файл с реальными контрагентами попал в диалог случайно, и с тех пор в моих шаблонах промптов обезличивание стоит первым пунктом. Подробный разбор с примерами в статье про обезличивание данных для ChatGPT.
Теперь перехожу к семи операциям. Начну с самой частой.
Операция 1. Объединение таблиц по ключу вместо ручного ВПР
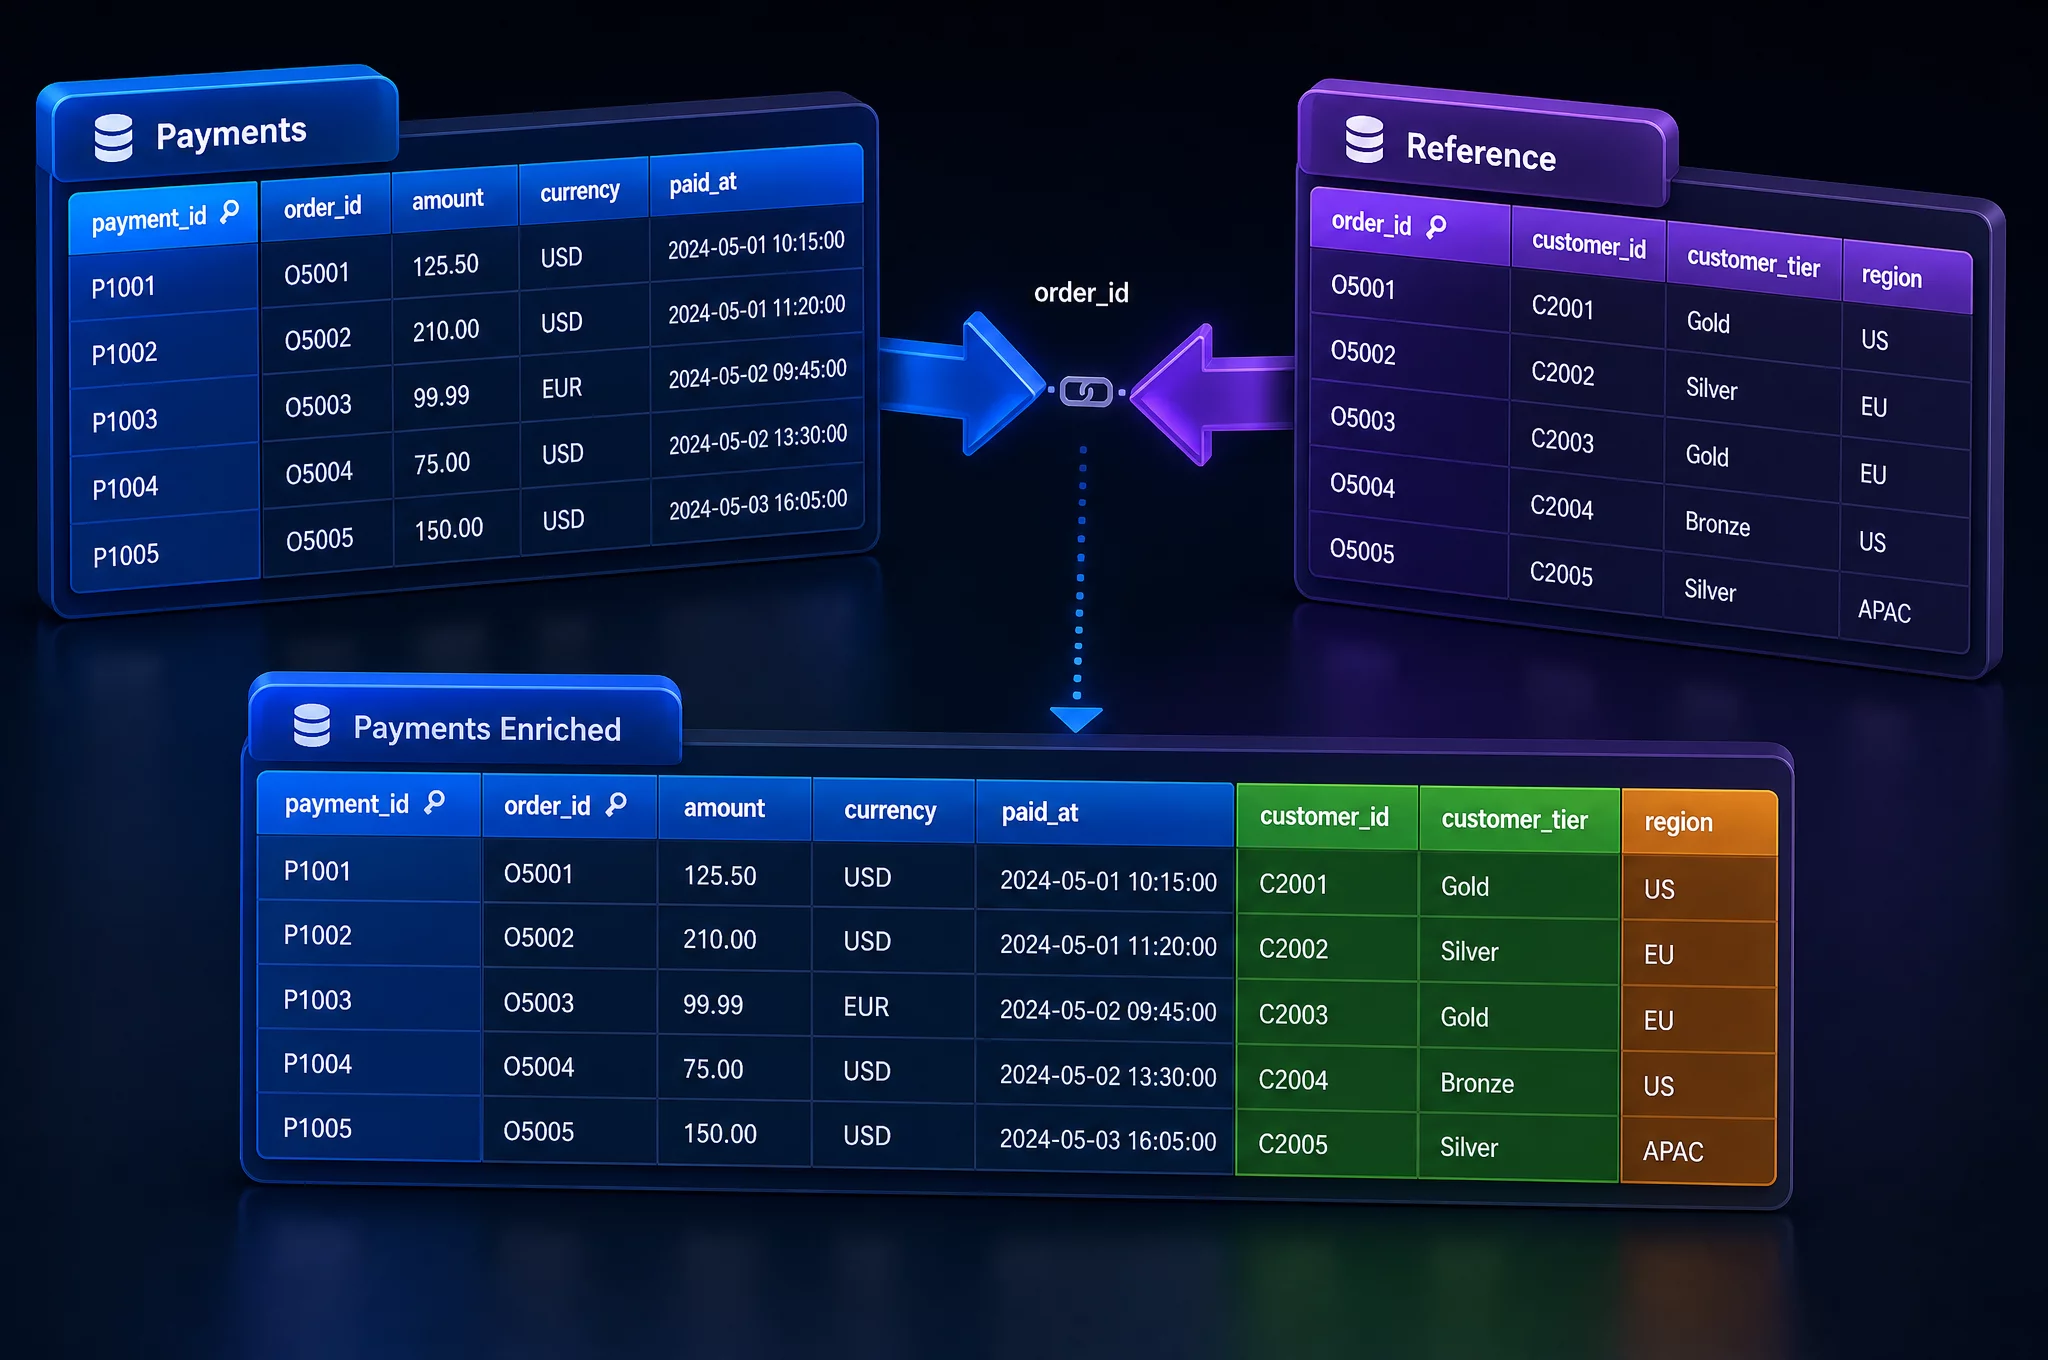
Самая популярная задача, с которой ко мне приходят. Есть две таблицы: в одной выручка по контрагентам, в другой реестр договоров. Нужно сопоставить строки и получить одну таблицу со всеми полями. Классический сценарий ручного ВПР, который из «задачи на 15 минут» превращается в два часа борьбы с несовпадениями.
Руками это выглядит так: ставите ВПР по ИНН, получаете «Н/Д» по трети строк, начинаете разбираться. Выясняется, что в выгрузке из 1С контрагенты называются «ООО Ромашка», а в реестре договоров «Ромашка, ООО». Или у одного контрагента два ИНН в справочнике. Каждое несовпадение надо найти, понять и решить вручную.
ChatGPT решает это за один проход: он сопоставляет строки по нескольким ключам сразу, учитывает сокращения и лишние пробелы и возвращает готовую таблицу с пометками, где сопоставление не удалось.
Промпт для объединения таблиц:
В приложении два файла: «01_выручка» и «02_реестр_договоров».

Таблица «01_выручка»: контрагент, ИНН, сумма за июль.
Таблица «02_реестр_договоров»: название, ИНН, менеджер,
срок договора.

Сопоставь каждую строку таблицы «01_выручка» с таблицей
«02_реестр_договоров» по правилам:
1. Сначала по ИНН, если ИНН совпадает полностью
2. Если ИНН нет или отличается, сопоставь по названию с учётом
   сокращений, порядка слов и лишних пробелов: «ООО Ромашка»
   и «Ромашка, ООО» считаются одним контрагентом
3. Если сопоставить не удалось, оставь поля пустыми и поставь
   в колонке «Статус» значение «не найдено»

Верни таблицу со всеми колонками из обеих таблиц плюс колонки:
«Совпадение» (да/нет) и «Комментарий» (почему сопоставление
не удалось, если это так). Не выдумывай данные, которых нет
в файлах. Работай только с тем, что реально загружено.
Что вы получаете на выходе: одну таблицу, где каждая строка выручки связана с договором, и список «не найдено» вместо молчаливых «Н/Д». Дальше вы разбираете только те строки, которые модель не смогла сопоставить, а их обычно немного. Раньше на поиск этих несовпадений уходила половина времени.
Важный нюанс: не просите модель «поставить ВПР». Просите «сопоставить таблицы». Разница в том, что ВПР ищет точное совпадение, а вам нужно умное совпадение. ChatGPT умеет и то и другое, но по умолчанию сделает то, что вы попросили. Формулируйте задачу по результату, а не по инструменту.
Что делать с несовпадениями, которые модель не нашла
Даже лучший промпт оставит хвост из нераспознанных строк. Это нормально. Вопрос в том, как с ними работать быстро.
У меня есть правило «трёх проходов» для несовпадений:
- Сначала смотрим на дубли. Чаще всего «не найдено» это повторная строка, которая уже сопоставлена. Отфильтруйте дубли по ключу и посмотрите, сколько «потеряшек» исчезнет само.
- Потом проверяем ключ. В одной таблице ИНН мог попасть в колонку с текстом, а в другой стоять с буквой «ИНН» в начале. Приведите ключи к одному формату и прогоните ещё раз.
- И только потом разбираем вручную. Оставшиеся 20-30 строк это обычно старые контрагенты, технические счета или операции без ключа. На них и тратится человеческое время.
Этот порядок экономит час: вместо того чтобы разбирать все 200 несовпадений по одному, вы сначала механически отсекаете те, что чинятся сами.
Про другие способы искать данные в справочниках, включая альтернативы ВПР и XLOOKUP, читайте в статье про объединение таблиц через ChatGPT.
Операция 2. Чистка грязной выгрузки из 1С и банка
Выгрузка из учётной системы никогда не бывает чистой. В ней дубли строк, названия с двойными пробелами, даты в формате текста, числа с пробелами в разрядах и скрытые символы. Руками это чистится за час-два монотонной работы: выделил столбец, проверил формат, убрал пробелы, убрал дубли, проверил заново. И так по каждому столбцу.
ChatGPT чистит выгрузку за один промпт. Он проходит по всем колонкам, находит типичные проблемы и исправляет их по вашим правилам, а потом возвращает чистый файл и список того, что поменял.
Промпт для чистки выгрузки:
В приложении файл «выгрузка_банк_август.csv». Это выписка по
расчётному счёту. Приведи таблицу в порядок:

1. Удали полностью дублирующиеся строки (когда совпадают дата,
   сумма, назначение и контрагент). Оставь одну запись.
2. В колонке «Контрагент» убери лишние пробелы, кавычки,
   символы «№» и «;» в конце названия. Приведи к единому виду:
   без лишних пробелов, с большой буквы.
3. В колонке «Дата» приведи все значения к формату ГГГГ-ММ-ДД.
   Если дата записана текстом («05.08.2026»), преобразуй в дату.
4. В колонке «Сумма» убери пробелы и символ валюты, оставь
   число с двумя знаками после запятой. Пустые суммы пометь
   как 0.
5. В колонке «Назначение платежа» не меняй текст, только убери
   двойные пробелы.

После очистки верни файл и приложи отчёт: сколько строк было,
сколько удалено как дубли, сколько исправлено по каждому пункту.
Никаких других изменений не делай.
Почему это работает лучше ручной чистки? Потому что вы задаёте правила один раз, а модель применяет их к каждой строке одинаково. Человек на пятидесятой строке начинает пропускать, на сотой делает иначе, чем в начале. Модель ровно держит правило до последней строки.
После чистки вы получаете не просто файл, а отчёт о том, что было изменено. Этот отчёт удобно прикладывать к пояснению «почему цифры в отчёте отличаются от выписки на 4 операции». Подробно про работу с грязными выгрузками и дублями я писала в статье про бесплатные нейросети, которые чистят данные за финансиста.
Частая ошибка: просить модель «почистить таблицу» без правил. Модель начнёт фантазировать: переименует контрагентов, сократит названия, переформатирует то, что вы не просили. Поэтому в промпте я всегда перечисляю, что менять, а что не трогать. Пункт «Назначение платежа не менять, только убрать двойные пробелы» закрывает кучу неприятностей.
Операция 3. Разбор назначений платежа из банка
Выписка за месяц это сотни и тысячи операций с коротким текстом в поле «Назначение платежа»: «Оплата по сч. 412 от 14.08 за материалы, в т.ч. НДС 20%». Руками разобрать такую выписку на колонки «счёт, дата, товар, НДС» это два-три часа кропотливой работы. Особенно весело, когда назначения написаны в разных стилях: кто-то пишет «в т.ч. НДС», кто-то «включая НДС», кто-то вообще без пометки.
ChatGPT делает разбор за один промпт. Он читает каждый текст, извлекает из него структурированные поля и возвращает готовую таблицу. Там, где данных в тексте нет, ставит честное «не указано» вместо того, чтобы выдумать.
Промпт для разбора назначений платежа:
В приложении выписка по счёту: дата, контрагент, сумма,
назначение платежа.

Разбери колонку «Назначение платежа» на отдельные поля:
1. «Счёт»: номер счёта или договора из текста (например,
   «сч. 412»). Если номера нет, оставь пусто.
2. «Дата счёта»: дата из текста. Если даты нет, оставь пусто.
3. «Товар или услуга»: суть платежа: материалы, аренда,
   услуги, зарплата, налоги. Сократи до 2-4 слов.
4. «НДС»: признак: «НДС 20%», «НДС 10%», «без НДС»,
   «не указано». Определяй по тексту: «в т.ч. НДС»,
   «включая НДС», «НДС облагается»: это «НДС 20%»,
   если не указана другая ставка.
5. «Категория»: один вариант: материалы, услуги, зарплата,
   налоги, аренда, прочее. По смыслу текста.

Не додумывай данные. Если в тексте нет счёта, ставь пусто,
а не «счёт не указан». Верни полную таблицу с исходными
колонками и новыми полями.
Проверьте магию на одном примере. Строка «Оплата по сч. 412 от 14.08 за материалы, в т.ч. НДС 20%» превращается в: счёт 412, дата 14.08, товар материалы, НДС 20%, категория материалы. А строка «За услуги связи за август» становится: счёт пусто, дата пусто, товар услуги связи, НДС не указано, категория услуги.
После разбора у вас появляется таблица, по которой можно строить сводные: сколько ушло на материалы, сколько на услуги, где НДС к вычету. Раньше для этого надо было либо читать выписку построчно, либо писать сложную формулу с ПОИСКПОЗ и кучей условий. Теперь это промпт на две минуты. Разбор назначений платежа в связке со сверкой выписки и реестра я разбирала в статье про банковскую сверку через ChatGPT.
Важная оговорка: категоризация всегда немного субъективна. Один назовёт аренду услугой, другой отдельной категорией. Поэтому в промпте я задаю жёсткий список категорий, чтобы модель не придумывала новые. И всегда просматриваю строки с категорией «прочее»: туда обычно попадает всё неочевидное, и это самый ценный список для ручной работы.
Сводная по категориям: выписка превращается в управленческий отчёт
После разбора назначений следующий логичный шаг собрать сводную. Из колонки «Категория», которую вы получили на предыдущем шаге, модель собирает таблицу «категория, сумма за месяц, доля в выписке». Промпт для сводной строится по тому же образцу: перечислить колонки, попросить посчитать суммы по категориям, добавить долю в процентах, отсортировать по убыванию и обязательно добавить строку «Итого» с проверкой, что она равна сумме всех строк исходной таблицы.
Зачем отдельный промпт, если можно попросить в первом? Потому что сводная опирается на результат разбора. Если разбор был неточным, сводная покажет неверную картину. Два отдельных шага позволяют проверить каждый: разобрали, проверили категории, собрали сводную, проверили итог. Ошибка не закапывается в глубине одного большого запроса.
Операция 4. Сложная формула, которую страшно писать самому
Вложенные ЕСЛИ, СУММЕСЛИМН по трём условиям, индекс-поискпоз с матрицей. Любой финансист знает ощущение, когда формула должна быть, а мозг сопротивляется. Вы тратите час на то, чтобы собрать её из кусочков, потом ещё час, чтобы найти, почему она не работает, и в итоге либо упрощаете задачу, либо делаете костыль.
ChatGPT пишет сложную формулу за минуту, если вы описали правила. Он не устаёт от вложенности и не путается в скобках. Главное, что нужно от вас, это точное описание логики расчёта на человеческом языке.
Промпт для написания формулы:
Напиши формулу Excel для такой задачи.

Что есть:
- Колонка A: дата операции
- Колонка B: контрагент
- Колонка C: сумма
- Колонка D: признак оплаты («оплачено», «аванс», «долг»)

Что нужно: посчитать сумму по контрагенту из ячейки F1
(в неё вводится название), где признак оплаты равен «долг»
и дата операции раньше 01.01.2026.

Условия:
1. Если контрагент не найден, вернуть 0, а не ошибку
2. Если в колонке D пусто, не считать строку
3. Использовать функцию СУММЕСЛИМН
4. Объясни каждую часть формулы одной строкой
5. Скажи, какие ограничения есть у этого решения
Почему стоит писать формулу через нейросеть, а не гуглить? Потому что гугл даёт общий пример, который нужно подгонять под вашу таблицу. ChatGPT даёт формулу под вашу структуру: вы называете свои колонки, свои условия, свои даты, и получаете готовое решение. Плюс объяснение, которое можно проверить.
Но не останавливайтесь на первом варианте. Второй промпт из этой пары важнее первого: попросите модель найти ошибку в своей же формуле.
Ты написал формулу: [вставь формулу из прошлого ответа].
Проверь её как придирчивый ревизор:

1. Какие ошибки ты видишь в этой формуле?
2. При каком наборе данных она вернёт неверный результат?
3. Есть ли более короткий и надёжный вариант?
4. Напиши исправленную версию.

Особое внимание: проверь границы диапазонов, обработку пустых
ячеек и строки, где контрагент не найден.
Такой двойной прогон убирает почти все ошибки: сначала модель пишет решение, потом сама его критикует. Приём работает не только с формулами, но и с любыми расчётами. О том, как заставить нейросеть проверять себя внешним расчётом, я писала в статье про ошибки ChatGPT в цифрах и приёмы защиты.
Если формула получилась слишком сложной, попросите модель переписать её через вспомогательные столбцы. Разбитая на этапы логика читается легче, проще проверяется и реже ломается при вставке строк. Длинная формула на 15 вложений это не повод для гордости, а признак того, что логику пора вынести в отдельные ячейки.
Операция 5. Разбор чужой формулы: что делает этот столбец
Преемственность в финансах это боль. Вы приходите на новое место, открываете файл, а там 40 листов формул, написанных человеком, которого уже нет. Или коллега ушёл в отпуск, а вы должны проверить его расчёт. Читать чужую формулу мучительно: вложенные ЕСЛИ, именованные диапазоны, ссылки на другие листы.
ChatGPT разбирает чужую формулу за минуты. Он читает её, объясняет по частям и показывает, что она на самом деле делает, а не что должна делать по замыслу. Последнее важно: иногда формула работает, но считает не то.
Промпт для разбора формулы:
Объясни, что делает эта формула Excel:
[вставь формулу]

Расскажи простым языком, без сложных терминов:
1. Что она вычисляет в итоге, одним предложением
2. Какой ввод она использует (на какие ячейки ссылается)
3. Что делает каждая часть формулы, по шагам
4. При каких условиях она вернёт ошибку или неверный результат
5. Есть ли в ней подозрительные места: жёстко зашитые числа,
   ссылки на пустые ячейки, логика, которая может не совпадать
   с задумкой
6. Как эту формулу можно упростить

Если формула ссылается на другие листы, опиши, данные из каких
листов она использует. Не меняй формулу, только объясни.
Что вы получаете на выходе: перевод формулы с «машинного» на человеческий. Это работает и с формулами в ячейках, и с целыми листами. После такого разбора вы можете спокойно отвечать на вопрос «а что здесь считалось?» и принимать решения о правках.
Пример из практики: разбирала формулу расчёта премии, где была зашита ставка 0,25. По замыслу это был квартальный коэффициент, а в реальности формула работала как ежемесячный понижающий. Человек, который писал формулу, ушёл, никто не знал. Модель подсветила жёсткое число и спросила, откуда оно. Через десять минут выяснилось, что премии полгода считались неверно. Формально формула работала без ошибок. Логически она врала.
После разбора чужой формулы я советую сразу прогнать её через проверку по эталону. Возьмите 5-6 строк, посчитайте вручную или на калькуляторе и сравните с результатом формулы. Если расходится, отдайте модели оба варианта: ваш расчёт и формулу. Она найдёт, где логика ушла не туда. Приёмы из статьи про аудит формул в Excel через ChatGPT здесь работают напрямую.
Операция 6. Сверка двух таблиц и поиск расхождений
Сверка двух файлов это, пожалуй, самая недооценённая по времени операция. Выгрузка из 1С и реестр из банка, прошлая и новая версия бюджета, данные оператора и данные бухгалтерии. Руками это делается через сводные, ВПР и мучения: то не сходится, то сходится, но непонятно почему.
ChatGPT сводит две таблицы по ключу и выдаёт аккуратный список расхождений: что в первой есть, чего нет во второй, где суммы отличаются и на сколько. Всё в одной таблице, с колонкой «статус» и комментарием.
Промпт для сверки двух таблиц:
В приложении два файла: «01_реестр» и «02_выписка». Это данные
по одним и тем же операциям из двух систем.

Сверь таблицы между собой:
1. Найди ключ для сопоставления: если есть общая колонка
   (номер счёта, номер операции, ИНН), используй её.
2. Сопоставь строки и сравни суммы по каждой паре.
3. Раздели результат на группы:
   - «совпадает»: строка есть в обеих, суммы равны
   - «нет в выписке»: строка есть в реестре, но отсутствует
     в выписке
   - «нет в реестре»: строка есть в выписке, но отсутствует
     в реестре
   - «разница в сумме»: строка есть в обеих, но суммы
     отличаются. Укажи разницу в отдельной колонке.
4. Подведи итог: сколько строк в каждой группе, на сколько
   рублей общая разница по группе «разница в сумме».

Верни итоговую таблицу и сводку по группам. Если найти ключ
не получается, напиши об этом и предложи, по каким полям
сопоставить.
На выходе вы получаете не просто «есть расхождения», а полную картину: что, где и на сколько разошлось. Это заменяет час-полтора ручной сверки с чашкой кофе и нервным тиком. В связке с операцией по чистке данных сверка закрывает почти все вопросы при подготовке документов для банка и собственника.
Приём «сводки по группам» в конце промпта важен не только для сверки. Когда вы просите модель не просто выполнить операцию, а ещё и посчитать, сколько строк в каждом статусе, вы получаете цифру для объяснения руководству: «из 1 200 операций 1 176 совпали, 18 нет в выписке, 6 расходятся по сумме». Это убедительнее, чем «ну, вроде всё сошлось». Про сверку двух файлов и версий подробно в статье про сверку регистров через ChatGPT Code Interpreter.
Частая ошибка при сверке: не задать, что делать с дублями. Если в одном файле строка встречается дважды, а в другом один раз, модель может свести их как совпадение и испортить итоги. Поэтому я всегда добавляю в промпт строчку: «Если в одной таблице строка повторяется, обработай каждый повтор отдельно и пометь это в комментарии».
Операция 7. Перекладка отчёта из 1С в формат собственника
Формат, в котором отдаёт данные учётная система, почти никогда не совпадает с тем, что хочет видеть собственник. В 1С отчёт разложен по субсчетам и аналитикам, собственнику нужны три строки и понятный итог. Раньше это означало ручную перекладку: взять отчёт, руками перегруппировать строки, переименовать, собрать сводную, проверить, что итог совпал.
ChatGPT делает перекладку за минуты, если описать целевой формат. Это работает и для отчёта о прибылях и убытках, и для управленческого баланса, и для кассового разрыва.
Промпт для перекладки отчёта:
В приложении отчёт из 1С по продажам за квартал: разбивка по
субсчетам и аналитикам.

Переложи его в формат для собственника:
1. Объедини строки в укрупнённые группы: «Выручка»,
   «Себестоимость», «Валовая прибыль», «Коммерческие расходы»,
   «Управленческие расходы», «Прочие доходы и расходы»,
   «Чистая прибыль».
2. Для каждой группы посчитай сумму из исходных строк.
3. Добавь колонку «Доля в выручке» в процентах.
4. Итоговая строка «Чистая прибыль» должна совпасть с итогом
   исходного отчёта. Проверь это и напиши, сходится ли.
5. Верни компактную таблицу на одну страницу: группа, сумма,
   доля в выручке, комментарий (какие исходные строки вошли).

Если какие-то исходные строки не укладываются в группы, не
выбрасывай их: собери в группу «Прочее» и перечисли в
комментарии.
Смысл операции не в том, чтобы модель придумала формат, а в том, чтобы она выполнила рутинную перегруппировку без ошибок и проверила, что итог сходится. Пункт «проверь, сходится ли» превращает перекладку из ручной работы в процесс с контролем качества.
После перекладки я всегда сверяю итог: сумма «Чистая прибыль» в новом формате должна быть равна итогу исходного отчёта. Модель пишет, сходится или нет, но проверяю я руками. Это двадцать секунд, а спокойствия много. Про то, как собирать управленческую отчётность через нейросети, читайте в статье про управленческую отчётность собственнику через ChatGPT.
Ещё один вариант этой операции: когда нужно из текстового отчёта или PDF собрать таблицу Excel. ChatGPT вытаскивает цифры из документа и раскладывает по колонкам. Для этого не нужен файл Excel, достаточно загрузить PDF или скан. Про перевод таблиц из текста и картинок в Excel я рассказывала в статье про таблицы из текста через нейросеть.
Сравнение моделей для работы с Excel: что выбрать в 2026 году
Когда я показываю эти операции на вебинарах, всегда звучит один и тот же вопрос: «А какой нейросетью это делать?». Отвечаю честно, с цифрами и без рекламных обещаний.
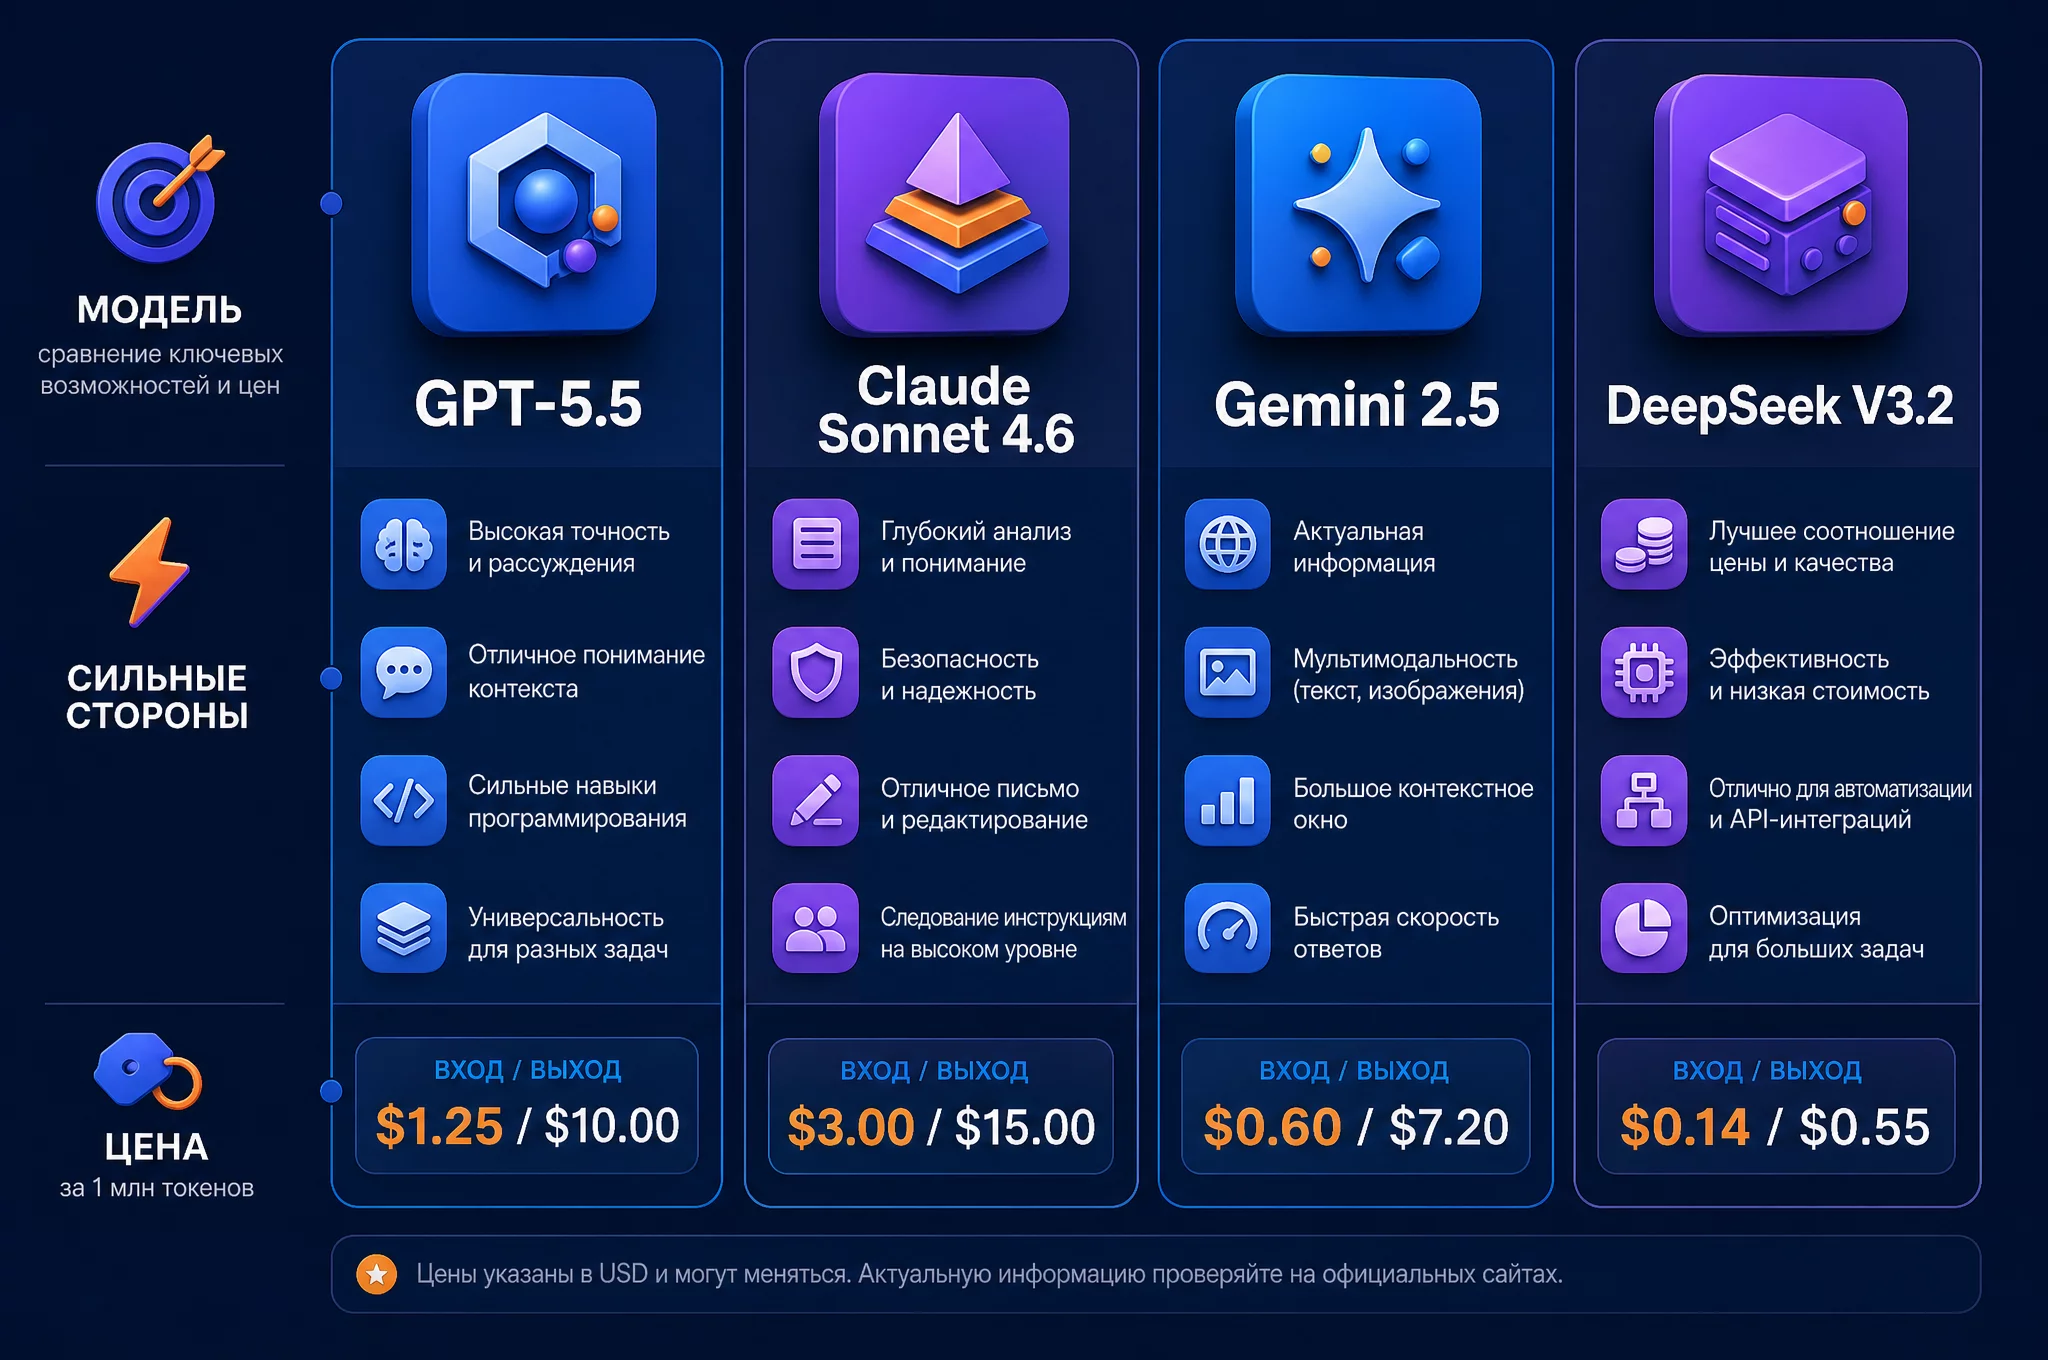
| Модель | Где сильна | Где слабее | Стоимость | Кому подойдёт |
|---|---|---|---|---|
| GPT-5.5 | Чтение xlsx, код на Python для пересчёта, память между диалогами, скорость | Длинные книги на десятки листов тяжелее | Платно, есть бесплатный лимит | Основная рабочая лошадка для большинства задач |
| Claude Sonnet 4.6 | Сложные вложенные формулы, длинные документы, точность логики | Не читает xlsx так же глубоко, как GPT-5.5 | Платно | Разбор формул, анализ длинных моделей |
| Gemini 2.5 | Google Таблицы, интеграция с экосистемой Google | Сложные финансовые логики чуть слабее | Платно, щедрый бесплатный лимит | Работа в Google Sheets |
| DeepSeek V3.2 | Бесплатно, неплохо для черновиков | Ошибки в логике на длинных цепочках | Бесплатно | Черновики, простые задачи на обезличенных данных |
Эта таблица актуальна на август 2026 года. Модели выходят часто, и через полгода расклад может поменяться. Поэтому я советую не привязываться к одной модели, а проверять одну и ту же задачу на двух-трёх и выбирать ту, которая стабильнее на вашем типе файлов.
Мой личный расклад такой: на 80% задач с Excel работаю в GPT-5.5, потому что он читает xlsx напрямую, помнит структуру моих таблиц и умеет пересчитывать на Python. Сложные формулы и длинные книги, где логика запутана, отправляю в Claude Sonnet 4.6. В Google Таблицах работаю с Gemini 2.5, потому что он встроен в среду. DeepSeek V3.2 держу как бесплатный запасной вариант для черновых проверок на обезличенных данных.
Про честное сравнение нейросетей для таблиц и их возможности писать формулы я подробно писала в статье про сравнение нейросетей для Excel и в большой статье про выбор нейросети для финансиста в 2026 году.
Один практический совет: не гоняйте между моделями те задачи, которые уже отлажены. Если промпт для разбора назначений платежа стабильно работает в GPT-5.5, не переключайтесь на другую модель в разгар закрытия месяца. Отладка занимает время, а время в конце месяца дороже всего.
Три кейса с цифрами: сколько часов и рублей экономит ChatGPT
Теория хороша, но финансисты верят цифрам. Собрала три кейса из своей практики и практики выпускников курса. Цифры честные, имена изменены по понятным причинам.
Кейс 1. Сверка выписки с реестром: 40 минут вместо 3,5 часов
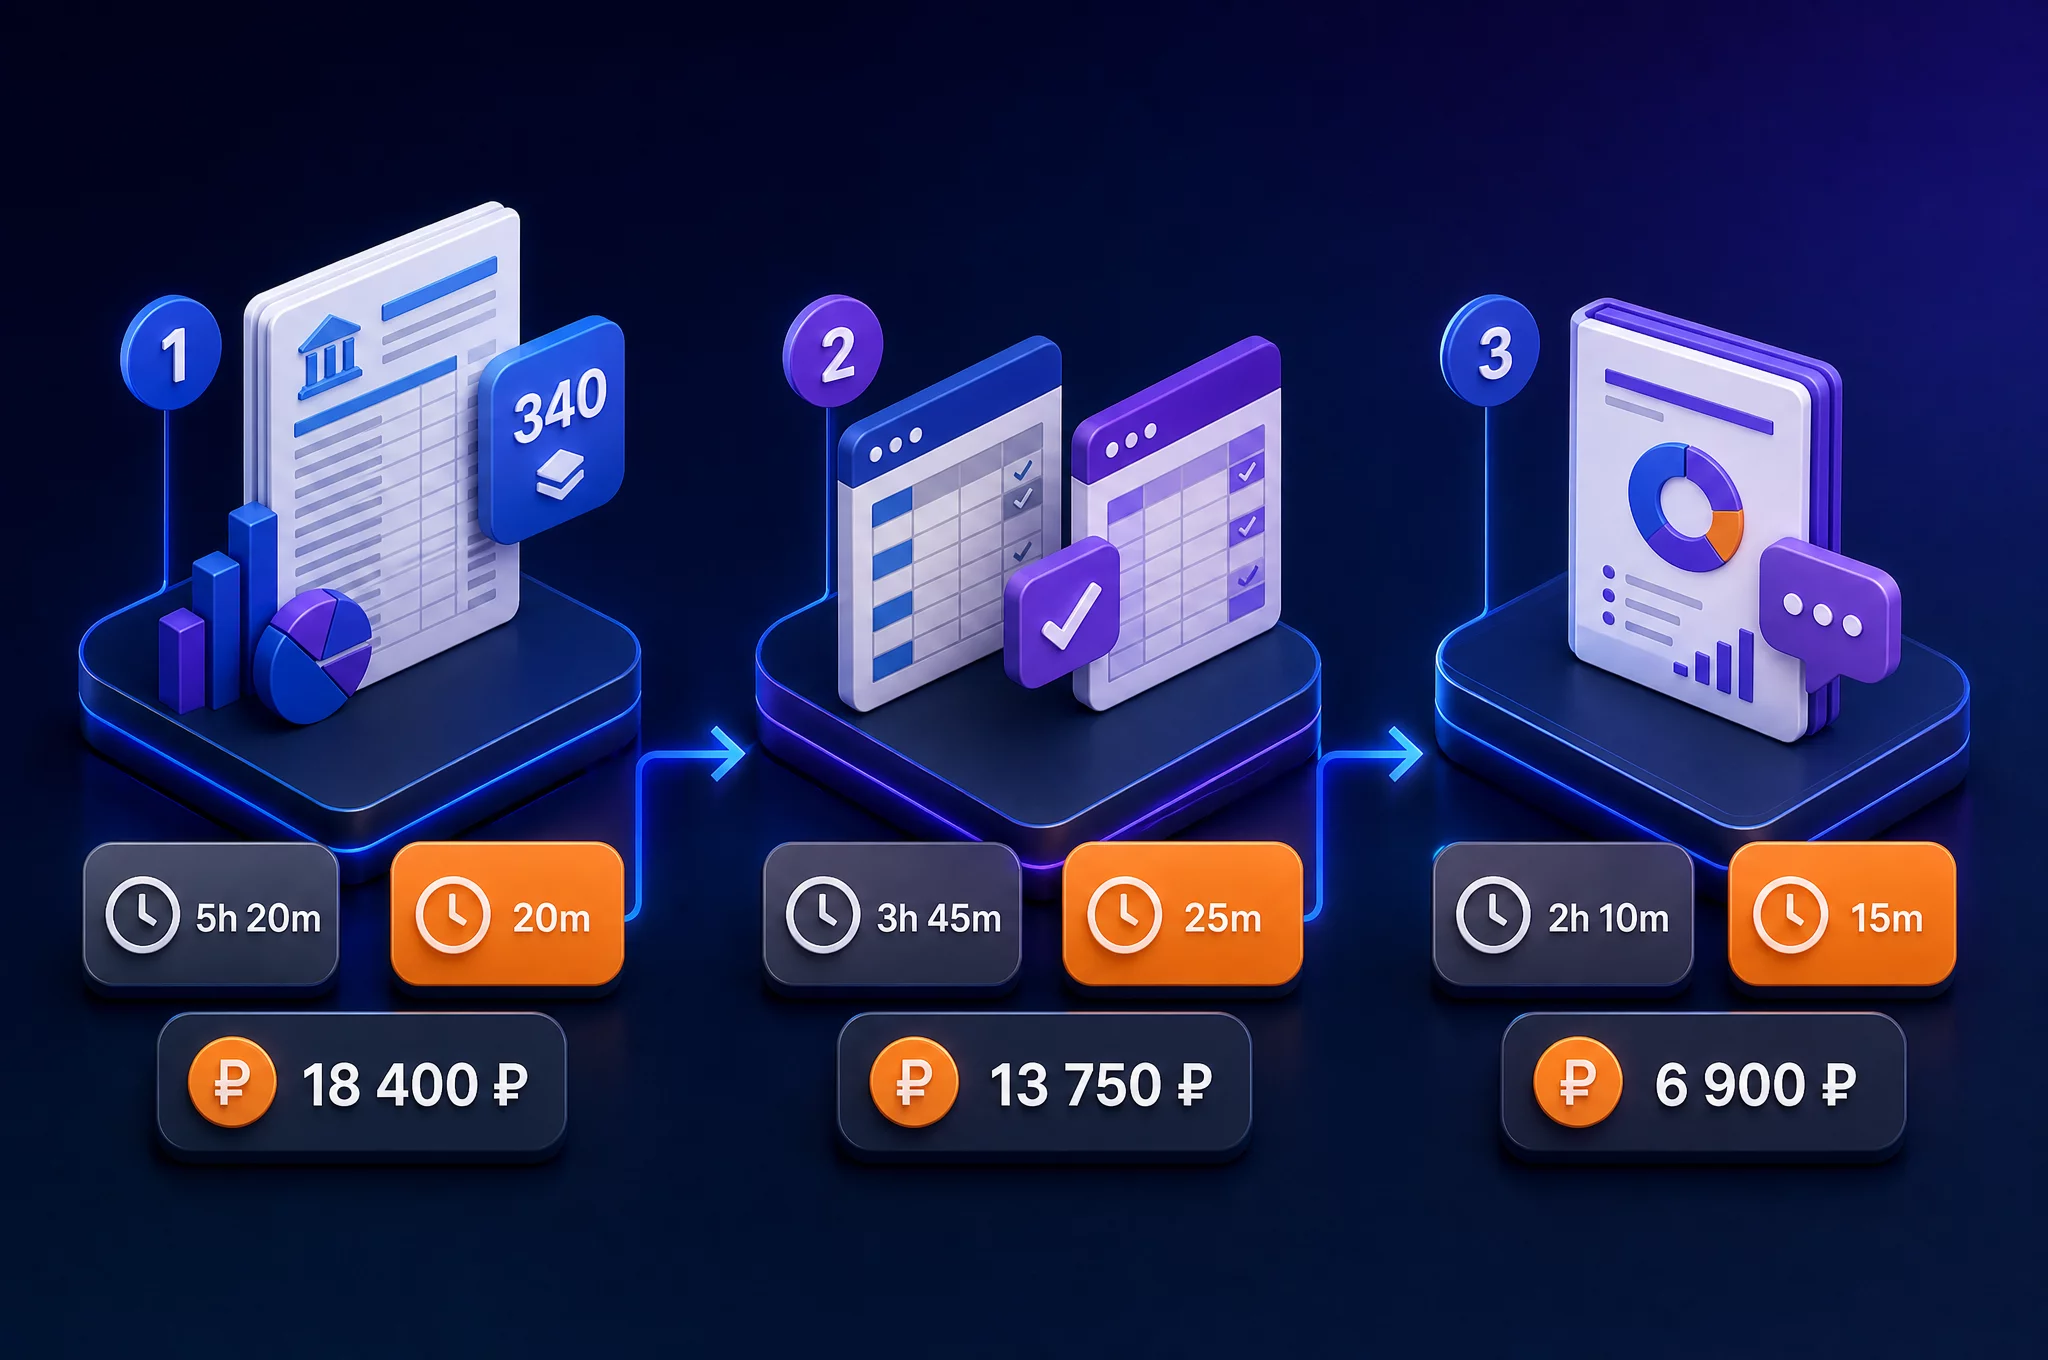
Финансовый директор торговой компании, Москва. Каждый день она получала выписку банка с 1 000-1 200 операциями и сводила её с реестром платежей в 1С. Раньше это занимало 3-4 часа в неделю: выгрузка, ВПР, ручной разбор несовпадений, звонки в банк по непонятным операциям.
Что сделали: настроили промпт из операции 6, обезличили контрагентов в выгрузке, добавили правило «дубли обрабатывать отдельно». Первый прогон показал 28 расхождений, разобрали их за вечер: 12 оказались двойными строками в выгрузке, 9 разницей в суммах из-за комиссии, 7 не хватало в реестре.
Стало: 40 минут на всю сверку. Из них 10 минут на выгрузку и обезличивание, 4 минуты на прогон через нейросеть, 25 минут на разбор расхождений. Экономия 3 часа в неделю, то есть около 12 часов в месяц. В деньгах при ставке такого специалиста это примерно 35-45 тысяч рублей в месяц только на одной операции. За год набегает больше сотни сэкономленных часов.
Кейс 2. Объединение таблиц для отчёта собственнику: 15 минут вместо полдня
Главный бухгалтер производственного предприятия, Екатеринбург. Квартальный отчёт собственнику требовал объединить продажи из 1С, реестр договоров и данные по дебиторке. Раньше он садился за это на полдня: три таблицы, три формата, названия контрагентов не совпадают.
Что сделали: загрузили три файла, описали структуру каждого, запустили промпт объединения из операции 1. Модель сопоставила 780 строк, 41 не нашла по названию. Из этих 41 почти все оказались старыми контрагентами с закрытыми договорами.
Стало: 15 минут на объединение и 20 минут на ручной разбор «не найдено». Вместо полдня. Квартальный отчёт перестал быть событием, которое откладывается на выходные.
Кейс 3. Разбор назначений платежа за 20 минут вместо 2 часов
Аутсорсинговый бухгалтер, Санкт-Петербург. Ведёт счета пяти небольших компаний. Каждый месяц ей нужно было раскладывать выписки клиентов на категории для управленческого учёта. Две-три выписки по 500-600 операций, каждая назначение написано в своём стиле.
Что сделали: промпт из операции 3, с жёстким списком категорий и правилом «не додумывай». Модель разобрала все 600 операций за 2-3 минуты. Бухгалтер просмотрела категорию «прочее»: там оказалось 34 операции, 20 из них она переопределила руками.
Стало: 20 минут на клиента вместо 2 часов. На пять клиентов экономия около 8 часов в месяц. Она перестала делать разбор по вечерам и перераспределила это время на новых клиентов, что добавило ей выручки примерно на 15% за квартал.
Во всех трёх кейсах схема одинаковая: операция уходит в нейросеть, проверка остаётся за человеком. Модель ускоряет рутину, а человек добавляет контекст, который модель не видит: почему этот контрагент старый, почему эту операцию надо переопределить, почему комиссия банка не считается расхождением. Именно это сочетание даёт и скорость, и точность.
Как проверять результат, чтобы не попасть на ошибку модели
Проверка это не «недоверие», а рабочий шаг, который занимает 5-10 минут и закрывает почти все риски. Делюсь своей схемой из трёх точек контроля.
Первая точка: сверка итогов. У любой операции есть контрольная сумма: итог выписки, сумма всех строк реестра, общий объём по отчёту. Сравните итог исходной таблицы и итог результата. Если они совпадают, основная масса ошибок уже отсечена. Это занимает одну минуту.
Вторая точка: выборочная сверка строк. Возьмите 5-6 случайных строк и проверьте их вручную: как модель сопоставила, как разнесла, как посчитала. Если случайные строки сходятся, вероятность системной ошибки низкая. На это уходит 3-4 минуты.
Третья точка: просмотр «подозрительной» категории. У любой операции есть категория, куда модель складывает всё непонятное: «не найдено», «прочее», «без НДС». Просмотрите её целиком. Именно там прячутся ошибки и неоднозначности, которые надо решать человеку.
Промпт для контрольной проверки результата:
Проверь результат своей же работы.

Была задача: [опиши задачу одной строкой].
Результат ты уже вернул.

Проверь:
1. Сходится ли итог результата с итогом исходных данных?
   Посчитай оба итога и сравни.
2. Есть ли строки, где результат противоречит исходным данным?
3. Есть ли пустые ячейки там, где данные должны быть?
4. Сколько строк в статусах «не найдено», «прочее» и подобных?
   Перечисли их, чтобы я проверил руками.

Найди ошибки, а не подтверждай правильность. Если всё верно,
напиши, что проверил и что сходится.
Этот промпт заставляет модель проверять себя, а не выдавать «всё отлично». На финансовых данных «всё отлично» без проверки не принимается ни от человека, ни от модели.
Частые ошибки и мифы про «ChatGPT и Excel»
За два с половиной года работы с нейросетями я наслушалась мифов и насмотрелась типовых ошибок. Разберу самые частые, чтобы вы не наступали на те же грабли.
Миф 1. «ChatGPT считает неправильно, ему нельзя доверять цифры». Частично правда: если просто бросить модели файл и спросить «посчитай», она может ошибиться. Но если дать правила, попросить пересчитать на Python и проверить итог, ошибки почти исчезают. Проблема не в модели, а в промпте. Я писала об этом в статье про ошибки ChatGPT в цифрах.
Миф 2. «Нейросеть заменит меня и заберёт работу». Не забирает. Она берёт рутину, а освободившееся время уходит на анализ, контроль и общение с собственником. Те, кто научился работать с нейросетями, не теряют работу, а получают её больше: они закрывают три компании вместо одной.
Ошибка 1. Не описывать структуру файла. Вы загружаете таблицу и пишете «сопоставь», а модель гадает, что в колонках. Всегда описывайте, что где лежит, хотя бы одной строкой: «Колонка A дата, колонка B контрагент, колонка C сумма».
Ошибка 2. Просить «поставить ВПР» вместо «сопоставить». Модель сделает буквально: поставит ВПР и вернёт «Н/Д». А вам нужно умное сопоставление с учётом сокращений. Формулируйте по результату.
Ошибка 3. Загружать файл с личными данными. Контрагенты, ИНН, ФИО. Это и утечка, и нарушение. Обезличивание занимает три минуты, а привычка экономить на нём аукается.
Ошибка 4. Принимать первый ответ без проверки. Модель может ошибиться, и на финансовых данных это дорого. Проверка итоговых сумм занимает 10 минут и обязательна. Проверяйте, но не перепроверяйте каждую строку: выборочная сверка плюс сверка итогов закрывает 95% проблем.
Миф 3. «ChatGPT работает только с английским». Работает с русским отлично: понимает и «в т.ч. НДС», и «выручка по субсчетам», и «дебиторка». Главное, чтобы данные и промпты были на одном языке, иначе модель начнёт путаться.
Ошибка 5. Делать всё в одном гигантском промпте. «Почисти, объедини, посчитай, построй отчёт» в одном запросе. Дробите: чистка отдельно, объединение отдельно, расчёт отдельно. Каждый шаг проще проверить, и ошибка не расползается по всему файлу.
Миф 4. «Это сложно, я не программист». Для работы с таблицами через ChatGPT не нужен код. Нужно уметь сформулировать задачу словами и описать правила. Остальное делает модель. Если вы умеете объяснить бухгалтеру, что от него нужно, вы умеете писать промпты.
Когда ChatGPT не поможет: честные границы
Не люблю продавать воздух, поэтому сразу скажу, где нейросеть бессильна. Это важно, чтобы вы не потратили время впустую.
Первое: сверхточные расчёты с валютными курсами и налоговыми нюансами. Модель может не знать свежий курс или особенности конкретной нормы. Если расчёт зависит от данных, которых нет в файле и которые меняются каждый день, проверяйте особо тщательно.
Второе: файлы с макросами VBA и сложными связанными книгами. ChatGPT читает xlsx, но макросы он не запускает, а связанные внешние ссылки между книгами может понять не полностью. Для таких случаев нужны другие инструменты.
Третье: полная автоматизация без человека. Модель не поставит себя в расписание и не будет сама запускаться каждое утро. Если нужна автоматизация по расписанию, это уже про связки и агентов, а не про разовые промпты.
Четвёртое: интерпретация неоднозначных операций. Модель не знает деловой контекст: почему этот платёж «прочее», а не «материалы». Это знаете вы. Поэтому в промптах я прошу модель не додумывать, а помечать сомнительное.
Граница проходит так: всё, что имеет правила, отдаём модели. Всё, что требует контекста и ответственности, оставляем себе. Это правило я повторяю на каждом вебинаре, потому что оно уберегает от двух крайностей: слепого доверия и полного отказа.
Первый час с ChatGPT: с чего начать, если вы ещё не пробовали
Если вы дочитали до этого места, но ни разу не открывали ChatGPT с таблицей, не откладывайте на потом. Первый час устроен так, чтобы вы сразу увидели результат, а не закопались в теории.
Первые 10 минут: заведите аккаунт и откройте chatgpt.com. Выберите тариф: для работы с файлами удобнее платный, в нём есть загрузка xlsx в полном объёме и отключение обучения на данных. Бесплатного лимита хватает на знакомство, но для регулярной работы с таблицами платный тариф оправдан.
Следующие 10 минут: загрузите реальный файл. Возьмите свою выгрузку или выписку и запустите промпт «опиши файл» из начала статьи. Просто посмотрите, как модель описывает ваши данные. Если описание совпадает с реальностью, база для работы есть.
Ещё 20 минут: выполните одну операцию. Начните с самой простой и болезненной: разбор назначений платежа или чистка выгрузки. Возьмите готовый промпт из статьи, подставьте названия своих колонок, запустите. Сравните результат со своим привычным способом: сколько времени заняло, сколько нашлось неожиданного.
Последние 20 минут: проверьте результат. Сверьте итоги, посмотрите, что модель поменяла, решите, что можно использовать, а что переделать. Вы получите не просто опыт, а первый сэкономленный час.
План первого часа специально такой: файл, одна операция, проверка. Никакой теории, никаких «а давайте попробуем ещё 14 моделей». Один прогон на своих данных убеждает сильнее, чем сто статей. Если после часа появилось ощущение «я мог бы делать это быстрее», значит, вы на верном пути.
Самые частые возражения на этом шаге я слышу так: «У меня нет времени разбираться». Отвечаю: час на знакомство это 36 часов экономии в год, если хотя бы одна операция из семи уходит в автоматизацию. Окупается с лихвой. Сомневаетесь в выборе тарифа или модели, посмотрите статью про бесплатные нейросети для Excel и про выбор нейросети финансисту, там разложено по ценам.
Как превратить разовые промпты в повторяемый процесс
Разовый промпт экономит час. Повторяемый процесс экономит недели. Разница между ними в пяти минутах подготовки один раз.
Когда вы нашли рабочий промпт для своей типовой задачи, не оставляйте его в истории диалога. Сохраните в отдельный файл или заметку с заготовкой под ваш отчёт. В следующем месяце вы просто меняете месяц в названии файла, подставляете новую выгрузку и запускаете тот же промпт.
Как я строю повторяемый процесс на примере закрытия месяца:
Первый шаг: собрать библиотеку промптов. Отдельный файл на каждую типовую операцию: сверка выписки, разбор назначений, перекладка отчёта, объединение таблиц. Каждый промпт проверен, отлажен и описан одной строкой, для чего он.
Второй шаг: один диалог на один отчёт. Не смешивайте задачи в одном чате. Сверка выписки и разбор назначений живут в разных диалогах. Так контекст не путается и модель не начинает решать сверку правилами разбора.
Третий шаг: шаблон имени файла. «01_выписка_август.xlsx», «02_реестр_август.xlsx». Модель видит порядок и понимает, что за файл перед ней, а вы не путаетесь в версиях.
Четвёртый шаг: ежемесячная проверка промпта. Раз в квартал прогоняйте библиотеку на свежих данных и смотрите, что изменилось. Формат выгрузки из 1С мог поменяться, банк мог добавить новое поле в выписке. Промпт подстраивается за пару минут.
Создай шаблон ежемесячной задачи из этого описания.

Отчёт: закрытие месяца. Каждый месяц повторяется одна и та же
последовательность:
1. Сверка выписки банка с реестром 1С
2. Разбор назначений платежа по категориям
3. Перекладка ОПиУ в формат собственника

Для каждого шага напиши:
1. Готовый промпт с местами для подстановки (название файла,
   месяц, правила)
2. Какую проверку результата делать после шага
3. Какие типичные проблемы ожидать и как их чинить

Оформи как чек-лист на месяц, который можно пройти сверху вниз.
Такой шаблон превращает хаос закрытия месяца в понятную последовательность из трёх шагов, каждый по 15-20 минут. Через пару месяцев вы не вспомните, как жили без этого списка.
Чек-лист: сокращение задачи в Excel через ChatGPT
Шесть шагов, по одному на каждую задачу. Сохраните в заметки и прогоняйте, пока не войдёт в привычку.
- Сформулируйте задачу одним предложением. «Сопоставить таблицы по ИНН», «почистить выгрузку», «разобрать назначения». Чёткая цель задаёт рамку.
- Обезличьте данные. Контрагенты, ИНН, счета и ФИО замените масками. Выключите обучение на данных. Документы под NDA в публичные тарифы не грузим.
- Загрузите файл и опишите структуру. Скажите модели, что в каждой колонке и по каким правилам считаются данные.
- Запустите промпт и получите результат. Возьмите готовый промпт из статьи или соберите свой по образцу.
- Проверьте итоги руками. Сверьте итоговые суммы, выборочно проверьте строки, посмотрите на подозрительные места.
- Сохраните удачный промпт в библиотеку. Через месяц он сработает снова и сэкономит время на формулировке.
Чек-лист короткий, но каждый пункт закрывает конкретный риск: без описания структуры модель гадает, без обезличивания течёт информация, без проверки ошибка уходит в отчёт. Шесть шагов на задачу, и ни один не лишний.
FAQ: частые вопросы про работу с Excel через ChatGPT
Почему простая задача в Excel занимает 2 часа? Потому что на операцию уходит 15 минут, а остальное на правки: несовпадения названий, скрытые символы, дубли, даты-текстом, проверка. ChatGPT берёт операцию и чистку сразу, поэтому общее время сжимается до 15-20 минут включая проверку.
Какие операции ChatGPT сжимает до минуты? Объединение таблиц, чистка выгрузок, разбор назначений платежа, сложные формулы, разбор чужих формул, сверка двух файлов, перекладка отчётов. Для каждой есть готовый промпт в статье.
Можно ли загружать файлы Excel прямо в ChatGPT? Да. xlsx, xls, csv и скриншоты таблиц прикрепляются в диалоге на chatgpt.com. Крупные книги лучше разделять на листы.
Безопасно ли загружать финансовые данные? Только после обезличивания и отключения обучения в платном тарифе. Контрагенты, ИНН и ФИО маскируются, документы под NDA в публичные тарифы не грузятся.
ChatGPT сам меняет файл? Да, он может вернуть исправленный файл прямо из диалога. Но для финансовых таблиц правки лучше проверять и вносить осознанно.
Какая нейросеть лучше для Excel? GPT-5.5 для основной работы, Claude Sonnet 4.6 для сложных формул и длинных книг, Gemini 2.5 для Google Таблиц, DeepSeek V3.2 бесплатно для черновиков.
Сколько времени экономит работа через ChatGPT? В кейсах статьи: сверка выписки 40 минут вместо 3-4 часов, объединение 15 минут вместо полдня, разбор назначений 20 минут вместо 2 часов. В среднем 75-90% времени на рутине.
Что делать, если модель путается в таблице? Проверьте, что файл открылся, опишите структуру колонок, задайте правила, разбейте задачу на части. Попросите модель описать файл своими словами до начала работы.
Нужно ли для этого уметь программировать? Нет. Нужно уметь сформулировать задачу словами и описать правила. Если вы умеете объяснить коллеге, что от него нужно, вы умеете работать с ChatGPT.
Что дальше
Семь операций из этой статьи это фундамент. Когда вы освоите их, следующий шаг собрать вокруг нейросетей весь контур финансовой работы: от закрытия месяца до отчёта собственнику. На курсе «AI-навыки финансиста» онлайн-школы «Финансовый директор | Мастер CFO» разбираю, как выстроить такую систему: от обезличивания данных до библиотеки промптов под ваши процессы. 10 модулей, 800+ выпускников, диплом установленного образца с лицензией и налоговый вычет 13%. Начать можно с бесплатного эфира-экскурсии, где показываю процесс на живых файлах.
Записаться на курс «AI-навыки финансиста»
Для тех, кто хочет продолжить самостоятельно: посмотрите статью про большой бесплатный курс нейросетей для финансиста, там ещё больше готовых промптов и приёмов, и статью про закрытие месяца с ChatGPT, где весь процесс разобран целиком.
Наши каналы для финансистов
@findir_pro. Основной Telegram-канал «Финансовый директор | Мастер CFO». 45 000 подписчиков. Ежедневно: практические разборы, кейсы выпускников, обновления инструментов, новые промпты для финансистов.
«АИ с Софьей и Натали». Канал об AI для финансистов. 13 000 подписчиков. Вместе с Софьей Бурцевой, основателем школы, разбираем новые модели, делаем живые тесты и публикуем обновлённые промпты сразу после выхода новых версий.
MAX. Закрытое сообщество для действующих финансовых директоров. 5 000+ участников. Кейсы коллег, шаблоны, закрытые эфиры по AI и стратегии CFO.
Об авторе
Натали Васильева. Эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO». С нейросетями в работе финансиста с февраля 2023 года. Через курс «AI-навыки финансиста» прошли 800+ финансистов, главбухов и финдиров. Веду Telegram-канал @findir_pro (45 000 подписчиков) и MAX-канал «Финансовый директор» (5 000+).