AI для финансиста
Нейросеть вместо Excel: создаём таблицы из текстового описания бесплатно, ChatGPT, DeepSeek и Gemini

Да, нейросеть превращает текстовое описание в структурированную таблицу за пару минут. Вы вставляете в чат абзац текста или загружаете файл, перечисляете нужные колонки и получаете готовую таблицу, которую остаётся проверить и перенести в Excel. На этом держится половина задач финансового отдела: бюджет из переписки в мессенджере, реестр договоров из сканов, реестр платежей из выписки с примечаниями, план-факт из текстового отчёта.
Если коротко: на сборку таблицы из 40-50 строк уходит 10-20 минут, на проверку ещё 20-40, итого час вместо вечера ручного ввода. По опыту школы экономия на задачах «текст в таблицу» составляет от 5 до 10 раз по времени. Ниже показываю, как именно это работает, на каких моделях и что проверить, прежде чем доверить нейросети цифры.
Я Натали Васильева, эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO». Основатель школы это Софья Бурцева. Вместе мы ведём каналы, где 45 000 подписчиков в @findir_pro, 13 000 в «АИ с Софьей и Натали», 5 000+ в MAX, а через курс «AI-навыки финансиста» прошли 800+ выпускников. Каждую неделю я вижу одну и ту же картину: специалист тратит вечер на то, чтобы вбить в Excel данные из текста, который нейросеть структурирует за десять минут.
Актуально на август 2026 года. Про доступ сразу: сайт chatgpt.com и claude.ai могут требовать специальных средств доступа, выбор сервиса и средств остаётся за вами. DeepSeek работает без VPN. Дальше к этой теме не возвращаюсь.
В этой статье сравниваю ChatGPT (GPT-5.5), DeepSeek V3.2, Gemini 2.5 и Claude Sonnet 4.6 именно на задаче «текст в таблицу». Даю пошаговый алгоритм, 12 готовых промптов, сравнительную таблицу и три кейса с часами и рублями из практики школы. Если вы ещё не работали с нейросетями в финансах, начните с базовой статьи ChatGPT для финансиста и бухгалтера, там установка и первые задачи. А если интересно, какие модели вообще доступны без платной подписки, посмотрите AI в Excel бесплатно: сравнение нейросетей.
Что такое таблица из текста и как нейросеть её собирает?
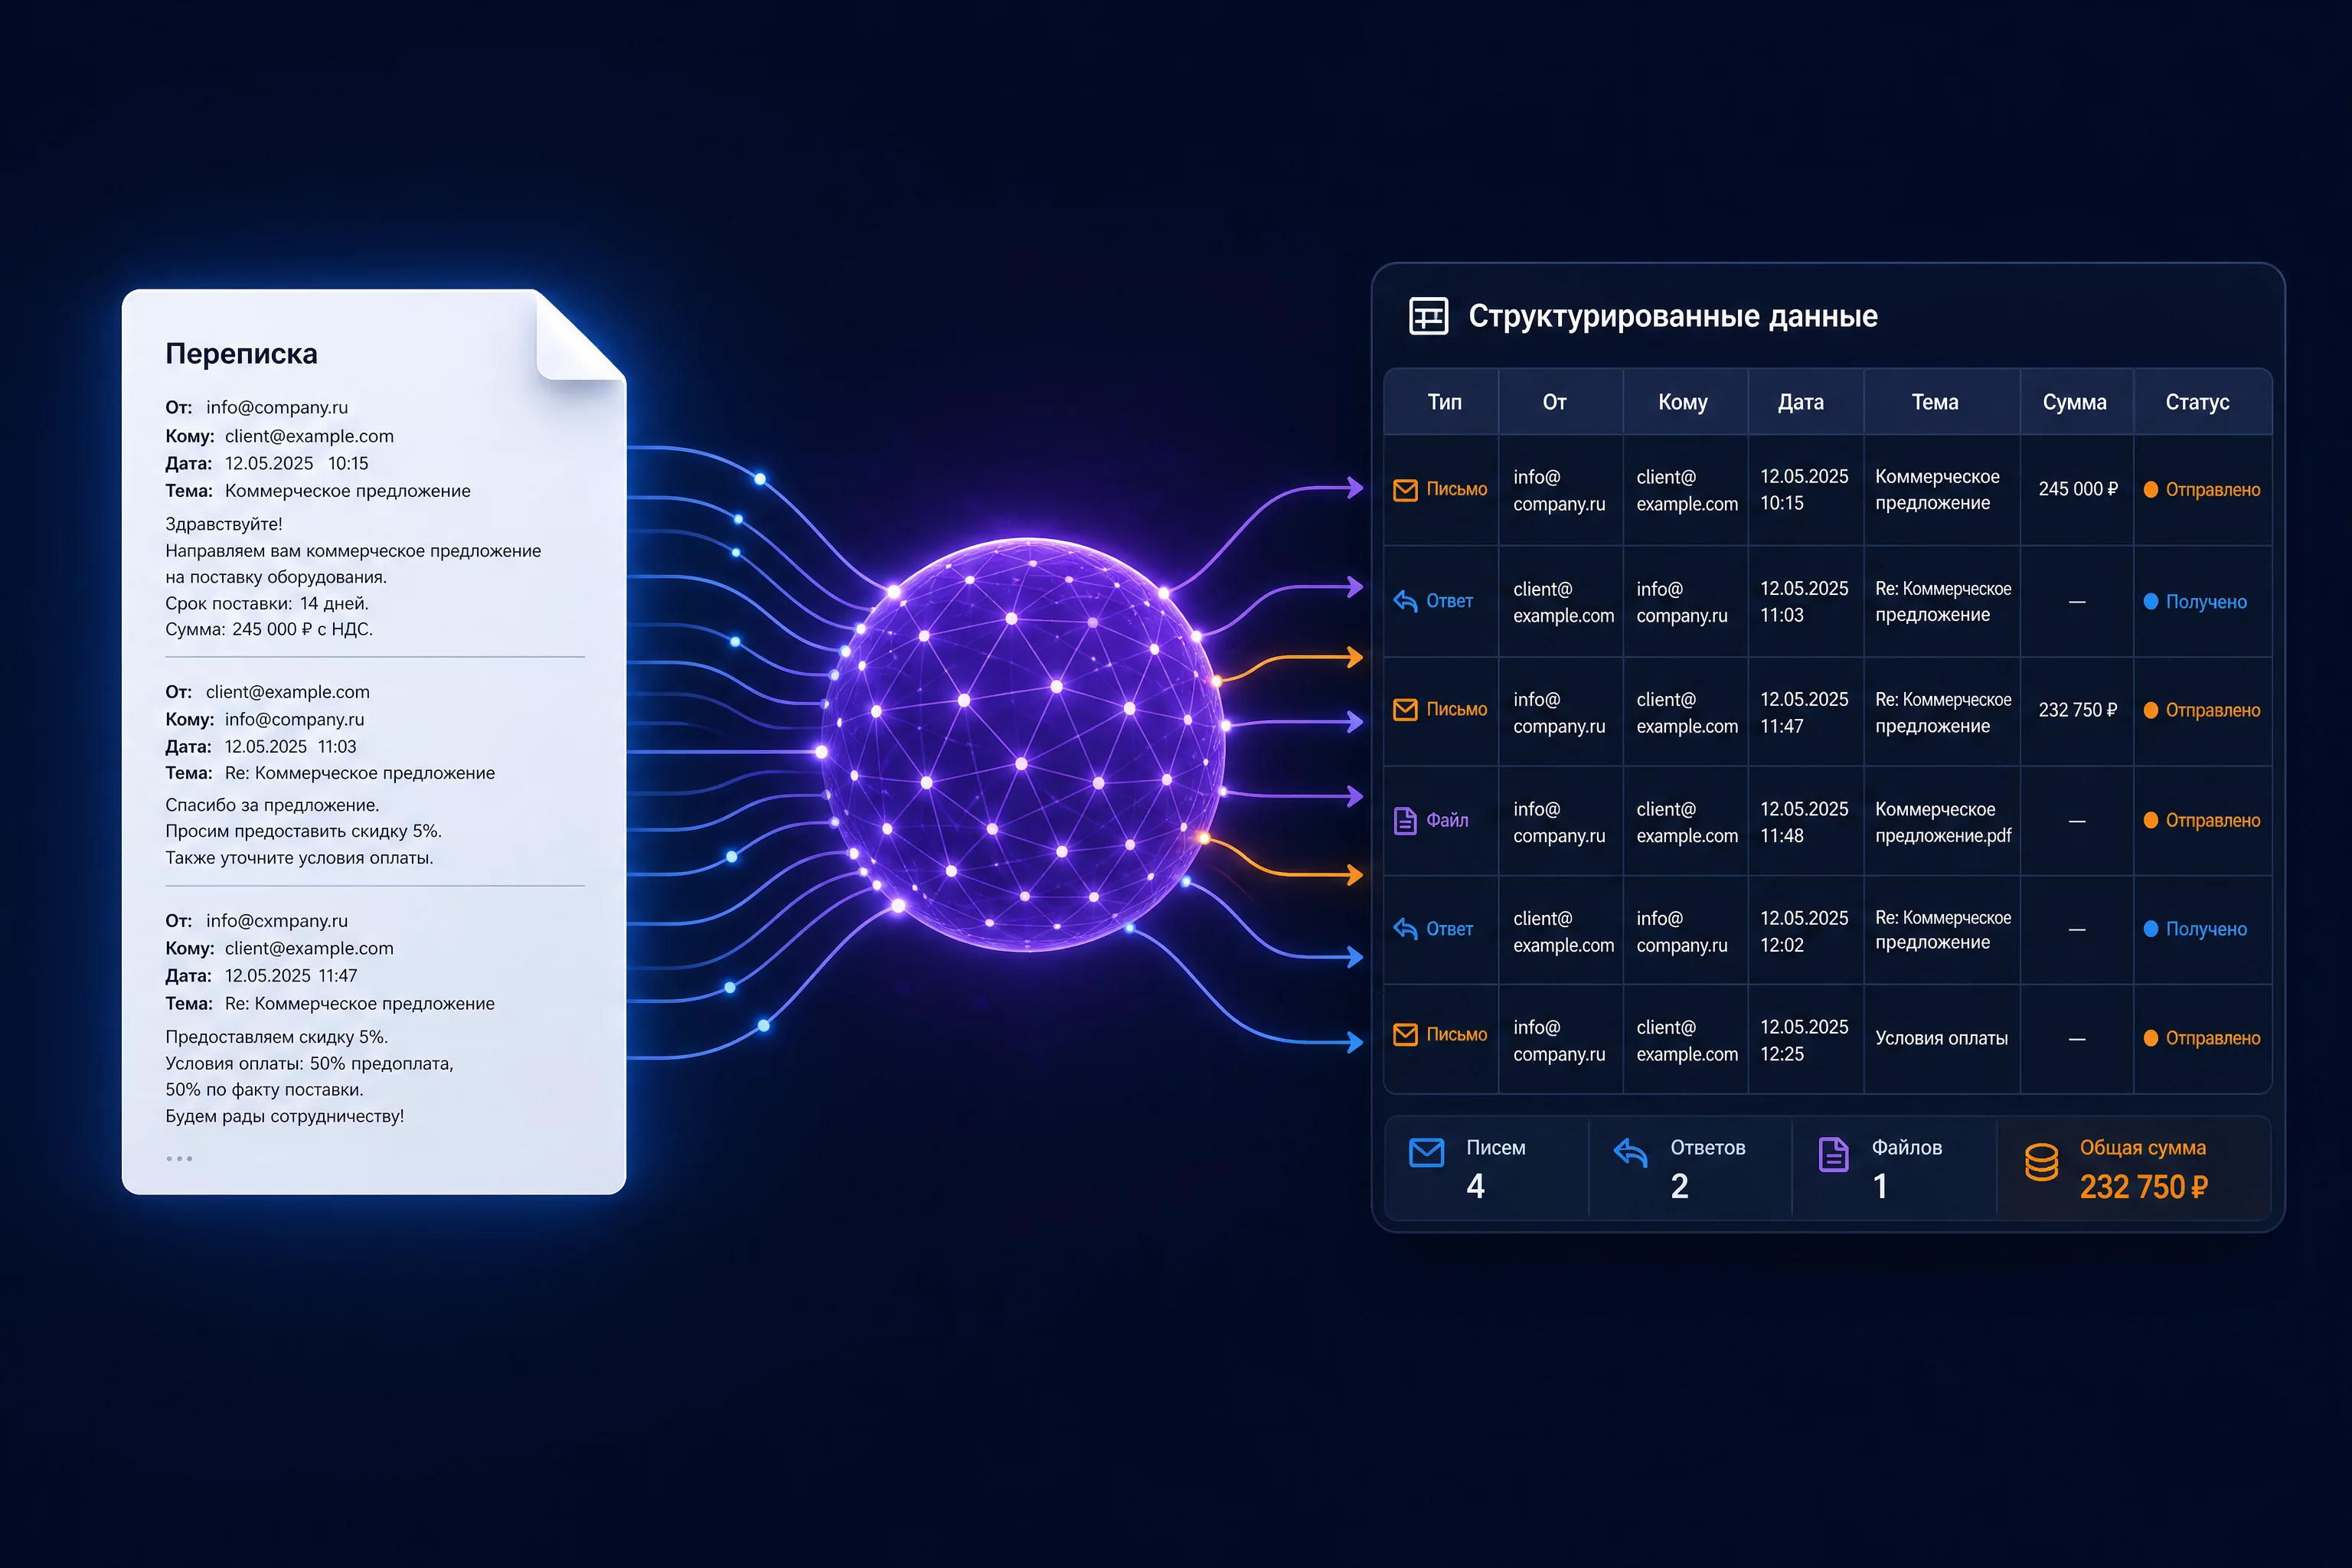
Таблица из текстового описания это результат, который нейросеть собирает из неструктурированного текста: переписки, выписки, скана, отчёта, списка в свободной форме. Модель читает текст, понимает смысл каждой фразы и раскладывает его по колонкам, которые вы задали. Получается таблица, которую можно скопировать в Excel, посчитать итоги и использовать в работе.
Внутри всё работает проще, чем кажется. Нейросеть это большая языковая модель, LLM, обученная на огромном объёме текстов. Когда вы просите её сделать таблицу, она не «ищет» таблицу в базе, а предсказывает ответ по тому же принципу, что и в обычном диалоге, только в формате строк и колонок. Поэтому качество результата напрямую зависит от того, как вы описали задачу.
Ключевое отличие от Excel: Excel работает с уже готовыми данными, а нейросеть данные добывает из текста. Вы не вбиваете строки руками, вы объясняете модели, что считать строкой и что положить в каждую колонку. Остальное она делает сама.
Какие таблицы можно собрать из текста
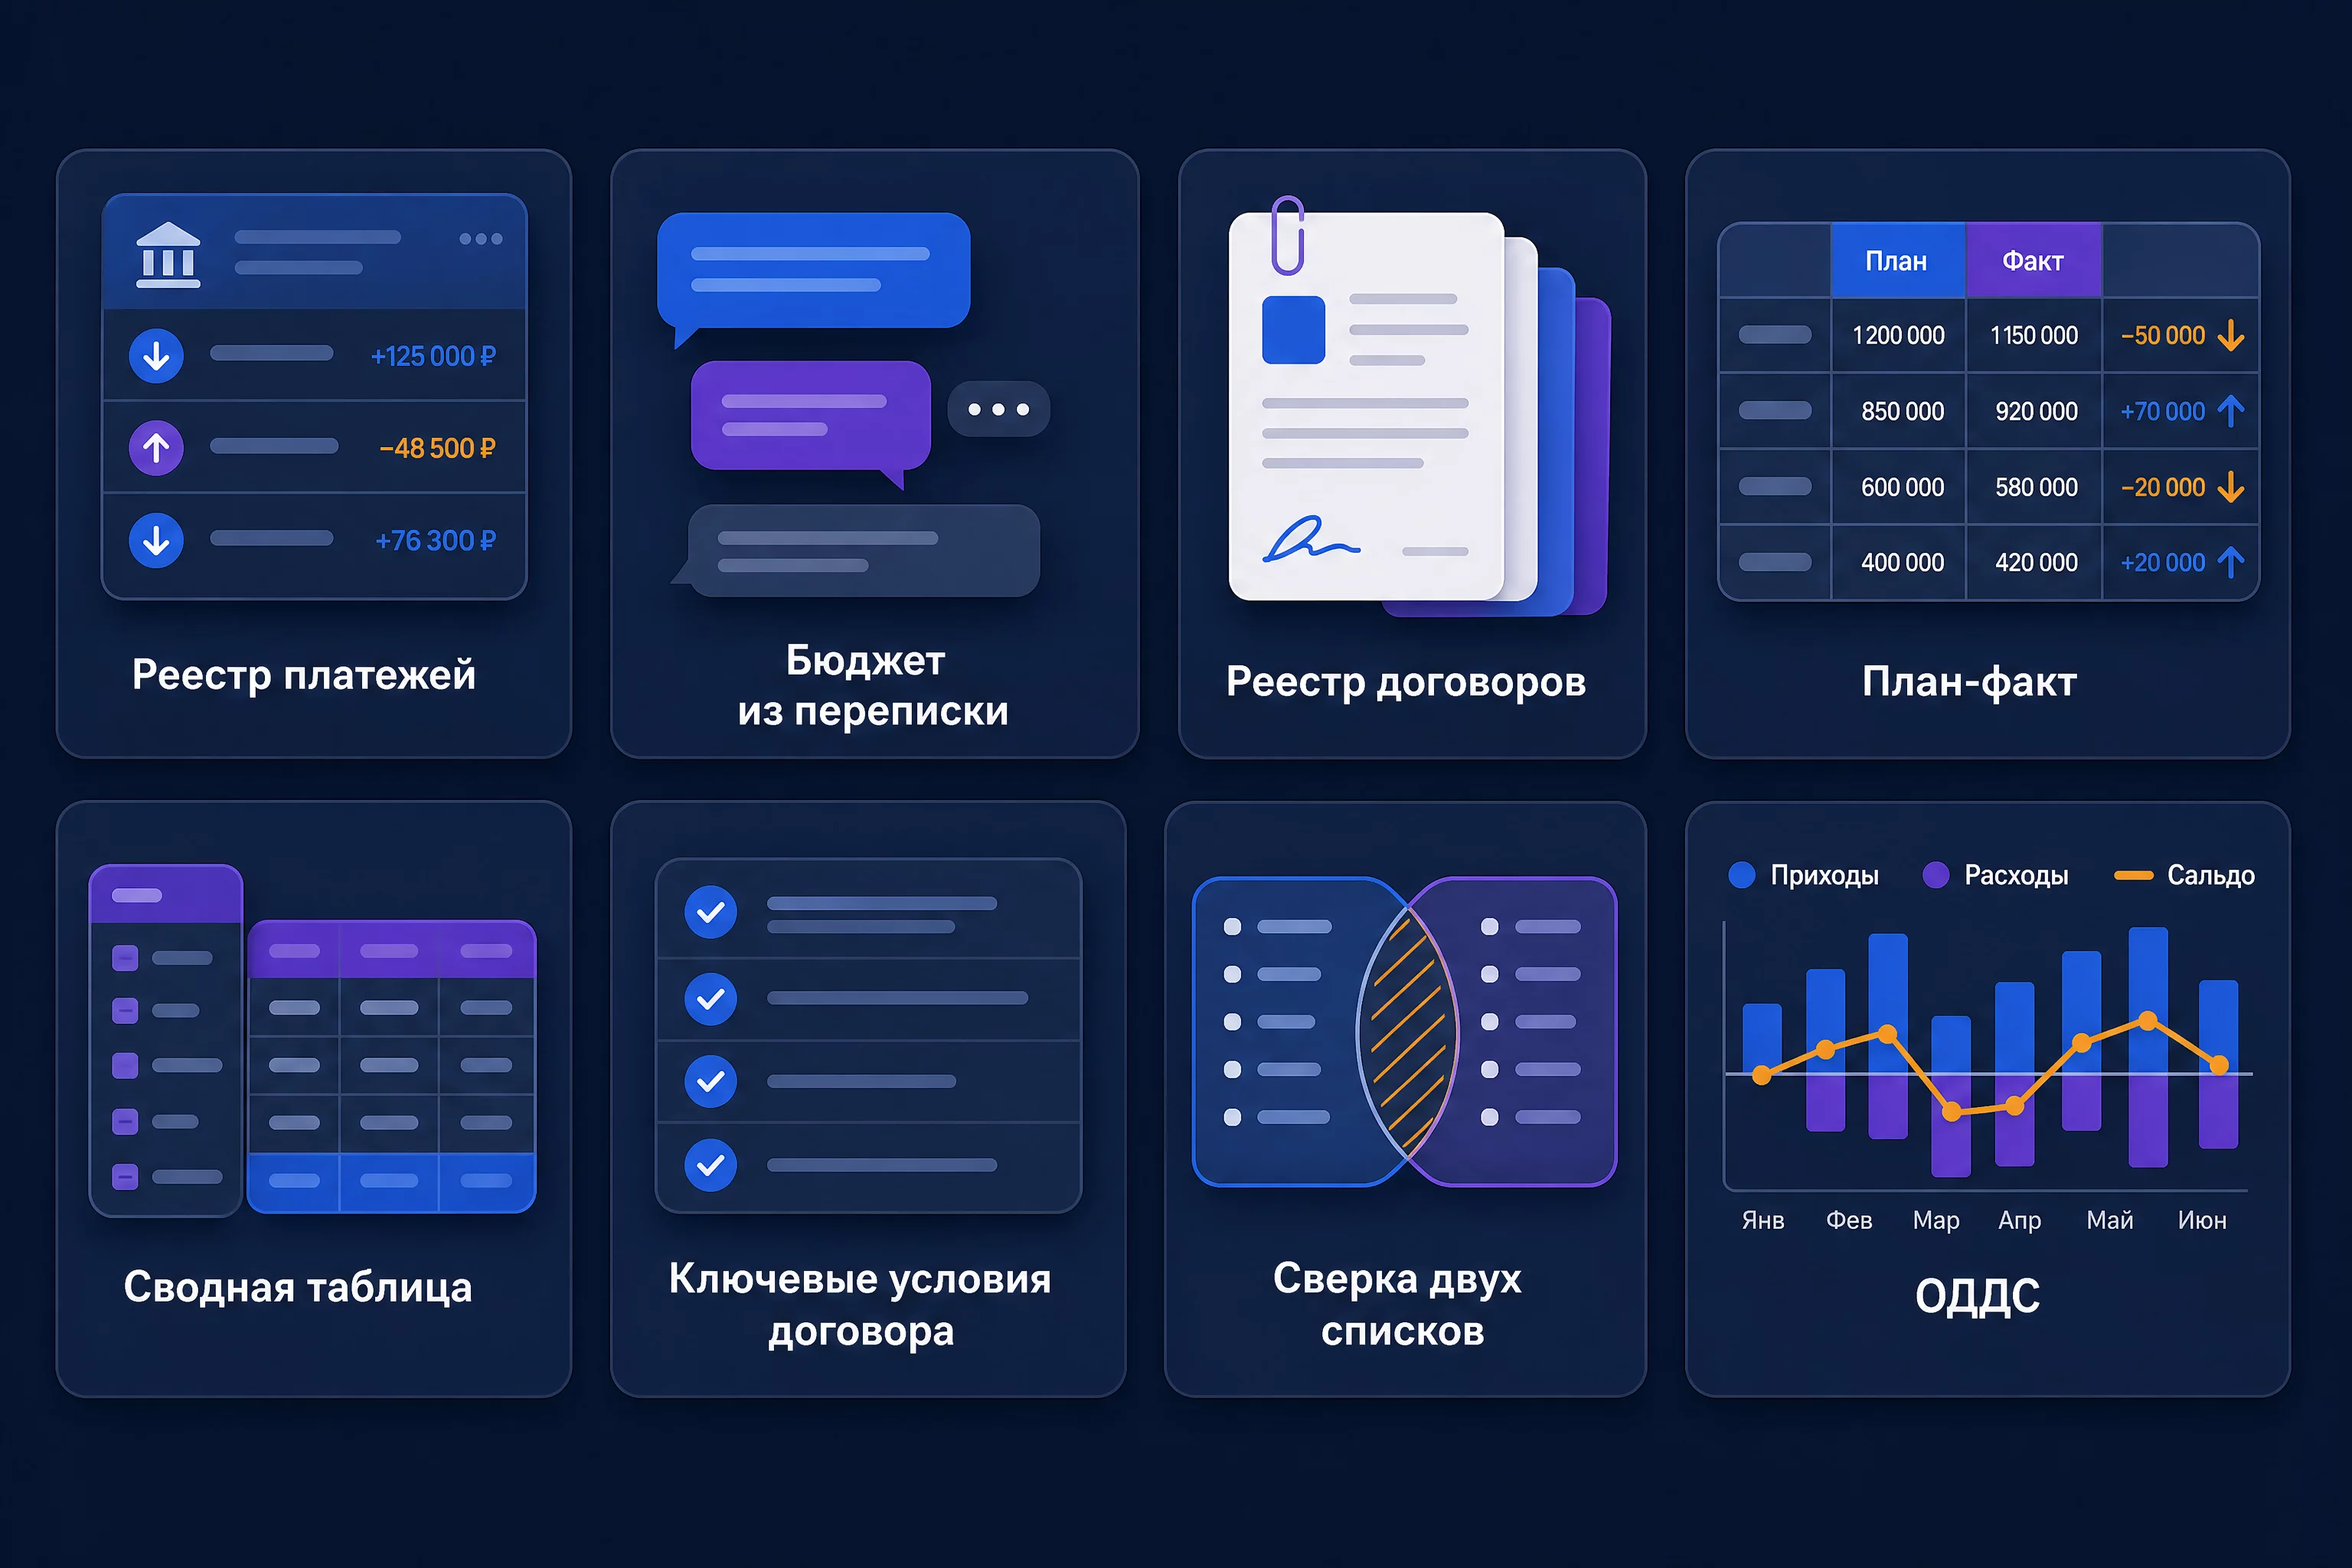
На практике чаше всего просят собрать восемь типов таблиц. Перечисляю с типовым исходником, чтобы вы узнали свою задачу:
- Реестр платежей из банковской выписки, где назначения перемешаны с примечаниями бухгалтера. Модель разносит строки по колонкам и расставляет категории. Сверку выписки с учётной системой я разбирала отдельно в статье банковская сверка через ChatGPT.
- Бюджет из переписки в мессенджере или на почте, когда руководители отделов присылают планы расходов в свободной форме. Модель собирает всё в единую таблицу по статьям. Про автоматизацию бюджетирования целиком я рассказываю в статье AI-бюджетирование для CFO.
- Реестр договоров из стопки сканов или PDF. Модель распознаёт номер, дату, контрагента, предмет, сумму и срок действия по каждому документу. Глубокий разбор договоров на 200 тысяч токенов у Claude описан в статье анализ договора в Claude 200K.
- План-факт из текстового отчёта о выполнении бюджета. Модель раскладывает план и факт по статьям и считает отклонения в рублях и процентах.
- Сводная таблица по категориям из длинного списка назначений. Модель группирует расходы по ключевым словам, как сводная таблица в Excel, только без ручной настройки.
- Таблица ключевых условий из договора. Модель вытаскивает стороны, цену, сроки, штрафы и порядок расторжения с номерами пунктов.
- Сверка двух списков: счета на оплату и фактические платежи. Модель находит расхождения и собирает единую таблицу со статусами.
- Отчёт о движении денег из текстового описания операций. Модель раскладывает поступления и списания по статьям ОДДС.
Любую из этих задач можно закрыть одной из четырёх моделей, о которых ниже. Разница только в том, какая справится точнее и быстрее на вашем типе исходника.
Ещё один важный термин: контекстное окно. Это объём информации, который модель держит в памяти при ответе. У Claude Sonnet 4.6 контекст до 200 тысяч токенов, это примерно 300-400 страниц текста, поэтому она тянет длинные договоры целиком. Gemini 2.5 в старших версиях заявляет до миллиона токенов. Чем больше контекст, тем более длинный текст можно превратить в таблицу за один проход.
Галлюцинация это ещё один термин, который стоит держать в голове. Модель может уверенно вписать в таблицу цифру, которой нет в исходном тексте, просто потому что она правдоподобна. В финансах это опасно, поэтому в каждом промпте для таблиц я добавляю правило «если данных нет, напиши нет данных, не додумывай». Проверка цифр по источнику остаётся за человеком в любом случае.
Что умеет ChatGPT (GPT-5.5) для таблиц из текста?
ChatGPT на модели GPT-5.5 это самый сильный вариант, когда текст нужно не просто разложить по колонкам, а ещё посчитать. Главная фишка для финансиста это код-интерпретатор: модель пишет код на Python и запускает его на своей стороне. Вместо оценки на глаз она реально пересчитывает суммы, удаляет дубли, приводит даты к одному формату и строит сводки.
Что у ChatGPT получается лучше всего для таблиц из текста:
- Сборка таблицы из выписки или реестра с пересчётом итогов кодом, а не на глаз.
- Очистка «грязного» текста: дубли, лишние символы, даты в разном формате, пробелы в суммах.
- Категоризация назначений платежей по ключевым словам с проверкой результата.
- Построение сводок и графиков по только что собранной таблице.
- Поиск аномалий в готовом массиве, про это есть отдельная статья AI против мошенничества в отчётности.
Длинные документы ChatGPT тоже тянет: контекстное окно GPT-5.5 достигает миллиона токенов, поэтому договор или выписка загружаются целиком. При разборе объёмного документа всё равно сверяйте условия из середины, у любой модели есть предел внимания, а для максимально длинных массивов по-прежнему удобен Claude.
Отдельно про память. В 2026 году ChatGPT заметно прокачали память: модель запоминает ваши предпочтения по формату таблиц и переиспользует их в следующих запросах. Если вы один раз объяснили, что суммы нужны в рублях с разделителем тысяч и итоговой строкой внизу, следующие таблицы она собирает в этом же стиле. Управлять этим можно: у обновлённой модели появилась отдельная страница памяти, где видно, что именно она о вас запомнила, что-то можно поправить, что-то удалить. Польза для таблиц прямая: если вы собираете реестр платежей каждую неделю, задайте формат один раз и дальше просто меняйте данные в сообщении, модель повторит структуру прошлых таблиц. Это экономит время на написании промпта, но добавляет и риск: если вы случайно попросили не ту колонку, модель может повторить ошибку прошлого раза. Поэтому раз в месяц я советую открывать страницу памяти и чистить ненужные воспоминания, а итоги всё равно проверять по источнику.
Что ещё умеет ChatGPT, о чём часто забывают: он принимает файлы напрямую. Можно загрузить не просто текст, а PDF-выписку, Excel-файл или текстовый лог и попросить собрать таблицу прямо из файла. Модель прочитает документ и структурирует его содержимое. Это удобно, когда текст слишком большой, чтобы вставлять его в чат руками. Для работы с файлами стабильнее работает платная версия. Бесплатной хватает на базовые таблицы из текста, а для регулярной работы с файлами и код-интерпретатором нужна подписка.
Что умеет DeepSeek V3.2: бесплатные таблицы без VPN?
DeepSeek V3.2 это китайская модель, которая в 2026 году стала популярной по одной причине: она бесплатна и работает без VPN. Для российского рынка это весомо, потому что остальные три сервиса требуют средств доступа.
Для таблиц из текста DeepSeek закрывает простые сценарии: вы вставляете текст, перечисляете колонки, получаете таблицу в markdown и переносите её в Excel. На простых и средних задачах качество сопоставимо с остальными моделями, разница почти не видна.
Что на DeepSeek можно делать:
- Сборка таблицы из списка назначений платежей, переписки, текстового отчёта.
- Категоризация строк по ключевым словам.
- Черновики таблиц для обучения: вы учитесь составлять промпты, не тратя на подписку ни рубля.
- Тестовые прогоны перед тем, как решить, нужна ли платная модель.
Честно про ограничения. Данные уходят на серверы в Китае, поэтому загружать в DeepSeek можно только обезличенную информацию: без названий контрагентов, ИНН, номеров договоров и банковских реквизитов. С первичными документами компании эта модель не работает. Второе ограничение это отсутствие полноценного код-интерпретатора в обычном чате, поэтому сложные расчёты по собранной таблице ей доверять не стоит.
Мой совет простой: DeepSeek это бесплатная точка входа для таблиц из текста. Как только появляются реальные данные компании или нужны точные пересчёты, переходите на одну из трёх других моделей.
Что умеет Gemini 2.5: сканы и фото превращаются в таблицы?
Gemini 2.5 это мультимодальная модель от Google, и её суперсила в том, что она понимает не только текст, но и картинки, сканы, фото и графики. Для таблиц из текста это значит практичную вещь: вы можете сфотографировать счёт, акт или рукописную пометку и попросить Gemini собрать из них таблицу с датами, суммами и назначениями.
Практические сценарии для финансиста:
- Реестр счетов из фото и сканов, которые присылают поставщики и прорабы.
- Таблица из PDF-отчётов банков и контрагентов, включая сканы плохого качества.
- Разбор диаграмм и графиков из презентаций в цифры и таблицу.
- Работа внутри экосистемы Google: Gemini умеет собирать данные прямо в Google Таблицах, без переключения между окнами.
По опыту учениц школы, распознавание 40-50 платёжек и сбор их в таблицу занимает 10-15 минут вместо вечера ручного ввода. Точность высокая, но каждую сумму я рекомендую проверять, потому что на плохих фото модель иногда путает цифры.
Ещё у Gemini большой контекст в старших версиях и одна из самых щедрых бесплатных версий среди четвёрки. Для старта без вложений это хороший вариант. Слабое место это длинные сложные тексты: договоры она разбирает хуже Claude, а оформление ответов иногда перегружено лишними элементами.
Практический совет про сканы: качество распознавания напрямую зависит от качества фото. Ровный свет, документ без сгибов, камера строго сверху заметно повышают точность распознавания. Фото под углом, с бликами и тенью от рук дают ошибки в цифрах, и их приходится ловить при проверке. Если сканов много, потратьте пять минут на настройку съёмки, это сэкономит час на сверке.
Ещё одна фишка Gemini, которую используют реже: модель понимает графики и диаграммы. Если у вас есть презентация с графиком динамики выручки и вам нужно вытащить из него цифры в таблицу, Gemini справится. Это закрывает задачи, где данные существуют только в визуальной форме и их невозможно скопировать текстом.
Что умеет Claude Sonnet 4.6: большие документы в аккуратные таблицы?
Claude Sonnet 4.6 это модель, которую я ставлю выше всех для работы с длинными документами. Её главный козырь это контекстное окно до 200 тысяч токенов в стандартной подписке. Это значит, что договор на 150-200 страниц, стопка накладных или годовая выписка загружаются целиком, и модель держит их в памяти от начала до конца.
Для таблиц из текста это даёт конкретные сценарии:
- Таблица ключевых условий из договора на 50-100 страниц: стороны, цена, оплата, штрафы, расторжение, индексация. Каждое значение подтверждается номером пункта.
- Сводная таблица по нескольким договорам сразу: ставки, сроки, объёмы, пороги по всей базе документов.
- Таблица из учётной политики или регламента: модель находит противоречия и пропущенные разделы.
- Аккуратный текст: если таблицу нужно сопроводить пояснительной запиской, Claude пишет её чище всех, без канцелярита.
Слабое место Claude это расчёты на глаз. Если попросить её посчитать что-то без код-инструментов, она может ошибиться в арифметике, как и любая текстовая модель. Поэтому для чистой сборки таблицы из текста она отлична, а для пересчёта собранных цифр я всё равно советую ChatGPT с код-интерпретатором.
Ещё про контекст: фраза «до 200 тысяч токенов» звучит абстрактно, пока не переведёшь её в работу. Годовая выписка по счёту среднего предприятия — это десятки тысяч строк, и если она укладывается в лимит токенов, модель держит её целиком. Договор на сотню страниц с приложениями, пока он в пределах контекста, обрабатывается за один проход. Для сравнения: чтобы обработать такой объём в моделях с меньшим контекстом, придётся разбивать документ на части и сводить результаты, а это дополнительное время и риск потерять строку на стыке частей.
Кстати, про стыки: это частый источник ошибок при разборе длинных документов. Когда текст режут на куски и собирают таблицу из кусков, строка, которая попала на границу двух частей, может быть утеряна или продублирована. Модель с длинным контекстом этот класс ошибок убирает целиком, потому что видит документ от начала до конца. Если договоры и выписки у вас бывают большими, длинный контекст это не роскошь, а экономия времени на сверке.
Какая нейросеть лучше для таблиц из текста: сравнение моделей?
Сведу главное в одну таблицу. Актуально на август 2026 года, цены и лимиты проверяйте на официальных страницах, они меняются.
| Критерий | ChatGPT (GPT-5.5) | DeepSeek V3.2 | Gemini 2.5 | Claude Sonnet 4.6 |
|---|---|---|---|---|
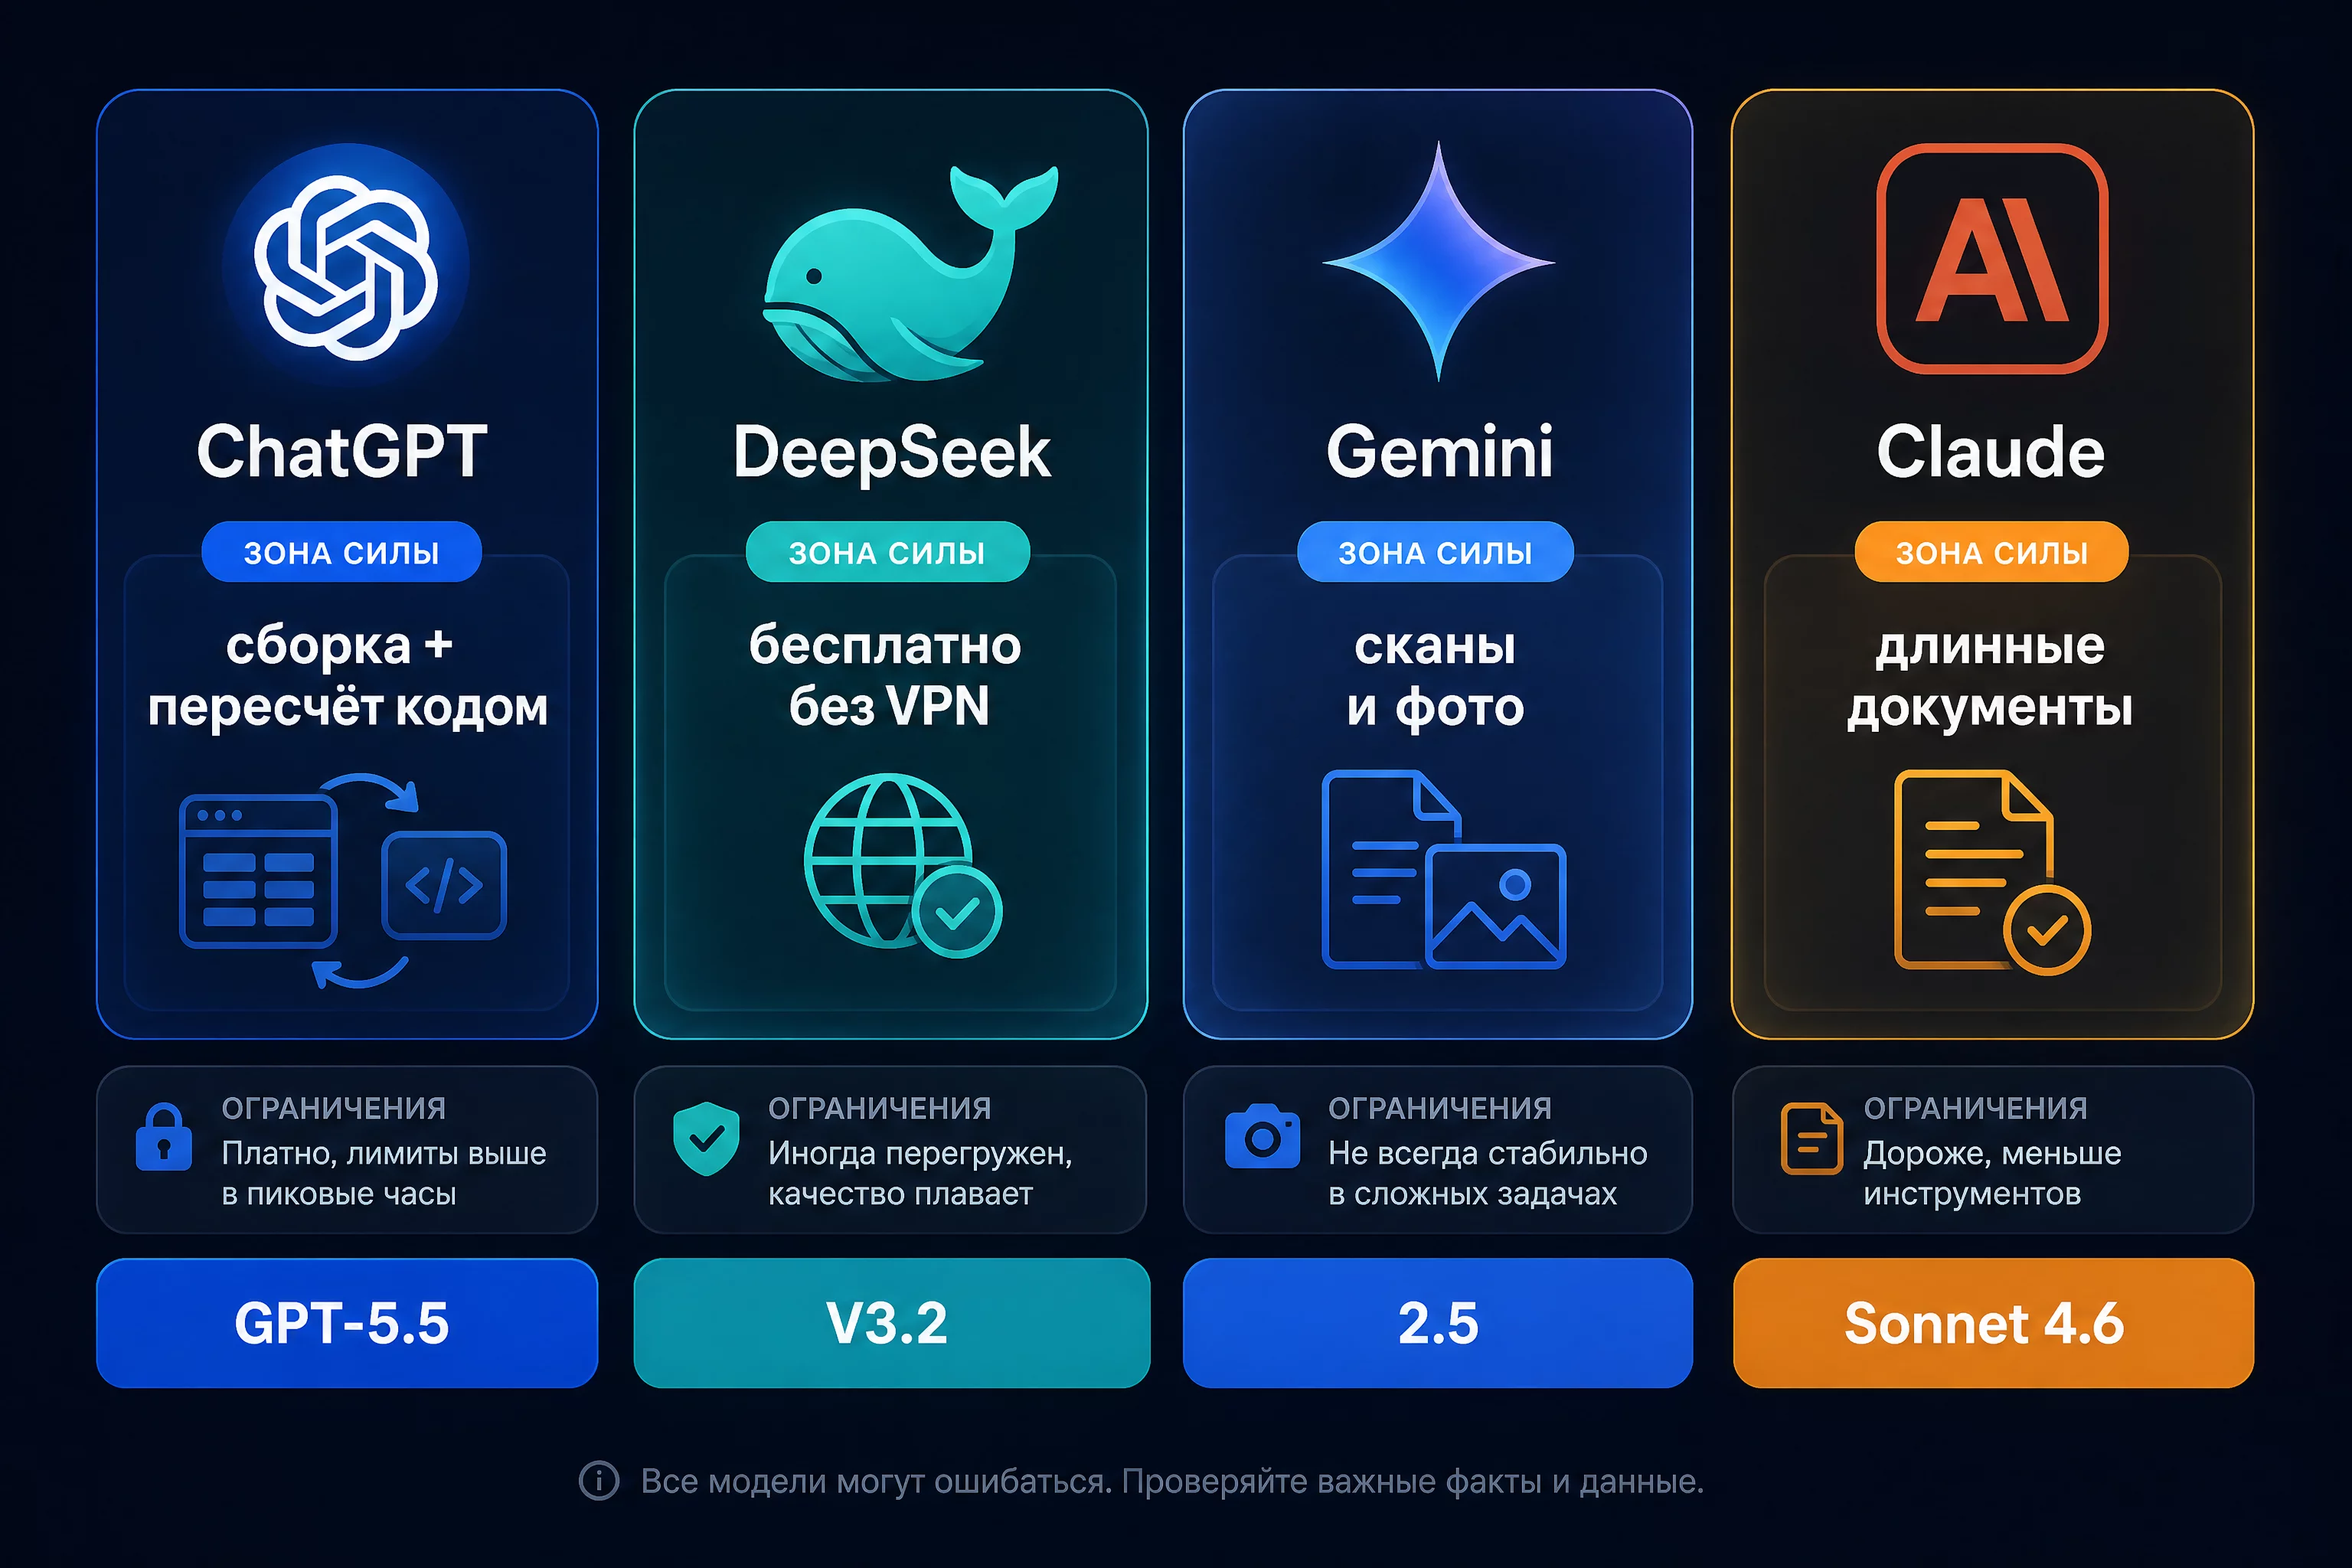
| Главная сила для таблиц | Сборка + пересчёт кодом | Бесплатно, без VPN | Сканы, фото, графики | Длинные документы целиком |
| Контекст | До 1 000 000 токенов | Средний | До 1 000 000 токенов в старших версиях | До 200 000 токенов |
| Код-интерпретатор | Есть, считает точно через Python | Нет в обычном чате | Ограниченно | Ограниченно |
| Договор на 100 страниц в таблицу | Хорошо | Слабо | Хорошо | Отлично |
| Сканы и фото в таблицу | Средне | Слабо | Отлично | Средне |
| Бесплатная версия | Есть с лимитами | Полностью бесплатно | Есть, одна из самых щедрых | Есть с лимитами |
| Работа без VPN в России | Нет | Да | Нет | Нет |
| Безопасность данных | Корпоративные тарифы | Данные уходят в Китай, только обезличенное | Корпоративные тарифы | Корпоративные тарифы |
| Моя оценка для таблиц из текста | 8 из 10 | 7 из 10 | 8 из 10 | 10 из 10 |
Оценки это моё экспертное мнение на основе работы с ученицами школы, не объективная истина. Для ваших задач расклад может отличаться.
Если ваша главная задача это выписка и расчёты по ней, берите ChatGPT. Если много сканов и фото, берите Gemini. Если длинные договоры, берите Claude. Если только стартуете и нет бюджета, начните с DeepSeek на обезличенных данных.
Сколько стоят нейросети для таблиц в 2026 году
Разберу цены отдельно, потому что вопрос «сколько это стоит» всплывает раньше, чем «что это умеет». Актуально на август 2026 года, точные цифры проверяйте на официальных страницах, тарифы меняются.
| Сервис | Бесплатная версия | Платная подписка | Что даёт платная версия для таблиц |
|---|---|---|---|
| ChatGPT (GPT-5.5) | Есть, с лимитами | Порядка 20 долларов в месяц | Код-интерпретатор, файлы, приоритет в пиковые часы |
| Claude Sonnet 4.6 | Есть, с лимитами | Порядка 20 долларов в месяц | Длинный контекст до 200 тысяч токенов, файлы |
| Gemini 2.5 | Есть, одна из самых щедрых | Входит в Google One | Большой контекст, работа в Google Таблицах |
| DeepSeek V3.2 | Полностью бесплатно | Нет | Бесплатный чат с лимитами по объёму |
Бесплатных версий хватает, чтобы собрать десятки таблиц и понять, нужна ли вам автоматизация вообще. Платную подписку подключайте, когда упрётесь в лимит по объёму файла или количеству запросов. Один признак того, что пора платить: вы перестали укладываться в бесплатный лимит и ждёте обнуления счётчика чаще, чем раз в неделю.
Как проверить модели на своих данных за вечер
Вместо того чтобы гадать, какая модель лучше, прогоните одинаковый тест на своих данных. Это займёт вечер и даст ответ, который работает именно для вас.
Первый шаг, подготовьте тестовый файл. Возьмите обезличенную выписку или перечень на 30-50 строк, с типичными для вас формулировками: назначения платежей, сокращения, суммы. Обезличьте, чтобы не светить данные компании.
Второй шаг, соберите один промпт. Возьмите универсальный шаблон из блока промптов ниже и не меняйте его для разных моделей. Смысл теста в том, чтобы сравнить модели на одинаковых условиях, а не в том, чтобы подогнать промпт под каждую.
Третий шаг, прогоните файл через каждую модель. ChatGPT, DeepSeek, Gemini и Claude. Замерьте время ответа, посмотрите, какие колонки собрала каждая, сверьте суммы по случайным строкам.
Четвёртый шаг, сравните по четырём критериям: полнота (все ли строки перенесены), точность цифр (совпадают ли суммы с исходником), аккуратность оформления (удобно ли копировать в Excel) и время ответа. Поставьте каждой модели оценку от 1 до 5 по каждому критерию.
Пятый шаг, выберите модель с наибольшим суммарным баллом под вашу главную задачу. Повторите тест через месяц-два, модели обновляются быстро, и расклад может поменяться.
Такой тест честнее любых рейтингов, потому что он посчитан на ваших формулировках и ваших типах документов. По опыту школы, на простых таблицах разница между моделями почти не видна, а на длинных или «грязных» текстах она становится решающей.
Как превратить текст в таблицу и перенести в Excel?
Сам процесс занимает 15-20 минут, из которых большинство времени уходит на проверку. Алгоритм работает одинаково во всех четырёх моделях, разница только в нюансах доступа.
Шаг первый, определите исходный текст и нужные колонки. Посмотрите, что у вас есть: переписка, выписка, скан, отчёт. Решите, что из этого попадает в таблицу: дата, сумма, категория, контрагент, примечание. Перечень колонок продумываете вы, а не модель, это ключевой момент.
Шаг второй, очистите и обезличьте данные. Уберите дубли и лишние символы, замените названия контрагентов кодами, удалите ИНН и реквизиты. Это защищает компанию и повышает точность разбора: модели проще работать с чистыми данными, чем с мусором.
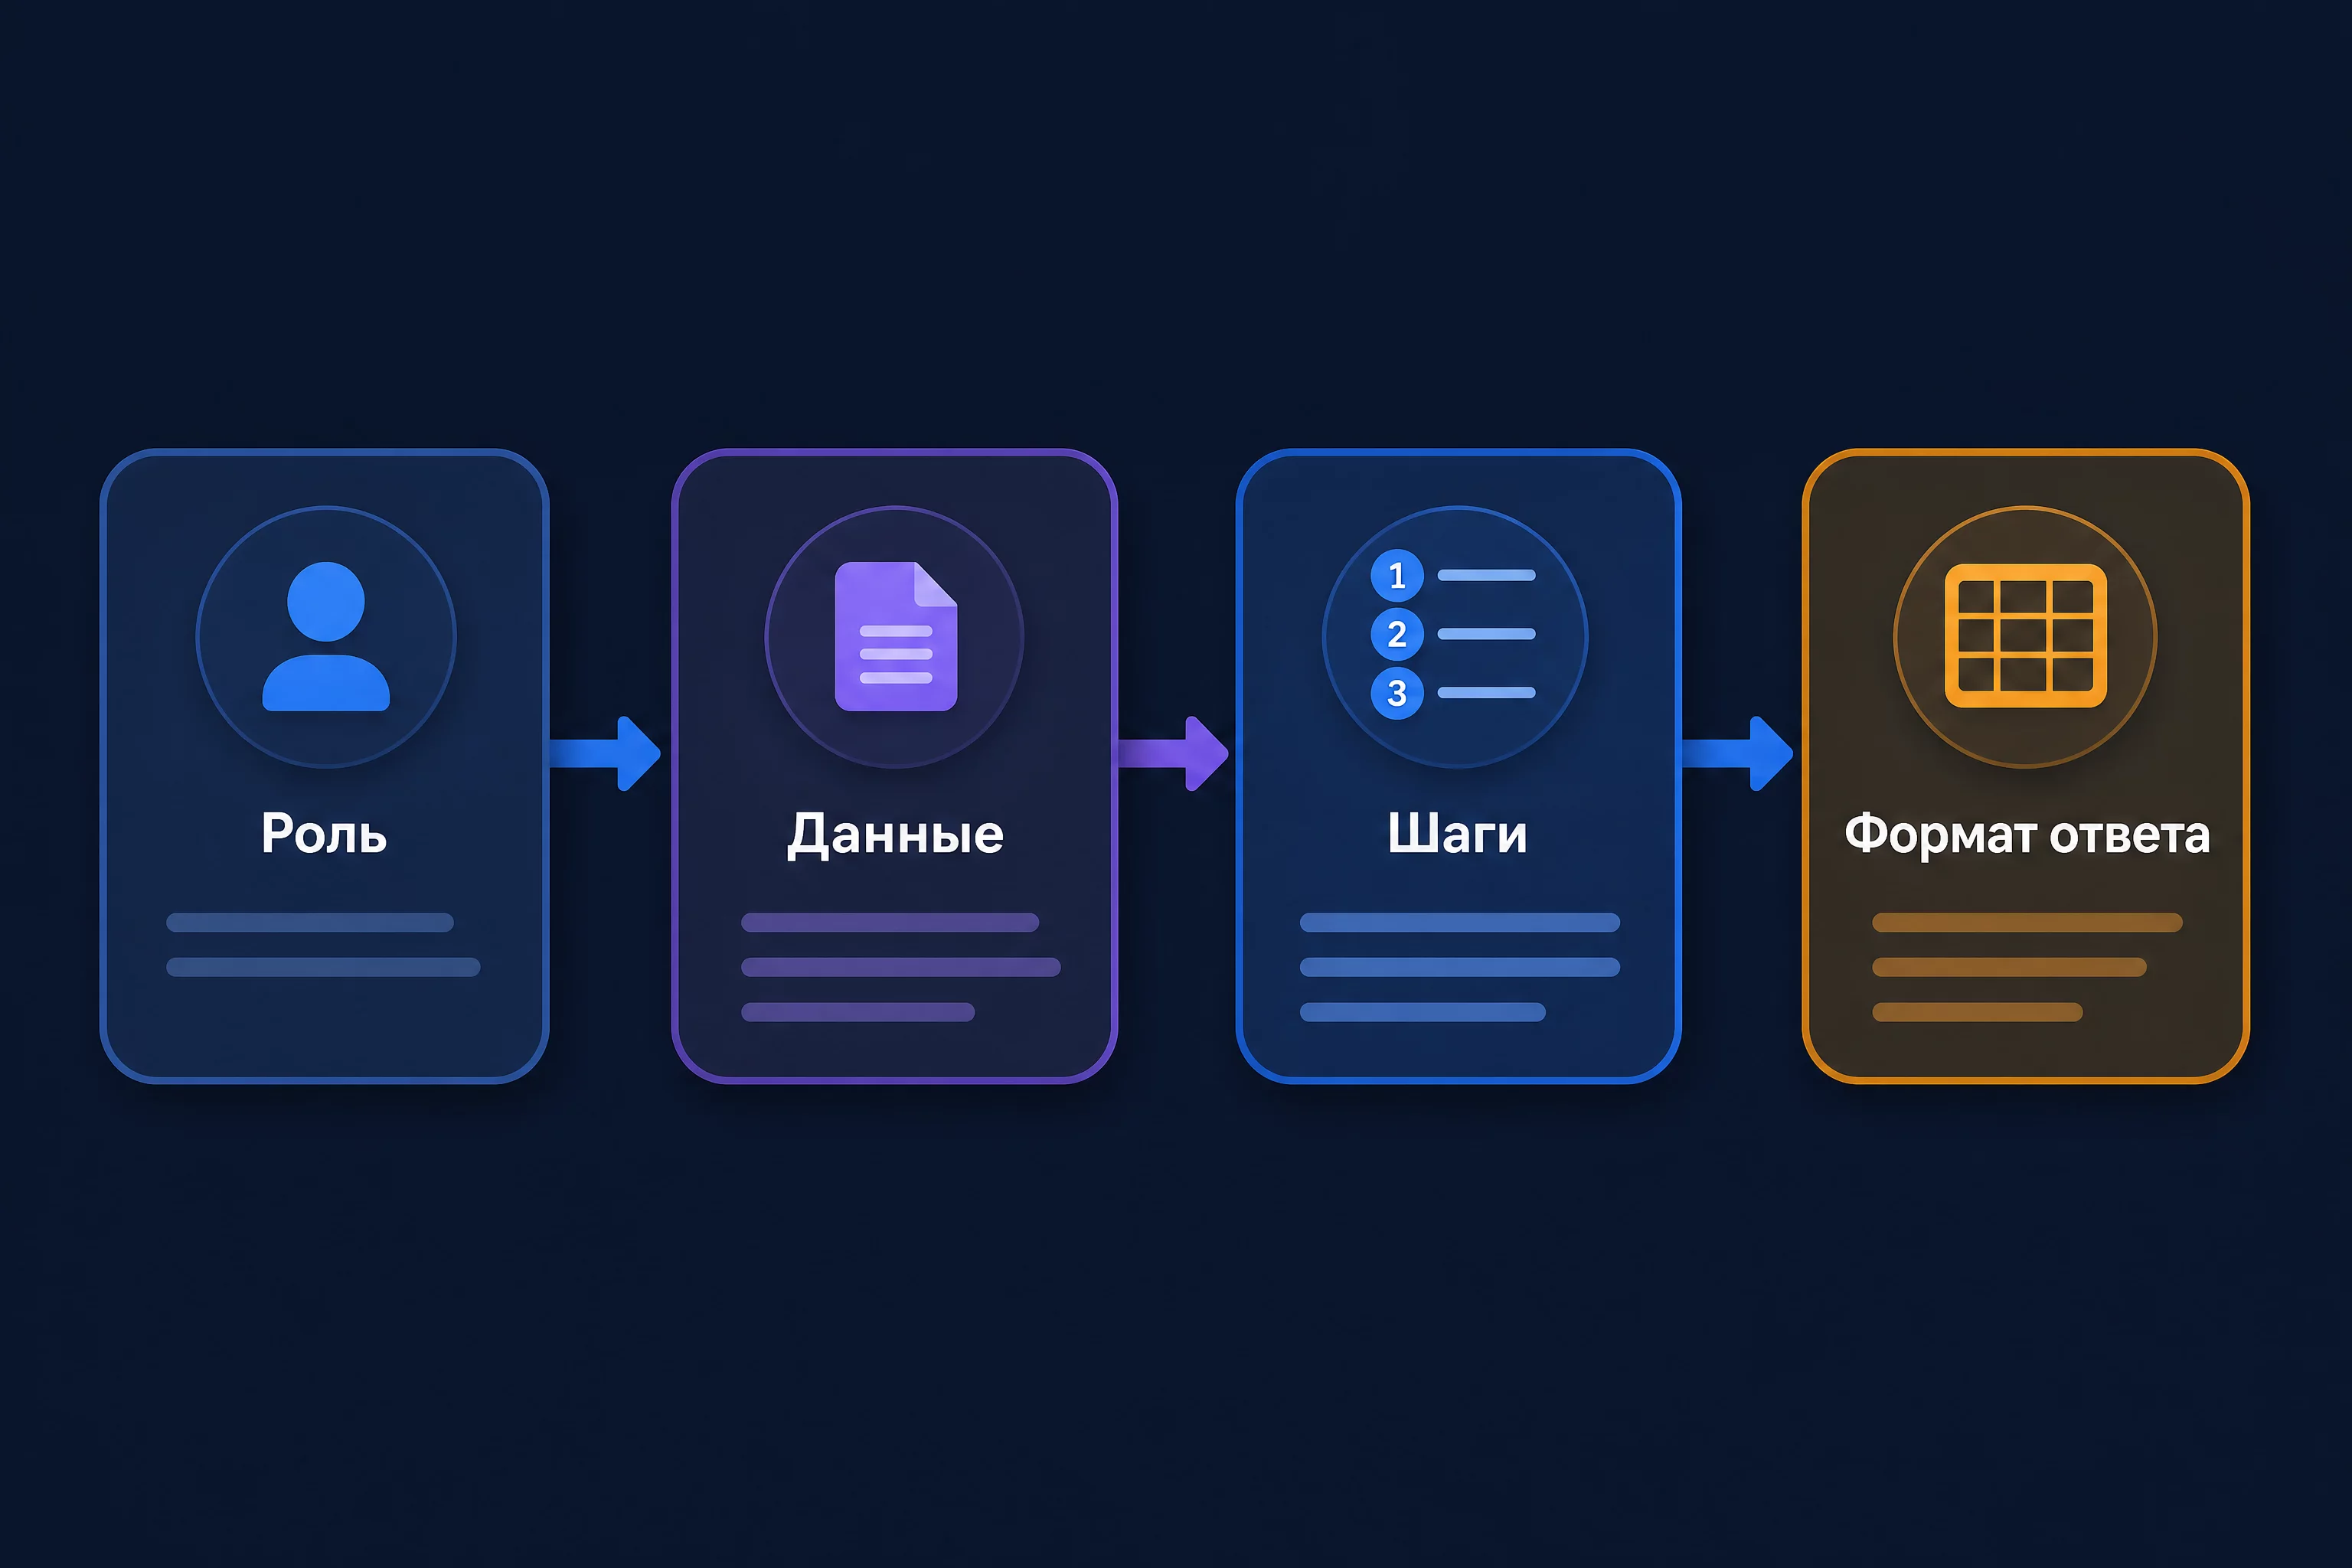
Шаг третий, составьте промпт из четырёх частей. Роль, данные, шаги, формат. Полный разбор схемы я даю ниже в разделе про ошибки, а готовые примеры в блоке промптов.
Шаг четвёртый, загрузите текст и отправьте промпт. Вставьте текст прямо в чат или загрузите файл. Если ответ вышел простынёй вместо таблицы, добавьте в следующем сообщении строку «представь ответ в виде таблицы с колонками дата, категория, сумма».
Шаг пятый, проверьте результат. Сверьте несколько случайных строк с исходником, проверьте итоговую сумму, убедитесь, что модель не додумала цифры. На проверку таблицы из 40-50 строк уходит 10-20 минут, и это обязательная часть.
Шаг шестой, экспортируйте. Скопируйте таблицу в Excel или попросите модель выдать CSV, который загружается напрямую. Рабочий промпт сохраните в отдельный документ, он пригодится для следующего раза.
Как перенести таблицу из нейросети в Excel
Собрать таблицу в чате это половина дела, вторая половина это аккуратно перенести её в Excel, чтобы с ней можно было работать дальше: считать, фильтровать, сводить. Три рабочих способа, выбирайте под свой уровень удобства.
Первый способ, копирование вставкой. Модель отвечает таблицей в markdown, вы копируете её и вставляете в Excel. Excel распознаёт строки и колонки, разделённые вертикальной чертой, и раскладывает по ячейкам. Это самый быстрый путь, он подходит для таблиц до 100-200 строк. Минус в том, что при вставке форматирование чисел иногда сбивается: суммы приходят текстом, и их приходится вручную переводить в числовой формат.
Второй способ, CSV. Попросите модель выдать результат в виде CSV: «представь ответ в формате CSV, разделитель точка с запятой, первая строка это заголовки колонок». Дальше сохраните ответ в текстовый файл с расширением .csv и откройте его в Excel. Способ надёжнее первого, потому что Excel читает CSV как нативный формат и сам раскладывает по колонкам. Для русских сумм и разделителей выбирайте точку с запятой, чтобы не перепутать с десятичной запятой в числах.
Третий способ, копирование в Google Таблицы. Если вы работаете в экосистеме Google, Gemini умеет собирать таблицу прямо внутри Google Таблиц: вы открываете лист, вызываете модель и описываете, что собрать. Таблица появляется сразу на листе, без промежуточного копирования. Для команд, которые живут в Google-инструментах, это самый удобный вариант.
Отдельно про формат чисел. Нейросеть может выдать сумму как «1 250 000 руб» или «1250000.00», и при переносе в Excel это станет текстом. Чтобы суммы легли как числа, добавьте в промпт строку «суммы выводи числами без пробелов и без обозначения валюты, две десятичные цифры после запятой». Тогда Excel распознает числа сразу, и не придётся переводить формат вручную.
Каким бы способом вы ни пользовались, после переноса всегда проверяйте итоговую сумму. Сверьте сумму в Excel с суммой, которую назвала модель в ответе, а потом с исходным текстом. Три источника должны совпасть, только тогда таблицу можно считать собранной.
Наглядный пример. Бухгалтер собрала реестр из нескольких десятков платёжек через ChatGPT, скопировала markdown-таблицу в Excel и увидела, что суммы пришли текстом: ячейки выровнены влево, сортировка по сумме не работает, итог не считается формулой. Решение заняло пять минут. Она попросила модель заново выдать ответ в формате CSV с разделителем точка с запятой и без обозначения валюты, открыла файл в Excel через вкладку «Данные», и все суммы легли числами. Тот же объём ручного переформатирования занял бы полчаса. Правило простое: формат запрашивайте до сборки, а не после.
12 готовых промптов для таблиц из текста
Промпты ниже я использую на курсе и в собственной работе. Каждый можно подставить в любую из четырёх моделей, для отдельных указала, где промпт работает лучше всего.
Промпт 1. Универсальный шаблон: текст в таблицу.
Ты финансовый аналитик. Ниже текст с данными о расходах за месяц.
Преврати его в таблицу с колонками: дата, категория, сумма, комментарий.

Правила:
1. Каждую строку исходного текста перенеси в отдельную строку таблицы.
2. Если в тексте нет значения для колонки, поставь "нет данных".
3. Не выдумывай цифры, которых нет в тексте.
4. В конце добавь строку "Итого" с суммой всех строк.

Текст: [вставить]
Формат ответа: таблица в markdown.
Промпт 2. Бюджет из переписки в мессенджере.
Ниже сообщения из мессенджера, в которых руководители отделов присылают
планы расходов на следующий месяц. Собери из них бюджет в таблицу.
Колонки: отдел, статья расхода, сумма, примечание, кто прислал.
Если в сообщении сумма указана в тысячах, переведи в рубли.
Цифры бери только из сообщений, ничего не додумывай.

Сообщения: [вставить]
Формат: таблица + строка Итого по каждому отделу.
Промпт 3. Реестр платежей из выписки с примечаниями.
Вот выписка по расчётному счёту в виде текста: дата, назначение платежа,
сумма, примечания бухгалтера. Собери реестр платежей в таблицу.
Колонки: дата, назначение, сумма, категория, примечание.
Категории распредели по ключевым словам в назначении: налоги, аренда,
зарплата, поставщики, прочее. Не меняй суммы и даты.

Выписка: [вставить]
Формат: таблица + сводка по категориям с суммами.
Промпт 4. Категоризация расходов из списка назначений.
Вот список из 60 назначений платежей из банковской выписки (обезличен).
Раздели их на категории: закупка сырья, логистика, аренда, зарплата,
налоги, маркетинг, прочее. Для каждой строки укажи категорию и ключевое
слово, по которому ты её определил. Сомнительные строки пометь
"проверить человеку". Данные обезличены, контрагентов нет.

Список: [вставить]
Формат: таблица из трёх колонок: назначение, категория, ключевое слово.
Промпт 5. Таблица ключевых условий из договора.
Лучше всего работает в Claude Sonnet 4.6 из-за длинного контекста.
Я загружаю договор в PDF. Собери из него таблицу ключевых условий.
Колонки: условие, значение, пункт договора, комментарий.
Обязательно вытащи: стороны, предмет, цена, порядок оплаты, срок
действия, порядок расторжения, штрафы и неустойки, индексация.
Каждое значение подтверждай номером пункта из текста. Если условия
в договоре нет, напиши "не указано", не додумывай.
Промпт 6. Распознавание сканов счетов в таблицу.
Лучше всего работает в Gemini 2.5, она сильнее всех в работе со сканами.
Я загружаю фото и сканы счетов от поставщиков. Распознай каждый документ
и собери в таблицу: номер счёта, дата, поставщик, сумма, назначение.
Если сумму распознать не удалось, поставь "требует проверки".
В конце покажи итоговую сумму по всем счетам. Каждую цифру сверяй
с изображением, не дорисовывай.
Промпт 7. Сверка двух текстовых списков в одну таблицу.
Вот два списка: реестр счетов на оплату и реестр фактических платежей.
Оба в виде текста. Собери единую таблицу: номер документа, дата,
сумма, статус (оплачен / не оплачен / оплачен частично).
Найди счета без платежа и платежи без счёта, добавь их отдельными
строками с пометкой. Не меняй суммы.

Список 1: [вставить]
Список 2: [вставить]
Формат: таблица + итоговая сводка по статусам.
Промпт 8. Очистка «грязной» таблицы.
Вот таблица, которую собрали вручную из разных источников. В ней
пропуски, дубли, даты в разном формате, суммы с лишними символами.
Приведи её к нормальному виду:
1. Удали дубли по дате, сумме и назначению.
2. Приведи даты к формату ДД.ММ.ГГГГ.
3. Убери из сумм пробелы и лишние символы, оставь число.
4. Пустые ячейки заполни "нет данных".
Покажи, какие строки ты удалил как дубли, и почему.

Таблица: [вставить]
Формат: очищенная таблица + список удалённых дублей.
Промпт 9. Расчёт итогов по собранной таблице.
Лучше всего работает в ChatGPT с код-интерпретатором, модель пересчитает кодом, а не на глаз.
Я загружаю таблицу расходов в формате CSV (колонки: дата, категория,
сумма). Напиши код на Python и посчитай:
1. Итоговую сумму по каждой категории.
2. Долю каждой категории от общего объёма в процентах.
3. Динамику по месяцам: сумму и % изменения к предыдущему месяцу.
4. Топ-5 самых крупных расходов.
Каждую цифру пересчитывай кодом, не на глаз. Выдай таблицу с итогами
и короткие выводы по каждой категории.
Промпт 10. План-факт из текстового отчёта в таблицу.
Ниже текстовый отчёт о выполнении бюджета за квартал. Преврати его
в таблицу план-факт: статья, план, факт, отклонение в рублях,
отклонение в процентах. Для статей с отклонением больше 10% добавь
колонку "вероятная причина" (сезонность, задержка, изменение цены),
но не выдумывай факты о компании, только общие объяснимые причины.

Текст: [вставить]
Формат: таблица + вывод по трём главным отклонениям.
Промпт 11. Разбить один столбец на несколько.
Вот список записей в колонке "Контрагент и договор" вида:
"ООО Ромашка, договор №45 от 12.03.2026". Разбей каждую строку
на отдельные колонки: название контрагента, номер договора, дата
договора. Если в строке нет какого-то элемента, поставь "нет данных".

Исходный список: [вставить]
Формат: таблица с колонками: исходная строка, контрагент, номер
договора, дата договора.
Промпт 12. Few-shot: собираем таблицу по примерам строк.
Лучший способ объяснить модели формат, когда в тексте попадаются редкие случаи: сокращения, пометки, частичные данные. Три примера в промпте работают точнее, чем описание словами.
Ниже список начислений с примечаниями. Собери его в таблицу
с колонками: сотрудник, начислено, налог, к выплате.

Формат по образцу:
Строка из исходника: "Иванов - 120000, удержан НДФЛ 15600"
Строка в таблице: Иванов | 120000 | 15600 | 104400
Строка из исходника: "Петрова - 85000, без удержаний"
Строка в таблице: Петрова | 85000 | нет данных | 85000

Разбери остальные строки точно в таком же формате.
Не выдумывай удержания, которых нет в тексте.
Если налог не указан, ставь "нет данных".

Список: [вставить]
Формат: таблица в markdown.
Как пользоваться промптами: берите одну задачу, один промпт, одинаковые данные и прогоняйте через две-три модели. Сравнивайте полноту, точность цифр и удобство оформления. Так выбор инструмента превращается из гадания в измерение.
В каком формате просить ответ
От формата ответа зависит, сколько времени вы потратите на перенос таблицы в Excel. Здесь три варианта, и у каждого своя роль.
Markdown-таблица это ответ по умолчанию: строки и колонки, разделённые вертикальной чертой. Удобно читать прямо в чате, но при вставке в Excel суммы часто приходят текстом, и формат приходится поправлять вручную.
CSV это формат для прямого импорта. Одна строка ответа это одна строка таблицы, значения разделены точкой с запятой. Такой ответ сохраняется в файл и открывается в Excel без потери формата чисел. Для таблиц от 50 строк я советую просить именно CSV.
JSON это формат для автоматизации. Если таблица уходит в другую программу, скрипт или агента, просите ответ в JSON: модель выдаёт строгую структуру, которую легко обработать машинно. Для разовых ручных таблиц JSON избыточен, для связок с автоматизацией он незаменим.
Что указывать в промпте: формат ответа, разделитель для CSV, обработку сумм (числом без валюты), заголовки колонок в первой строке. Один раз описали эти четыре пункта, сохранили промпт, дальше подставляете только данные.
Как подготовить данные, чтобы таблица вышла точной?
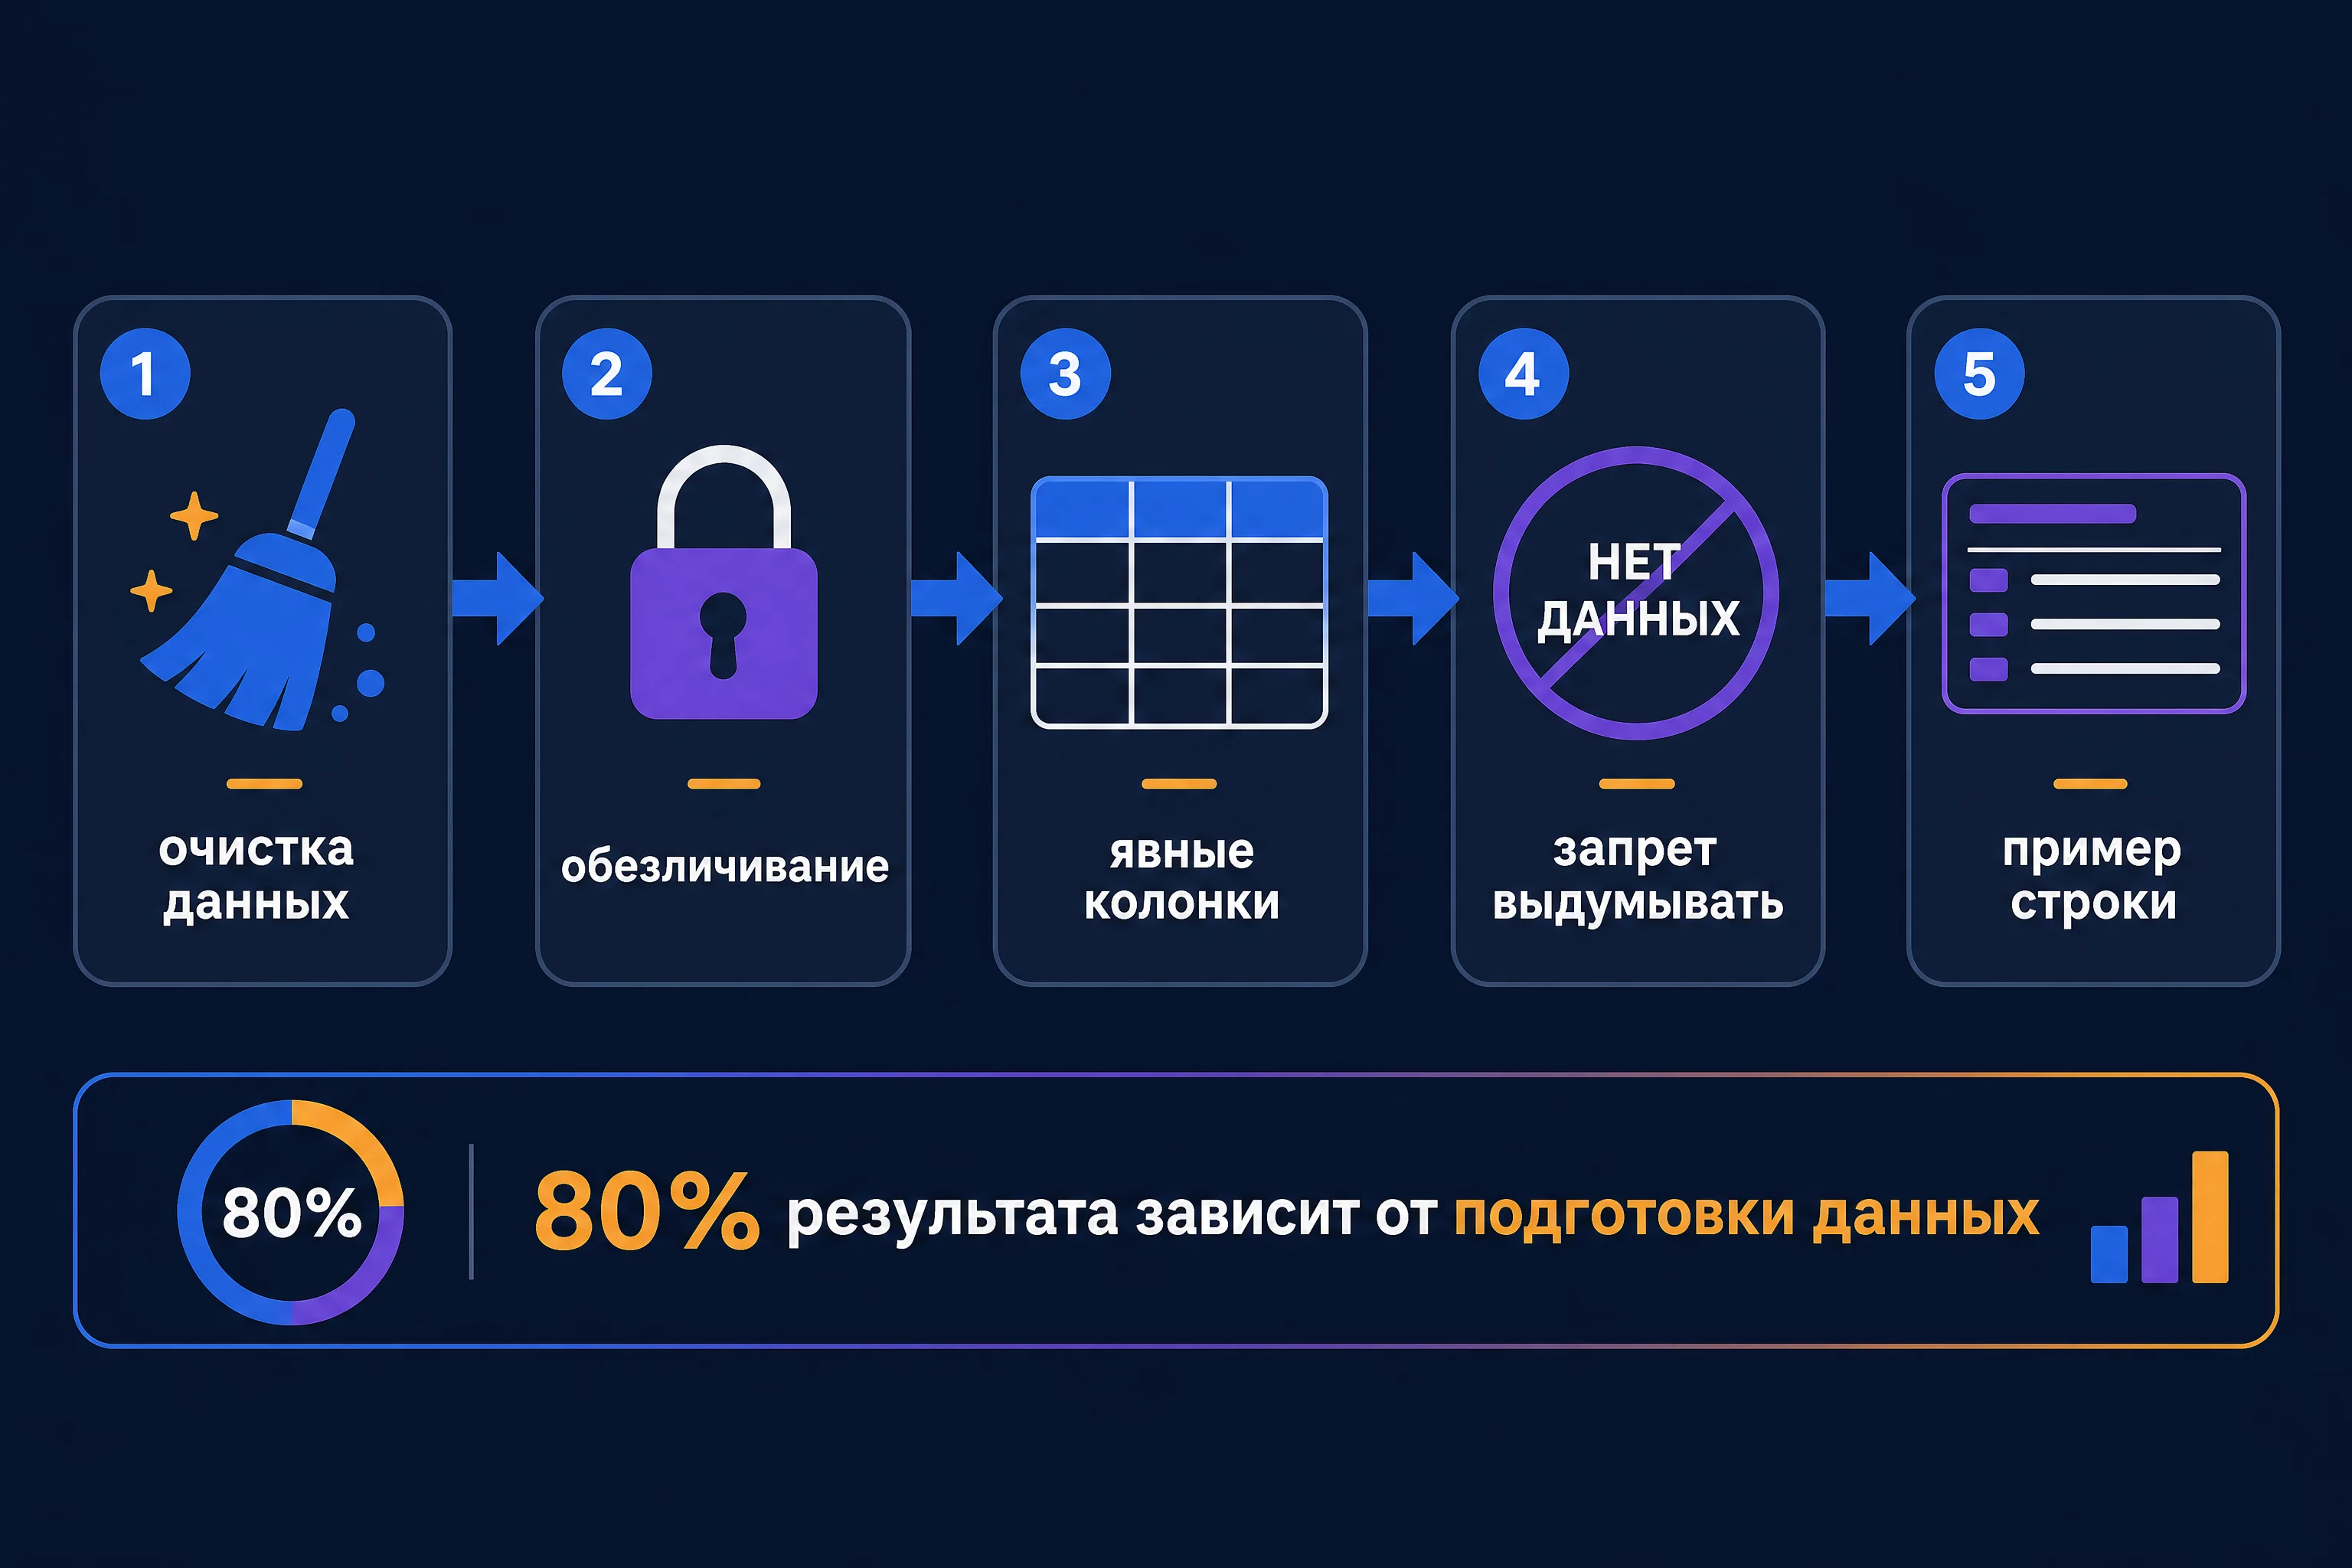
Качество таблицы из текста на 80% определяется подготовкой данных, а не силой модели. Пять правил, которые я проверяю перед каждым прогоном.
Первое, уберите лишнее. Из текста для таблицы выкиньте приветствия, подписи, рекламные блоки и всё, что не относится к данным. Модель тратит внимание на каждую строку, и мусор снижает точность разбора.
Второе, обезличьте. Замените названия контрагентов кодами: Контрагент 1, Поставщик А, Клиент Б. Уберите ИНН, номера договоров, банковские реквизиты и личные данные. Подробный гайд я писала в статье обезличивание данных перед загрузкой в ChatGPT. Суммы и даты сами по себе допустимо показывать, а вот связка «кто платит кому и сколько» это уже чувствительная информация.
Третье, приведите текст к единому виду. Если даты в одном месте записаны как 12.03.2026, а в другом как «12 марта», модель справится, но с меньшей точностью. Если суммы вперемешку с пробелами и без них, лучше навести порядок до загрузки.
Четвёртое, задайте колонки явно. Не пишите «сделай таблицу», перечислите колонки: дата, категория, сумма, комментарий. Модель не угадывает ваши ожидания, она следует инструкции. Чем точнее инструкция, тем точнее результат.
Пятое, добавьте правило про выдумывание. Строка «если данных нет, напиши нет данных, не додумывай» режет галлюцинации в таблицах лучше всего. Без неё модель может дозаполнить пробел правдоподобной цифрой, и вы её заметите только при сверке.
Шестое, дайте пример строки. Если таблица сложная, покажите модели одну-две строки того, что вы хотите получить. Три строки-примера в промпте повышают точность заметнее, чем десять дополнительных слов с описанием. Это называется few-shot, и работает это одинаково во всех моделях. Пример такого промпта я даю в блоке ниже.
Седьмое, разбивайте длинный текст на части. Если исходник больше 100-150 строк или страниц на 30 и больше, не просите собрать всё в один проход. Разбейте на куски по 20-30 строк, соберите каждый в таблицу, потом сведите части в Excel. Модель меньше ошибается на коротких порциях и проще проверяется.
Безопасность: какие данные можно загружать, а какие нет
Вопрос безопасности всплывает каждый раз, когда речь заходит о финансовых таблицах. Правило простое: в облачную нейросеть уходит только то, что обезличено до неузнаваемости.
Что можно загружать смело. Обезличенные перечни: суммы без названий контрагентов, категории без деталей, даты без номеров документов. Идеальный формат это таблица вида «дата, категория, сумма», где вместо ООО «Ромашка» стоит «Контрагент 1». По такой заготовке модель отлично собирает реестры, категоризирует расходы и считает сводки, а риск для компании нулевой.
Что загружать нельзя. Связку «кто платит кому и сколько»: названия контрагентов вместе с суммами, ИНН, банковские реквизиты, номера договоров, паспортные данные, зарплаты с фамилиями. Это коммерческая и персональная информация, и утекать ей в облако не стоит. Отдельно про обезличивание у меня есть подробный гайд со встроенным промптом-«анонимайзером», который сам заменяет чувствительные поля, ссылку дала выше.
Как быть с особо чувствительными данными. Для зарплатных ведомостей, налоговой отчётности и персональных данных есть два пути. Первый: корпоративный тариф сервиса, где провайдер гарантирует, что данные не используются для обучения и не попадают в общий доступ. Второй: локальная модель, которая запускается на вашем компьютере и не отправляет данные в интернет вообще. Оба варианта дороже и сложнее бесплатного чата, но для чувствительных массивов они единственные оправданные.
Важно понимать: обезличивание это не только защита, но и точность. Модель, которая не видит реальных названий и реквизитов, не может их перепутать и не отвлекается на них. В моей практике обезличенные данные разбираются точнее, потому что модель не тратит внимание на узнаваемые имена и цифры, а сосредотачивается на структуре.
Почему модели ошибаются в цифрах: что происходит под капотом
Понимание механики помогает не злиться на модель, когда она ошибается, а чинить промпт. Нейросеть не «думает» в человеческом смысле, она предсказывает следующее слово по вероятности, опираясь на всё, что видела при обучении и в вашем запросе. Таблица для неё это не структура данных, а текст с колонками и разделителями, который она собрала по вашему образцу.
Отсюда вытекают три закономерности, которые важно держать в голове при работе с таблицами из текста.
Первое: модель не считывает цифры как калькулятор. Когда вы просите «пересчитай итог», она оценивает ответ по правдоподобию, а не по арифметике. Поэтому любые расчёты по собранной таблице я перевожу на код-интерпретатор там, где он есть, или проверяю формулой в Excel. Для черновой сборки таблицы это неважно, для итогов критично.
Второе: модель видит ровно то, что вы ей дали. Если в тексте сумма записана как «12 500» без указания валюты, а контрагент назван только фамилией, модель может достроить недостающее по своему усмотрению, если вы не запретили. Правило «если данных нет, напиши нет данных» работает именно потому, что оно закрывает этот пробел инструкцией.
Третье: чем больше мусора в тексте, тем ниже точность. Каждая лишняя строка из приветствий, подписей и рекламы занимает внимание модели и увеличивает шанс, что она перепутает соседние значения. Поэтому чистка входа это не прихоть, а прямое влияние на качество выхода.
Эта же механика объясняет, почему таблица с первого раза выходит редко, а после одного-двух уточняющих сообщений почти всегда. Модель не «поняла лучше» после уточнения, она получила более полную инструкцию. Чем меньше додумывать приходится ей, тем точнее результат, и на этом построены все промпты в этой статье.
Три кейса: часы, рубли и проценты из практики школы
Цифры из практики учениц школы, с их разрешения и без точных привязок к компаниям. В каждом случае указываю диапазон, потому что результат зависит от качества исходных данных.
Кейс 1. Бюджет из переписки в мессенджере, ChatGPT.
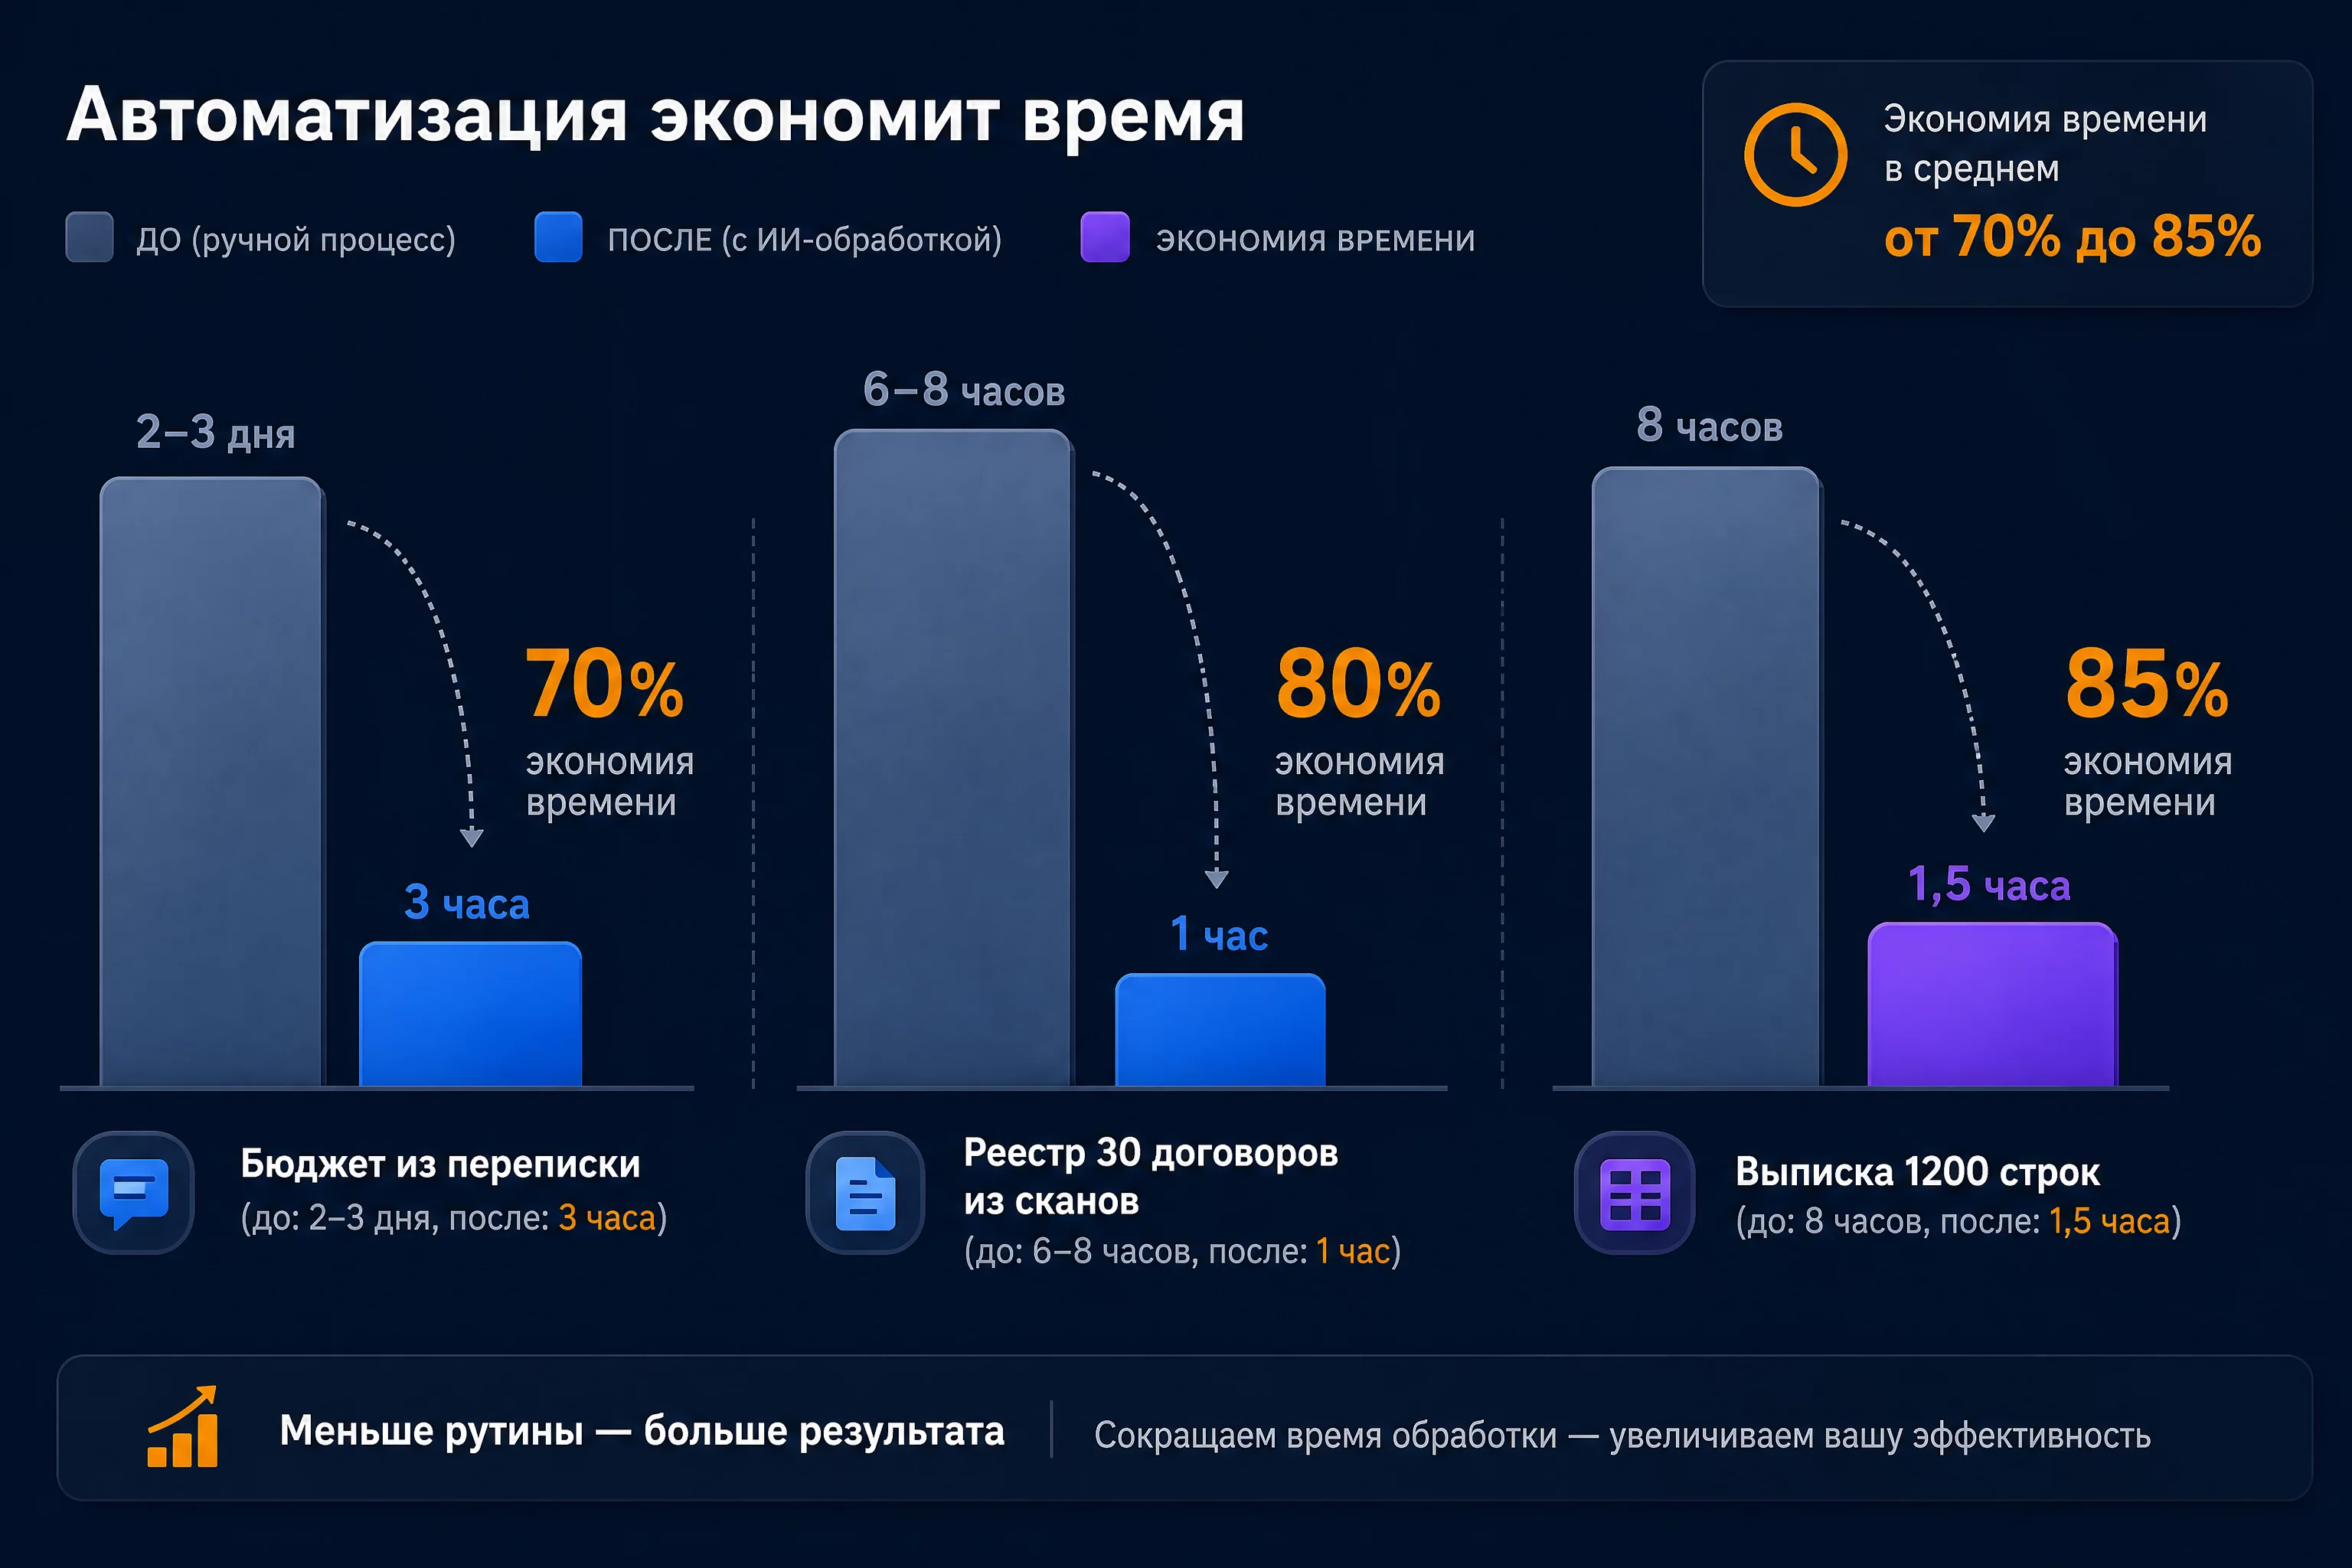
Финансовый директор торговой компании собирал бюджет на год. Руководители шести отделов присылали планы расходов в мессенджер и на почту, кто в таблице, кто текстом, кто голосовыми сообщениями, которые секретарь расшифровывала вручную. Раньше на сбор и структурирование бюджета уходило два-три дня: нужно было свести все сообщения в единую таблицу, разложить по статьям и проверить, что ничего не потерялось.
Что сделали: собрали переписку за месяц в один текстовый документ, обезличили названия отделов и загрузили в ChatGPT с промптом на сборку бюджета по статьям и подразделениям. Модель собрала черновик таблицы за 20-30 минут, проверка каждой строки по исходным сообщениям заняла ещё пару часов. Итог: три часа вместо двух-трёх дней. Экономия времени в разы на задаче, которая повторяется каждый год.
Отдельно нашлась польза, которую не закладывали: модель пометила строки, где в сообщении сумма была указана в тысячах без уточнения, и бухгалтер заметил два расхождения, которые в прошлом году ушли бы в бюджет с ошибкой.
Кейс 2. Реестр договоров из стопки сканов, Gemini 2.5.
Главный бухгалтер на УСН получила стопку из 30 сканов договоров аренды и поставки, которые нужно было свести в реестр: номер, дата, контрагент, предмет, сумма, срок действия. Раньше на ручной ввод такой стопки уходил вечер, примерно 6-8 часов, с неизбежными ошибками в суммах из-за усталости.
Что сделали: отсканировали документы, загрузили в Gemini 2.5 и попросили распознать каждый скан и собрать реестр в таблицу. Обработка 30 документов заняла около 40-60 минут, включая проверку каждой суммы по скану. Итог: час вместо вечера. Точность распознавания бухгалтер оценила в 95-98%, причём модель честно пометила несколько документов, где текст был смазан и сумму разобрать не удалось. О работе с первичными документами в целом я писала в статье AI для первичных документов: счета, накладные.
Экономия в часах здесь очевидная, но главное было в другом: ручной ввод 30 договоров почти гарантированно дал бы пару ошибок в суммах, которые потом всплыли бы при сверке с контрагентами. Нейросеть с проверкой каждой строки такие ошибки отсекает.
Кейс 3. Реестр платежей из хаоса, ChatGPT с код-интерпретатором.
Финансовый аналитик логистической компании получил выписку за месяц в виде текстового файла с примечаниями: часть строк была сгруппирована, часть содержала пояснения бухгалтера, часть имела двойное форматирование. Всего около 1 200 строк. Раньше на приведение такой выписки к нормальному виду уходил рабочий день: разбить строки, вычистить мусор, разложить по категориям, проверить итог.
Что сделали: загрузили файл в ChatGPT с код-интерпретатором, промпт просил очистить данные, разбить по колонкам, распределить категории и пересчитать итог кодом. Модель выдала очищенную таблицу с итоговой суммой за 15-20 минут, сверка с исходником заняла около часа. Итог: полтора часа вместо рабочего дня. Экономия около 80% времени, и пересчёт кодом исключил ошибки арифметики, которые при ручной работе встречаются регулярно.
Общий вывод из кейсов: нейросети не убирают человека из процесса, они убирают рутину ввода. Проверка, решения и ответственность остаются за специалистом, а время на сборку таблиц из текста сокращается в разы.
Сколько это в рублях: экономика внедрения
Прежде чем внедрять нейросети в рутину, полезно посчитать, сколько реально экономят таблицы из текста. Без цифр любое предложение упирается в вопрос «а зачем нам это надо» и встаёт. Расчёт занимает десять минут, а цифры из него помогают обосновать и покупку подписки, и изменение процессов.
Простая формула в четыре шага. Первый: выберите три самые частые задачи, где текст превращается в таблицу, например сбор бюджета, реестр счетов и реестр договоров. Второй: замерьте, сколько часов в месяц занимает каждая задача сейчас, вручную. Третий: после внедрения нейросети замерьте те же задачи снова. Четвёртый: разницу в часах умножьте на стоимость часа специалиста.
Стоимость часа считается просто: месячная зарплата делится на 160 рабочих часов. Для специалиста с окладом 150 000 рублей час стоит около 950 рублей, для финдиректора с окладом 250 000 рублей около 1 560 рублей. Дальше экономика считается на конкретных цифрах отдела.
Пример из практики школы. Бухгалтер собирала реестр договоров из стопки сканов раз в квартал, на это уходило два дня, примерно 16 часов. После внедрения Gemini на распознавание и сборку уходит четыре часа с проверкой. Экономия 12 часов за квартал, это 48 часов в год. При ставке 950 рублей в час это около 45 000 рублей в год на одной задаче, а задач с таблицами в отделе обычно несколько.
Важно считать не только время, но и ошибки. Ручная сборка таблиц пропускает строки и перевирает суммы, особенно к концу рабочего дня. Нейросеть проходит весь массив и не устаёт, хотя и требует проверки. Ошибка в сумме договора, которая всплыла через полгода при сверке с контрагентом, стоит дороже сэкономленных часов. Эту часть экономики сложно посчитать в часах, но она часто перекрывает экономию времени.
Отдельно про то, кому показывать эти расчёты. Собственнику и генеральному директору важны цифры в рублях, а не «мы теперь используем нейросети». Подготовьте одну страницу: задача, часы до, часы после, экономия в рублях за месяц и за год, стоимость подписок. Такая страница снимает большинство вопросов о выделении бюджета на инструменты.
И про окупаемость подписки, потому что этот вопрос задают чаще всего. Платная подписка на ChatGPT или Claude стоит порядка 20 долларов в месяц, это примерно 1 800-2 200 рублей по курсу. Считаем от обратного: чтобы подписка окупилась, достаточно сэкономить два-три часа работы специалиста со ставкой 900-1 000 рублей в час. Это одна задача «текст в таблицу» в неделю. Если у вас таких задач хотя бы две-три в месяц, подписка уже окупилась, остальное идёт в плюс. На бесплатных версиях стартуете без вложений, а платную подключаете, когда упрётесь в лимиты.
Какие ошибки и мифы мешают заменить Excel нейросетью?
За годы работы с ученицами школы я вижу повторяющиеся ошибки. Разберу самые частые, их легко избежать, если знать заранее.
Ошибка первая, расплывчатый промпт. «Сделай таблицу» даёт кашу, а «преврати текст в таблицу с колонками дата, категория, сумма, в конце итог» даёт готовый результат. Разница в одной строчке промпта, а результат в разы.
Ошибка вторая, пропущенный формат ответа. Если не сказать, что нужна таблица, модель может ответить текстом, который придётся переделывать. Всегда добавляйте «формат ответа: таблица» и перечисляйте колонки.
Ошибка третья, разрешение выдумывать. Без запрета модель дозаполнит недостающие цифры правдоподобными. В финансовых промптах всегда есть строка «если данных нет, так и напиши, не додумывай».
Ошибка четвёртая, загрузка полных данных. Имена контрагентов, ИНН, реквизиты в облачной модели это риск. Обезличивание занимает 10 минут и снимает большую часть вопросов безопасности.
Ошибка пятая, перегрузка промпта. Десять задач в одном запросе модель выполняет хуже, чем три. Разбивайте сборку таблицы и расчёт итогов на отдельные запуски.
Ошибка шестая, доверие без проверки. Таблица из текста это черновик, а не финальный отчёт. Проверка случайных строк по источнику и сверка итоговой суммы обязательны, модель ошибается реже человека, но ошибается.
Теперь про мифы, которые мешают начать.
Миф: нейросеть сделает таблицу сама, без моего участия. Нет. Модель следует инструкции, а инструкцию пишете вы. Если не задать колонки и формат, результат будет случайным. Участие человека это условие работы, а не недостаток.
Миф: бесплатная версия это игрушка. Бесплатные версии дают реально полезные функции с лимитами. На них можно собрать десятки таблиц, пока не упрётесь в ограничение по объёму или количеству запросов. Для разовых задач бесплатных лимитов хватает на месяцы.
Миф: нейросеть заменит финансиста. Это самый дорогой миф, потому что он пугает и откладывает внедрение. Нейросеть убирает рутину ввода и структурирования, но не заменяет решения. Сверка, проверка, выводы и ответственность остаются за человеком. По опыту школы, нейросеть усиливает специалиста, который уже умеет работать с цифрами, а не заменяет его.
Миф: чем новее модель, тем лучше таблицы. Новые версии действительно улучшают общие показатели, но для таблиц из текста важнее не свежесть модели, а то, насколько хорошо она следует инструкции и не выдумывает. Иногда проверенная временем версия работает предсказуемее свежего релиза с ещё не обкатанным поведением.
Миф: нейросеть всё сделает сама, надо только нажать кнопку. Это продолжение первого мифа, но в более коварной форме. Модель не знает, какая у вас учётная политика, как у вас называются статьи и кто ваш контрагент. Она знает то, что написано в вашем промпте. Поэтому «сама» она сделает ровно столько, насколько точно вы описали задачу. Ожидание «сделает сама» приводит к разочарованию и выводу «нейросеть не работает», хотя на самом деле не работает промпт.
Миф: нужен один инструмент для всех таблиц. Частая ошибка новичков: выбрать одну модель и мучить её всеми задачами, включая те, где она слаба. На практике связка из двух моделей закрывает больше. Выписку считает ChatGPT, сканы распознаёт Gemini, договор разбирает Claude. Это не усложнение, а наоборот экономия времени. Один инструмент для всего это удобно, но дороже по часам.
Чек-лист: как сделать таблицу из текста с первого раза
Если читаете статью и хотите применить прямо сейчас, вот порядок. Он занимает 15-20 минут на первую таблицу и даёт рабочий результат.
- Определите, что за текст и какие колонки нужны. Переписка, выписка, скан, отчёт. Колонки: дата, категория, сумма, комментарий. Перечень продумываете вы.
- Очистите и обезличьте данные. Уберите дубли, мусор, названия контрагентов, ИНН и реквизиты. Чистый вход даёт чистый выход.
- Составьте промпт из четырёх частей. Роль, данные, шаги, формат. Используйте один из двенадцати промптов выше как шаблон.
- Загрузите текст и отправьте запрос. Вставьте текст в чат или загрузите файл. Если ответ вышел простынёй, уточните формат.
- Проверьте каждую строку по источнику. Сверьте несколько случайных строк, проверьте итоговую сумму, убедитесь, что модель не додумала цифры.
- Экспортируйте в Excel и сохраните промпт. Скопируйте таблицу или попросите CSV. Рабочий промпт сохраните, он пригодится в следующий раз.
- Прогоните таблицу через вторую модель. Один и тот же текст и один и тот же промпт запустите в другой нейросети и сравните строки. Расхождения покажут, где модель сомневалась, а совпадения повышают уверенность в цифрах.
- Повторяйте и накапливайте библиотеку промптов. Через месяц у вас будет набор из 10-15 проверенных шаблонов под ваши задачи, и каждая следующая таблица собирается быстрее.
FAQ: частые вопросы про таблицы из текста
Можно ли сделать таблицу из текста через нейросеть бесплатно? Да. DeepSeek V3.2 работает бесплатно и без VPN, у ChatGPT, Gemini и Claude есть бесплатные версии с лимитами. Для разовых задач бесплатных лимитов хватает, для регулярной работы с большими файлами удобнее платная подписка.
Какая нейросеть лучше всего превращает текст в таблицу? Зависит от исходного текста. Структурированная выписка и переписка это ChatGPT, он точнее из-за код-интерпретатора. Сканы и фото это Gemini 2.5. Длинный договор это Claude Sonnet 4.6. Простые таблицы на обезличенных данных бесплатно делает DeepSeek V3.2.
Нужно ли уметь программировать? Нет. Код пишет модель, вам нужно только описать словами, что и в каком виде получить. Достаточно понимать, какие колонки нужны, и уметь проверить результат.
Как нейросеть понимает, какие колонки нужны? Модель не угадывает, она следует инструкции. Если колонки перечислены в промпте, модель соберёт таблицу именно с ними. Если не перечислены, выберет их сама, и результат может не совпасть с ожиданием.
Что делать, если таблица получилась с ошибками? Проверить три вещи: конкретность промпта, чистоту входных данных и запрет выдумывать. В большинстве случаев ошибки уходят после уточнения этих трёх пунктов.
Безопасно ли загружать данные компании? Полные данные с контрагентами и реквизитами загружать не стоит. Перед загрузкой обезличьте: замените названия кодами, уберите ИНН и реквизиты. Для чувствительных данных используйте корпоративные тарифы или локальную модель.
Сколько времени экономит нейросеть на таблицах из текста? По опыту школы, ручная сборка таблицы занимает от пары часов до пары дней. Нейросеть сокращает это в 5-10 раз: черновик из 40-50 позиций собирается за 10-20 минут, проверка занимает ещё 20-40 минут.
Чем это отличается от обычного Excel? Excel хранит и считает готовые данные, а нейросеть собирает их из неструктурированного текста. После сборки таблицу переносят обратно в Excel, поэтому нейросеть не заменяет Excel, а заполняет его данными.
Итог: что выбрать и с чего начать
Нейросеть вместо Excel для таблиц из текста это рабочий инструмент, который экономит часы уже сегодня. ChatGPT собирает и пересчитывает таблицы особенно точно, Gemini вытаскивает данные из сканов и фото, Claude разбирает длинные договоры, DeepSeek даёт бесплатный старт без VPN.
Главное, что нужно понять из этой статьи: модель не думает за вас, она следует инструкции. Качество таблицы определяет промпт и подготовка данных. Четыре части промпта, роль, данные, шаги, формат, это весь секрет, дальше дело практики.
Начните с одной задачи, которая съедает больше всего времени. Подготовьте обезличенные данные, возьмите промпт из блока выше, прогоните через две модели и сравните. Вечер на первую задачу, вечер на вторую, и через три-четыре дня у вас есть рабочий набор таблиц и промптов под вашу реальную работу.
Конкретный план первой недели. День первый: выберите задачу и подготовьте обезличенные данные. День второй: соберите первую таблицу в бесплатной версии DeepSeek или в лимитах ChatGPT. День третий: прогоните те же данные через вторую модель, сверьте строки и итоги. День четвёртый: перенесите рабочий промпт в отдельный документ и закройте ещё одну задачу. Через неделю у вас есть измеренная разница между моделями на ваших данных, а это лучшая основа для выбора подписки.
Отдельно скажу про тех, кто откладывает старт в ожидании идеальной модели. Идеальной не будет, каждая новая версия это компромисс. Ждать совершенства значит терять часы, которые нейросети экономят уже сейчас. Даже бесплатная версия DeepSeek или лимиты ChatGPT на простых таблицах дают результат, который быстрее ручного ввода.
Агенты вместо чата: следующий уровень автоматизации
Таблицы из текста через чат это первый уровень, и на нём останавливаться не обязательно. В 2026 году модели превращаются в агентов: они не просто отвечают на запрос, а выполняют цепочки действий. У ChatGPT и Claude появились режимы агентов: модель не просто отвечает на запрос, а выполняет цепочку действий, пока не достигнет цели. Для таблиц это значит, что сборка перестаёт быть ручной процедурой.
Как это выглядит на практике. Агент может забрать файл с выпиской из почты, распознать, очистить, разложить по колонкам, посчитать итоги и отправить готовую таблицу в мессенджер, в чат или в общую папку. Вы задаёте сценарий один раз, дальше агент повторяет его по расписанию. Сверка месяца, которая сейчас занимает день с подсказками модели, через год может стать автоматическим сценарием без вашего участия в рутине.
В школе мы уже разбираем такие связки на курсе: например, AI-агенты для закрытия месяца, сверка регистров через нейросети и проверка авансовых отчётов. Принцип один: модель собирает данные, правила разбора задаёт человек, а автоматизация берёт на себя повторяемость.
Что это значит для выбора модели сейчас. Покупайте не просто самую умную модель, а ту, у которой есть нормальный режим агента и API для интеграции. ChatGPT и Claude в этом направлении ушли дальше всех, Gemini догоняет, у DeepSeek агентных режимов в обычном доступе нет. Если ваша цель это автоматизация таблиц на регулярной основе, этот параметр важнее силы модели на отдельной задаче.
Мой прогноз на 2026-2027: разовая сборка таблиц из текста останется, но вырастет доля регулярных сценариев, которые запускаются по расписанию. Кто держит процесс в руках уже сейчас, тот накопит библиотеку промптов и сценариев раньше, и автоматизация для него будет следующим шагом, а не революцией.
Что я советую заложить уже сейчас, чтобы не переделывать потом. Храните промпты в одном документе по задачам, а не в истории чатов: «реестр платежей», «бюджет из переписки», «сверка двух списков». У каждой задачи свой промпт с проверенным форматом ответа. Когда появится агент, который собирает таблицы без чата, вы просто передадите ему свои промпты как готовые сценарии. Те, кто собрал библиотеку промптов заранее, окажутся в два раза быстрее на старте автоматизации, потому что правила разбора у них уже записаны и отлажены.
Если вы хотите не просто собрать пару таблиц, а выстроить работу финотдела с нейросетями как систему, приходите на курс «AI-навыки финансиста». 800+ выпускников уже внедрили такие сценарии в свою работу. Записаться можно на сайте школы fin-academy.pro/ai, а начать с бесплатного эфира-экскурсии по ChatGPT для финансиста можно здесь chatgpt.fin-academy.pro.
Подписывайтесь на наши каналы, там я и Софья Бурцева делимся практикой и новостями:
- @findir_pro, 45 000 подписчиков, основной канал школы «Финансовый директор | Мастер CFO»
- «АИ с Софьей и Натали», 13 000 подписчиков, канал про нейросети для финансистов
- MAX, 5 000+ подписчиков, актуальные новости и практика применения AI в финансах
Об авторе
Натали Васильева. Эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO». С нейросетями в работе финансиста с февраля 2023 года. Через курс «AI-навыки финансиста» прошли 800+ финансистов, главбухов и финдиров. Веду Telegram-канал @findir_pro (45 000 подписчиков) и MAX-канал «Финансовый директор» (5 000+).