AI для финансиста
Фото таблицы → готовый Excel: нейросети распознают бумагу, PDF и скриншоты без ручного ввода

Меня зовут Натали Васильева, я эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO». Вместе с основателем школы Софьей Бурцевой я второй год показываю финансистам и бухгалтерам, как нейросети снимают рутину, а через курс «AI-навыки финансиста» прошли уже 800+ выпускников. В этой статье рассказываю, как превратить фото таблицы в готовый Excel за минуты. Бумажная накладная, PDF с реестром, скриншот из банк-клиента: всё это нейросети 2026 года распознают без ручного ввода. Внутри 12 готовых промптов, сравнительная таблица моделей, три кейса с цифрами в часах и рублях и чек-лист на 15 минут. Материал актуален на 28 августа 2026 года. Если вы только начинаете с нейросетями, сначала советую пройти большой бесплатный курс ChatGPT для финансиста, а потом возвращаться сюда за распознаванием таблиц.
Зачем это вам. Ввод таблиц в Excel руками это одна из самых дорогих и скучных операций в финансах. Одна страница печатной таблицы переводится в ячейки за 20-40 минут, а в месяце таких страниц десятки. Нейросеть делает то же за 1-3 минуты, включая шапку, итоги и объединённые ячейки. Разница между теми, кто набирает руками, и теми, кто прикрепляет фото и получает файл, это от 4 до 15 часов в неделю чистого времени. Именно эту разницу мы с учениками закрываем распознаванием.
Ключевые выводы:
- Нейросети 2026 года превращают фото бумажной таблицы, PDF и скриншот в готовый Excel за минуты: GPT-5.5, Claude Sonnet 4.6 и Gemini 2.5 читают изображения и отдают файл, DeepSeek V3.2 работает без VPN с обезличенными данными.
- Типовая операция занимает 1-3 минуты вместо 20-40 минут ручного набора: прикрепил фото, отправил промпт, получил таблицу, скачал в формате XLSX.
- Модели видят не только текст, но и структуру: шапку, колонки, объединённые ячейки, итоги. Умеют собирать многостраничные PDF в одну таблицу и переносить формулы.
- На чистых сканах и ровных скриншотах точность высокая, ошибки единичны. На фото с наклоном, засветкой и рукописными пометками нужен промпт проверки.
- Три кейса из практики школы: экономия от 4 до 15 часов в неделю на операциях с таблицами, оцифровка архива за 5 лет сэкономила около 45 000 рублей.
- Правило безопасности: перед загрузкой в публичную нейросеть обезличивать данные, документы под NDA не грузить.
- Нейросеть ускоряет ввод и распознавание, а проверка цифр и ответственность остаются за человеком.
Что умеет нейросеть с таблицей в 2026 году
В 2026 году нейросети умеют читать таблицы с любого носителя: бумага, PDF, скриншот, фото с телефона, даже рукописные ведомости. Вы прикрепляете изображение, отправляете промпт, и модель возвращает готовую таблицу с колонками, строками и суммами, а в ChatGPT сразу в файле XLSX. В отличие от классического OCR, который просто считывает символы, модель понимает структуру таблицы целиком: шапку, колонки, объединённые ячейки, итоги.
Что именно делает нейросеть. Она идёт от смысла документа: находит шапку, колонки, итоговую строку, отмечает объединённые ячейки и переносит всё в табличный формат. На практике фотографию накладной модель превращает в аккуратную таблицу с номером, датой, позициями, количеством, ценой и суммой, которую можно сразу открыть в Excel.
Почему это стало возможным именно сейчас. Три вещи совпали. Первая: модели стали мультимодальными. GPT-5.5, Claude Sonnet 4.6 и Gemini 2.5 принимают изображения и PDF напрямую, без отдельного распознавателя. Вторая: выросла точность чтения структуры. Современные модели не путают колонки, когда в таблице многоуровневая шапка или объединённые ячейки, это было слабым местом ещё год назад. Третья: модели научились отдавать результат в файл. ChatGPT умеет генерировать XLSX через код, Claude отдаёт CSV, Gemini экспортирует в Google Таблицы.
Вместе эти три вещи собираются в короткий конвейер: прикрепить, распознать, выгрузить. Раньше этот путь занимал три отдельных инструмента: сканер, отдельную программу распознавания и конвертер. Теперь одна модель делает всё, и именно это я называю базовым навыком финансиста 2026 года. Причём сценарии разные: у бухгалтера это бумажные накладные, у финдира скриншоты из банк-клиента, у казначея реестры платежей в PDF. Ниже разберу каждый сценарий по шагам с готовыми промптами.
Почему именно таблицы распознаются так хорошо. Таблица это самый предсказуемый формат делового документа: жёсткая сетка, понятные границы колонок и строк, итоги внизу. Модель восстанавливает такую структуру увереннее, чем сплошной текст абзаца или произвольную вёрстку. Поэтому на практике распознавание таблиц даёт более стабильный результат, чем чтение рукописных писем или сканов со сложной вёрсткой, и именно на этом построены все промпты ниже.
Про ограничения сразу, чтобы не было ложных ожиданий. Нейросеть отлично справляется с печатными таблицами, ровными сканами и скриншотами. На кривом фото с тенями, засветкой или рукописными пометками она начинает ошибаться: перепутать последнюю цифру суммы, номер счёта, НДС. Поэтому в каждый промпт я добавляю требование отмечать ненадёжные поля, а после распознавания советую прогонять проверку. Про это подробно в разделе про ошибки.
Что такое распознавание таблиц нейросетью
Распознавание таблиц это превращение изображения в структурированные данные: колонки, строки, ячейки с числами и текстом. Классический OCR читает символы, но не понимает структуру, поэтому на сложных таблицах выдаёт кашу. Нейросеть идёт дальше: она понимает, что строка «Итого» суммирует столбец, что шапка повторяется на каждом листе, что объединённая ячейка относится к нескольким строкам.
Для финансиста это означает конкретную вещь: вы перестаёте перепечатывать. Вместо набора данных руками вы прикрепляете файл, получаете таблицу, проверяете итоги и работаете дальше. В следующих разделах покажу по шагам, как это делается для каждого типа источника: бумага, скриншот, PDF, рукописная ведомость.
Какие форматы превращаются в Excel: бумага, фото, PDF, скриншот
Все четыре основных источника таблиц нейросети 2026 года переводят в Excel: бумажные документы через фото, электронные таблицы через скриншот, документы через PDF и рукописные ведомости через фотографию сверху. Разница только в качестве результата и в том, сколько нужно проверять. Печатные и ровные сканы распознаются почти без ошибок, рукописные и кривые фото требуют проверки.
Пройдусь по каждому источнику коротко, а в следующих разделах разберу пошагово.
Бумажные таблицы. Накладные, акты, реестры, банковские выписки на бумаге. Фотографируете сверху при хорошем свете, прикрепляете в чат, получаете таблицу. Это самый частый сценарий в бухгалтерии.
Скриншоты. Таблица из банк-клиента, CRM, отчёта, чужого письма, вебинара. Выделили область, сделали скриншот, прикрепили, получили Excel. Спасает, когда данные нельзя выгрузить или они в закрытой системе.
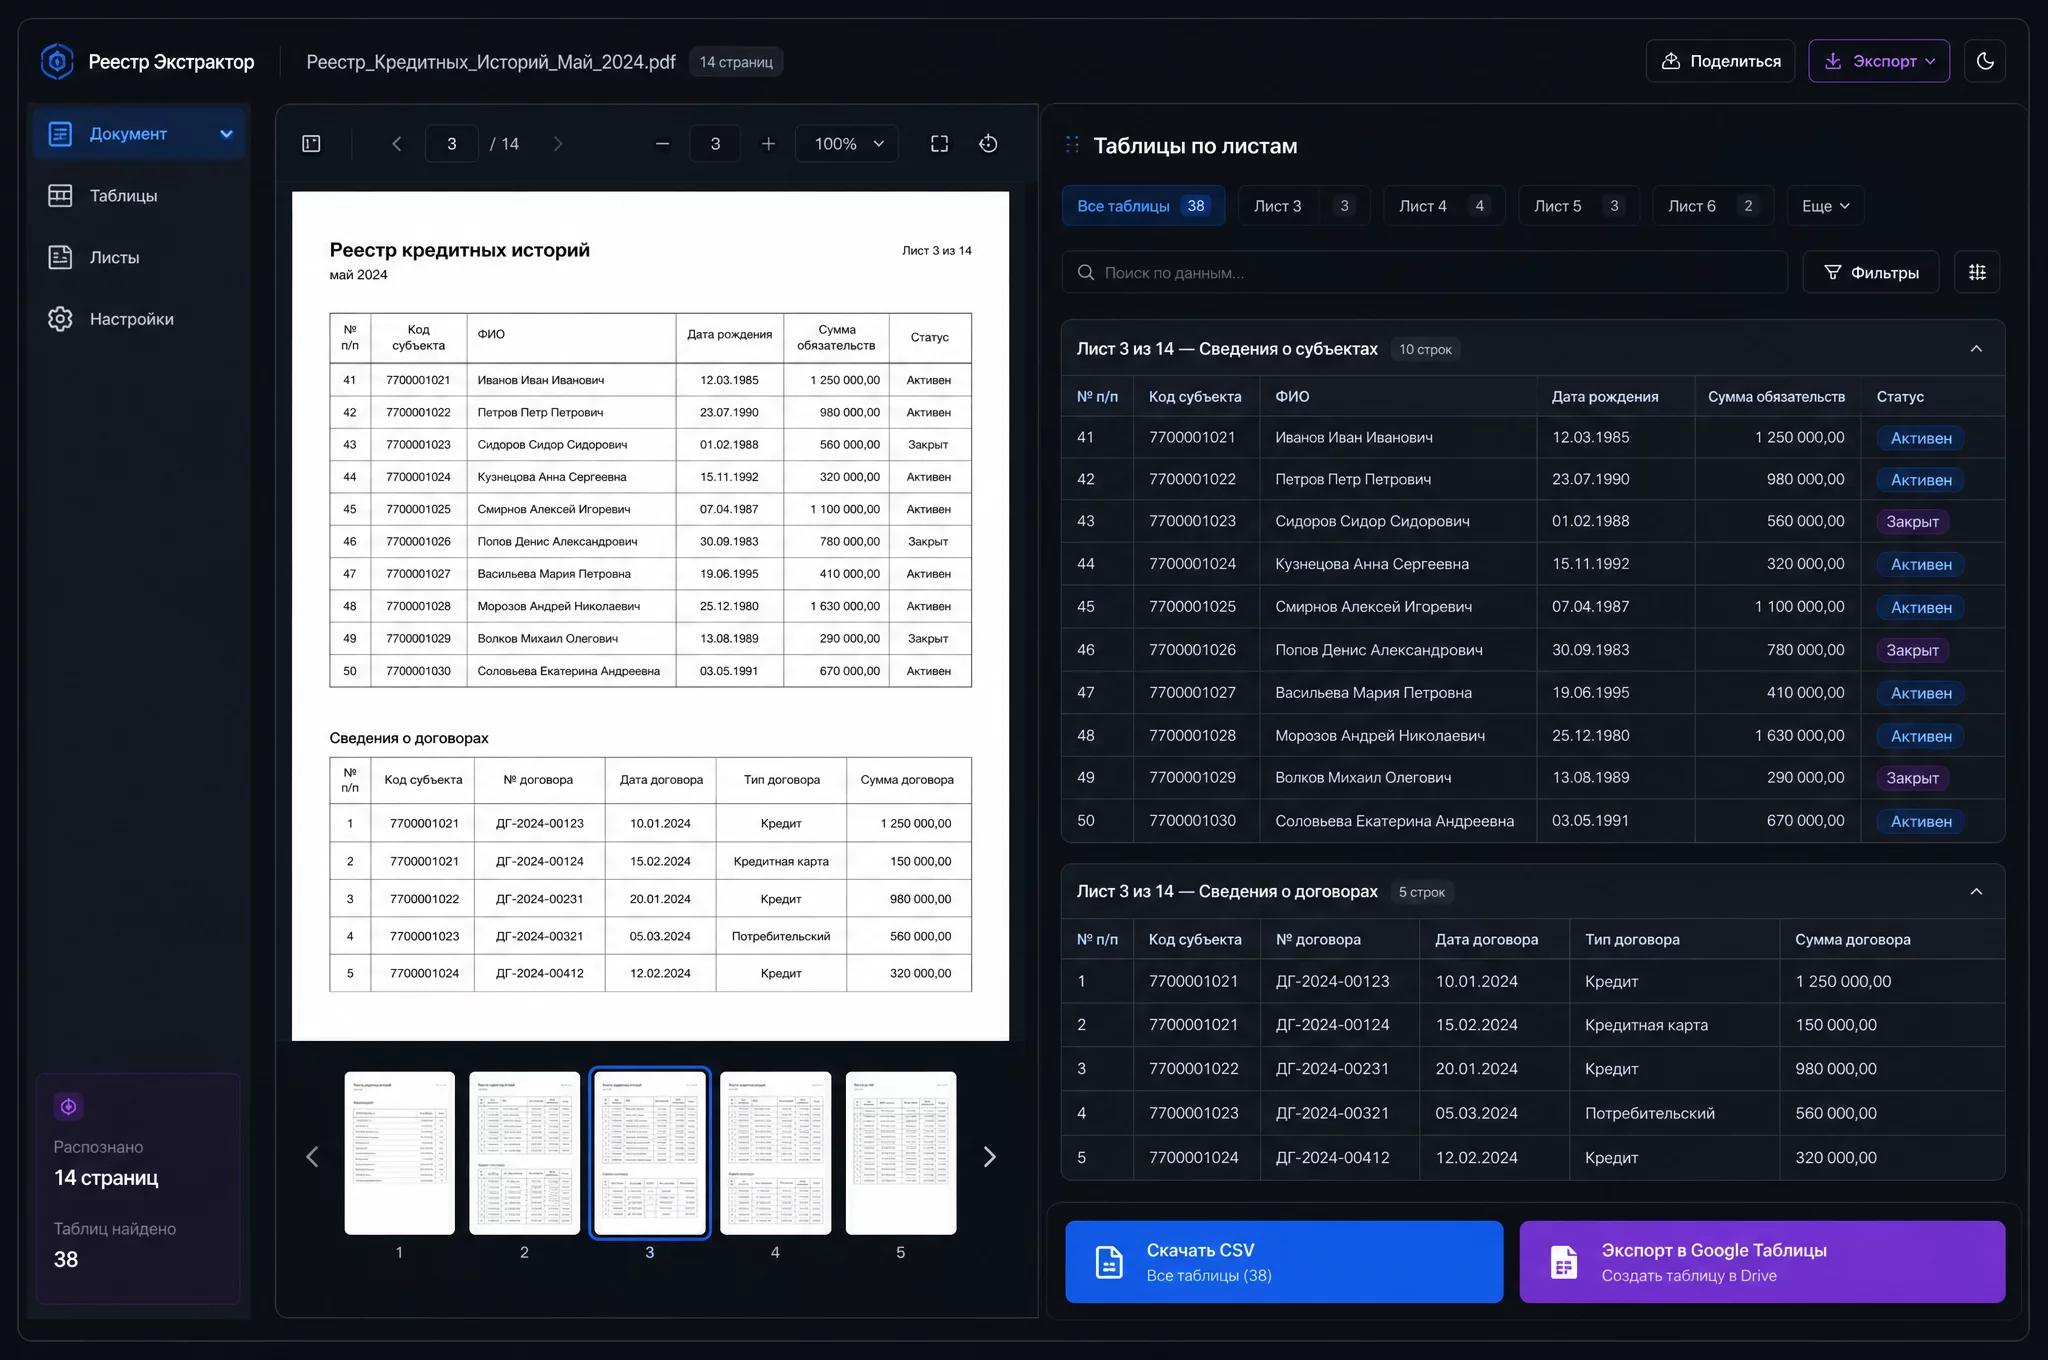
PDF. Реестры, ведомости, отчёты, приложения к договорам. Прикрепляете PDF целиком, модель собирает таблицы со всех страниц в один лист или несколько. Тут нейросеть спорит с конвертерами, о чём отдельно.
Рукописные ведомости. Архивы, табели, полевые журналы. Распознаются хуже печатных, но цифры и короткие слова читаются, если фото ровное и свет хороший.
Фото с телефона на ходу. Документ сфотографирован под углом, с тенью, в сумерках. Распознаётся, но с ошибками, которые обязательно надо ловить промптом проверки.
Для наглядности собрала таблицу: какой источник, какая точность и сколько проверять.
| Источник | Пример | Точность распознавания | Сколько проверять |
|---|---|---|---|
| Ровный скан или PDF | Скан накладной, реестр | Высокая, ошибки единичны | Итоги и последние цифры сумм |
| Скриншот таблицы | Банк-клиент, CRM, отчёт | Высокая, если таблица ровная | Шапку и форматы чисел |
| Фото бумаги сверху | Накладная при дневном свете | Средняя, зависит от света и угла | Все поля, особенно суммы |
| Рукописная ведомость | Табель, архивный журнал | Ниже печатной, цифры читаются | Каждую строку |
| Кривое фото на ходу | Снимок под углом с тенью | Низкая, много ошибок | Всё, лучше переснять |
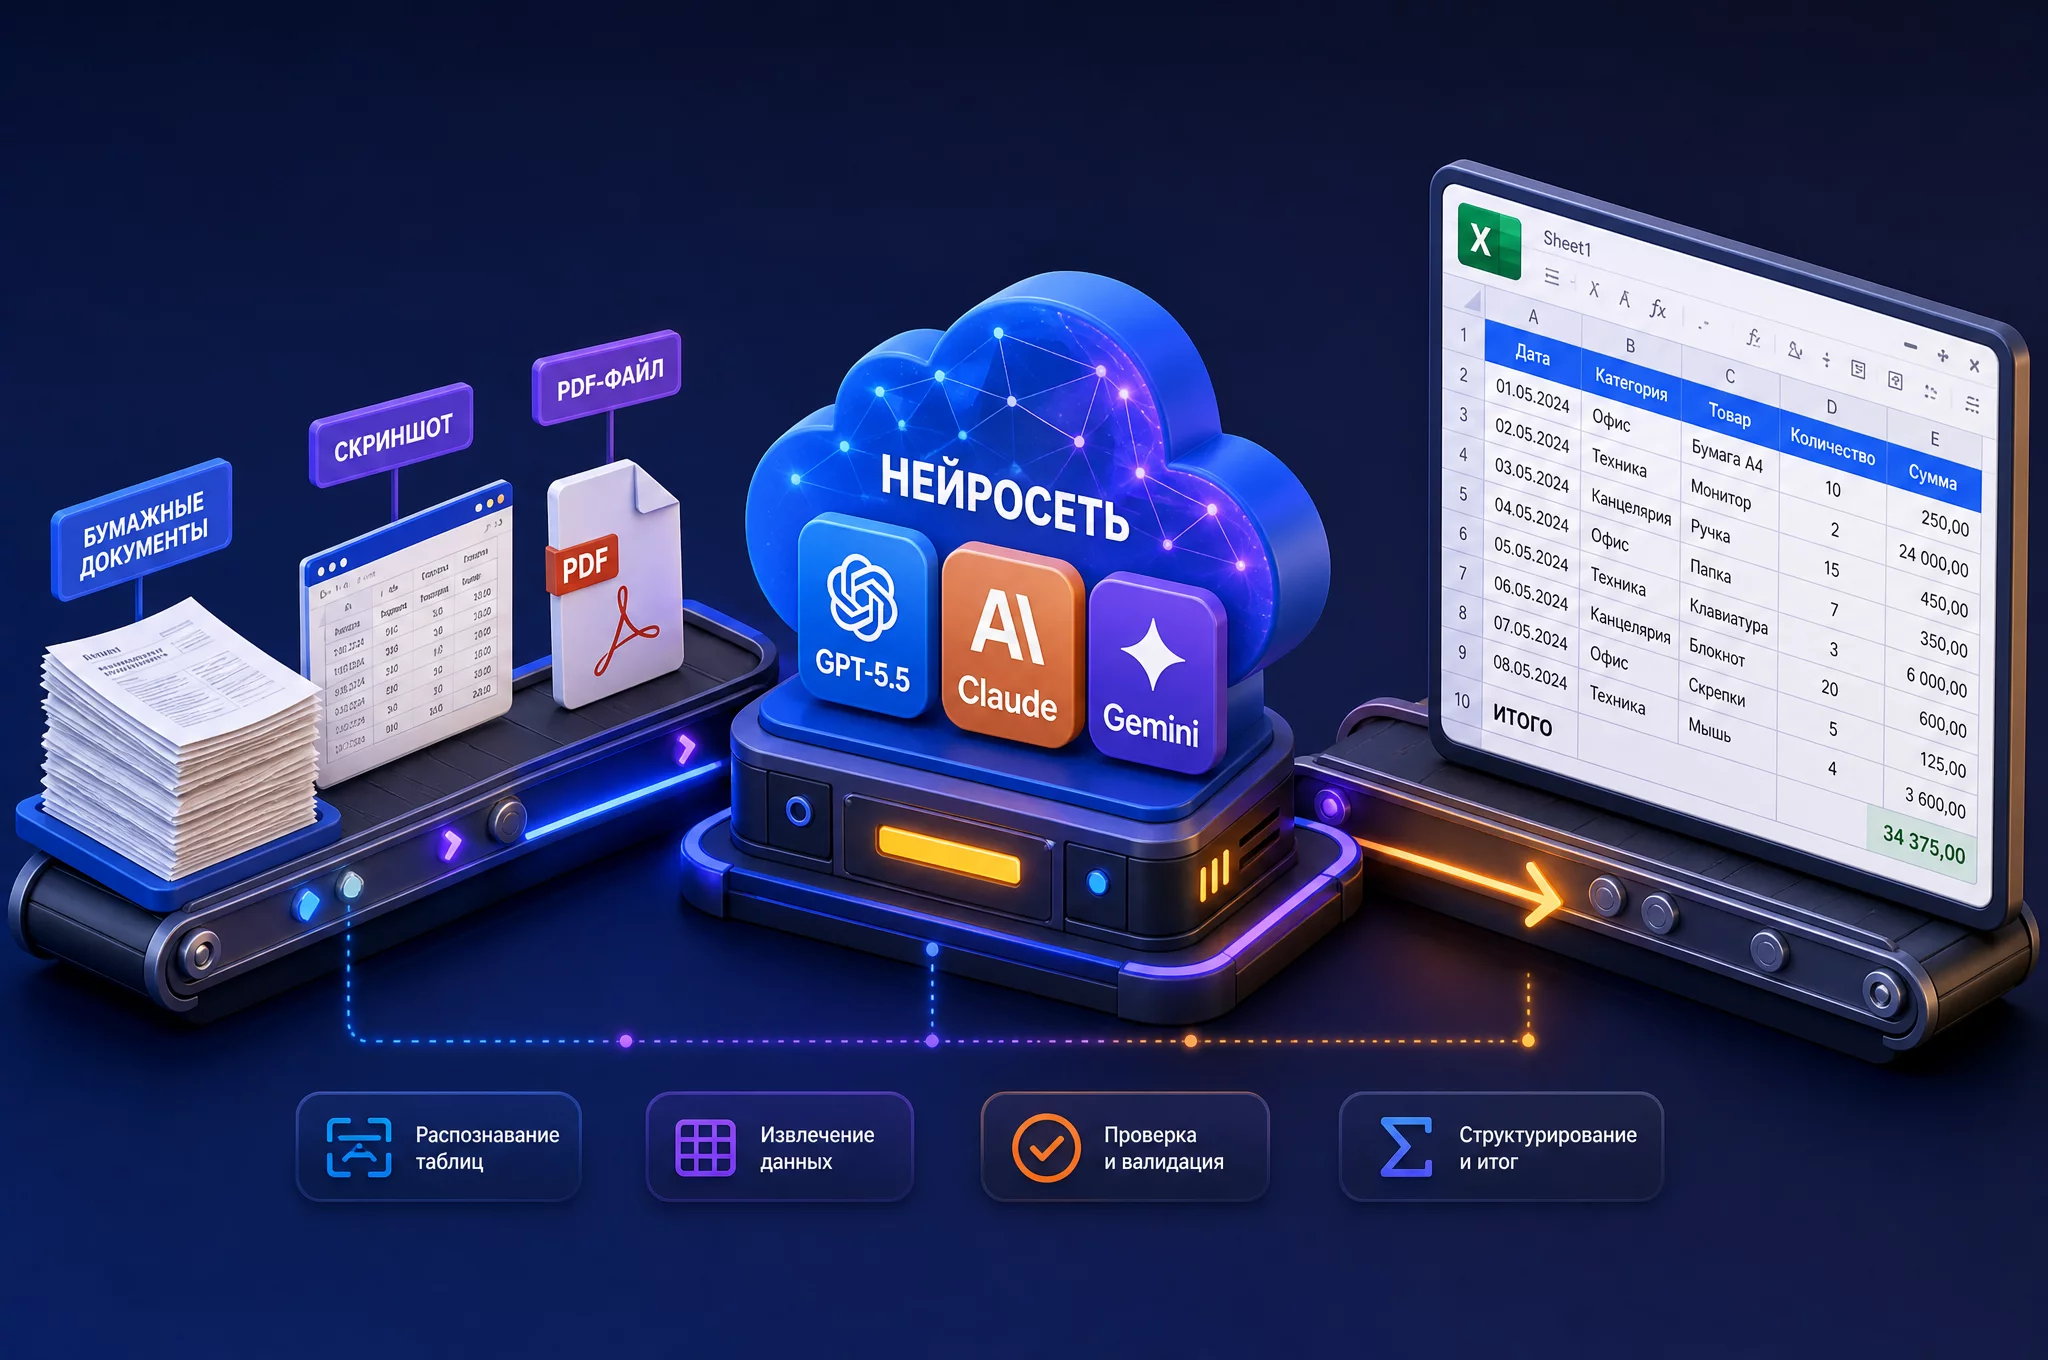
Фото бумажной таблицы в Excel: пошаговый алгоритм
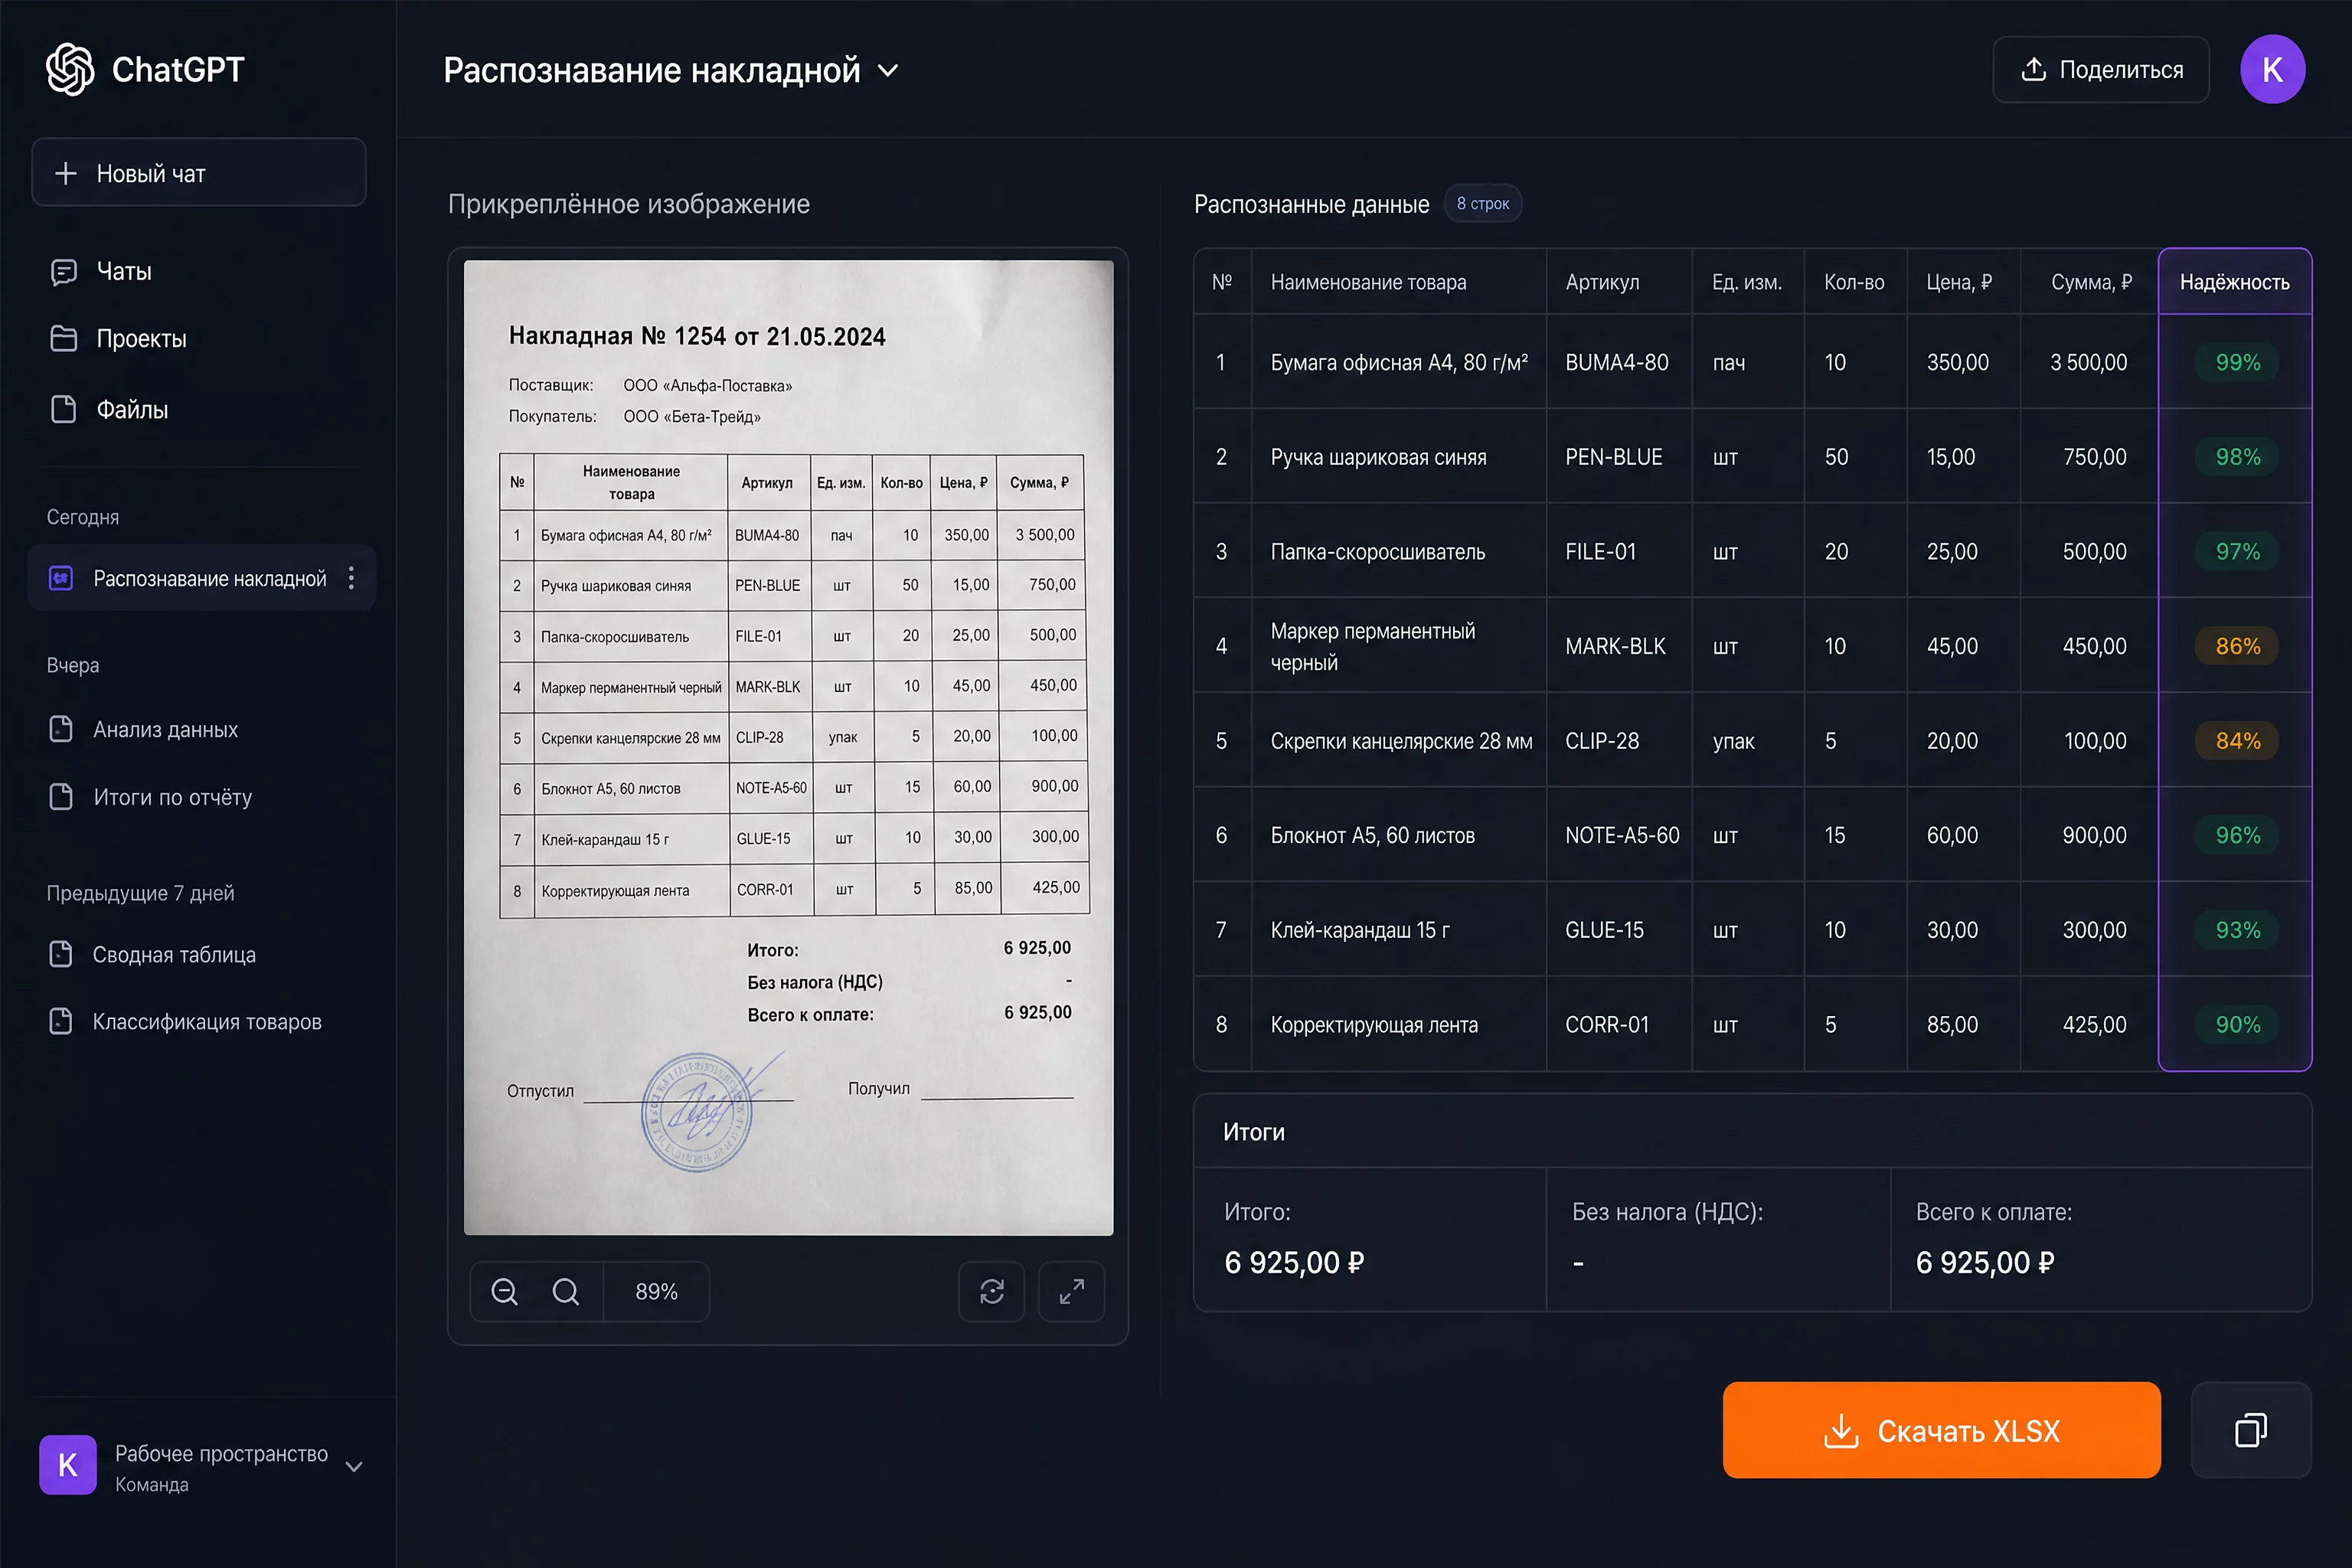
Главный сценарий, ради которого читают эту статью: есть бумажная таблица, нужно её в Excel. Алгоритм простой: сфотографировать ровно, прикрепить в чат, отправить промпт, проверить, выгрузить. На всё уходит 1-3 минуты, из которых основное время это проверка итогов.
Что отправить в чат. Откройте chatgpt.com, прикрепите фото, отправьте промпт распознавания. В ответ получите таблицу с колонками, строками и итогами, а в конце попросите выгрузить файл XLSX. То же самое работает в Claude на claude.ai и Gemini на gemini.google.com.
Промпт 1. Универсальный: фото бумажной таблицы в Excel
Ты помощник финансиста, который превращает фотографию таблицы
в структурированные данные для Excel.

Прикрепляю фото таблицы (накладная, акт, реестр, выписка).

Сделай:
1. Определи тип таблицы и её назначение
2. Извлеки шапку, колонки и все строки данных
3. Сохрани объединённые ячейки как повторение значения
4. Отдельно вынеси итоговые строки, если они есть
5. Числа перенеси как числа, даты как даты, без текста
6. Не выдумывай отсутствующие значения, ставь пустую ячейку

В конце:
- Укажи, какие поля читаются ненадёжно из-за качества фото
  (наклон, засветка, тень, рукописные пометки)
- Сверь итоговую сумму, если она есть на фото
- Если итога нет, посчитай сам и напиши, что он вычислен

Формат ответа: таблица с колонками как в оригинале,
затем список ненадёжных полей.
Этот промпт закрывает 80 процентов задач. Ключевое в нём два требования: сохранить структуру и честно отметить ненадёжные поля. Модель не просто читает текст, она восстанавливает таблицу, и вы сразу видите, чему доверять.
Что делать после распознавания. Проверьте итоговые суммы с оригиналом, посмотрите список ненадёжных полей, затем попросите выгрузить файл. В ChatGPT это простая команда: «Подготовь файл XLSX». Модель соберёт файл через код, и вы его скачаете. Для тех, кто не работал с выгрузкой файлов, подробно про это писала в статье Своя AI-бухгалтерия, там весь конвейер от первички до отчёта.
Как получить доступ к нейросетям в России
Вопрос, который задают на каждом эфире: как вообще открыть ChatGPT и Claude из России. Отвечу коротко и по делу, без рекламы обходов. ChatGPT работает в браузере на chatgpt.com, у него есть официальные приложения для телефона и компьютера. Для оплаты тарифа нужна зарубежная карта или виртуальная карта, выпущенная банком, который работает с международными платёжными системами. Бесплатный тариф тоже работает, но с лимитами на загрузку файлов и без выгрузки XLSX. Gemini от Google доступен на gemini.google.com, у него похожая ситуация с оплатой.
Что касается доступа к сервисам, я не даю здесь инструкций по обходу ограничений. Скажу главное: есть нейросети, которые работают из России напрямую, без всяких обходов. DeepSeek V3.2 доступен на chat.deepseek.com, регистрация по почте, есть бесплатный тариф, интерфейс на русском языке. Для распознавания простых таблиц его хватает, а сложные документы лучше гонять на флагманских моделях. Ещё один вариант это российские сервисы на базе отечественных моделей, они тоже умеют работать с таблицами, но по моим тестам пока уступают флагманам на сложной структуре.
Правило для всех нейросетей одинаковое: независимо от того, какой моделью вы пользуетесь, в неё попадают только обезличенные данные. Про обезличивание подробно в разделе про безопасность, а промпт 12 делает это за минуту. Всё остальное, что касается доступов и тарифов, меняется быстро, поэтому я обновляю актуальную информацию в канале «АИ с Софьей и Натали», там 13 000 подписчиков следят за новыми моделями и рабочими связками.
Как подготовить документ перед фото
Качество фото решает больше, чем выбор модели. Я проверяла это не раз: один и тот же документ, сфотографированный ровно при дневном свете, распознаётся почти без ошибок, а кривой снимок с тенью даёт десяток ошибок в мелких цифрах. Пять минут на подготовку экономят час проверки, которая иначе ушла бы на ловлю ошибок в мелких цифрах.
Пять правил хорошего снимка таблицы. Первое: кладите документ на ровную поверхность без складок, разглаживайте края. Второе: камера строго сверху, держите телефон параллельно листу, чтобы не было перспективы, когда верхний край уже, чем нижний. Третье: свет должен падать ровно, без тени от рук, головы или корпуса. Дневной свет у окна лучше всего, вспышку не включайте. Четвёртое: заполните кадр документом, обрежьте лишний фон, чтобы модель не отвлекалась на стол и посторонние предметы. Пятое: для таблиц с мелким шрифтом подойдите ближе или включите максимальное разрешение, мелкие цифры на снимке с телефона должны читаться глазом.
Если документ мятый или выцветший, есть приём: положите сверху лист белой бумаги и прогладьте, или прижмите края. Иногда помогает сфотографировать документ через стекло, это выравнивает заломы. Если бумага просвечивает с обратной стороны, подложите чистый белый лист, чтобы текст сзади не мешал распознаванию. Такие мелочи дают заметный прирост точности, а стоят секунд.
Что делать, если таблица не помещается в один кадр. Длинные реестры и ведомости лучше снимать по частям с перекрытием: сделайте фото верхней части, затем сдвиньте вниз так, чтобы последние две-три строки попали в следующий кадр. Перекрытие нужно модели, чтобы склеить части без пропуска строк. В промпте распознавания укажите, что таблица прислана по частям и её надо склеить. Модель сопоставит колонки и уберёт дубли на стыках.
Как получить файл XLSX из ChatGPT
Когда модель собрала таблицу, попросите её подготовить файл. Промпт короткий, но есть нюанс: если таблица большая, лучше сразу просить файл, а не копировать из чата.
Промпт 2. Выгрузка в XLSX
Собери распознанную таблицу в файл Excel (XLSX):
1. Первая строка листа: шапка с жирным шрифтом и заливкой
2. Числа в числовом формате, даты в формате дат
3. Итоговую строку отдели границей и выдели
4. Автоподбор ширины колонок по содержимому
5. Назови лист по смыслу данных

Подготовь файл и дай ссылку на скачивание.
Почему это лучше ручного копирования. Модель сама решает формат, ширину колонок и выделение итогов. Вы получаете файл, который можно сразу открыть в Excel или Google Таблицах, без доводки. Если нужно, чтобы файл собирался по одинаковым правилам каждый раз, сохраните промпт в память ChatGPT, об этом дальше.
Как запомнить правила форматирования
Недавно в ChatGPT прокачали память: модель сама формирует и упорядочивает воспоминания на основе истории чатов, их можно посмотреть на отдельной странице управления памятью и задать инструкции, какие темы и в каких ситуациях нейросети следует затрагивать. Это значит, что вы один раз объяснили, как называть файлы и какие форматы использовать, и дальше каждый новый диалог модель помнит ваши правила.
Как этим пользоваться. После того как промпт выгрузки заработал стабильно, добавьте в память короткую инструкцию: «При выгрузке таблиц всегда называй лист по смыслу, числа в числовом формате, итоги выделяй». Тогда не нужно повторять это в каждом диалоге. Подробно про память я писала в статье ChatGPT Memory для финансиста.
Как распознавать пачки документов, а не по одному
По одному распознавать невыгодно: каждый диалог занимает минуты, а документов в месяце десятки. Поэтому я учу учеников собирать пачки. Модель справляется с 5-10 однотипными документами за один прогон, если они одинаковой структуры. Разнородную пачку лучше разбивать по типам: отдельно накладные, отдельно акты, отдельно счета-фактуры.
Промпт 3. Пачка однотипных документов
Прикрепляю пачку из [количество] однотипных документов
[тип: накладные / акты / счета-фактуры].

Обработай каждый документ отдельно:
1. Для каждого извлеки реквизиты и позиции
2. Собери все документы в одну таблицу,
   добавь колонку «Номер документа»
3. Если документы с НДС и без, раздели их
   отдельными блоками
4. Итоги по каждому документу сохрани в своей строке
5. В конце: список документов, где какие-то поля
   читаются ненадёжно

Формат: одна таблица с колонкой «Номер документа»,
затем список замечаний.
Почему это работает. Однотипные документы модель распознаёт по общей схеме и реже путает поля. Колонка «Номер документа» позволяет потом разнести результат по карточкам в учётной системе. На моей практике пачка из десяти накладных обрабатывается за один прогон, а проверка занимает столько же времени, сколько проверка одного документа. Экономия на масштабе.
Если в пачке документы разные, разбивайте по типам. Два прогона по пять накладных и три акта быстрее и точнее, чем один прогон на восемь разнородных документов. Модель не переключается между схемами и меньше ошибается в полях.
Скриншот с экрана в Excel: приём для ежедневных задач
Скриншот это второй по частоте источник таблиц, и здесь нейросеть спасает каждый день. Данные в банк-клиенте нельзя выгрузить в Excel, таблица в чужой CRM не копируется, цифры в закрытой системе нужно перенести в отчёт. Вместо перепечатывания делаете скриншот, прикрепляете в чат, получаете таблицу.
Как сделать скриншот, который распознается лучше. Выделите ровно область таблицы, без лишних панелей и окон. Чем меньше мусора в кадре, тем выше точность. На Windows это сочетание клавиш с выделением области, на macOS аналогично, можно просто обрезать полный скриншот перед загрузкой. Если таблица длинная и не влезает на экран, делайте несколько скриншотов или прокручивайте и снимайте по частям, модель потом склеит.
Промпт 4. Скриншот в Excel
Прикрепляю скриншот таблицы из [название системы, например,
банк-клиент / CRM / отчёт].

Преврати его в таблицу:
1. Извлеки все колонки и строки как в оригинале
2. Сохрани валюту, разделители тысяч и формат чисел
3. Если в скриншоте есть скрытые колонки или обрезанные
   строки, отметь это в конце
4. Итоговые строки вынеси отдельно и подпиши

Если скриншот длинный и я прислал его по частям,
склей части в одну таблицу без пропусков.

Формат: таблица, затем список замечаний.
Склейка частей это важный приём для длинных таблиц. Я специально включила его в промпт, потому что ученики часто присылают длинную выписку из банк-клиента несколькими скриншотами и просят собрать в один файл. Модель склеивает части по совпадающим колонкам и убирает дубли строк на стыках.
Когда скриншот незаменим. Когда данные в системе, из которой нет выгрузки, когда нужно перенести таблицу из вебинара или презентации, когда коллега прислал картинку с цифрами вместо файла. Вместо «перебей мне эти цифры в Excel» вы делаете скриншот, прикрепляете и через минуту отправляете готовый файл обратно.
Скриншот банк-клиента: самый частый кейс
Отдельно про банк-клиент, потому что это самый частый сценарий у финансовых директоров. Большинство банк-клиентов не дают выгрузить таблицу операций в удобном Excel: либо экспорт в формате, который открывается криво, либо выгрузка только по ограниченному периоду, либо таблица в веб-интерфейсе, которую не скопировать целиком. Раньше оставался ручной ввод, теперь есть скриншот.
Как это работает на практике. Вы открываете банк-клиент, сортируете операции за нужный период, делаете скриншот всей таблицы. Если операций много и таблица не влезает на экран, скроллите и делаете несколько скриншотов с перекрытием. Прикрепляете в ChatGPT, отправляете промпт со склейкой, получаете таблицу операций в Excel. Дальше с ней можно делать что угодно: категоризировать, свести с учётной системой, построить платёжный календарь.
Промпт 5. Выписка из банк-клиента по скриншотам
Прикрепляю скриншоты выписки из банк-клиента за период
[даты], таблица не влезла на один экран, поэтому прислана
частями с перекрытием строк.

Собери полную таблицу операций:
1. Склей части в одну таблицу, убирая дубли строк на стыках
2. Колонки: дата, контрагент, назначение платежа, приход,
   расход, остаток
3. Числа перенеси без текста, валюту отметь
4. В конце добавь итоги: приход, расход, остаток на конец
   периода
5. Проверь арифметику: остаток начала плюс приход минус
   расход должно равняться остатку конца

Формат: таблица операций, затем итоги и список расхождений,
если арифметика не сошлась.
Проверка арифметики в промпте это ключ. Остаток на конец периода в банке известен, и если склейка или распознавание ошиблись, контрольная сумма не сойдётся. Модель посчитает и покажет расхождение, а вы поймёте, где искать ошибку. На моей практике такой контроль ловит почти все проблемы со склейкой многоэкранных выписок.
После того как выписка собрана в таблицу, её удобно сразу провести через категоризацию. Про это есть отдельная статья Платёжный календарь в Telegram, а промпт категоризации я приведу в разделе про работу с распознанными данными.
PDF с таблицей в Excel: нейросеть или конвертер
PDF с таблицами это отдельная история. Тут есть два пути: обычные конвертеры PDF в Excel и нейросети. Конвертер быстрее и дешевле на простых таблицах, но ломает структуру на сложных: объединённые ячейки, многоуровневые шапки, итоги. Нейросеть понимает смысл таблицы и восстанавливает структуру. Моё правило: простой одностраничный PDF можно гнать через конвертер, сложный многостраничный реестр через нейросеть.
Когда брать конвертер. Одна страница, простая таблица, печатный текст, ровные колонки. Любой онлайн-конвертер справится за секунды, и вам не нужен аккаунт и обезличивание. Но как только в таблице появляется двухуровневая шапка, объединённые ячейки, вложенные итоги или таблица занимает пять страниц, конвертер начинает путаться.
Когда брать нейросеть. Многостраничный реестр, таблица с объединёнными ячейками, документ с несколькими таблицами на странице, сканированный PDF (это по сути фото страниц). Нейросеть собирает все таблицы со всех страниц, склеивает их по смыслу и отдаёт один файл.
Промпт 6. PDF с таблицей в Excel
Прикрепляю PDF с таблицами.

Найди в документе ВСЕ таблицы и преврати их в структурированные
данные:
1. Определи границы каждой таблицы, если их несколько
2. Для каждой таблицы извлеки шапку, колонки, строки
3. Объединённые ячейки восстанови как повторение значения
4. Итоги и промежуточные суммы вынеси отдельно
5. Если таблица переходит на несколько страниц, склей
   в одну таблицу, шапку повтори один раз
6. Пронумеруй таблицы в порядке появления в документе

В конце:
- Укажи, где структура документа была неоднозначной
- Отметь, какие цифры читаются ненадёжно
- Если документ сканированный, проверь качество распознавания

Формат: таблицы, затем список замечаний.
Сканированный PDF это тот случай, где нейросеть выигрывает у конвертера с большим отрывом. Конвертер из скана вытаскивает текст, но теряет структуру, нейросеть читает скан как изображение и восстанавливает таблицу целиком. Для бухгалтерии это спасение, потому что огромная часть архивов существует именно как сканы.
Рукописные таблицы и кривые фото: где предел
Ровный рукописный ввод цифр и коротких слов модели читают неплохо, но хуже, чем печатный. Главные проблемы это рукописные цифры, которые похожи друг на друга: четвёрка и единица, семёрка и двойка, ноль и шестёрка. На кривом фото с тенью рукописная таблица становится лотереей.
Что делать с рукописными ведомостями. Фотографируйте строго сверху, при ярком ровном свете, без бликов. В промпт добавьте требование отмечать каждый сомнительный символ. После распознавания проверяйте каждую строку, особенно цифры. Для архивов с рукописными таблицами я советую распознавать пачками и проверять по одной странице, потому что ошибка в одном числе разъезжается по всему итогу.
Промпт 7. Рукописная таблица
Прикрепляю фото рукописной таблицы (ведомость, табель, журнал).

Распознай данные, учитывая:
1. Цифры читай максимально осторожно, не угадывай
2. Каждый символ, который читается неуверенно,
   выдели в колонке «Надёжность» со значением «проверить»
3. Если два числа похожи (4 и 1, 7 и 2, 0 и 6),
   выбери то, что читается лучше, и отметь проверку
4. Не исправляй цифры по контексту, если не уверен
5. Суммы в итоговой строке пересчитай и проверь с оригиналом

Формат: таблица с колонкой «Надёжность», затем список
сомнительных значений.
Ключевое слово в этом промпте «не угадывай». Модель по умолчанию старается дать целостный ответ и может дорисовать цифру по контексту. Запрет на угадывание снижает количество красивых, но неверных чисел. Проверять всё равно нужно, но вы хотя бы знаете, куда смотреть.
Что делать с распознанной таблицей дальше
Распознанная таблица это не конечная точка, а начало работы. Когда у вас есть чистый Excel с данными, дальше его можно сразу отдавать на категоризацию, сведение, анализ или построение отчёта. Я приведу два промпта, которые превращают голую таблицу в рабочий инструмент.
Промпт 8. Категоризация распознанных операций
В таблице операции, которые я распознал из документа.

Распредели операции по статьям движения денежных средств:
1. Создай справочник статей: выручка, закупки, зарплата,
   налоги, аренда, банк, прочее
2. Каждой операции присвой статью по назначению платежа
3. Незнакомых контрагентов отнеси в «Прочее»
4. В конце сведи итоги по статьям в отдельную таблицу
5. Если назначение платежа неоднозначное, отметь
   операцию в списке на уточнение

Формат: исходная таблица с колонкой «Статья», затем
свод по статьям.
Категоризация по статьям это первый шаг к управленческому отчёту. Выписка из банка, распознанная и разнесённая по статьям, превращается в основу для отчёта о движении денежных средств. Подробно про сборку ДДС я писала в статье Финансовая модель без Excel. Когда статьи назначены, таблица готова к финальной сводке для руководителя, промпт для неё я приведу в разделе про связку с отчётами.
Проверка распознанного: как ловить ошибки нейросети
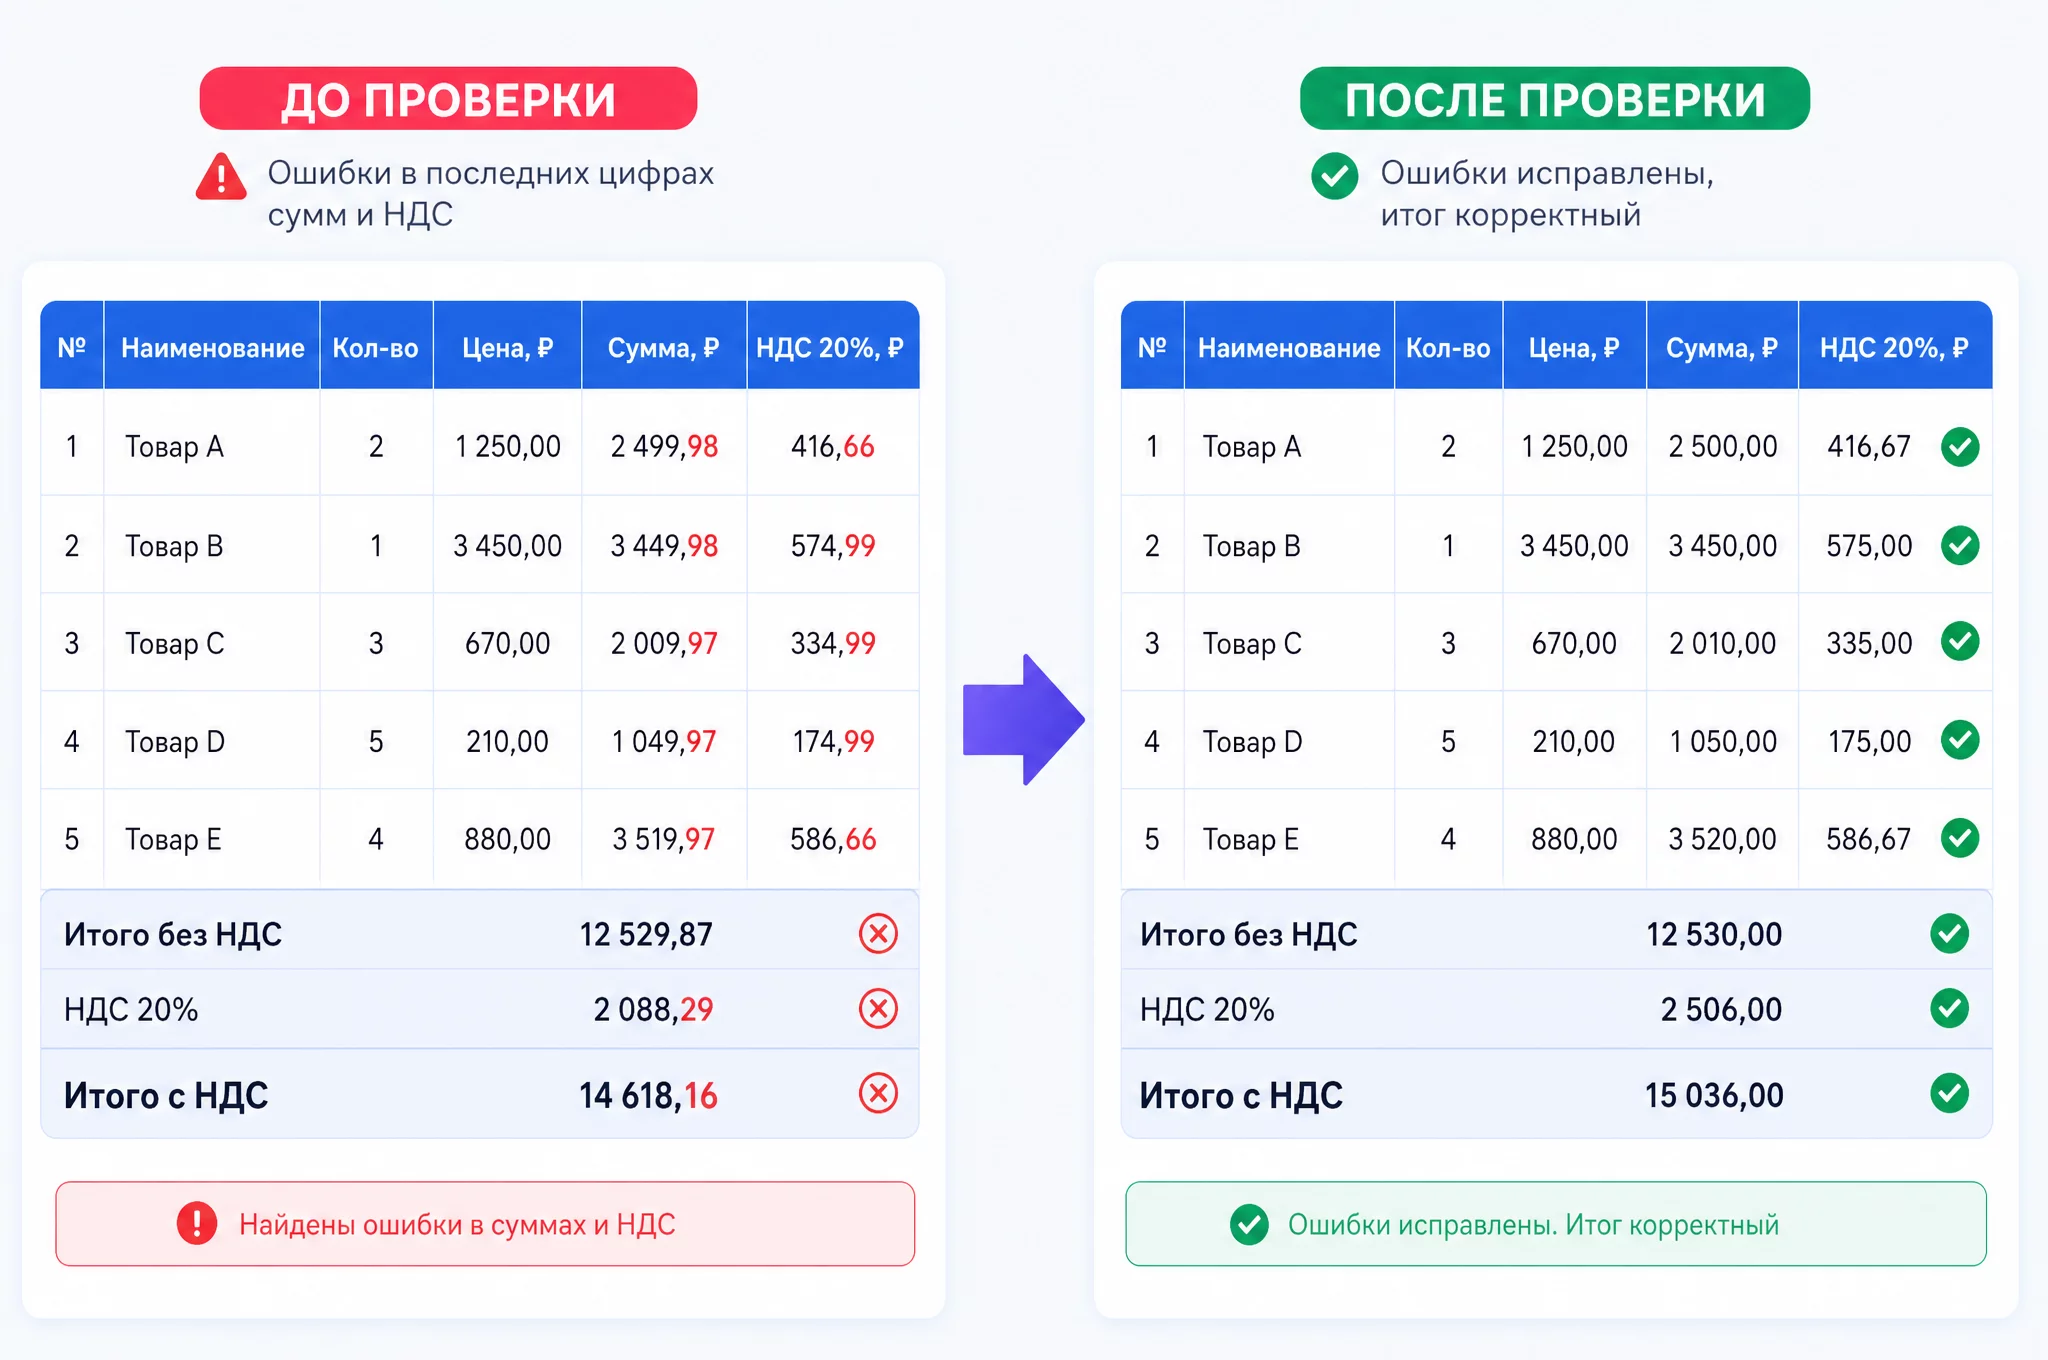
Ошибки распознавания не исчезли, они стали редкими и коварными: модель не пишет «не знаю», а ставит похожую цифру. Проверка должна идти в каждом прогоне, а не включаться по настроению. Хорошая новость: она тоже автоматизируется промптом.
Где модели ошибаются чаще всего. На моей практике и по разборам с учениками есть три зоны риска. Первая: последние цифры сумм, особенно когда на фото тень или наклон. Вторая: номера и коды, длинные последовательности цифр, которые не с чем сверить. Третья: НДС, если в документе сумма с НДС и без НДС, модель может перепутать, что куда. На ровных сканах этих ошибок почти нет, на кривых фото они появляются.
Промпт 9. Критическая проверка распознанного
Ты контрольный ревизор. Проверь распознанную таблицу
по правилам бухгалтерской сверки.

Для каждой строки проверь:
1. Суммы: совпадает ли строка с итогом по колонке
2. Логику: нет ли отрицательных значений там, где
   их быть не должно, нет ли нулей вместо данных
3. Формат: числа в числовых ячейках, даты в датах
4. Выбросы: значения, которые сильно отличаются
   от соседних и похожи на ошибку распознавания

Верни:
- Список строк с подозрениями, причину и рекомендацию
- Пересчитанные итоги, если оригинал доступен
- Общий вердикт: можно ли использовать таблицу в отчёте
Этот промпт ловит большую часть ошибок до того, как они попадут в отчёт. Модель пересчитывает итоги, ищет логические несостыковки и выбросы. Я советую прогонять его всегда перед тем, как вставить распознанную таблицу в рабочую модель или отчёт.
Дополнительная механика: считать в коде. Если в таблице много чисел, попросите модель пересчитать в коде, а не в уме. Это правило из нашей статьи Аудит формул в Excel через ChatGPT: когда модель пишет код и выполняет его, вероятность арифметической ошибки падает почти до нуля.
Промпт 10. Пересчёт в коде
Пересчитай таблицу программно, через Python:
1. Импортируй данные из распознанной таблицы
2. Проверь, что сумма колонки равна итогу в каждой строке
3. Посчитай контрольные итоги по всем колонкам
4. Найди расхождения между посчитанным и заявленным
5. Выведи список расхождений с номерами строк

Данные: [вставьте таблицу или приложите файл]
Когда модель считает в коде, она не «прикидывает», а выполняет операции над реальными значениями. Это закрывает класс ошибок, связанных с приблизительным счётом. Для финансовых таблиц я делаю это правилом по умолчанию.
Какая модель лучше для «фото в Excel»: сравнение 2026
Разберу четыре модели, которые реально используют финансисты в России в 2026 году: GPT-5.5 в ChatGPT, Claude Sonnet 4.6, Gemini 2.5 и DeepSeek V3.2. Кратко: ChatGPT база для распознавания таблиц, Claude сильнее на сложной структуре и длинных документах, Gemini удобен с Google Таблицами, DeepSeek бесплатный черновой вариант без VPN. Мои оценки по десятибалльной шкале из практики: ChatGPT 8 из 10, Claude 10 из 10, Gemini 8 из 10. Оценки отвечают на вопрос «кто точнее на сложных документах», поэтому у Claude они выше. Совет начинать с ChatGPT касается другого: простая точка входа, готовая выгрузка XLSX и память на правила. Десять баллов у Claude не отменяют того, что для ежедневной базы удобнее ChatGPT.
ChatGPT, GPT-5.5. Открываете chatgpt.com, прикрепляете фото, PDF или скриншот, получаете таблицу и выгрузку XLSX. Сильные стороны: стабильно читает шапки и итоги, умеет собирать файлы, помнит ваши правила через память. Слабые места: на кривых фото с тенями ошибается в последних цифрах, нужно проверять.
Claude Sonnet 4.6. Принимает изображения и PDF на claude.ai. Сильные стороны: лучшая точность на сложной структуре, объединённых ячейках, длинных многостраничных документах, аккуратно работает с большим объёмом текста вокруг таблицы. Слабые места: выгрузка файла в формате CSV, а не XLSX, чуть менее привычный интерфейс для новичков.
Gemini 2.5. Работает в gemini.google.com, сильная интеграция с Google Таблицами: распознанная таблица экспортируется в Sheets одним движением. Большой контекст, удобно для длинных PDF. Слабые места: на некоторых типах таблиц точность ниже, чем у Claude, и интерфейс не всегда очевиден для тех, кто привык к ChatGPT.
DeepSeek V3.2. Доступен без VPN, есть бесплатный тариф, что для России важно. Хорошо тянет простые таблицы и черновые задачи. Слабые места: ниже точность на сложной структуре, и главное, по правилам работы с публичными нейросетями в Россию грузить можно только обезличенные данные. Подробно про DeepSeek я писала в статье DeepSeek для Excel.
| Модель | Где запускать | Что принимает | Результат | Сильные стороны | Слабые места |
|---|---|---|---|---|---|
| GPT-5.5 | chatgpt.com | Фото, PDF, скриншот, XLSX | Файл XLSX | Стабильность, память, выгрузка файлов | Ошибки на кривых фото |
| Claude Sonnet 4.6 | claude.ai | Фото, PDF, скриншот | CSV | Точность на сложной структуре | CSV вместо XLSX |
| Gemini 2.5 | gemini.google.com | Фото, PDF, скриншот | Google Таблицы | Интеграция с Sheets, большой контекст | Точность чуть ниже на некоторых типах |
| DeepSeek V3.2 | chat.deepseek.com | Фото, PDF | Текст и таблица | Бесплатно, без VPN | Ниже точность, только обезличенные данные |
Почему я советую начинать с ChatGPT. Три причины. Первая: единая точка входа, фото, PDF, скриншот и выгрузка XLSX в одном месте. Вторая: память, которая запоминает ваши правила форматирования. Третья: крупнейшая база обучающих материалов, в том числе наш бесплатный курс. Если вы работаете в Google Таблицах, присмотритесь к Gemini. Если у вас сложные многостраничные документы с объединёнными ячейками, попробуйте Claude. Общий совет по выбору модели я собрала в статье Какую нейросеть выбрать финансисту в 2026.
Как я тестировала модели на распознавании таблиц
Чтобы рекомендации были честными, а не из рекламных проспектов, я регулярно прогоняю модели на одинаковых таблицах из практики школы. Расскажу про один такой тест: набор из 12 документов, среди которых ровные сканы накладных, кривые фото с тенями, скриншоты из банк-клиента и один рукописный табель. Задача одинаковая: превратить каждый документ в таблицу с сохранением структуры и итогов.
Что показал тест. На ровных сканах и скриншотах все три флагманские модели GPT-5.5, Claude Sonnet 4.6 и Gemini 2.5 показали высокую точность: ошибки единичные, в основном в последних цифрах сумм и в номерах. На кривых фото с тенями ошибок стало больше, и тут разница между моделями проявилась сильнее: все три модели ошиблись примерно в одном документе из набора, это был самый неудачный снимок с тенью. На рукописном табеле точность упала у всех, но модель с запретом на угадывание из промпта 7 честно отметила сомнительные значения вместо того, чтобы подставить правдоподобные.
Что я вынесла из теста. Первое: качество фото влияет на результат сильнее, чем выбор между флагманскими моделями. Ровный скан распознают все, кривое фото не спасает ни одна модель. Второе: промпт важнее модели. Та же модель с промптом, требующим отмечать ненадёжные поля, даёт более честный результат, чем без него. Третье: для сложных документов лучше пара прогонов, один на распознавание, второй на проверку, чем один прогон с надеждой на чудо.
Эти выводы я встроила в промпты этой статьи: везде требование отмечать ненадёжные поля, отдельный промпт критической проверки и пересчёт в коде. Слепой тест на живых документах я описывала и в других разборах, например в статье Честный тест: финансист против нейросети, там больше про границы возможностей моделей.
Распознанная таблица в отчёте: связка с другими инструментами
Распознавание редко бывает самоцелью. Обычно это первый шаг конвейера: фото превратилось в таблицу, таблица поедет в учётную систему, в отчёт, в финансовую модель или в сводку для собственника. Поэтому расскажу, как встроить распознавание в существующие процессы, а не держать его отдельным трюком.
Связка с учётной системой. Распознанную таблицу из накладных можно передавать в модуль проводок, о котором я подробно писала в статье Своя AI-бухгалтерия. Схема простая: распознавание даёт структурированные данные, проводки применяют к ним правила учётной политики, отчёты собирают результат. Каждый модуль закрывается своим промптом, и между ними не нужно перепечатывать.
Связка с Google Таблицами и Excel. Если вы работаете в Google Таблицах, Gemini экспортирует распознанный результат сразу в Sheets. Если в Excel, ChatGPT отдаёт XLSX, и дальше файл живёт обычной жизнью: сводные, формулы, диаграммы. Про то, как заставить нейросеть работать с самими таблицами, я писала в статье ChatGPT читает ваш Excel: распознанную таблицу можно сразу спросить «где выросли расходы» или «какая строка не сходится», не открывая Excel.
Связка с Power BI и отчётностью. Распознанная таблица в Excel это готовый источник данных для Power BI или сводки. Вместо ручного ввода в дашборд вы прикрепляете фото, получаете таблицу, и она подхватывается в модель. Для финансового директора это снимает главную боль еженедельных отчётов: данные из закрытых систем, которые нельзя выгрузить, теперь попадают в аналитику за минуты.
Промпт 11. Превращение распознанной таблицы в отчёт для собственника
По распознанной таблице собери отчёт для собственника:
1. Назови отчёт по смыслу данных
2. Дай краткую выжимку: главные цифры периода
3. Сравни с планом или прошлым периодом, если есть
4. Выдели три вещи, которые требуют решения
5. Напиши простым языком, без канцелярита

Формат: заголовок, выжимка на 5-7 строк, три вопроса
собственнику.
Этот промпт закрывает классическую задачу финдира: собственник просит «расскажи, что в таблице». Вместо вечера в Excel вы получаете структурированный ответ за несколько минут. Модель сама находит главные изменения и формулирует вопросы, которые стоит задать команде. Я использую такие сводки перед каждой встречей с собственником, это экономит мне часы подготовки.
Связка с памятью и постоянными правилами. Когда распознавание работает стабильно, сохраните правила в память ChatGPT: как называть файлы, какие форматы чисел использовать, как выделять итоги. Тогда каждый новый документ распознаётся по вашим стандартам без повторного объяснения. Подробно про настройку памяти я писала в статье ChatGPT Memory для финансиста, а про сборку целых процессов в RAG для бухгалтерии.
Три кейса: сколько экономит распознавание таблиц
Цифры убеждают лучше слов, поэтому приведу три кейса из практики школы. Имена и реквизиты изменены, суммы округлены, но механика и порядок цифр реальные. Во всех трёх случаях распознавание таблиц нейросетью заменило ручной ввод.
Кейс 1. Бухгалтер ООО на ОСНО, ввод накладных
Было. Бухгалтер вручную вносила в учётную систему бумажные накладные и акты, примерно 40-50 документов в месяц. Каждый документ занимал 20-30 минут: проверить, набрать, сверить. В месяц на ввод уходило около 20 часов, в пиковые дни после закрытия периода почти полные рабочие дни.
Что сделали. Настроили промпт распознавания из этой статьи, добавили правило проверки итогов и сохранения в память ChatGPT. Документы стали фотографировать ровно сверху при дневном свете, пачками по 5-10 штук.
Стало. Один документ распознаётся за 1-2 минуты, проверка итогов занимает ещё минуту, то есть около 3-4 минут на документ вместе с фотографированием и отправкой. На пачку из десяти документов уходит около получаса вместо пяти часов. Экономия примерно 17 часов в месяц, это больше двух рабочих дней, которые бухгалтер вернула на закрытие периода и разбор расхождений с контрагентами.
Кейс 2. Финансовый директор, скриншот из банк-клиента
Было. Финдир компании на УСН ежемесячно переносил обороты из банк-клиента в управленческий отчёт. Выгрузки в нужном формате в системе не было, поэтому таблица из личного кабинета перепечатывалась руками. На это уходило 40-60 минут.
Что сделали. Вместо перепечатывания финдир делает скриншот длинной выписки в три-четыре части и отправляет в ChatGPT с промптом склейки из этой статьи. Модель собирает выписку в одну таблицу, пересчитывает итоги в коде и выгружает XLSX.
Стало. Вся операция занимает 3-4 минуты, из которых основное время это проверка совпадения итогов с банком. Ускорение примерно в 12-15 раз. Месяц стал закрываться за вечер вместо двух дней, а финдир перестал ненавидеть выписки.
Кейс 3. Главбух, архив за пять лет
Было. Главбух небольшой компании получила задачу оцифровать архив ведомостей за пять лет для перехода в новую учётную систему. В архиве около 1200 страниц бумажных таблиц, в основном печатных, часть с рукописными пометками. Привлечённый оператор оценил работу в два месяца и около 60 000 рублей.
Что сделали. Главбух прошла наш курс «AI-навыки финансиста» и собрала конвейер: фотографировала страницы по вечерам, распознавала пачками промптом из этой статьи, проверяла итоги. Сложные рукописные страницы разбирала отдельно промптом с колонкой «Надёжность».
Стало. Архив оцифрован за три недели по вечерам, без привлечения оператора. Из 1200 страниц около 90 процентов распознались без правок, остальные потребовали ручной проверки сомнительных значений. Экономия составила около 45 000 рублей на подрядчике, плюс главбух получила готовый массив данных для новой системы, а не поток файлов от оператора, который всё равно пришлось бы проверять.
Общий вывод из кейсов. Распознавание таблиц окупается с первого месяца. На операциях с таблицами экономия от 4 до 15 часов в неделю, а разовая оцифровка архива экономит десятки тысяч рублей. Подробнее про экономику нейросетей в финансах я писала в статье Сколько стоит AI-бухгалтер.
Безопасность: что можно грузить в нейросеть
Любой разговор о загрузке документов в нейросеть упирается в вопрос безопасности. Правило короткое: в публичные тарифы ChatGPT, Claude, Gemini и DeepSeek грузить можно только обезличенные данные. Заменить ИНН, названия компаний, ФИО и номера счетов масками. Суммы можно оставить, при необходимости округлить. Документы под NDA, банковскую тайну и персональные данные в публичные тарифы не грузить.
Почему обезличивание, а не запрет. Финансовые данные почти всегда содержат реквизиты, но сама структура таблицы, суммы и форматы это не секрет. Если вы убрали идентифицирующие признаки, остаётся обезличенный массив чисел, который можно обрабатывать. Для большинства задач этого достаточно: распознавание не требует знать название компании, ему нужна структура таблицы.
Как обезличить быстро. Модель может сделать это за вас, до распознавания.
Промпт 12. Обезличивание перед загрузкой
Я собираюсь отправить документ в нейросеть и хочу обезличить данные.

Прикрепляю файл. Замени:
1. Названия компаний на ООО А, ООО Б
2. ИНН, КПП, ОГРН на маски вида 77ХХХХХХХХ
3. ФИО на Иванов И. И.
4. Номера счетов и договоров на Н-1, Н-2
5. Адреса и телефоны на черновик без цифр

Суммы, даты и структуру таблицы НЕ меняй.
Верни обезличенную версию целиком.
Обезличенный документ можно нести в любую модель, включая DeepSeek. Подробно про безопасность загрузки данных я писала в статье Обезличивание данных для ChatGPT, там больше про границы и корпоративные сценарии.
Ещё два правила. Первое: в платных тарифах отключите обучение модели на ваших данных, это делается в настройках аккаунта. Второе: для документов, которые нельзя обезличить, есть корпоративные тарифы с гарантиями обработки и локальные модели, которые работают на вашем компьютере без отправки данных наружу. Про локальные модели я писала в статье Локальная нейросеть Ollama.
Пять ошибок новичков при переводе таблиц в Excel
За два года я видела одни и те же грабли у учеников. Собрала пять самых частых ошибок, чтобы вы их обошли.
Ошибка 1. Фотографировать под углом с тенью. Кривое фото с тенью от рук даёт десятки ошибок распознавания. Исправление простое: кладите документ на ровную поверхность, снимайте сверху, включайте яркий свет. Качество фото определяет точность сильнее, чем модель.
Ошибка 2. Не проверять итоги. Модель на ровном скане ошибается редко, но когда ошибается, ошибка попадает прямо в отчёт. Промпт критической проверки и сверка итогов с оригиналом занимают две минуты и закрывают почти все риски.
Ошибка 3. Грузить чувствительные данные как есть. ИНН, ФИО и банковские реквизиты в чистом виде уходят в публичную модель. Пять минут на обезличивание промптом из этой статьи убирают проблему.
Ошибка 4. Просить модель считать в уме. На больших таблицах модель может ошибиться в суммировании. Правило: все арифметические проверки через код, тогда вероятность ошибки падает почти до нуля.
Ошибка 5. Бросать после первого неудачного распознавания. Кривой скан распознался с ошибками, и человек делает вывод «нейросеть не работает». На деле нужно переснять документ, добавить промпт про ненадёжные поля и проверить. Разница между «не работает» и «работает с проверкой» это одна минута настройки.
Распознавание против ручного ввода: считаем честно
Давайте посчитаем, что реально экономит распознавание таблиц, без маркетинга. Возьмём типовую операцию: бумажная накладная с 15-20 позициями, которую нужно перенести в учётную систему. Руками опытный бухгалтер набирает такую за 20-30 минут, включая сверку. Через нейросеть это 2-4 минуты: фото, промпт, проверка итогов, вставка. Разница в 6-10 раз.
Если в месяце 50 таких накладных, руками выходит около 20 часов чистого ввода. Через нейросеть около 3 часов вместе с проверкой. Экономия 17 часов в месяц только на одной операции. Добавьте сюда скриншоты из банк-клиента, реестры в PDF, ведомости к зарплате, и общая экономия выходит в диапазон 4-15 часов в неделю, это та же вилка, которая проходит через все кейсы статьи.
В деньгах это считать сложнее, потому что время бухгалтера стоит по-разному. Но вот ориентир. Если средняя ставка специалиста 1500-2500 рублей в час, то 15 сэкономленных часов в неделю это 90 000-150 000 рублей в месяц потенциального времени команды. Подписка на ChatGPT стоит около 20 долларов в месяц. Простая арифметика объясняет, почему распознавание таблиц окупается с первого дня.
Важная оговорка про честность. Экономия времени не означает, что можно уволить половину бухгалтерии. Освободившееся время уходит на проверку, разбор расхождений и задачи, которые нейросеть не умеет: суждение, переговоры, объяснение цифр собственнику. На моей практике распознавание забирает самый скучный кусок работы, и те, кто перестаёт набирать таблицы руками, начинают приносить больше пользы в аналитике и контроле.
Где нейросеть не поможет
Честно про границы, чтобы не было ложных ожиданий. Нейросеть не поможет в трёх случаях.
Первый: сильно повреждённые документы. Если бумага мятая, выцветшая, залитая, с наложениями и посторонними пометками, распознавание превращается в угадывание. Такой документ лучше переснять или ввести руками.
Второй: таблицы с точной цветовой кодировкой, которую нужно перенести. Если смысл данных в цвете ячеек, шрифте или условном форматировании, нейросеть может не сохранить это в файле. Уточняйте в промпте, что цвет важно, но готовьтесь дорисовывать вручную.
Третий: документы, где критична юридическая точность. Распознанный договор или банковский реестр, который идёт в суд или в налоговую, нельзя использовать без сверки с оригиналом. Нейросеть это ускоритель черновика, а не замена юридической проверки.
Куда идти в этих случаях. Для повреждённых документов лучше качественный скан и ручной ввод по ключевым полям. Для юридически значимых документов остаётся человек. Нейросеть закрывает массовую рутину, где цена ошибки низкая и есть возможность проверки. Про границы использования нейросетей в отчётности я подробно писала в статье Галлюцинации нейросетей в финансовых данных.
Частые вопросы о переводе таблиц в Excel
Собрала вопросы, которые чаще всего задают на эфирах и в каналах школы. Короткие ответы, с цифрами.
Как перевести фото таблицы в Excel с помощью нейросети?
Прикрепите фото таблицы в ChatGPT, Claude или Gemini, отправьте промпт с инструкцией извлечь структуру, и модель вернёт таблицу с колонками, строками и суммами. В ChatGPT результат можно выгрузить в XLSX, в Claude в CSV, в Gemini в Google Таблицы. Обычно занимает 1-3 минуты.
Какая нейросеть лучше всего распознаёт таблицы с фото?
База это GPT-5.5 в ChatGPT: стабильно читает шапки, объединённые ячейки и итоги, отдаёт готовый XLSX. Claude Sonnet 4.6 сильнее на сложной структуре и длинных документах. Gemini 2.5 удобен, если работаете в Google Таблицах. DeepSeek V3.2 бесплатный вариант для черновых задач с обезличенными данными.
Можно ли распознать таблицу из PDF бесплатно?
Да. В бесплатных версиях ChatGPT, Claude и Gemini можно прикреплять PDF, но с лимитами по количеству и размеру файлов. DeepSeek V3.2 доступен без VPN и подходит для простых таблиц. Для регулярной работы с большими PDF удобнее платные тарифы, примерно 20 долларов в месяц на момент написания.
Что делать, если нейросеть ошиблась в цифрах при распознавании?
Включите в промпт требование указывать ненадёжные поля, просите считать в коде, а не в уме, и после распознавания прогоняйте критическую проверку. Ошибки чаще всего в последней цифре суммы, номерах и НДС на кривых фото.
Нейросеть распознаёт рукописные таблицы?
Частично. Ровный рукописный ввод цифр и коротких слов модели читают неплохо, но точность ниже, чем с печатным. Проверяйте каждую строку, а в промпт добавляйте запрет на угадывание.
Безопасно ли загружать таблицы с данными компании в нейросеть?
Только после обезличивания: замените ИНН, названия компаний, ФИО и номера счетов на маски. В платных тарифах отключите обучение модели на ваших данных. Документы под NDA в публичные тарифы не грузить.
Чем распознавание нейросетью лучше обычного OCR?
OCR читает символы, но ломает структуру на сложных таблицах. Нейросеть понимает смысл таблицы: восстанавливает объединённые ячейки, многоуровневые шапки, переносит итоги и отвечает на вопросы по данным. Конвертеры быстрее на простых таблицах, нейросеть сильнее там, где структура сложная.
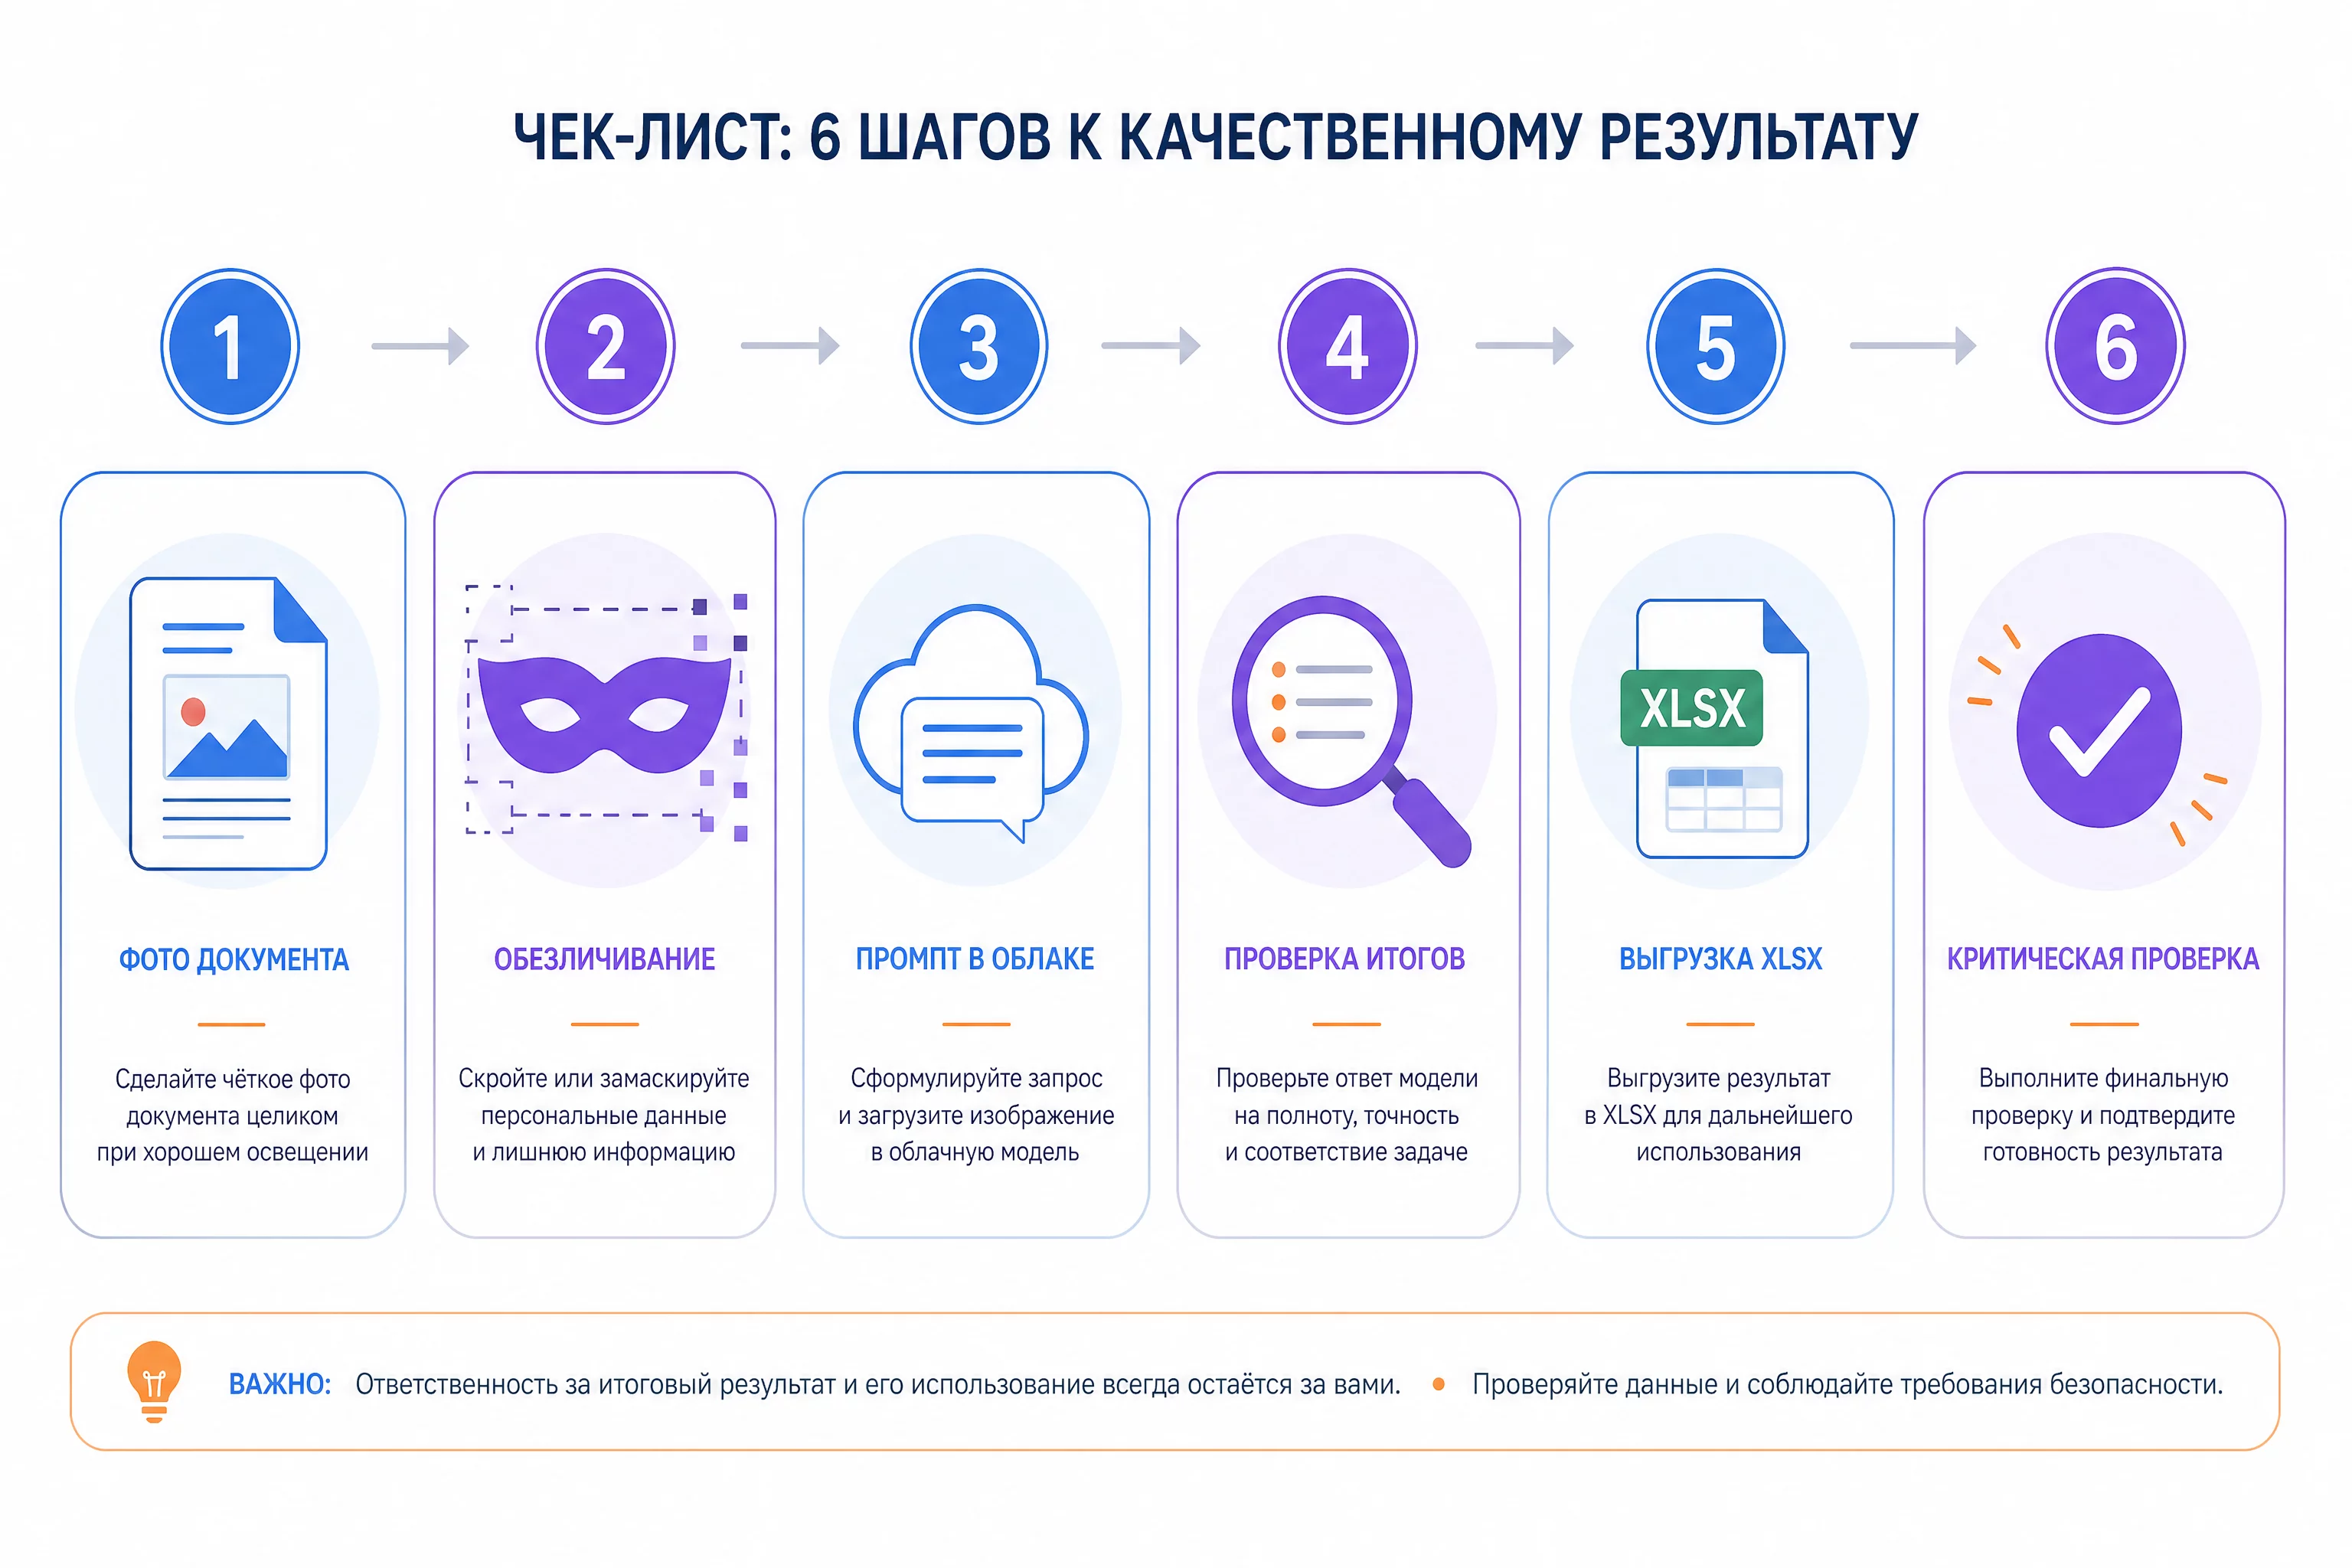
Чек-лист: фото таблицы в Excel за 15 минут
Собрала последовательность действий, которая закрывает любую таблицу за 15 минут. Первые три шага это подготовка, дальше распознавание, проверка и выгрузка.
Шаг 1. Подготовьте фото или файл. Положите документ ровно, фотографируйте сверху при дневном свете без вспышки и теней. Для бумаги уберите пометки карандашом, для PDF проверьте, что страницы не перевёрнуты.
Шаг 2. Обезличьте данные. Замените ИНН, названия компаний, ФИО и номера счетов масками вида ООО А или ИНН 77Х. Суммы можно оставить, при необходимости округлить.
Шаг 3. Прикрепите файл и отправьте промпт распознавания. Откройте ChatGPT или другую модель, прикрепите фото или PDF, отправьте промпт из статьи с требованием извлечь структуру и отметить ненадёжные поля.
Шаг 4. Проверьте итоги и ненадёжные поля. Сверьте итоговые суммы с оригиналом. Посмотрите, какие поля модель отметила как ненадёжные, и проверьте их глазами по картинке.
Шаг 5. Выгрузите результат в Excel. Попросите модель подготовить файл XLSX или CSV. В ChatGPT доступна выгрузка файла, в Claude CSV, в Gemini экспорт в Google Таблицы.
Шаг 6. Прогоните критическую проверку. Верните таблицу модели с промптом проверки: пусть сверит итоги, найдёт пустые ячейки и выбросы. Это ловит большинство ошибок до того, как они попадут в отчёт.
Итоги: что меняется в работе финансиста
Распознавание таблиц это базовый навык финансиста 2026 года, в одну строку с умением работать в Excel. Фото бумажной накладной в Excel за минуты, скриншот из банк-клиента в управленческий отчёт без перепечатывания, архив за пять лет за три недели по вечерам. Всё это уже работает, и работает без покупки дорогих сервисов, на обычной подписке ChatGPT.
Главное правило, которое я повторяю ученикам: нейросеть не решает за вас, она выполняет ваши инструкции и ускоряет рутину. Чем лучше промпт, чем честнее модель отмечает ненадёжные поля, чем строже проверка, тем надёжнее результат. Официальная отчётность и ответственность остаются за человеком, а ввод и распознавание уходят нейросети.
Что будет дальше. Через год-два ручной ввод таблиц будет выглядеть так же странно, как набор текста на пишущей машинке. Модели продолжат улучшать распознавание структуры, а вместе с ним и автоматизацию целых процессов: распознанная таблица сразу пойдёт в проводки, сводку и отчёт. Бухгалтер, который умеет настраивать и проверять этот конвейер, будет стоить дороже, чем тот, кто конкурирует с нейросетью в скорости набора. Уже сейчас по карьерам 800+ выпускников курса видно расслоение на два трека: углубление экспертизы у тех, кто берёт AI в инструменты, и стагнация у тех, кто делает вид, что ничего не меняется.
Начните с одного документа. Возьмите ближайшую бумажную таблицу, сфотографируйте ровно сверху, отправьте промпт из этой статьи и посмотрите, что получится. Первый результат займёт 15 минут, а дальше процесс станет привычкой, которая экономит часы каждую неделю.
Для тех, кто хочет не просто распознавать таблицы, а выстроить системную работу с нейросетями во всех задачах финансиста, есть курс «AI-навыки финансиста». За полтора года через него прошли 800+ выпускников, которые применяют нейросети в ежедневной работе осознанно: распознавание первички, проводки, отчёты, финансовые модели, анализ договоров. Диплом с лицензией и налоговый вычет 13 процентов в подарок.
Где следить за AI для финансистов: три канала школы
Нейросети обновляются быстро, новые модели выходят каждые несколько месяцев, и то, что работало вчера, сегодня уже можно ускорить. Чтобы оставаться в курсе без лишнего шума, подпишитесь на каналы школы:
@findir_pro. Основной Telegram-канал «Финансовый директор | Мастер CFO». 45 000 подписчиков. Ежедневно: практические разборы, кейсы выпускников, обновления инструментов, новые промпты для финансистов и бухгалтеров.
«АИ с Софьей и Натали». Канал об AI для финансистов. 13 000 подписчиков. Вместе с Софьей Бурцевой, основателем школы, разбираем новые модели, делаем живые тесты и публикуем обновлённые промпты сразу после выхода новых версий.
MAX. Закрытое сообщество для действующих финансовых директоров. 5 000+ участников. Кейсы коллег, шаблоны, закрытые эфиры по AI и стратегии CFO.