AI для финансиста
Грязные выгрузки из 1С, банка и CRM: ChatGPT чистит данные в Excel, дубли, форматы и справочники за 10 минут

Выгрузка из 1С: суммы текстом из-за пробелов в тысячах, даты вперемешку двух форматов, 40 строк дублей по одному контрагенту. Выгрузка из банка: назначения платежей с лишними пробелами и разным регистром, а справочник контрагентов в CRM записан иначе, чем в бухгалтерии. Пока это почистишь руками, пройдёт 2-3 часа, а в отчёт всё равно попадут кривые строки. ChatGPT через Code Interpreter чистит ту же выгрузку за 10-15 минут: код на Python нормализует форматы, убирает дубли и склеивает справочники, а вы только проверяете контрольные суммы.
Я Натали Васильева, эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO» (основатель школы Софья Бурцева, 45 000 подписчиков в @findir_pro, 800+ выпускников курса AI-навыков). В этой статье разбираю общий случай: как почистить грязную выгрузку из 1С, банка и CRM через ChatGPT за 10 минут. Даю пошаговый алгоритм, 10 готовых промптов, три кейса с цифрами, сравнительную таблицу инструментов и правила безопасности. Актуально на 1 сентября 2026 года, все примеры проверены на текущих версиях моделей.
Ключевые выводы
- ChatGPT Plus с Code Interpreter чистит выгрузку из 1С, банка или CRM за 10-15 минут: нормализует форматы, превращает текстовые суммы в числа, убирает дубли и склеивает справочники кодом на pandas, без ручного Excel.
- Семь типовых дефектов выгрузок закрываются готовыми промптами: суммы текстом, разные форматы дат, лишние пробелы, дубли, объединённые ячейки, шапки и строки Итого, кривые названия контрагентов.
- Главный приём: сначала диагностика файла, потом чистка, потом контрольные суммы. Если итог до чистки и после не сходится, где-то потерялись строки.
- Справочники чинятся через нечёткое сопоставление: ООО РОМАШКА и Ромашка ООО связываются по похожести, пары ниже порога выносятся на решение человека.
- Дубли находятся не только точные, но и разбитые платежи, и повторы в пределах 3 дней. Код первой чистки переиспользуется каждый месяц.
- Реквизиты обезличиваются до загрузки в ChatGPT, в настройках отключается Improve model for everyone, для данных под NDA локальная модель.
- В 2026 году GPT-5.5, Claude Sonnet 4.6 и Gemini 2.5 сравнялись по качеству в рутинной чистке данных. Выбор модели вторичен, важнее постановка задачи.
Почему выгрузки из 1С, банка и CRM всегда «грязные» и сколько стоит ручная чистка
Прямой ответ: выгрузки делаются для людей, а не для расчётов. Система показывает данные в удобном для чтения виде, с форматированием, и именно это ломает машинную обработку.
В опросе учениц моего курса по AI-навыкам почти 200 человек назвали подготовку выгрузок к работе самой нудной частью закрытия месяца. Средняя оценка потери времени: от двух часов до полного рабочего дня в месяц только на ручную чистку. Разберу, из чего складывается это время.
Первое, на что уходит время, это форматы чисел. Выгрузка из 1С часто отдаёт суммы с неразрывным пробелом как разделителем тысяч: 1 234 567,89. Excel и Python в этой записи видят текст, а не число. Чтобы превратить такие суммы в числовые, нужны замена символов, перепроверка каждой колонки и контроль, что ничего не потерялось. На таблицу в 5 000 строк это 40-60 минут.
Второе, это даты. В одной выгрузке дата записана как 01.09.2026, в другой как 01/09/2026, в третьей текстом «1 сентября 2026». Сортировка по дате, выборка за период и сверка с другими системами на таких данных дают ошибки, которые не видны сразу.
Третье, это дубли. Один и тот же платёж может попасть в выгрузку дважды: банк отдал реестр с повтором, оператор вбил документ дважды, CRM склеила заказы с возвратами. Ручной поиск дублей на больших таблицах через условное форматирование ненадёжен, часть повторов уезжает в отчёт.
Четвёртое, это справочники. Контрагент в бухгалтерии записан как ООО РОМАШКА, в CRM как Ромашка ООО, в банке как ООО «Ромашка». Сводная аналитика по таким названиям считает одного поставщика за трёх. Склейка справочника руками это часы работы и вечный компромисс между точностью и временем.
И пятое, это структура самого файла: шапки на несколько строк, объединённые ячейки, строки Итого в конце каждого периода, пустые колонки. Python читает такие файлы как есть, и строка Итого становится транзакцией, которая потом не находит пары в сводках.
Сравню ручную чистку и чистку через ChatGPT на одной выгрузке из банка на 4 500 строк. Цифры средние по моим разборам, но порядок именно такой.
| Этап | Вручную в Excel | ChatGPT с Code Interpreter |
|---|---|---|
| Диагностика дефектов | Глазами, часть пропускается | Промпт за минуту, полный список |
| Приведение сумм к числам | Замена символов, 40-60 минут | Автоматически, одна строка в промпте |
| Единый формат дат | Функции и протягивание | Автоматически |
| Поиск дублей | Условное форматирование, выборочно | Три типа дублей, с суммами |
| Склейка справочника | Вручную, часами | Нечёткое сопоставление, спорные пары отдельно |
| Контроль итогов | Ручная выборка | Контрольные суммы по колонкам |
| Итого | 2-4 часа | 10-15 минут |
Сколько это стоит в деньгах. Если финдир на окладе 250 000 рублей в месяц тратит на чистку выгрузок 6-8 часов, это примерно 18-24 тысячи рублей в месяц только на подготовку данных. А цена ошибки выше: задвоенный платёж на 300 000 рублей, контрагент, раздроблённый на три имени в аналитике, отчёт собственнику с кривыми суммами. Один вовремя найденный дубль покрывает сотню часов ручной работы.
Что такое чистка данных через ChatGPT и где она нужна
Чистка данных через ChatGPT это процесс, в котором нейросеть через Code Interpreter читает ваш файл, находит дефекты и исправляет их кодом на Python: нормализует форматы, убирает дубли, склеивает справочники и отдаёт чистую таблицу обратно.
Ключевое отличие от ручной работы: вы не совершаете каждое действие руками, а описываете правила словами, а модель превращает их в код, который выполняется одинаково для всех строк. Это снимает главную проблему человека, усталость и пропуски к третьему часу работы.
В работе финансиста чистка нужна везде, где данные приходят извне или из разных систем. Вот типовые сценарии.
Подготовка выгрузки из 1С к анализу. Оборотно-сальдовая ведомость, карточка счёта, реестр документов, справочник контрагентов после обновления конфигурации. Любая выгрузка перед загрузкой в модель расчётов требует нормализации.
Подготовка банковской выписки к сверке. Выгрузка из интернет-банка, реестр платежей, выписка по зарплатному проекту. Назначения платежей с лишними пробелами и разным регистром, дубли операций, суммы текстом.
Очистка данных из CRM для управленческого учёта. Экспорт сделок, заказов, клиентов. Неконсистентные названия, пропуски, дубли карточек, разные форматы телефонов и дат.
Склейка справочников из разных систем. Один и тот же контрагент по-разному записан в 1С, CRM и банке. Сводная аналитика по продажам и закупкам требует единого справочника.
Миграция данных. Переезд на новую конфигурацию 1С, смена CRM, объединение баз после покупки компании. Чистка и дедупликация перед загрузкой в новую систему экономит месяцы проблем в будущем.
Мой личный критерий простой: если задача сводится к перебору строк и однотипным заменам и занимает больше 15 минут, я загружаю файл в ChatGPT. Чистка данных это механическая работа, а человек нужен там, где принимается решение: как склеить контрагентов, какой дубль удалить, что делать со спорной строкой.
В 2026 году делать это руками уже странно. Флагманские модели, GPT-5.5 в ChatGPT и Claude Sonnet 4.6 в Claude, уверенно пишут код нормализации, а бюджетные модели вплотную подошли к ним по качеству. Разрыв между дорогими и дешёвыми моделями сократился настолько, что выбор конкретной модели стал вторичным, важнее постановка задачи. Про выбор бесплатных нейросетей для Excel я разбирала в отдельной статье.
Семь типовых дефектов выгрузок: таблица-диагноз
Собрала самые частые дефекты в таблицу. Если узнали свою выгрузку, сразу смотрите нужный промпт из раздела ниже.
| Дефект | Как выглядит | Чем опасен | Промпт из статьи |
|---|---|---|---|
| Суммы текстом | 1 234 567,89 с пробелом как разделителем тысяч | Не считается в формулах и сводных | Промпт 5 |
| Разные форматы дат | 01.09.2026, 01/09/2026, «1 сентября» | Ошибки в выборках и сверках | Промпт 6 |
| Лишние пробелы и регистр | «ООО Ромашка», «ромашка», «РОМАШКА» | Дубли и раздробленная аналитика | Промпт 2 |
| Дубли строк | Один платёж дважды в реестре | Задвоенные суммы в отчётах | Промпт 3 |
| Объединённые ячейки и шапки | Шапка на 3 строки, объединения в колонках | Python читает мусор как данные | Промпт 7 |
| Строки Итого внутри данных | Итого по периоду в конце блока | Итог читается как транзакция | Промпт 2 |
| Кривые названия контрагентов | ООО РОМАШКА, Ромашка ООО, ООО «Ромашка» | Один поставщик становится тремя | Промпт 4 |
Для каждой строки этой таблицы есть готовый промпт ниже. Чаще всего дефекты приходят не по одному, а пачкой, поэтому сначала диагностика, потом чистка.
Что умеет ChatGPT при чистке данных и чего не умеет
ChatGPT Plus на GPT-5.5 открывает Code Interpreter, инструмент, который пишет и выполняет Python-код прямо в чате. Для чистки данных это главный инструмент: он читает файлы, находит дефекты и исправляет их без вашего участия в коде.
Что Code Interpreter умеет с грязной выгрузкой:
- Читать Excel и CSV, показывать структуру: колонки, типы данных, первые строки
- Диагностировать дефекты: текстовые суммы, разные форматы дат, пробелы, дубли, пустые ячейки
- Нормализовать данные: убрать пробелы, выровнять регистр, очистить текстовые числа
- Привести даты к единому формату по вашему правилу
- Найти дубли трёх типов: точные, в пределах 3 дней, разбитые платежи
- Склеить справочник нечётким сопоставлением названий
- Разобрать объединённые ячейки и многоуровневые шапки
- Сохранить очищенную таблицу как Excel и скачать
- Показать отчёт о чистке: что изменено, сколько удалено, контрольные суммы
Чего он не умеет: подключаться к 1С напрямую, сам знать ваши правила учёта и принимать решение, какой дубль удалять, а какой оставить. Это всегда работа эксперта.
ChatGPT Plus принимает файлы до 512 МБ. Для выгрузок до 100-150 тысяч строк этого с запасом. Если таблицы больше, разбивайте на периоды или агрегируйте в исходной системе.
Как это выглядит изнутри. Вы загружаете файл, ChatGPT определяет структуру, вы описываете дефекты и правила. Дальше модель пишет код на Python с библиотекой pandas: чтение, приведение типов, чистка колонок, поиск дублей, нормализация названий, подсчёт итогов. Вы этот код не пишете и чаще всего не читаете, но можете попросить показать его и проверить ключевые шаги. Это же важный момент для доверия: вся работа прозрачна, вы видите, по какому правилу удалены строки и склеены названия.
Отдельно про текст. Код, который пишет ChatGPT, выполняет одно и то же действие для всех строк одинаково. Человек к третьему часу начинает пропускать, код не пропускает. Ошибка возможна в логике промпта, а не в арифметике.
Как ChatGPT чистит данные: алгоритм изнутри
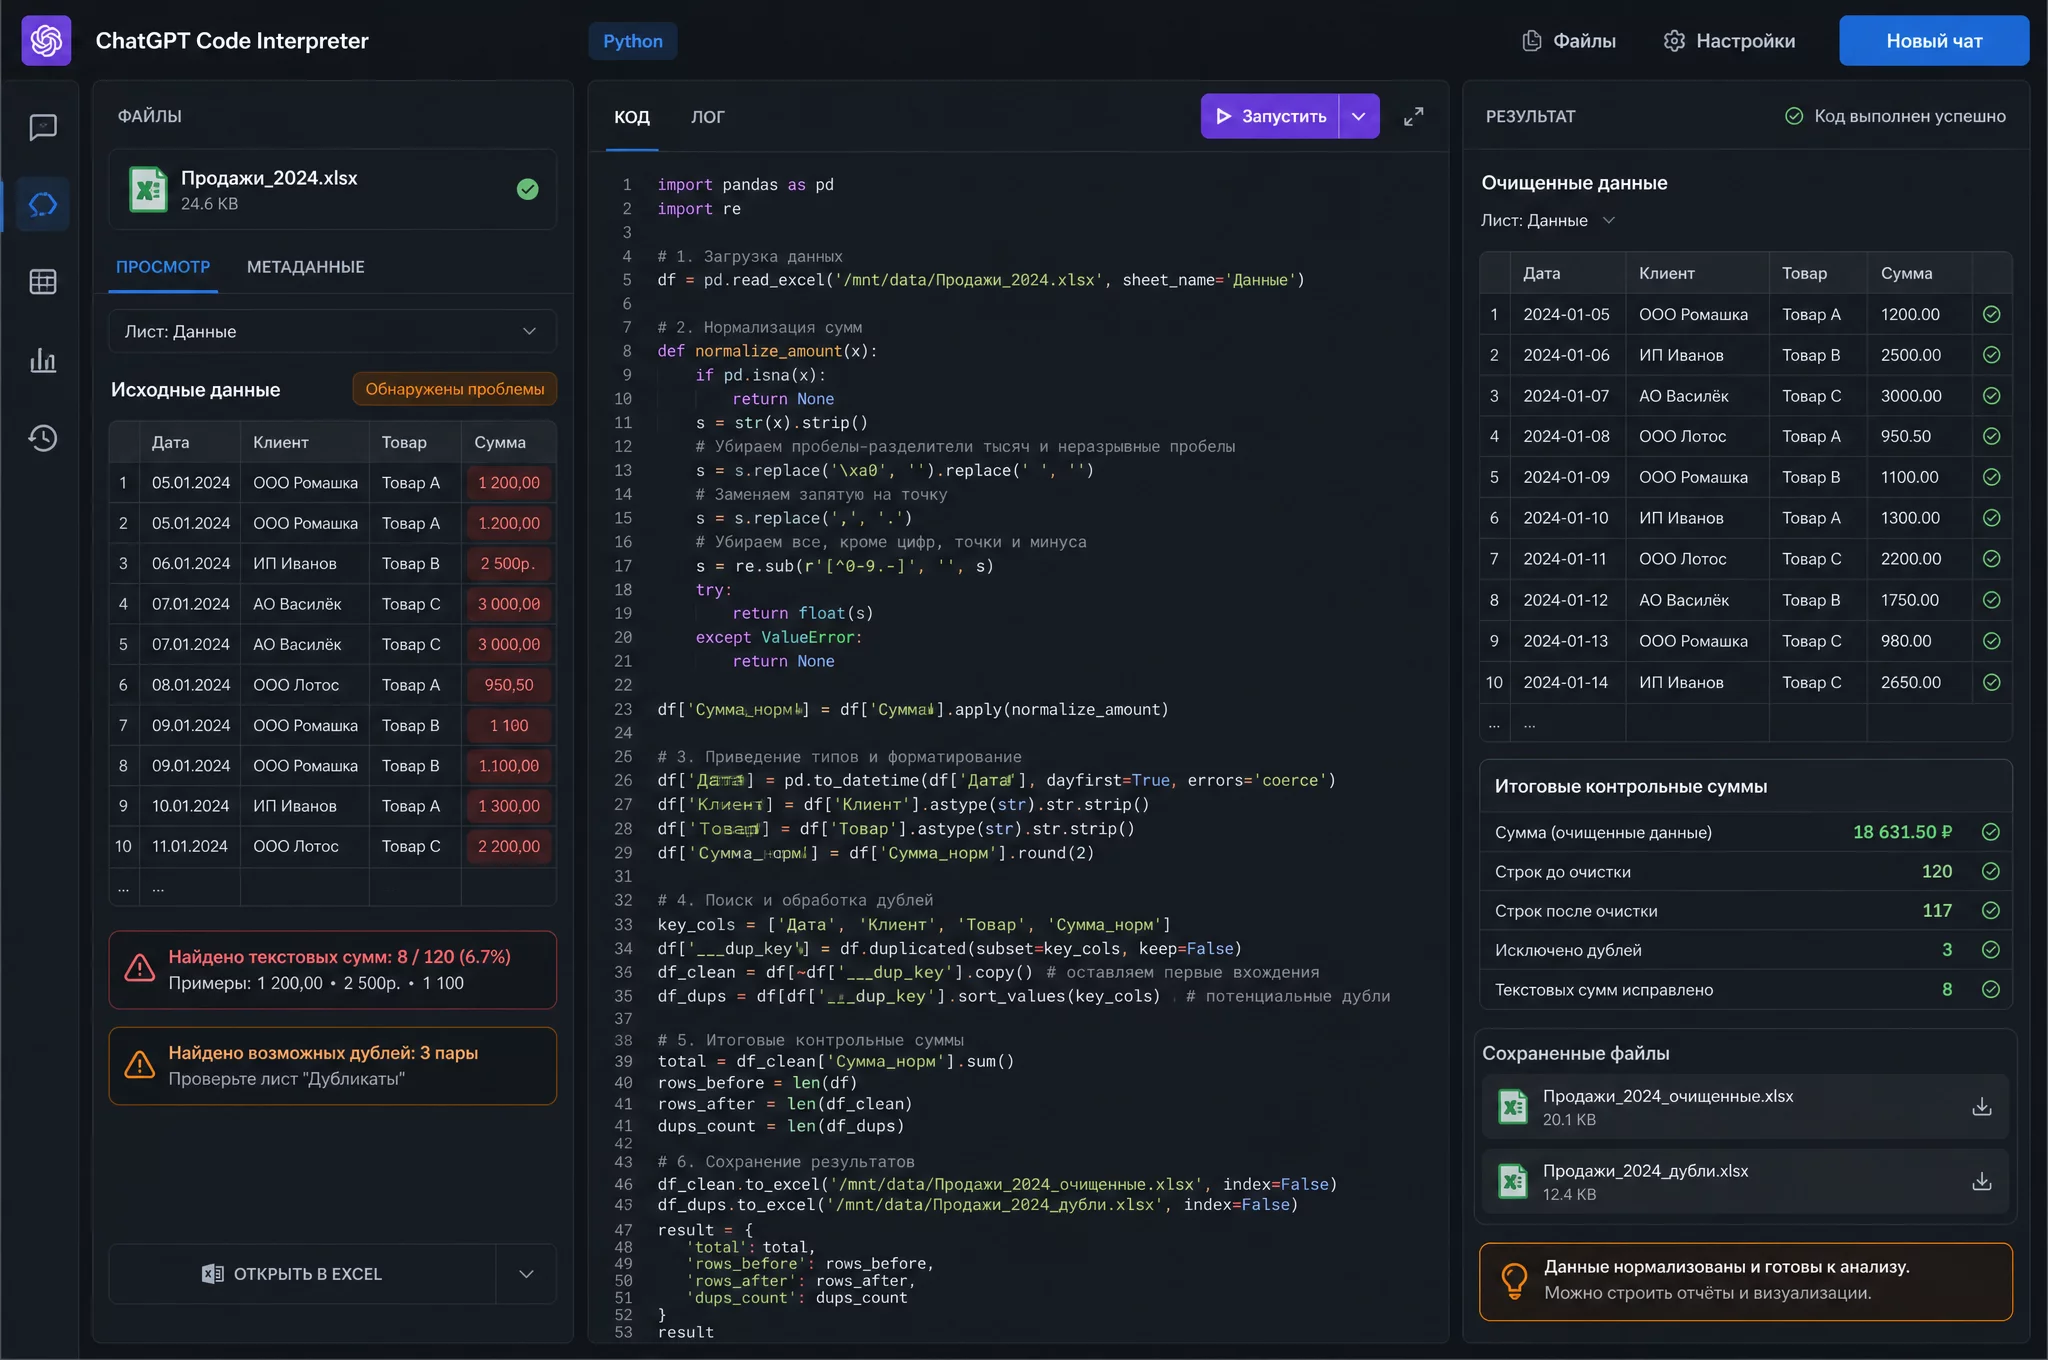
Чтобы убрать «магию», разберу механику на маленьком примере. Выгрузка из банка за август, 5 строк: 3 500,00 с пробелом в тысячах, две даты в разных форматах, один дубль, один контрагент записан в двух вариантах.
Python делает следующее. Читает файл, определяет типы колонок. Видит, что колонка Сумма имеет тип object, то есть текст, и преобразует её в число: убирает пробелы, меняет запятую на точку. Приводит даты к одному формату через парсинг. Убирает лишние пробелы в названиях и выравнивает регистр. Находит дубль по связке контрагент плюс сумма плюс дата и выносит его отдельно. Сопоставляет варианты названия одного контрагента по похожести.
Итог по примеру: чистые суммы, единые даты, один дубль отмечен, два названия склеены в одно, контрольная сумма сходится с исходной за вычетом дубля.
Почему это важно понимать. Когда вы видите, что чистка построена на простых и прозрачных правилах, исчезает страх «магии». А когда правило не работает, вы можете точно объяснить ChatGPT, что именно пошло не так, вместо того чтобы перезапускать вслепую. И главное: вы всегда можете проверить результат контрольными суммами.
Пошаговый процесс: грязная выгрузка до чистой таблицы за 10 минут
Разберу конкретный сценарий: выгрузка из интернет-банка за август 2026 года, 4 500 строк, с типовым набором дефектов.
Минуты 0-2. Подготовка файла. Выгружаю реестр платежей из интернет-банка в Excel. Проверяю, что файл открывается, колонки читаются. Обезличиваю контрагентов по справочнику замен: реальные названия на Контрагент 1, 2, 3. Суммы и даты не трогаю.
Минуты 2-3. Открытие ChatGPT и загрузка файла. Новый чат на chatgpt.com, тариф Plus. Загружаю файл через кнопку прикрепления. ChatGPT показывает первые строки. Проверяю: если в колонке Сумма тип object вместо float64, суммы текстовые, нужна очистка.
Минуты 3-4. Диагностика промптом 1. ChatGPT перечисляет дефекты: суммы текстом, даты в двух форматах, 43 дубля, 12 контрагентов с разным написанием, строки Итого в конце каждого дня. Получаю план чистки.
Минуты 4-8. Чистка промптом 2. ChatGPT пишет код, выполняет его, выдаёт результат: суммы числами, даты единого формата, дубли вынесены отдельно с общей суммой, контрагенты склеены, Итоги исключены. Прошу сохранить очищенную таблицу как Excel.
Минуты 8-9. Контроль. Прошу показать итог до чистки, итог после и сумму удалённых дублей. Контрольная арифметика: итог после плюс сумма дублей должна равняться итогу до. Если сходится, чистка полная.
Минута 10. Скачивание и сохранение кода. Скачиваю очищенный файл. Копирую Python-код в библиотеку, в следующий месяц загружу новую выгрузку и заменю имя файла и период, результат за 5-6 минут.
Критический промпт: контроль после чистки
После чистки запустите контрольный промпт. Он проверяет полноту результата и защищает от главного риска, когда код молча потерял часть строк.
Ты только что почистил файл. Проверь себя.

1. Посчитай итог исходного файла по колонке [СУММА].
2. Посчитай итог очищенного файла по той же колонке.
3. Посчитай сумму удалённых дублей, если они были.
4. Проверь арифметику: итог очищенного файла плюс сумма
   удалённых строк должен равняться итогу исходного файла.
5. Посчитай, сколько строк было в исходном файле, сколько
   стало после чистки и сколько удалено.
6. Проверь, что в колонке Сумма нет текстовых значений
   и все даты в едином формате.

Если арифметика не сходится или есть потерянные строки,
найди причину, исправь код и повтори расчёт.
Сообщи: строк до, строк после, удалено дублей, итоговые суммы.
Ожидаемый ответ: арифметика сходится, потерянных строк ноль. Если ChatGPT сначала выдал результат, а контрольный промпт нашёл расхождение, это нормально: код поправится в том же чате за минуту. Именно поэтому контроль запускается до того, как вы начнёте работать с очищенной таблицей.
Если что-то пошло не так
Три сбоя случаются чаще всего, каждый лечится за минуту.
Суммы остаются текстом. ChatGPT пишет, что колонка имеет тип object. Решение: добавьте в промпт «очисти неразрывные пробелы и преобразуй суммы в числовой тип». Обычно одной фразы достаточно.
Даты не привели к единому виду. Python видит разные форматы и не может распарсить часть строк. Решение: укажите в промпте, какие форматы дат есть в файле, и попросите парсить с явным перечнем.
Итог не сходится. Итог после чистки плюс удалённые дубли не равен итогу до. Значит, код потерял строки: возможно, из-за лишней фильтрации или ошибки в условиях. Решение: попросите ChatGPT проверить, все ли строки учтены, и показать, куда делись «потерянные» суммы.
Готовые промпты для чистки данных: 10 рабочих шаблонов
Все промпты работают в ChatGPT Plus с GPT-5.5. Перед каждым загружайте файл через кнопку прикрепления. Текст в [КВАДРАТНЫХ СКОБКАХ] заменяйте на свои данные.
Два правила работы с промптами. Первое: не запускайте чистку и разбор причин в одном чате, лучше открывать новый чат на каждый крупный шаг. Второе: после первого успешного прогона сохраните промпт вместе с кодом в библиотеку, со второго месяца это готовый шаблон под вашу выгрузку.
Промпт 1. Диагностика выгрузки перед чисткой
Я загрузила файл "[ФАЙЛ].xlsx" с выгрузкой из [СИСТЕМА].
Проверь его и сообщи:

1. Сколько строк и колонок, какая шапка.
2. Типы данных в каждой колонке.
3. Суммы числового типа или текст?
4. Форматы дат, сколько разных вариантов.
5. Есть ли дубли строк, сколько.
6. Есть ли пустые ячейки в ключевых колонках.
7. Есть ли строки Итого, шапки, объединённые ячейки.
8. Есть ли названия с лишними пробелами или разным регистром.

Покажи по 5 первых строк.
Если найдены проблемы, предложи план чистки.
Этот промпт закрывает половину задачи: вы получаете список дефектов и понимаете, какие промпты ниже запускать.
Промпт 2. Универсальная чистка выгрузки
Это якорный промпт статьи. Если запомнить один, то этот: он закрывает 80 процентов задач чистки. Подставляйте реальные названия колонок, это сильно влияет на качество.
Я загрузила файл "[ФАЙЛ].xlsx".
Колонки: [КОЛОНКИ].
Очисти данные по правилам:

1. Суммы: убрать пробелы и неразрывные пробелы в тысячах,
   преобразовать в числовой тип.
2. Даты: привести все к формату [ФОРМАТ], например ДД.ММ.ГГГГ.
3. Текст: убрать лишние пробелы по краям и внутри,
   выровнять регистр по правилу [ПРАВИЛО].
4. Удалить строки Итого, шапки, служебные строки.
5. Найти дубли и вынести их отдельным разделом.
6. Пустые ячейки в ключевых колонках пометить.

Результат:
- очищенная таблица без дублей
- раздел с дублями и их суммой
- отчёт: строк до, строк после, удалено дублей,
  итоговые суммы до и после.

Сохрани очищенную таблицу как Excel.
Промпт 3. Поиск дублей трёх типов
Файл "[ФАЙЛ].xlsx" с колонками [КОЛОНКИ].

Найди подозрительные дубли:
1. Точные: одинаковые значения во всех ключевых колонках.
2. В пределах 3 дней: одинаковый контрагент и сумма,
   разные даты.
3. Разбитый платёж: несколько строк одного контрагента за день,
   которые в сумме равны крупной сумме соседнего дня.

Для каждого дубля покажи строки-кандидаты рядом.
Общая сумма потенциально задвоенных операций.
Не удаляй строки, только покажи.
Подробно про поиск дублей я рассказываю в отдельном разделе ниже, этот промпт его основа.
Промпт 4. Склейка справочника контрагентов
В колонке [КОЛОНКА] названия контрагентов записаны по-разному:
"ООО РОМАШКА", "Ромашка ООО", "ООО «Ромашка»".

1. Очисти названия: убери ИНН из названия, выровняй регистр,
   убавь лишние слова вроде ООО, ИП, ЗАО по правилу [ПРАВИЛО].
2. Сопоставь названия по похожести, fuzzy match, порог [ПОРОГ]%.
3. Покажи таблицу групп: каноничное название, варианты,
   количество строк, итоговая сумма по группе.
4. Пары ниже порога выведи отдельно: их нужно решить вручную.

Сохрани справочник с каноничными названиями как Excel.
Промпт 5. Приведение сумм из текста в числа
В колонке [КОЛОНКА] суммы записаны текстом:
с пробелами как разделителями тысяч, с запятой как
разделителем копеек.

1. Найди все варианты записи сумм в колонке.
2. Убери пробелы, неразрывные пробелы и прочие символы.
3. Преобразуй в числовой тип, запятую замени на точку.
4. Проверь, что итог по колонке сошёлся до и после.
5. Покажи, сколько значений преобразовано,
   и список значений, которые не удалось распарсить.
Промпт 6. Единый формат дат
В колонке [КОЛОНКА] даты в разных форматах:
[ПЕРЕЧЕНЬ ФОРМАТОВ, например ДД.ММ.ГГГГ, ММ/ДД/ГГГГ, текст].

1. Определи формат каждой даты.
2. Приведи все к единому формату [ФОРМАТ].
3. Отдельно покажи строки, где дата не распозналась.
4. Проверь: количество строк до и после одинаковое,
   даты в диапазоне [ДАТА_С] по [ДАТА_ПО].
Промпт 7. Разбор объединённых ячеек и многоуровневых шапок
Файл "[ФАЙЛ].xlsx" имеет шапку из [N] строк и объединённые
ячейки в колонках [КОЛОНКИ].

1. Создай плоскую шапку из [N] строк: склей название колонок.
2. Заполни объединённые ячейки: значение в первой ячейке
   продублируй на все ячейки группы.
3. Удали служебные строки и пустые колонки.
4. Приведи данные к таблице, где первая строка шапка,
   дальше только данные.
5. Покажи структуру до и после.
Промпт 8. Построение эталонного справочника из нескольких выгрузок
Я загрузила несколько файлов:
[СПИСОК ФАЙЛОВ].

Это выгрузки из [СИСТЕМЫ_1], [СИСТЕМЫ_2], [СИСТЕМЫ_3].

1. Собери все уникальные значения из колонки [КОЛОНКА]
   во всех файлах.
2. Склей их в единый справочник по похожести, порог [ПОРОГ]%.
3. Для каждой группы покажи: каноничное название,
   варианты, в каких файлах встречается.
4. Пары ниже порога выведи отдельно для ручного решения.

Сохрани единый справочник как Excel.
Промпт 9. Отчёт о чистке для финансового директора
Файл "[РЕЗУЛЬТАТ].xlsx" это результат чистки выгрузки
за [ПЕРИОД].

Составь отчёт на одну страницу:
1. Сколько строк было в исходной выгрузке, сколько стало.
2. Удалено дублей: количество и сумма.
3. Склеено контрагентов: сколько групп, сколько строк.
4. Исправлено форматов: суммы, даты, текст.
5. Контроль: итог до чистки равен итогу после плюс дубли.
6. Статус: данные готовы к расчётам или требуют ручного решения.

Деловой стиль, конкретные цифры.
Промпт 10. Сохранение кода для повторного запуска
Ты только что почистил выгрузку.

Сделай три вещи:
1. Сохрани очищенную таблицу как Excel "clean_[ПЕРИОД].xlsx".
2. Выведи полный Python-код отдельным блоком.
   В начало добавь переменные, которые меняются каждый раз:
   FILE   = "[ФАЙЛ].xlsx"
   PERIOD = "[ПЕРИОД]"
3. Добавь комментарии на русском к каждому блоку:
   чтение файла, нормализация сумм, дат, текста,
   поиск дублей, склейка справочника, отчёт.

Остальной код должен работать без изменений при смене переменных.
Как адаптировать промпты под свою выгрузку
Готовая библиотека промптов это стартовая точка, а не догма. Ваши файлы всегда чуть другие: другие названия колонок, другие дефекты, другие правила. Пять минут на адаптацию экономят час переделок.
Первое: замените названия колонок на реальные. В промптах стоят шаблонные «Сумма», «Дата», «Контрагент». В вашей выгрузке колонка может называться «Сумма с НДС», «Дата операции», «Наименование». Названия должны совпадать с реальными, иначе код будет искать несуществующие поля.
Второе: опишите свои дефекты. Если в вашем банке дата приходит в виде «сентябрь, 1, 2026», скажите об этом прямо, а не надейтесь, что модель угадает. Чем точнее описан дефект, тем точнее код.
Третье: добавьте свои правила. Если для вашей компании дублем считается повтор в пределах 7 дней, а не 3, напишите это. Если в названиях контрагентов нельзя игнорировать слово ООО, потому что есть два ООО с похожими названиями, укажите.
Четвёртое: укажите, какие колонки трогать, а какие игнорировать. Служебные поля вроде номера строки выгрузки или времени загрузки лучше исключить из чистки.
Как найти и убрать дубли через ChatGPT
Прямой ответ: ChatGPT находит не только точные дубли, когда строка повторяется целиком, но и два скрытых типа, которые руками ловятся хуже всего.
Дубли это бич выгрузок. В банковском реестре платёж может попасть дважды из-за сбоя выгрузки. В 1С документ может быть проведён дважды. В CRM заказ с возвратом может создавать дубли карточек. Каждый дубль это задвоенная сумма в отчёте, а задвоенная сумма это вопрос собственника, который не хочется услышать.
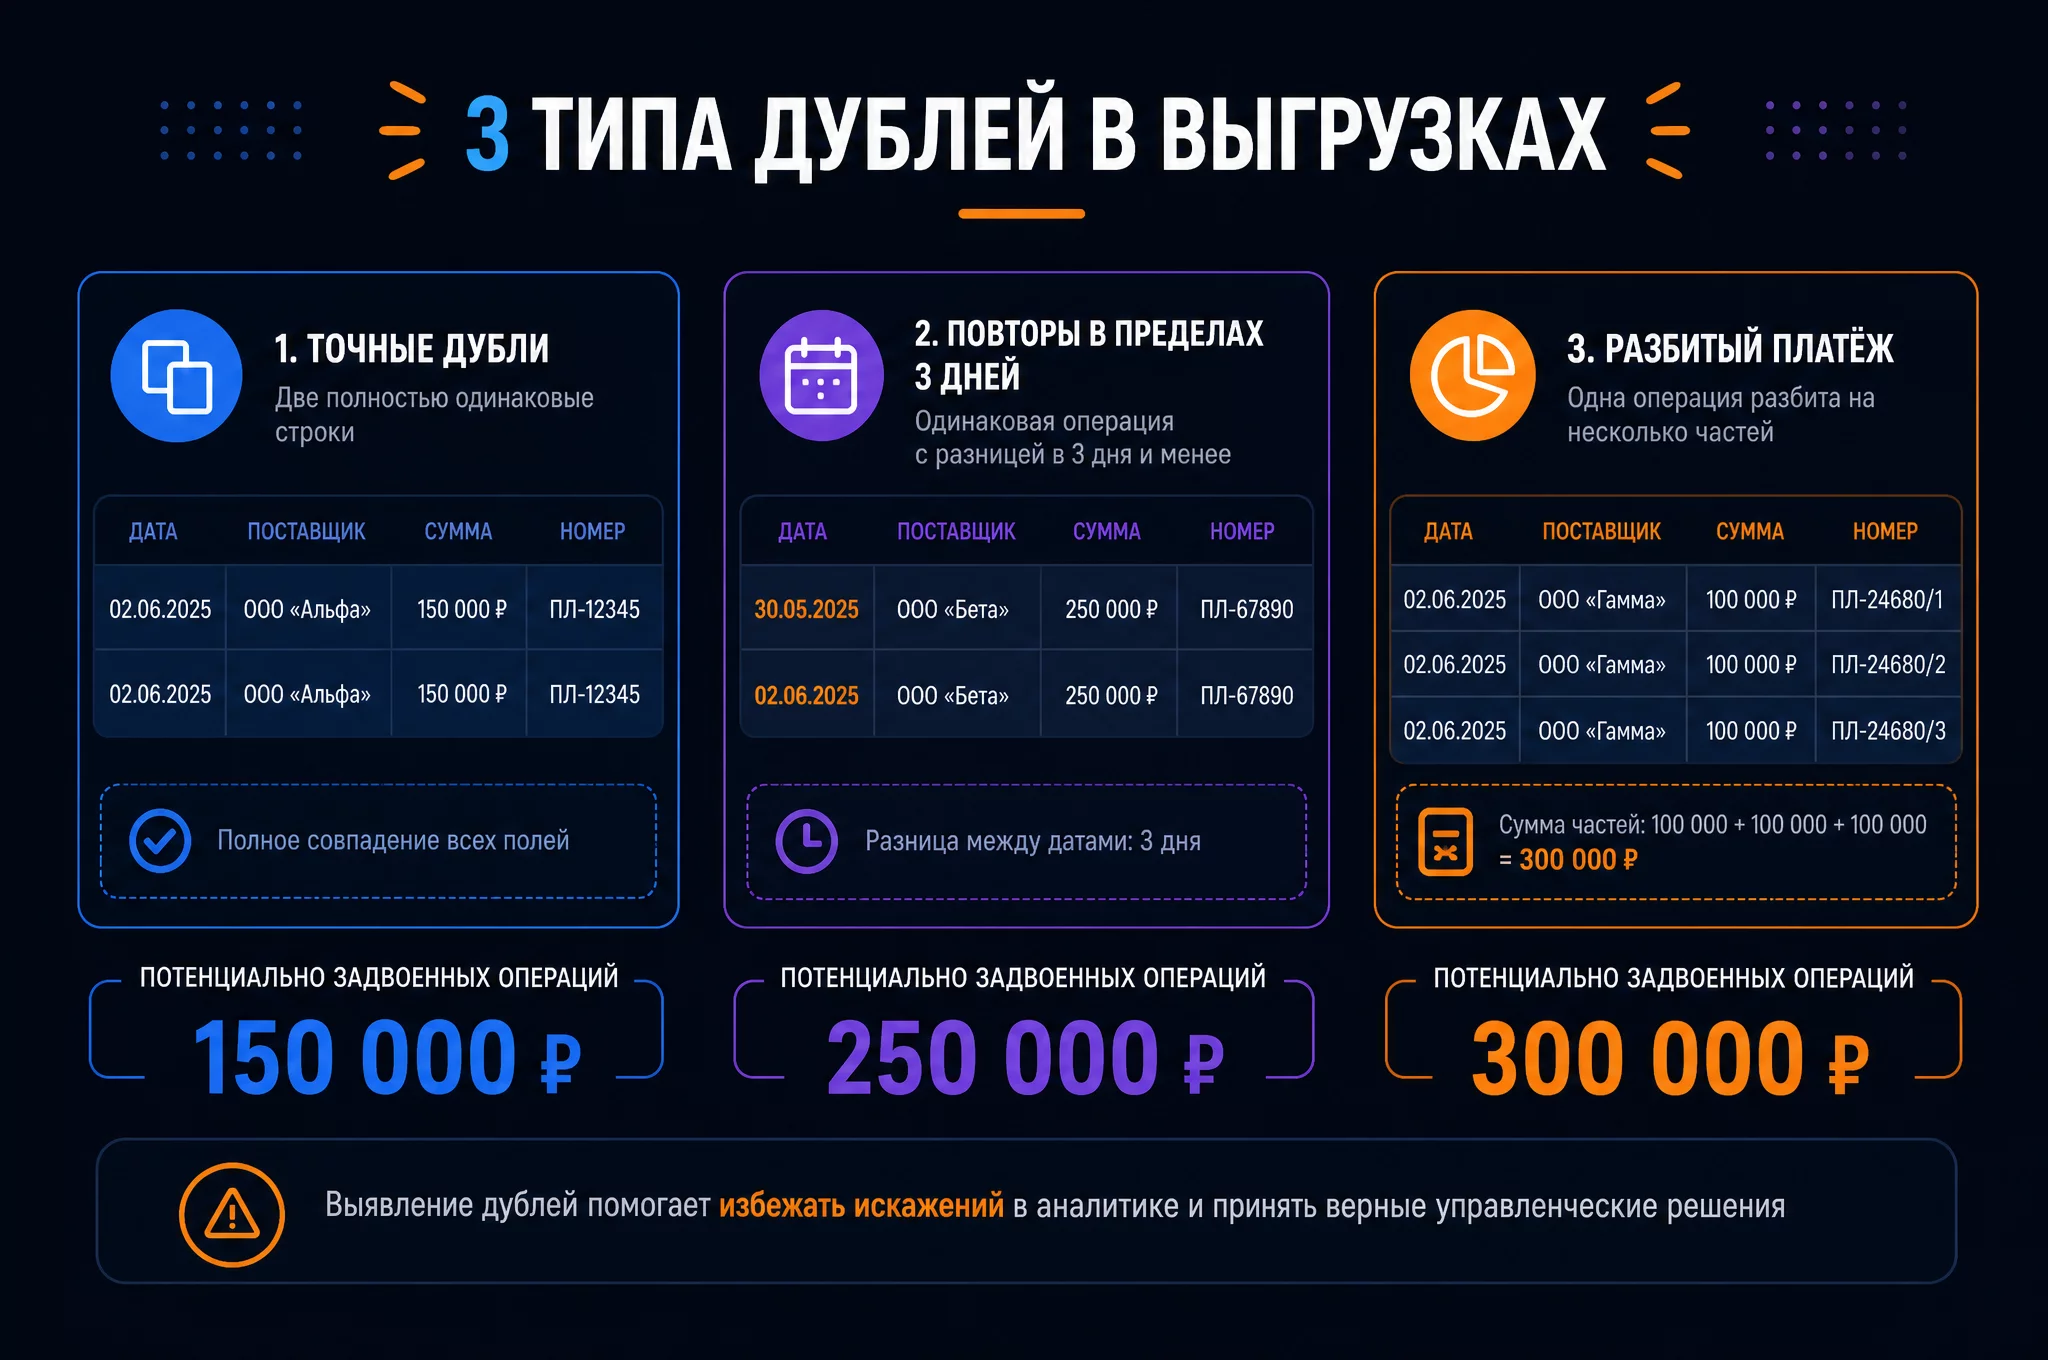
Три типа дублей, которые ищет промпт 3:
Точные дубли. Одинаковые значения во всех ключевых колонках: контрагент, сумма, дата, назначение. Самый простой случай, находится сравнением строк целиком.
Повторы в пределах 3 дней. Одинаковый контрагент и сумма, но разные даты. Это типичный сценарий: платёж провели дважды в разные дни, например 30 и 2 числа, и формально это разные строки, а по сути один платёж.
Разбитые платежи. Несколько строк одного контрагента за один день, которые в сумме равны крупной сумме. Классика: платёж на 300 000 рублей разбили на три по 100 000, чтобы обойти лимит, а в учёте он отразился целиком. Или наоборот, один платёж в учёте, а в банке три строки.
Для каждого типа ChatGPT показывает строки-кандидаты рядом и считает общую сумму потенциально задвоенных операций. Решение, какие строки удалять, принимаете вы. Это важно: код находит кандидатов, а не удаляет вслепую.
Как это выглядит на практике. Загружаете реестр платежей, запускаете промпт 3, получаете таблицу: тип дубля, строки-кандидаты, сумма. Отмечаете, какие пары подтверждаете, какие нет. Просите ChatGPT удалить подтверждённые и сохранить очищенный файл. Контрольная сумма: итог до минус сумма удалённых дублей равно итогу после.
Отдельно про дедупликацию при миграции данных. Если вы переезжаете на новую конфигурацию 1С или объединяете базы, чистка справочника до загрузки важнее, чем потом. Подробно про перенос и проверку регистров я писала в статье про сверку регистров.
Как привести форматы к единому виду: даты, суммы, текст
Прямой ответ: нормализация форматов это первая и самая частая задача чистки, и именно на ней ChatGPT экономит больше всего времени, потому что код обрабатывает все строки одинаково.
Форматы ломают всё, что строится на данных: сводные, сортировку, сверки, выборки за период. При этом глазами неполадку не всегда увидишь. Сумма 1 234,56 выглядит нормально, но Excel считает её текстом и в итог не включает. Дата «сентябрь 2026» сортируется по алфавиту, а не по времени.
Три главные колонки, которые приходится чистить в каждой выгрузке.
Суммы. Типовые дефекты: неразрывный пробел как разделитель тысяч, запятая вместо точки, валюта в тексте («1 234,56 руб.»), знак минус в конце. Промпт 5 собирает все варианты записи, парсит их, преобразует в числа и показывает, что не удалось распарсить. Контроль: итог по колонке до и после сходится.
Даты. Типовые дефекты: ДД.ММ.ГГГГ против ММ/ДД/ГГГГ, год из двух цифр, текстовые названия месяцев, время, приклеенное к дате. Промпт 6 определяет формат каждой даты, приводит к единому виду и выносит нераспознанные отдельно. Контроль: количество строк не изменилось, даты в нужном диапазоне.
Текст. Лишние пробелы по краям и внутри, разный регистр, сдвоенные пробелы, невидимые символы из копипасты. Промпт 2 убирает пробелы, выравнивает регистр по вашему правилу. Это критично для названий, по которым потом идёт группировка и склейка справочников.
Почему это лучше ручной чистки. В Excel вы делаете замену для одного дефекта: Ctrl+H по пробелам, текстовые функции для дат. Каждый дефект это отдельный цикл действий, и на 4 500 строках циклы повторяются много раз. ChatGPT описывает все правила в одном промпте, код выполняет их за один проход, и отчёт показывает, что именно изменено.
Проверка результата всегда одна: контрольная арифметика. Итог по денежным колонкам до чистки должен равняться итогу после плюс сумма удалённых строк. Если сходится, чистка ничего не потеряла. Если нет, в коде ошибка, и её надо исправить до того, как работать с данными.
Как починить справочники: контрагенты, банки, статьи
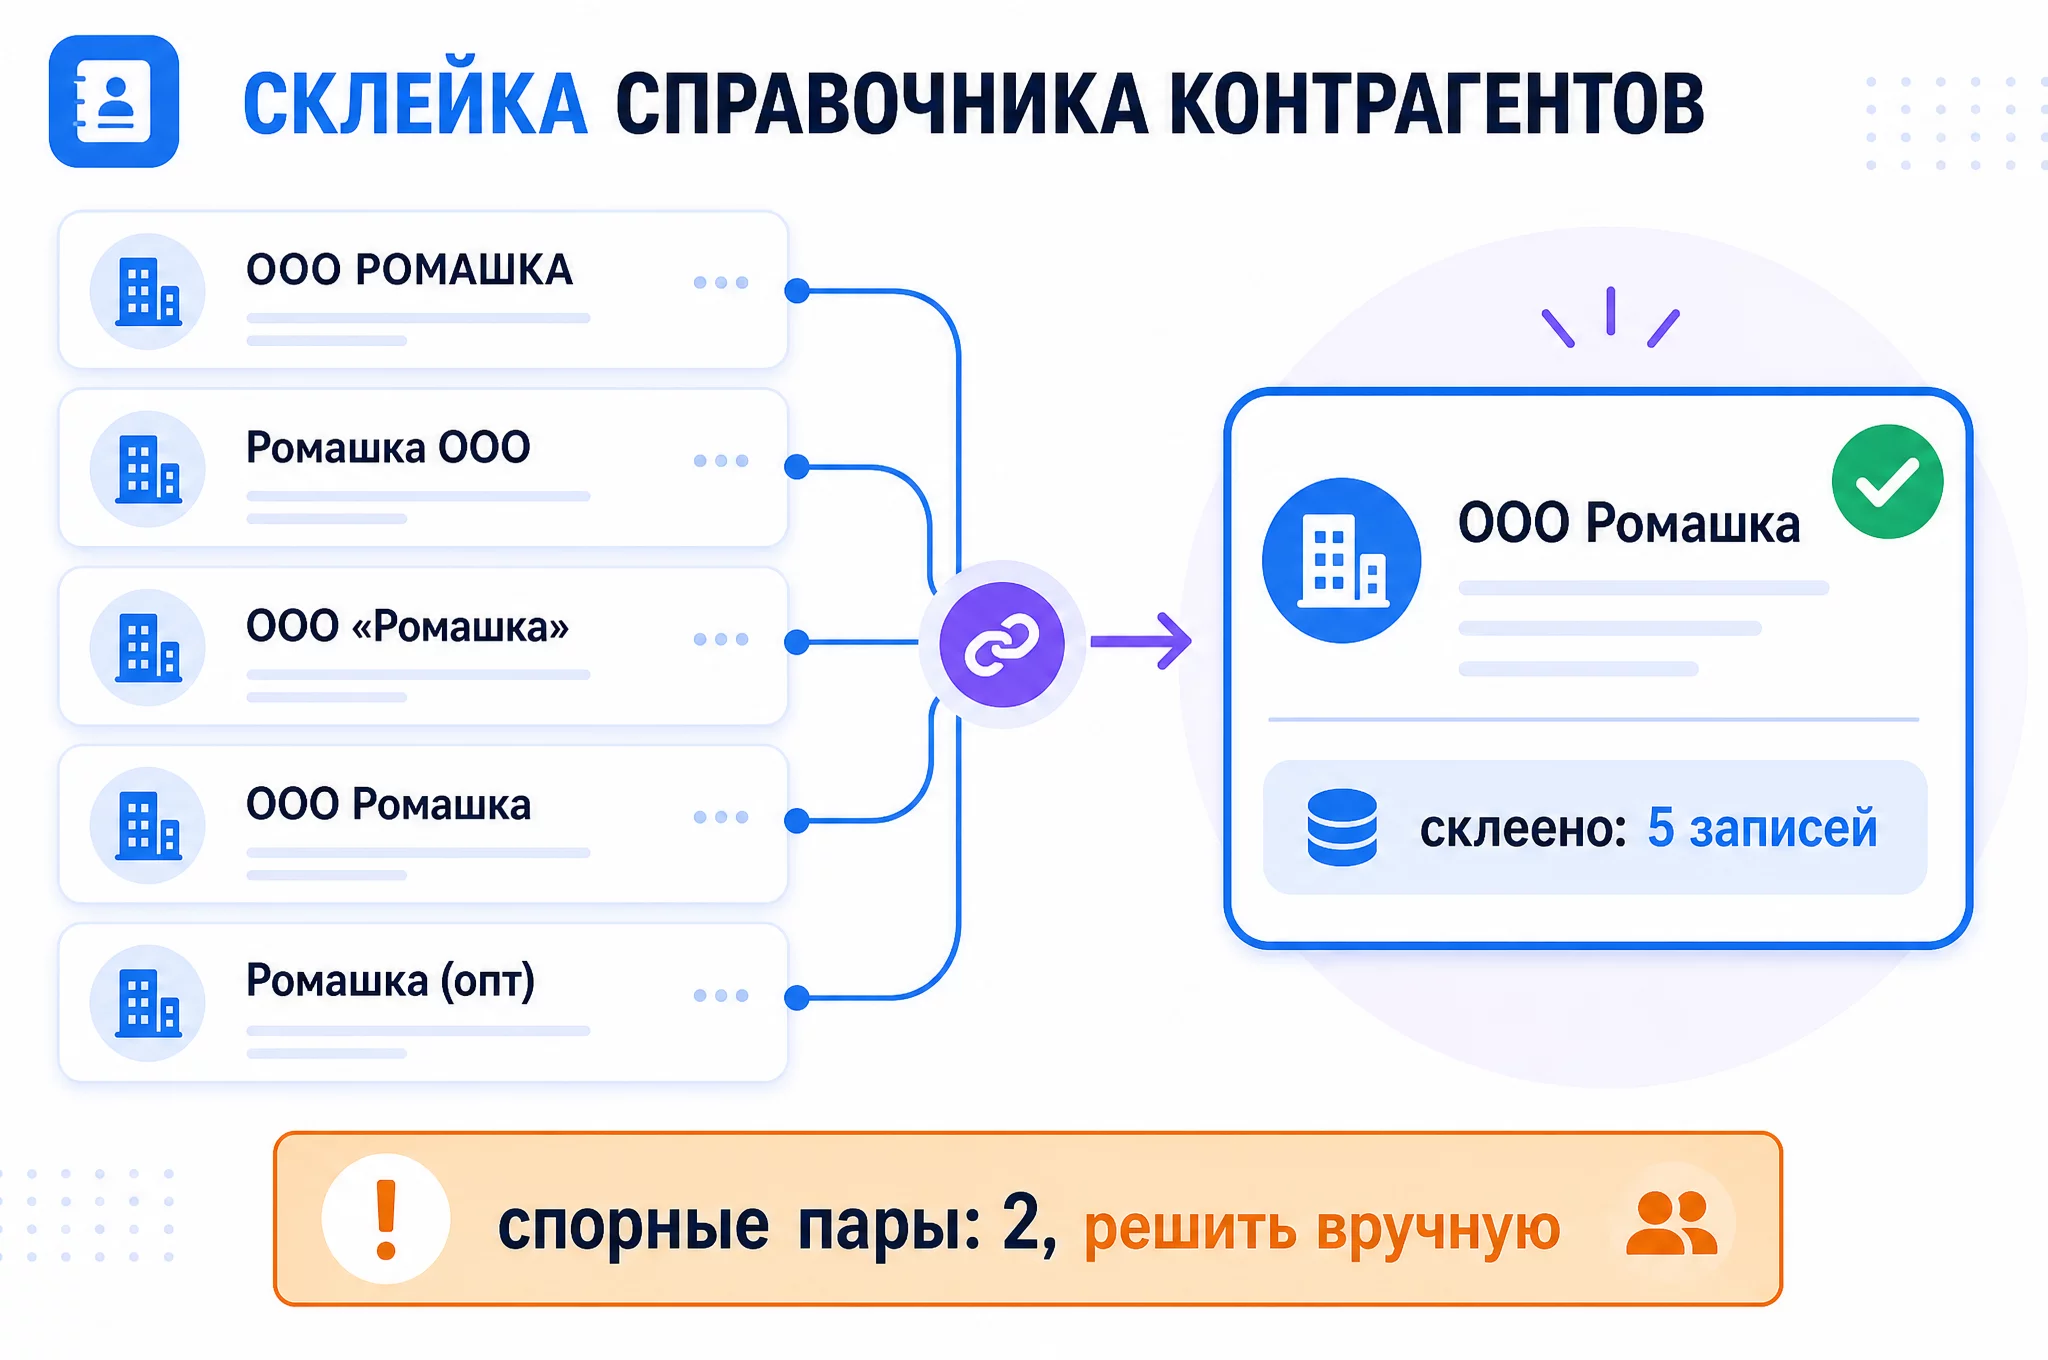
Прямой ответ: справочники чинятся нечётким сопоставлением, когда ChatGPT группирует похожие названия и предлагает каноничное значение, а спорные пары выносит на решение человека.
Раздробленный справочник это тихая проблема. Аналитика по продажам показывает одного клиента как трёх, потому что в базе он записан тремя способами. Закупки у одного поставщика размазаны по пяти карточкам. Расчёт маржи по контрагентам превращается в гадание.
Откуда берётся разнобой. Системы не обмениваются справочниками. Бухгалтер заводит ООО РОМАШКА, менеджер в CRM пишет Ромашка ООО, банк отдаёт ООО «Ромашка». Плюс ручной ввод с опечатками: Ромащка, Ромашка (лишний пробел). Плюс смена названия: ООО Ромашка стало ООО Ромашка-М.
Что делает промпт 4. Сначала чистит названия: убирает ИНН, выравнивает регистр, отрезает организационно-правовую форму по вашему правилу. Потом сопоставляет по похожести с порогом, который вы задаёте. Для каждой группы показывает каноничное название, варианты, количество строк и сумму. Пары ниже порога выводит отдельно.
Почему порог важен. Если поставить порог слишком низкий, модель начнёт склеивать разных контрагентов с похожими названиями: ООО Ромашка и ООО Ромашка-Трейд это разные компании, а в нечётком сопоставлении они близки. Поэтому спорные пары не склеиваются автоматически, а выносятся на решение эксперта. Вы смотрите список из 20-30 пар, подтверждаете склейку или отклоняете, и только после этого ChatGPT применяет правки.
Склейка даёт два эффекта. Первый: аналитика становится честной, один контрагент это одна строка в сводке. Второй: сверка с контрагентом перестаёт спотыкаться о разные написания. Подробно про замену ВПР и объединение таблиц по справочникам я разбирала в статье про ChatGPT вместо ВПР.
Три кейса с цифрами: сколько экономит финансист
Три истории учеников курса «AI-навыки финансиста». Имена обезличены, цифры реальные.
Кейс 1. Финансовый менеджер оптовой компании, Москва
Было: ежемесячная подготовка выгрузки из банка к сверке с 1С. Реестр на 4 500 строк, суммы текстом с пробелами, дубли по зарплатному проекту, контрагенты в разных написаниях. Ручная чистка занимала 3-4 часа, часть дублей уезжала в сверку, и потом они всплывали при разборе расхождений.
Что сделали: загрузили выгрузку в ChatGPT, запустили диагностику промптом 1, потом чистку промптом 2 и поиск дублей промптом 3. Настроили справочник обезличивания на 120 контрагентов.
Стало: чистка за 20 минут вместо 3-4 часов. В первый же месяц ChatGPT нашёл 14 дублей по зарплатному проекту на общую сумму 890 000 рублей. Это были повторные выплаты, которые вручную пропускались, потому что строки отличались датой на день.
Экономия: 3-4 часа в месяц и 890 000 рублей потенциального задвоения, найденных за один прогон. Почему сработало: один раз настроили промпт под свою выгрузку, дальше шаблон работал без изменений.
Кейс 2. Главный бухгалтер производственного предприятия, Екатеринбург
Было: перед закрытием квартала надо было склеить справочник контрагентов из 1С и CRM. 3 200 строк, одни и те же поставщики записаны по-разному в двух системах. Ручная склейка заняла бы полтора дня, поэтому её откладывали, а аналитика по закупкам строилась с раздробленным справочником.
Что сделали: загрузили обе выгрузки, запустили промпт 8 для построения эталонного справочника. ChatGPT собрал 640 групп, из них 580 склеил автоматически, 60 пар вынес на ручное решение. Главбух разобрала 60 пар за 40 минут.
Стало: справочник готов за 1,5 часа вместо полутора дней. После склейки аналитика по закупкам показала, что топ-5 поставщиков дают 42% закупок, раньше из-за раздробленного справочника картина размазывалась.
Экономия: полтора дня в квартал и честная аналитика по поставщикам. Почему сработало: порог сходства и вынос спорных пар на человека убрали риск склейки разных компаний.
Кейс 3. Финансовый аналитик на аутсорсе, Санкт-Петербург
Было: ведёт семь клиентов, каждый месяц собирает данные из их 1С, банков и CRM в единую управленческую модель. Каждая выгрузка приходила со своим набором дефектов, на подготовку уходило по 30-40 минут на клиента, почти полный рабочий день только на чистку.
Что сделали: завела библиотеку промптов по типам выгрузок, банк, 1С, CRM. Код первой чистки сохранила по промпту 10, теперь меняет только имена файлов и период. Справочники обезличивания отдельные на каждого клиента.
Стало: по 8-12 минут на клиента, весь цикл за 1-1,5 часа. Освободилось время на контрольные проверки и на нового клиента.
Экономия: 5-7 часов в месяц. При ставке 2 500 рублей в час это 13 000-18 000 рублей освобождённого времени под новых клиентов. Почему сработало: библиотека кодов и промптов превратила разовую задачу в тиражируемый процесс.
Про закрытие месяца с ChatGPT в целом я рассказываю в отдельной статье, там чистка вписана в общий контур месяца.
ChatGPT, Claude, Gemini или Excel для чистки данных: сравнительная таблица
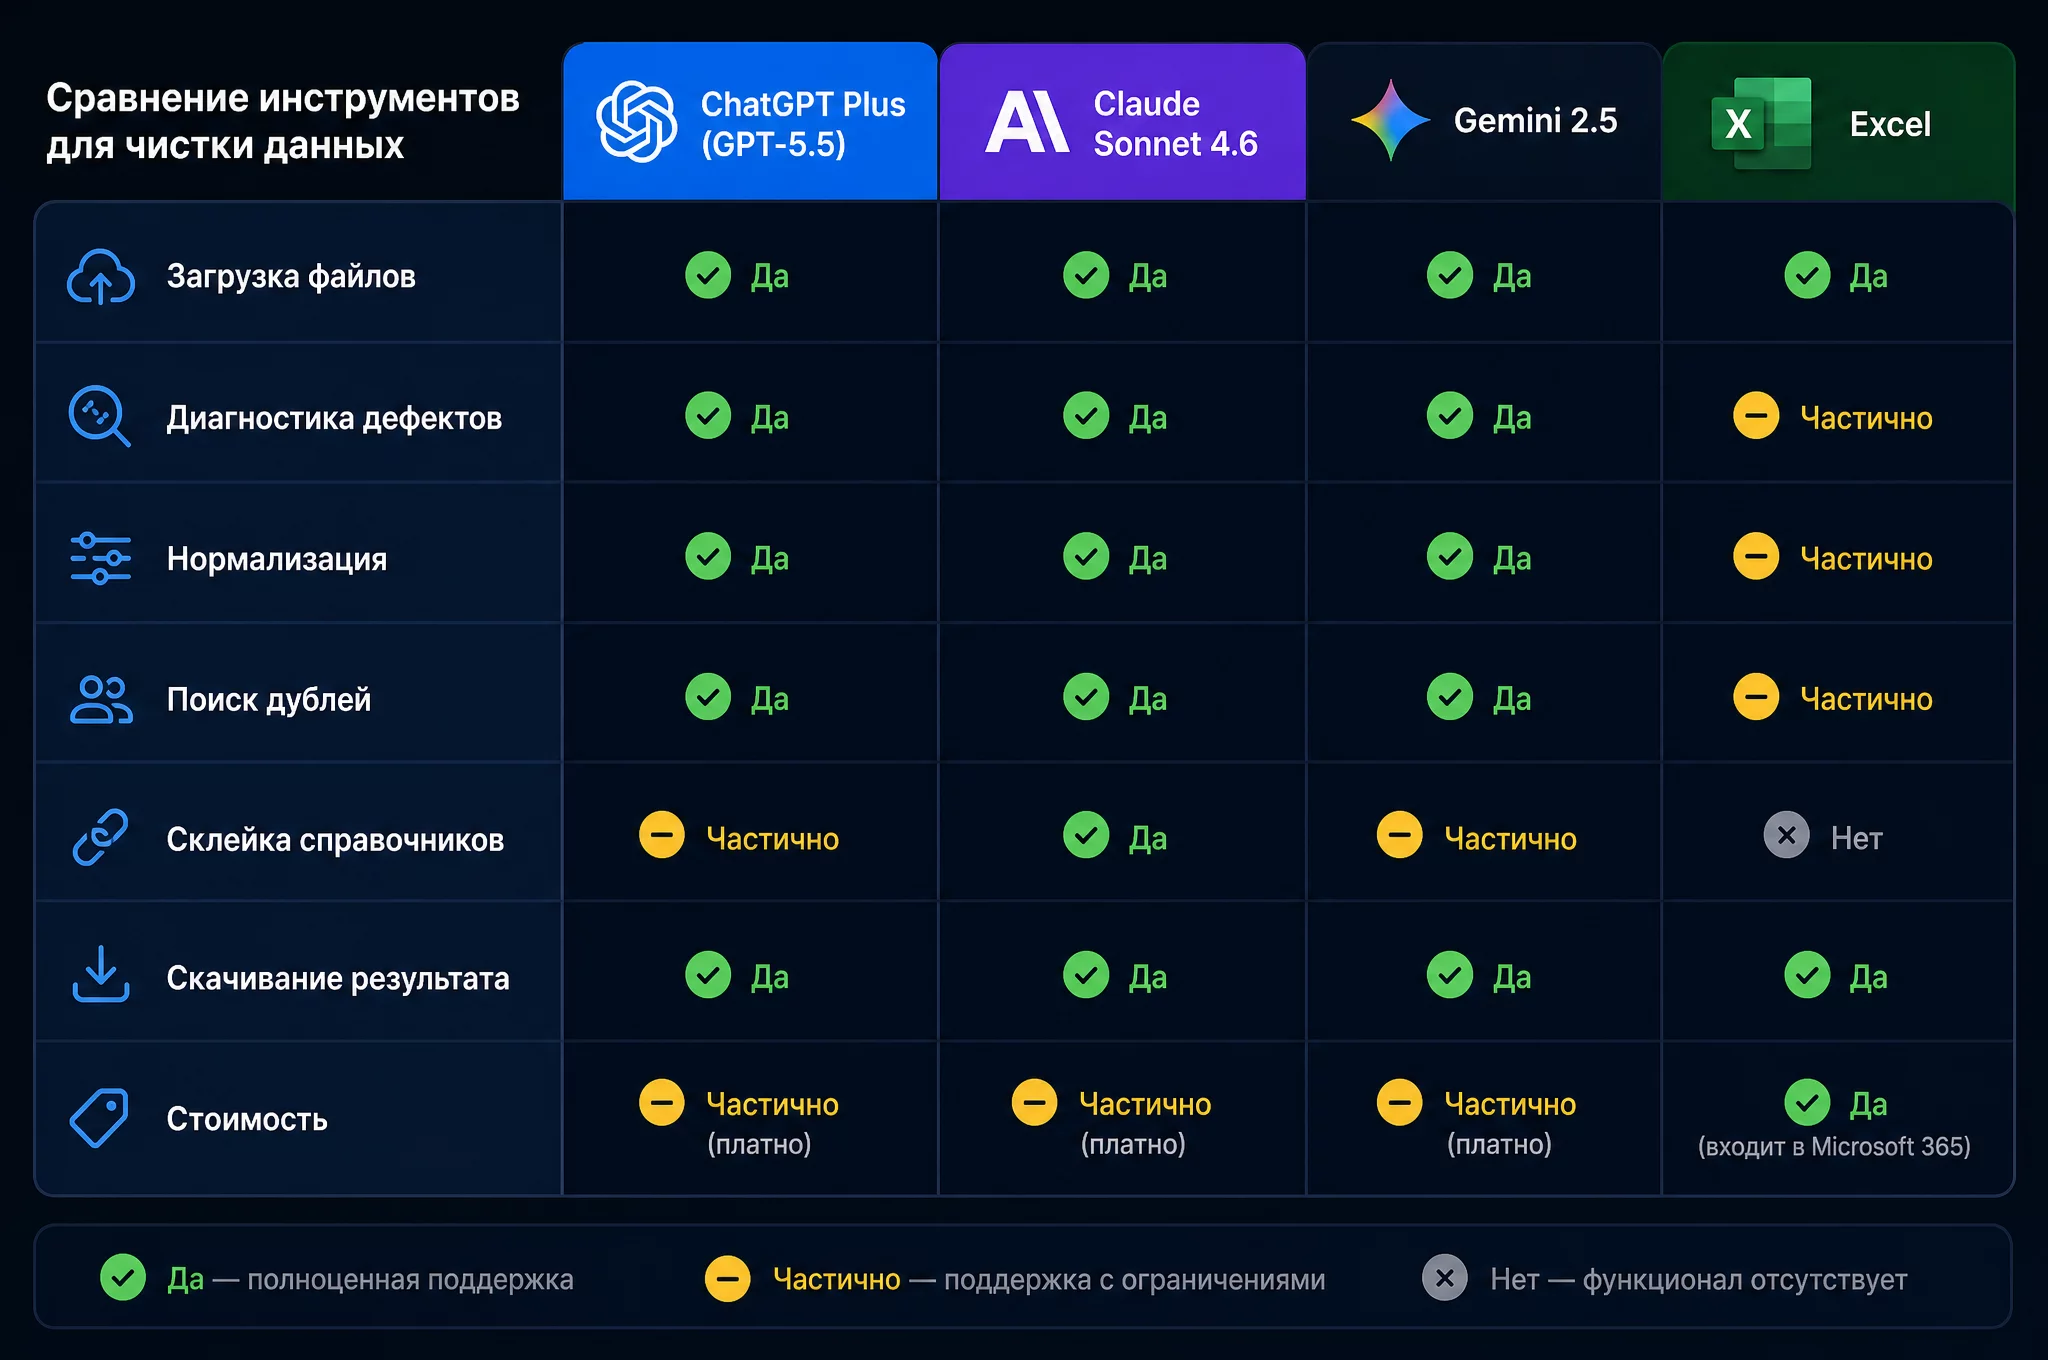
| Параметр | ChatGPT Plus (GPT-5.5) | Claude Sonnet 4.6 | Gemini 2.5 | Excel (ручная чистка) |
|---|---|---|---|---|
| Загрузка Excel и CSV | Да, Code Interpreter | Ограниченно | Да, в Workspace | Да |
| Диагностика дефектов | Да, полный список | Да, с промптом | Частично | Вручную глазами |
| Нормализация сумм, дат, текста | Да, кодом | Да, через код | Да | Вручную, колонка за колонкой |
| Поиск дублей трёх типов | Да | Да | Частично | Условное форматирование |
| Склейка справочников по похожести | Да, с порогом | Да | Частично | Вручную |
| Скачивание очищенного файла | Да | Нет напрямую | Нет напрямую | Да |
| Отчёт о чистке с контрольными суммами | Да | Да | Частично | Нет |
| Стоимость | Подписка, цены на openai.com | Подписка, цены на anthropic.com | Частично бесплатно | Входит в Office |
| Доступ в России | Ограничен | Ограничен | Ограничен | Без ограничений |
| Лучше для | Числовые выгрузки с файлами | Текстовые описания и объяснения | Экосистема Google | Разовые мелкие правки |
Актуально на сентябрь 2026 года. Тарифы и функции меняются, проверяйте на официальных сайтах.
Мой практический выбор зависит от задачи. Для чистки выгрузок с файлами это ChatGPT Plus с Code Interpreter: загрузка, код, скачивание результата в одном чате. Claude Sonnet 4.6 точнее объясняет, что именно починил, и хорош, когда нужен текстовый отчёт о чистке. Gemini 2.5 удобен, когда данные уже живут в Google Таблицах и команда работает в Workspace. DeepSeek V3.2 беру, когда данные нельзя выносить за периметр компании, локальная модель запускается на своём сервере.
Отдельно про Excel. Ручная чистка остаётся рабочим вариантом, когда файлы маленькие, формат стабильный и дефектов мало. Переезжать на нейросеть ради переезда не нужно. Но если каждый месяц вы тратите часы на пробелы, даты и дубли, ChatGPT закрывает именно эту боль, а не просто повторяет Excel быстрее. Про Power Query и сравнение подходов я писала в отдельной статье.
Как выбрать инструмент под конкретную задачу
Критерий простой: смотреть не на модность, а на объём, частоту и формат вывода.
| Ваш сценарий | Что взять |
|---|---|
| 50-100 строк, разовая правка | Excel, руками |
| 1 000-50 000 строк, каждый месяц | ChatGPT Plus с Code Interpreter |
| Склейка справочника из двух систем | ChatGPT, промпт 8 |
| Данные живут в Google Таблицах | Gemini 2.5 |
| Нужен подробный текстовый отчёт о чистке | Claude Sonnet 4.6 |
| Данные нельзя выносить за периметр | DeepSeek V3.2 локально |
| 500 000+ строк, тяжёлая обработка | Агрегация по периодам или Power Query |
Три вопроса перед выбором. Сколько строк в выгрузке? Если до 100, нейросеть избыточна. Как часто повторяется чистка? Если каждый месяц, стоит один раз настроить шаблон. Что делать с результатом? Если нужен файл для архива, удобнее ChatGPT, если таблица живёт в Google, удобнее Gemini.
Из России ChatGPT, Claude и Gemini без VPN не работают, это ограничение самих сервисов. Пользоваться нейросетями из России не запрещено. Какой сервис поставить, выбираете сами, названия VPN в статье не даю. Про работу с нейросетями без VPN я писала в статье про DeepSeek.
Как безопасно загружать грязные выгрузки в ChatGPT
Файлы с реквизитами контрагентов попадают под защиту персональных данных, поэтому обезличивание встроено в процесс как рабочий шаг, такой же обязательный, как проверка контрольных сумм.
Что нельзя загружать в публичный ChatGPT:
- Реальные ИНН организаций и физических лиц
- Названия контрагентов, по которым можно идентифицировать компанию
- ФИО сотрудников
- Расчётные счета и банковские реквизиты
- Документы под жёстким NDA с запретом передачи третьим лицам
Что можно после обезличивания:
- Структуру таблиц: даты, суммы, типы операций с заменёнными реквизитами
- Назначения платежей без ИНН и реальных наименований
- Агрегированные данные по периодам
Как обезличить файл за 10 минут. Создайте таблицу замен в Excel: две колонки, реальное значение и маска. ИНН 7712345678 становится К01, ООО «Ромашка» становится Контрагент 1. Через Ctrl+H замените каждый реальный реквизит на маску. Суммы и даты не трогайте, они нужны для чистки. Справочник замен храните у себя, он нужен чтобы расшифровать результат.
Подводные камни обезличивания. Во-первых, заменяйте до загрузки, а не после. Во-вторых, проверяйте, что маска не совпадает с реальным значением другого контрагента. В-третьих, храните справочник замен отдельно от файла выгрузки, чтобы случайно не загрузить его в чат. Механика обезличивания детально разобрана в отдельной статье.
Технические настройки. В Settings, Data Controls выключите переключатель Improve model for everyone, это запрещает OpenAI использовать ваши чаты для обучения модели. Для корпоративного уровня есть два варианта: ChatGPT Enterprise с изолированным контуром или локальная модель типа DeepSeek V3.2 на собственном сервере, тогда данные вообще не покидают периметр компании. Локальный сценарий я разбирала в статье про Ollama.
Правовой фрейм. ФЗ-152 о персональных данных требует законного основания для передачи персональных данных иностранному оператору. С 2025 года действуют оборотные штрафы: при повторных нарушениях от 1% до 3% годовой выручки, не менее 20 млн и не более 500 млн рублей. Ответственность несёт должностное лицо организации, не ChatGPT.
Что делать, если файл уже загружен без маски. Удалите чат в истории ChatGPT, чтобы не оставлять данные в истории диалогов. Сообщите ответственному за персональные данные в компании, если реквизиты были чувствительными. На будущее встройте обезличивание в процесс подготовки, чтобы шаг не зависел от памяти сотрудника.
Частые ошибки и мифы при чистке данных через нейросеть
Собрала в один раздел три блока: что ломается чаще всего, какие мифы мешают начать и где нейросеть реально не поможет.
Пять типичных ошибок при чистке через нейросеть
Ошибка 1. Не проверить типы данных после загрузки. Самая частая причина сбоев. Число 1 234 567,89 с неразрывным пробелом Python читает как текст, и все дальнейшие операции валятся. Проверка: если ChatGPT говорит, что тип колонки object вместо float64, это текст. Решение: добавьте в промпт строку очистки разделителей.
Ошибка 2. Не запускать диагностику перед чисткой. Если сразу запустить универсальную чистку, часть дефектов останется: например, объединённые ячейки, которые чистка не затрагивает. Диагностика промптом 1 занимает минуту и задаёт план.
Ошибка 3. Доверять результату без контрольных сумм. Итог после чистки плюс сумма удалённых строк должен равняться итогу до. Если не сходится, код потерял строки. Три минуты проверки стоят дешевле, чем месяц работы с неверными данными.
Ошибка 4. Склеивать справочник без порога и без ручного решения спорных пар. Низкий порог склеит разных контрагентов с похожими названиями. Всегда просите выводить пары ниже порога отдельно и решайте их сами.
Ошибка 5. Загружать чувствительные файлы без обезличивания. Реальные ИНН и названия в публичном ChatGPT это нарушение порядка работы с персональными данными. Обезличивание занимает 10 минут, а последствия утечки дороже.
Мифы, которые мешают начать
Миф первый: чистка данных это работа программиста. ChatGPT пишет код сам, вы описываете правила по-русски. Для проверки результата достаточно контрольных сумм. За два года работы с финансистами я не встретила ни одного, кому потребовалось знание Python для чистки через Code Interpreter.
Миф второй: нейросеть навредит данным. Наоборот, код выполняет одно действие одинаково для всех строк и не устаёт. Человек к третьему часу начинает пропускать, код нет. Ошибка возможна в логике промпта, а не в арифметике.
Миф третий: это дорого. ChatGPT Plus это стоимость подписки, а экономия на одной чистке от 2 до 8 часов в месяц. При ставке финдира 1 500-2 500 рублей в час подписка окупается в первый же месяц. Бесплатные альтернативы тоже существуют, я разбирала их в статье про бесплатные нейросети для Excel.
Миф четвёртый: нейросеть заменит бухгалтера. Нет. Она убирает механическую часть, но решение, какой дубль удалить и как склеить контрагентов, всегда за человеком. Финансист с нейросетью готовит данные быстрее и с меньшим стрессом, но без финансиста данные не станут отчётом.
Честные ограничения
Я не призываю переехать из Excel в ChatGPT навсегда. У инструмента есть границы, которые нужно знать до старта.
Нет памяти между сессиями. Файлы и код живут только в пределах одного чата. Решение: сохраняйте код в библиотеку после каждой чистки по промпту 10, тогда следующий месяц начинается с готового скрипта.
Не понимает бизнес-контекст сам по себе. ChatGPT не знает, что для вашей компании дубль это повтор в пределах 7 дней и что названия ООО Ромашка и ООО Ромашка-Трейд трогать нельзя. Правила вы описываете в промпте или принимаете решение сами. Это не слабость модели, это работа эксперта.
Сложно с очень большими файлами. ChatGPT Plus принимает файлы до 512 МБ, но на таблицах с 500 000+ строк Code Interpreter замедляется. Для таких объёмов разбивайте на периоды или агрегируйте в исходной системе.
Нестандартные форматы требуют настройки. Старые конфигурации 1С и региональные банки выгружают файлы с объединёнными ячейками и многоуровневыми шапками. На первичную отладку промпта уходит 15-30 минут, но потом шаблон работает годами.
И главное: нейросеть находит и чинит фактические дефекты, а решения о данных остаются за вами. Задвоенный платёж, спорный контрагент, неоднозначная строка это всегда решение финансиста, а не модели. Про то, как нейросети уверенно ошибаются в цифрах и как это проверять, я писала в статье про галлюцинации.
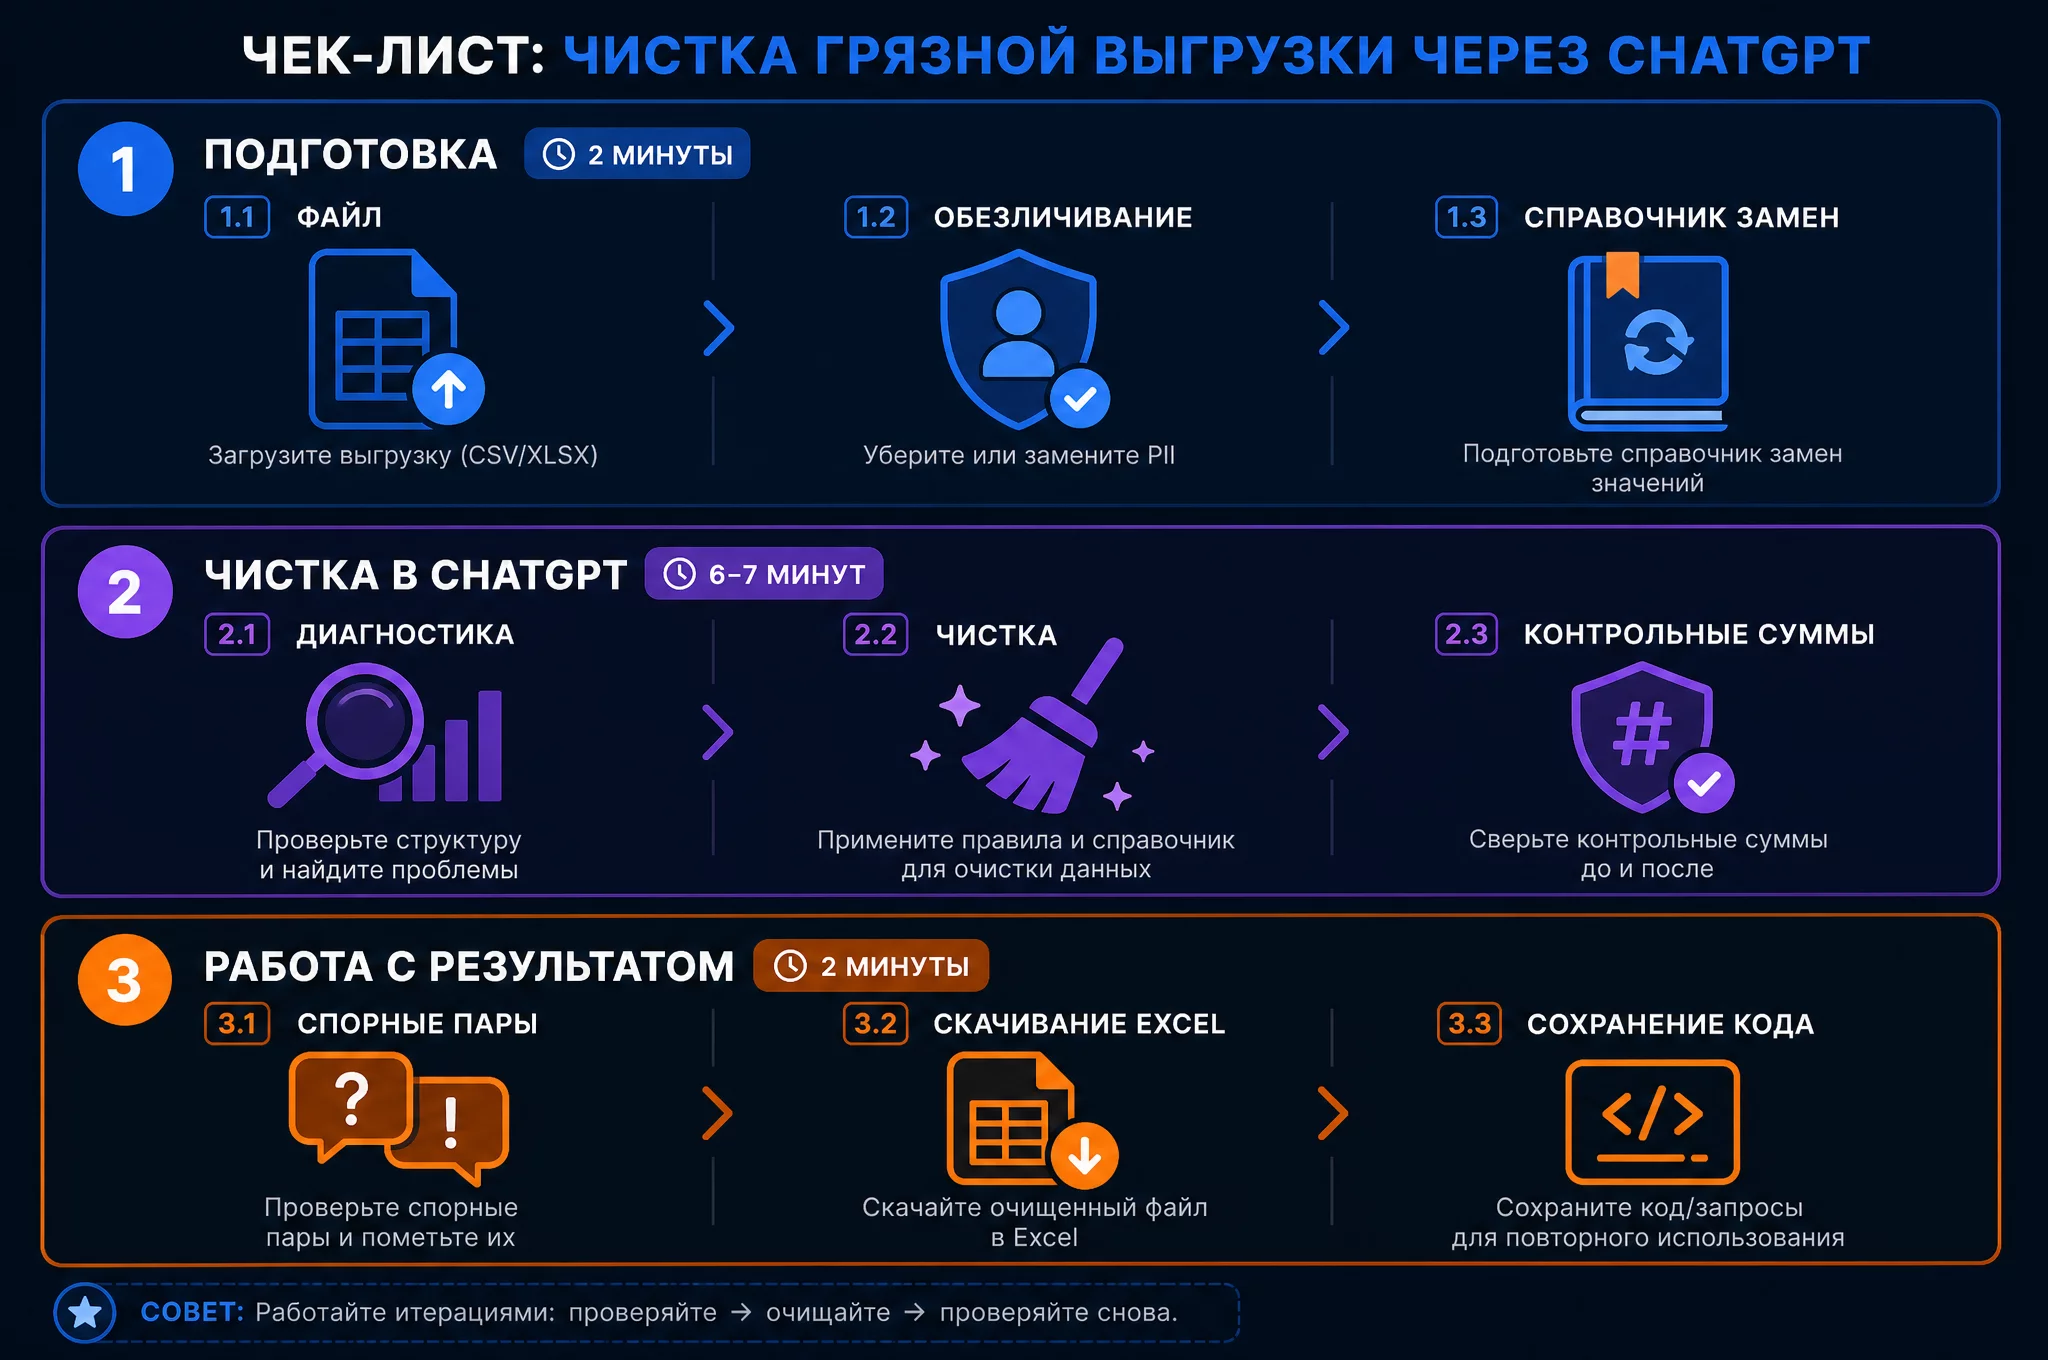
Чек-лист: чистка грязной выгрузки за 10 минут
Подготовка, 2 минуты
- Сохранить выгрузку из 1С, банка или CRM как .xlsx или .csv.
- Обезличить данные по справочнику замен: ИНН на К01, К02, названия на Контрагент 1, 2, 3.
- Сохранить справочник замен отдельно для расшифровки результата.
Чистка в ChatGPT, 6-7 минут
- Открыть chatgpt.com, тариф Plus, новый чат.
- Загрузить файл через кнопку прикрепления.
- Проверить первые строки и типы колонок в ответе ChatGPT.
- Отправить промпт 1, диагностику дефектов.
- Отправить промпт 2, универсальную чистку, или точечные промпты 3-8 под найденные дефекты.
- Дождаться выполнения кода, при ошибке просить исправить и повторить.
- Запустить контрольный промпт, проверить контрольные суммы.
Работа с результатом, 2 минуты
- Разобрать спорные пары справочника из списка ниже порога сходства.
- Скачать очищенный файл как Excel.
- Скопировать Python-код в библиотеку с пометкой тип выгрузки и период.
Три уровня автоматизации после первой чистки
ChatGPT в ручном режиме закрывает большинство задач. Но если вы чистите одни и те же выгрузки каждый месяц, есть смысл пойти дальше.
Уровень 1. Ручная чистка через ChatGPT, стартовый уровень, описан в этой статье. Загружаете файл руками, используете шаблонный промпт, скачиваете результат. Экономия 1,5-3 часа в месяц, порог входа 30-40 минут на первую настройку.
Уровень 2. Полуавтоматизация: Python-скрипт из кода ChatGPT. Берёте код, который ChatGPT написал для вашей чистки, сохраняете в .py-файл. Меняете две строки: имя файла и период. Запускаете в Google Colab бесплатно или локально. Данные никуда не уходят. Настройка занимает 1-2 часа, знание Python не нужно, ChatGPT помогает и с этим.
Уровень 3. Полная автоматизация через n8n. Сценарий: файлы автоматически попадают в папку, скрипт запускается по расписанию, результат записывается в Google Таблицы, уведомление приходит в Telegram. Финансист только проверяет результат. Подробно про n8n для финансиста разбираю в отдельной статье, а про готового AI-агента для сверки регистров первички в статье про агента.
Рекомендация: не перескакивайте на уровень 3, не освоив уровень 1. Автоматизировать нужно рабочий процесс, который уже работает, а не ломаный.
Хочешь получать готовые промпты для чистки данных и разборы новых AI-инструментов каждую неделю? Забирай бесплатно в Telegram-канале школы @findir_pro.
Часто задаваемые вопросы
Что значит «грязные данные» в выгрузках из 1С, банка и CRM? Грязные данные это выгрузка, которую нельзя использовать в расчётах без ручной подготовки. Типичные дефекты: суммы текстом из-за пробелов как разделителей тысяч, даты в разных форматах, лишние пробелы, дубли строк, объединённые ячейки, шапки и строки Итого, кривые написания контрагентов. Такую выгрузку нельзя сводить, группировать и строить отчёты, пока её не почистили.
Чем ChatGPT чистит данные лучше, чем Excel? Excel требует ручных действий на каждый дефект. ChatGPT через Code Interpreter пишет код на Python, который выполняет все операции за один проход по всем строкам одинаково. Нормализация, поиск дублей и склейка справочников описываются словами в промпте, код генерирует модель, результат скачивается файлом. Для ежемесячной чистки это экономия от 2 до 8 часов.
Какие файлы можно загружать в ChatGPT для чистки? Excel и CSV лучше всего. CSV идеален: суммы всегда числа, нет объединённых ячеек. Excel работает почти всегда, но требует проверки типов. PDF для чистки не подходит. Перед загрузкой реквизиты контрагентов обезличиваются по справочнику замен. Файлы до 512 МБ ChatGPT Plus принимает без проблем.
Как убрать дубли через ChatGPT? Загрузите файл и запустите промпт поиска дублей. ChatGPT найдёт точные дубли, повторы в пределах 3 дней и разбитые платежи. Для каждого покажет строки-кандидаты и общую сумму задвоенных операций. Решение, какие строки удалять, принимаете вы, ChatGPT сохранит очищенный файл.
Безопасно ли загружать выгрузку из 1С в ChatGPT? Только в обезличенном виде. Реальные ИНН, названия контрагентов, ФИО и расчётные счета в публичный ChatGPT не загружаем. Заменяем масками по справочнику. В настройках Data Controls отключаем Improve model for everyone. Для данных под NDA используем ChatGPT Enterprise или локальную модель вроде DeepSeek V3.2.
Какая модель лучше для чистки данных: GPT-5.5, Claude Sonnet 4.6 или Gemini 2.5? Для чистки таблиц с файлами удобнее ChatGPT Plus с Code Interpreter: загрузка, код, скачивание результата в одном чате. Claude Sonnet 4.6 точнее объясняет, что именно починил. Gemini 2.5 удобен в связке с Google Таблицами. DeepSeek V3.2 подходит для локального запуска. Для рутины разница в качестве не критична, важнее структура промпта.
Можно ли скачать очищенный файл обратно в Excel? Да. После чистки попросите ChatGPT сохранить результат как Excel или CSV и скачать. Дополнительно можно попросить отчёт о чистке: сколько строк убрано как дубли, сколько контрагентов склеено, какие суммы изменились.
Что делать, если ChatGPT не убрал все дубли или починил не всё? Уточните правила в том же чате: добавьте порог сходства, укажите ключевые колонки, опишите свои форматы. Попросите показать код и пробегитесь по шагам глазами. Запустите контрольные суммы: итог очищенной таблицы плюс сумма удалённых дублей должен равняться итогу исходной.
Наши каналы
Следите за новыми промптами, кейсами и разборами AI-инструментов для финансистов:
- @findir_pro основной Telegram-канал онлайн-школы «Финансовый директор | Мастер CFO», 45 000 подписчиков. Ежедневные разборы нейросетей для финансистов и бухгалтеров: промпты, кейсы, инструменты.
- @ai_finansist канал «АИ с Софьей и Натали», 13 000 подписчиков. Разборы новых моделей и стратегия внедрения AI в работу финансового директора и бухгалтера.
- MAX закрытое сообщество 5 000+ выпускников и учеников школы. Живые разборы кейсов, доступ к записям вебинаров, нетворкинг с коллегами-финансистами.
Об авторе
Натали Васильева эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO», основатель школы Софья Бурцева. С нейросетями в финансовых задачах с февраля 2023 года, 800+ выпускников курса AI-навыков. Веду Telegram-канал @findir_pro, 45 000 подписчиков.