AI для финансиста
Шпаргалка: 20 промптов для Excel в ChatGPT — чистка, сверка, формулы и сводные под задачи финансиста

Ещё год назад я тратила на закрытие месяца два-три дня, и почти всё это время уходило на таблицы: почистить выгрузку, свести два регистра, переписать формулы, собрать сводную для собственника. Сейчас тот же объём работы у меня занимает полтора-два часа, и делаю я его в диалоге с нейросетью. Меня зовут Натали Васильева, я эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO». С февраля 2023 года я помогаю финансистам и бухгалтерам встраивать нейросети в рабочие процессы, через курс «AI-навыки финансиста» прошли 800+ выпускников, наши каналы читают 45 000 человек в Telegram и 13 000 в канале «АИ с Софьей и Натали». Материал актуален на 10 сентября 2026 года.
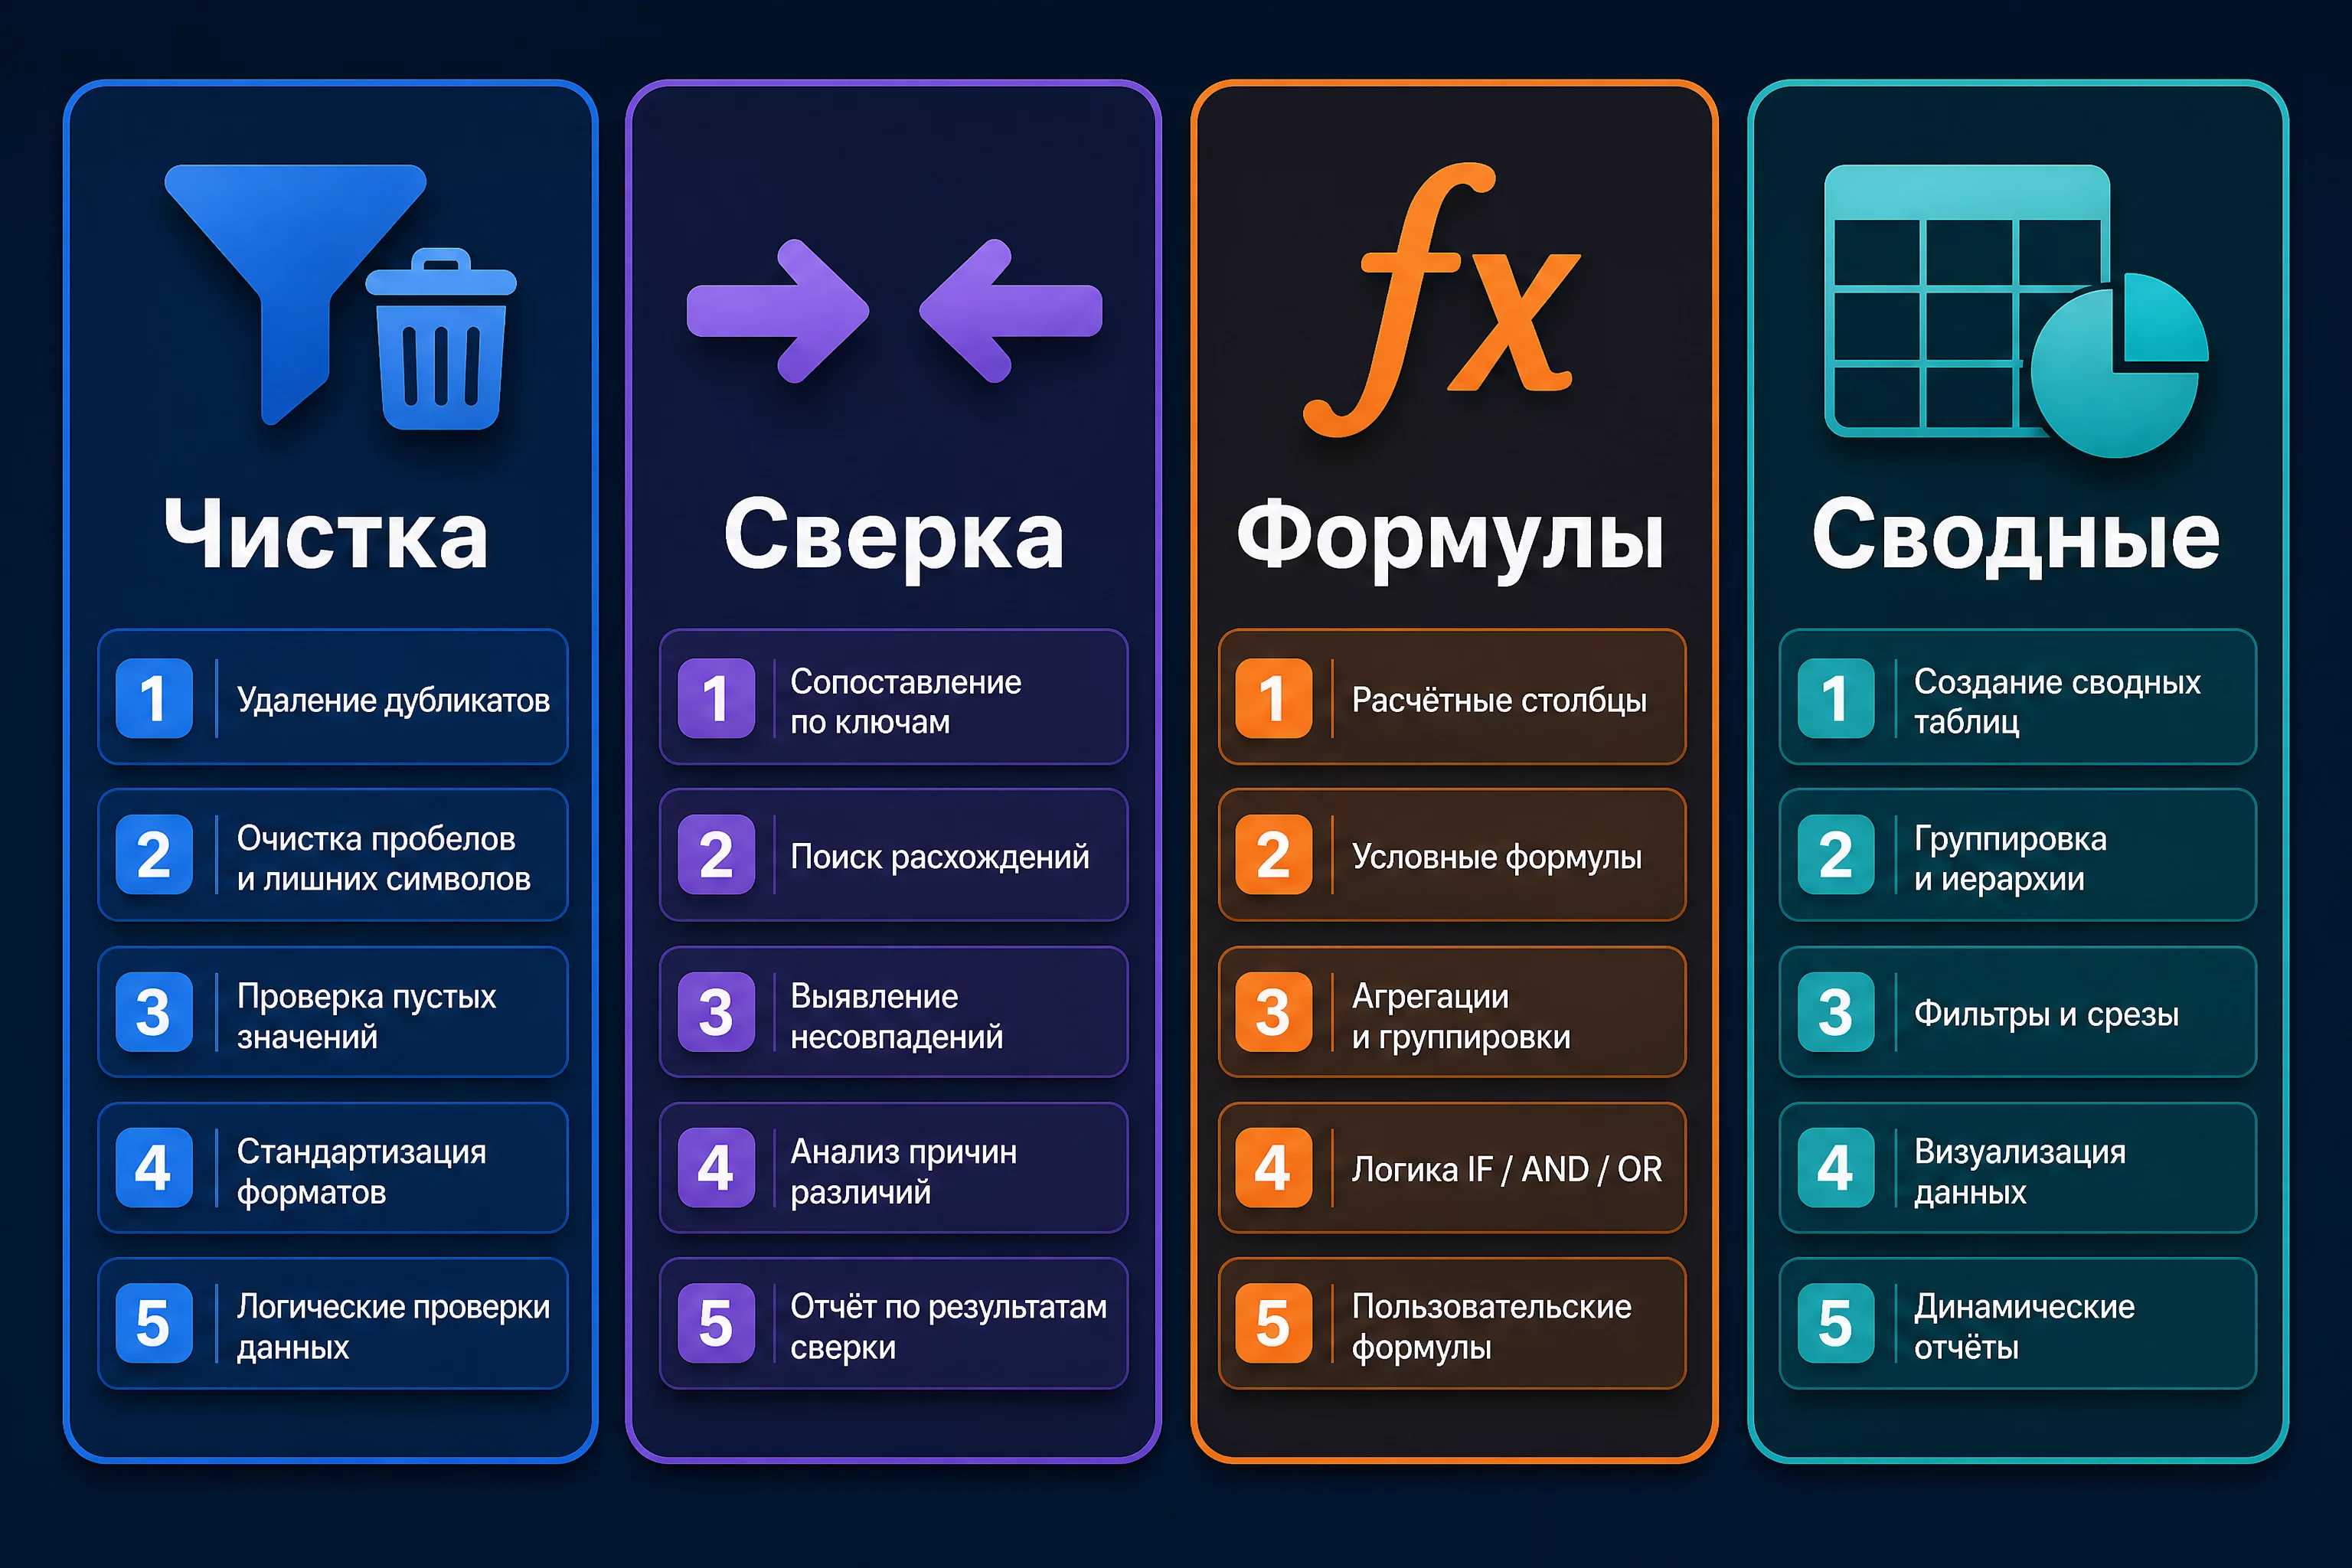
Эта статья не про то, как «спросить у ChatGPT что-нибудь про Excel». Это шпаргалка из двадцати готовых промптов, разложенных по четырём блокам: чистка выгрузки, сверка, формулы и сводные отчёты. Каждый промпт можно скопировать, подставить свои названия колонок и запустить через пять минут. Внутри также три кейса с часами и рублями, таблица сравнения моделей, правила безопасности и чек-лист, как собрать свой личный набор промптов за один вечер.
Если вы только начинаете работу с chatgpt.com, сначала посмотрите статью про базовые задачи нейросети для финансиста, там разобран вход в профессию с нуля. Здесь же мы сразу идём в глубину табличной рутины.
Что такое промпт для Excel и почему в 2026 году это отдельный навык финансиста
Промпт для Excel это текстовое задание, в котором вы описываете нейросети файл, правило расчёта и ожидаемый результат так, чтобы модель не угадывала, а выполняла. Отличие от обычного вопроса принципиальное. Вопрос «посчитай мне маржу» даёт ответ, который нельзя проверить. Промпт «вот таблица, вот правило расчёта, посчитай по нему, покажи ход и пересчитай итоги на Python» даёт результат, который можно сверить построчно.
Почему это стало отдельным навыком именно сейчас. В 2024 году модели уверенно писали формулы, но плохо держали структуру большой таблицы: теряли колонки, путали листы, придумывали данные. К 2026 году изменилось три вещи. Контекстное окно выросло настолько, что в диалог помещается книга на десятки тысяч строк. Появился встроенный интерпретатор Python, который считает по-настоящему, а не на словах. Модели научились работать с загруженными файлами как с объектами: открыть, преобразовать, вернуть готовый результат.
При этом качество работы по-прежнему упирается в промпт. По моим наблюдениям, типичный паттерн ошибок в 2026 году выглядит так: модель понимает задачу, но ломается на точности исполнения. Она может верно описать подход и ошибиться в одной строке. Или потерять часть строк при фильтрации и не заметить этого.
Второй источник ошибок серьёзнее и незаметнее. Модель проверяет себя по той же цепочке рассуждений, по которой считала. Если ошибка возникла в начале, все последующие проверки сойдутся, потому что сверяются с её же неверным результатом, а не с условием задачи. В моей практике разница между «посчитал сам» и «пересчитал внешним инструментом» видна почти на каждой большой таблице: без независимой проверки ошибка, возникшая в начале цепочки, спокойно доживает до финального отчёта. Разница не в модели, а в схеме работы.
Из этого вывода растёт главный принцип всей шпаргалки ниже:
- Промпт должен задавать рамки. Что за файл, что в колонках, что считается правильным, чего делать нельзя.
- Промпт должен требовать внешней проверки. Пересчёт на Python, сверка с эталоном, контроль количества строк до и после.
- Промпт должен запрещать догадки. Фраза «если данных не хватает, задай вопрос, а не выбирай за меня» убирает половину галлюцинаций.
Третья опора, которую нельзя пропустить: человек остаётся тем, кто подтверждает. В исследованиях о взаимодействии человека и ИИ различают два режима. Первый, когнитивный аутсорсинг: вы делегируете часть работы, но сохраняете контроль и сверяете результат с задачей. Второй, когнитивная капитуляция: вы принимаете ответ без проверки, и собственная аналитика не включается. По открытым работам на эту тему разница между режимами измеряется не процентами, а разы: при корректных подсказках модели точность решений растёт на десятки процентных пунктов, а при систематически неверных падает в разы. Промпт это инструмент, который удерживает вас в первом режиме.
Почему ChatGPT вообще справляется с таблицами: контекст, Python и модели 2026 года
ChatGPT работает с таблицами благодаря трём механизмам: анализатор файлов, интерпретатор кода и большое контекстное окно. Анализатор разбирает загруженный файл на структуру, интерпретатор считает на Python по-настоящему, контекст позволяет держать в диалоге всю книгу целиком. Понимание этих трёх механизмов сразу меняет то, как вы пишете промпт.
Анализатор файлов. Модель не читает вашу таблицу как человек, который листает лист. Она получает структурное представление: список листов, заголовки, типы данных, первые и последние строки, сводку по колонкам. Поэтому первая часть любого промпта должна описывать файл словами: что это за выгрузка, сколько в ней строк, что означает каждая колонка. Модель сопоставит ваше описание с тем, что видит, и расхождение сразу всплывёт.
Интерпретатор Python. Самая ценная часть. Когда вы просите «пересчитай итоги на Python и покажи код», модель не рассуждает, а выполняет. Расчёт идёт вне её языковой логики, поэтому самообман невозможен: либо сумма сходится, либо нет. Это ваш инструмент независимой проверки. Если модель посчитала на Python и получила другую цифру, чем при рассуждении, вы это увидите.
Контекстное окно. В 2026 году в диалог помещаются книги на десятки тысяч строк. Но объём это не только возможность, но и риск: чем больше данных, тем выше шанс, что модель «потеряет» часть. Отсюда практика: не грузить всё, а грузить нужное, и всегда просить в ответе указать, сколько строк было на входе и сколько на выходе.
Отдельная тема, о которой редко говорят вслух: не всякий «умный режим» полезен. По моим наблюдениям, повышение уровня рассуждений не всегда улучшает результат. Модель может начать рассуждать без запроса, добавлять в ответ оформление, которое вы не просили, и спорить с формулировкой задачи. Для таблиц это вредно: вам нужен предсказуемый исполнитель, а не философ. Поэтому в промпт стоит добавлять строку «отвечай строго по шаблону ниже, без вступлений и рассуждений в ответе».
Сколько это стоит. Тарифы на подписки и на токены меняются каждые несколько месяцев, поэтому конкретные цифры проверяйте на официальной странице сервиса перед началом работы. Общее наблюдение другое: кэширование повторяющихся частей запроса снижает стоимость типового диалога, поэтому не бойтесь делать промпт длинным и подробным. Длинный промпт с правилами дешевле, чем короткий, который приводит к трём переделкам.
Что умеет встроенный интерпретатор, а что нет
Границы важно понимать, иначе вы будете ждать от модели того, чего она не делает.
- Умеет: читать XLSX и CSV, склеивать таблицы, искать дубли, считать сводные, строить графики, экспортировать результат в файл.
- Умеет: писать и объяснять формулы Excel, включая ВПР, ИНДЕКС с ПОИСКПОЗ, СУММЕСЛИМН, ЛЯМБДА, Power Query M.
- Не умеет: надёжно работать с макросами VBA внутри вашего файла без вашего участия.
- Не умеет: гарантировать, что не потерял строки при фильтрации. Контроль количества на входе и выходе обязателен.
- Не умеет: знать вашу учётную политику. Правила расчёта задаёте вы.
Как устроена эта шпаргалка: 20 промптов в четырёх блоках
Шпаргалка построена по логике закрытия месяца: сначала данные приводятся в порядок, потом сверяются, потом по ним считаются формулы, и в конце собирается картинка для руководителя. Двадцать промптов равномерно распределены по четырём блокам, по пять в каждом.
| Блок | Задача | Промпты | Среднее время | Что на выходе |
|---|---|---|---|---|
| 1. Чистка | Привести выгрузку в нормальный вид | 1-5 | 30-40 минут | Готовая таблица без дублей и мусора |
| 2. Сверка | Сравнить два источника и найти расхождения | 6-10 | 25-40 минут | Список расхождений с суммами |
| 3. Формулы | Написать, объяснить, проверить формулы | 11-15 | 20-30 минут | Рабочие формулы и аудит старых |
| 4. Сводные и отчёты | Собрать управленческую картинку | 16-20 | 30-50 минут | Сводная, дашборд, текст для собственника |
Первые четыре промпта каждого блока даны полным текстом, чтобы можно было скопировать и запустить. Остальные собраны в короткие однострочники: это каркасы, которые вы дописываете под свою задачу. Всего в статье двенадцать полных промптов и восемь коротких каркасов, итого двадцать.
Важное правило нумерации: сохраняйте промпты под теми же номерами, что здесь. Через месяц вы будете искать нужный по номеру и названию, а не перечитывать текст целиком.
Блок 1. Чистка данных: 5 промптов, которые убирают хаос из выгрузки
Чистка это самая дорогая часть работы с таблицами, потому что она отнимает время, но не добавляет смысла. Выгрузка из 1С, отчёт из банка, файл от коллеги в свободной форме: везде свои объединённые ячейки, пустые строки-разделители, суммы текстом и даты в трёх форматах. Ниже пять промптов, которые закрывают эту часть.
Промпт 1. Полная чистка выгрузки
Промпт для первой встречи с незнакомым файлом. Он не меняет данные, а сначала показывает структуру и только потом предлагает план. Модель обязана спросить, если ей что-то непонятно.
Ты финансовый аналитик. Я загрузил выгрузку из учётной системы.

Шаг 1. Разбери структуру и покажи мне:
- сколько листов и строк в каждом;
- на какой строке находится настоящая строка заголовков;
- какие колонки содержат числа, какие текст, какие даты;
- где есть объединённые ячейки, пустые строки-разделители, итоги внутри данных.

Шаг 2. Предложи план приведения таблицы к нормальному виду: одна строка заголовков, один тип данных в колонке, ни одной объединённой ячейки, ни одной пустой строки внутри данных.

Шаг 3. После моего подтверждения выполни план и верни готовый файл.

Правила:
- ничего не додумывай и не заполняй пропуски своими значениями;
- если данных для решения не хватает, задай вопрос, а не выбирай вариант за меня;
- в конце укажи, сколько строк было на входе и сколько стало на выходе;
- приведи код на Python, которым ты это сделал, чтобы я повторил шаги на следующем файле.

Ответ дай строго по шагам, без вступлений и общих рассуждений.
Промпт 2. Приведение сумм и дат к единому формату
Самая частая проблема выгрузок: суммы приходят текстом с пробелами и знаком рубля, а даты встречаются в трёх форматах сразу. Формулы на таких данных дают нули или ошибку.
В загруженном файле колонки с суммами и датами.

Задача:
1. Найди все колонки, где числа хранятся как текст: пробелы внутри, знак рубля, запятая как разделитель, скобки вместо минуса.
2. Преобразуй их в настоящие числа с двумя знаками после запятой, формат отображения 1 234 567,89. Отрицательные значения оставь отрицательными, скобки разверни в минус.
3. Найди все колонки с датами. Приведи к формату ДД.ММ.ГГГГ. Отдельно перечисли строки, где дата не распозналась, и покажи исходное значение.
4. Посчитай контрольную сумму по каждой числовой колонке до и после преобразования. Если суммы разошлись, остановись и объясни, в каких строках.

В конце покажи код на Python и список строк, которые требуют моего решения.
Промпт 3. Поиск и разбор дублей
Дубли это не всегда ошибка. Иногда это две отгрузки в один день на одну сумму, и удалять их нельзя. Поэтому промпт не удаляет, а показывает кандидатов и просит решение у человека.
В файле найди дубли по связке ключевых колонок: номер документа, дата, сумма, контрагент.

Важно: ничего не удаляй.

Сделай так:
1. Покажи количество полных дублей (совпадают все четыре поля) и количество частичных (совпадают три из четырёх).
2. Выведи их отдельной таблицей с номером исходной строки, чтобы я нашёл её в Excel.
3. По каждой группе дай комментарий: похоже на технический дубль или на две разные операции.
4. Предложи правило, по которому можно автоматически отметить технические дубли, но не удаляй их.
5. Отдельно посчитай сумму, которую задваивает каждый найденный дубль. Это цена ошибки, если её пропустить.

Код на Python приложи.
Промпт 4. Поиск пропусков и разрывов в данных
Короткий каркас. Подставьте свои колонки и период.
Проверь файл на пропуски: пустые ячейки в обязательных колонках (номер, дата, сумма, контрагент), пропущенные месяцы в периоде, разрывы в нумерации строк. Выведи список пропусков с номерами строк и посчитай, сколько строк затронуто. Данные не заполняй и не исправляй.Промпт 5. Разбор «мусорных» значений
Ещё один каркас для грязных справочников.
Найди в текстовых колонках значения-близнецы: лишние пробелы в начале и конце, разный регистр, точки и запятые в названиях, сокращения одного и того же контрагента. Сведи их в таблицу «как написано / как должно быть» и покажи, сколько строк затронуто каждым вариантом. Ничего не заменяй без моего подтверждения.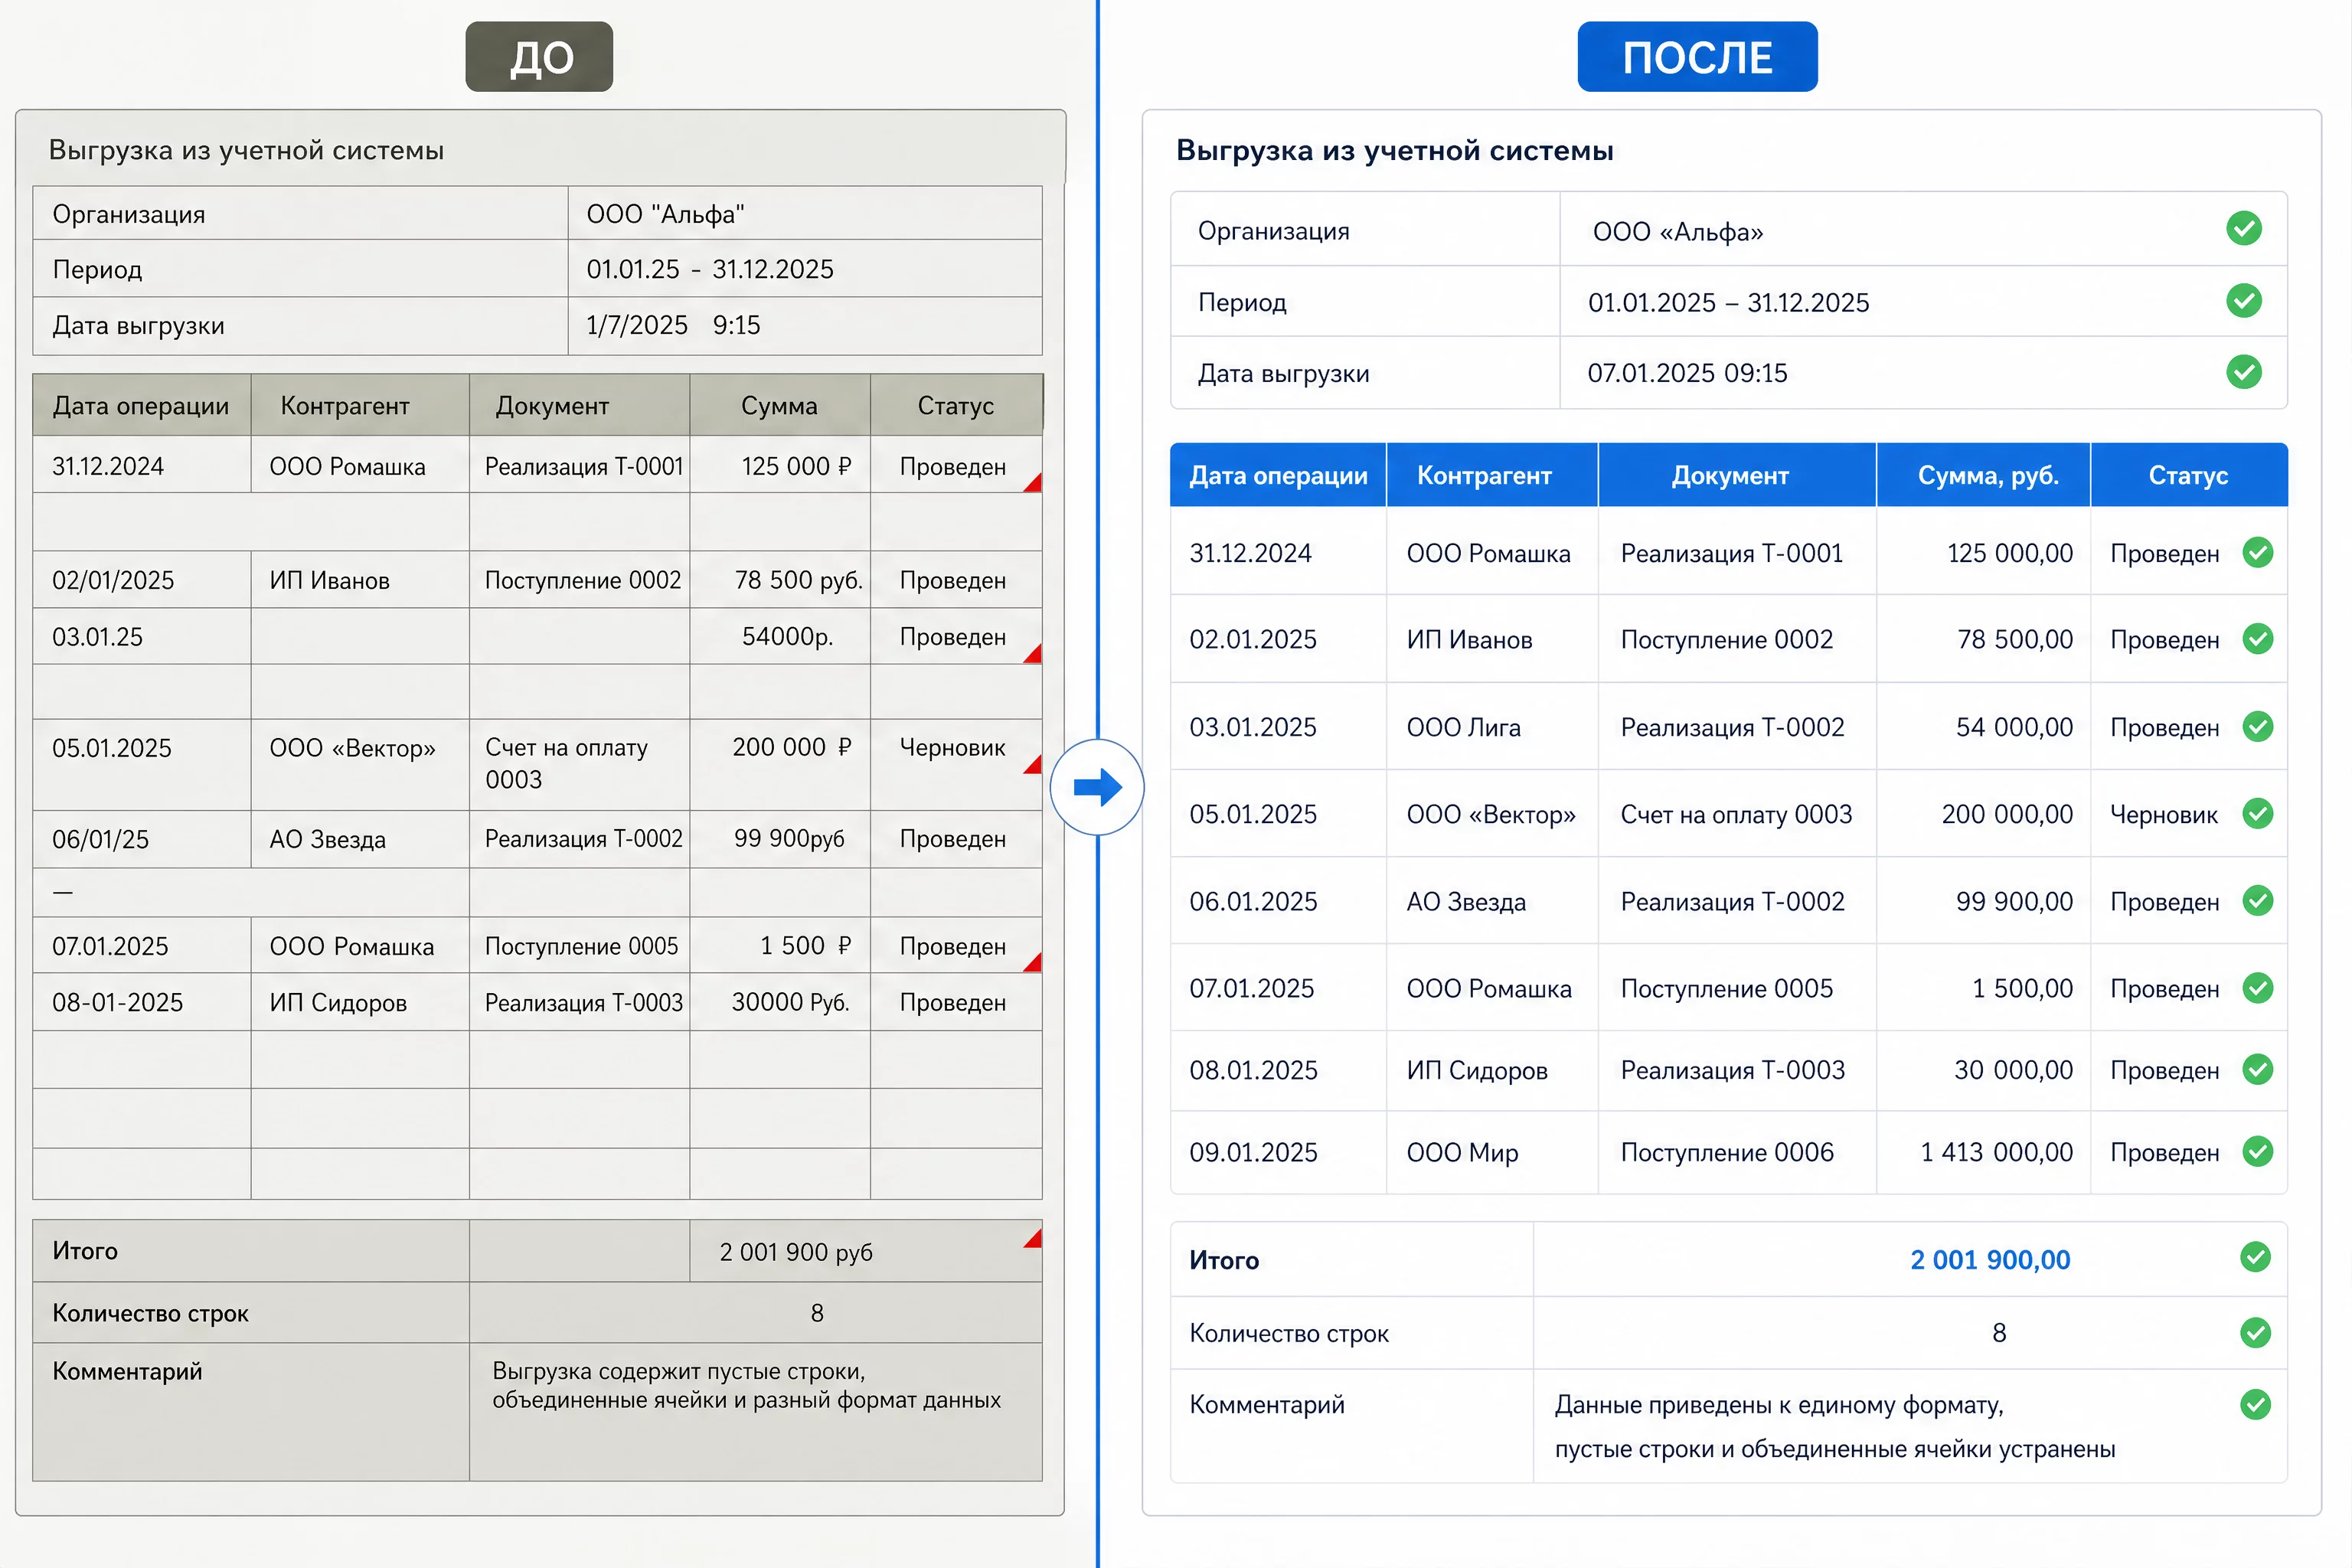
Блок 2. Сверка: 5 промптов для сличительных ведомостей и регистров
Сверка это задача, где нейросеть выигрывает у человека не скоростью, а внимательностью. Человек сверяет выборочно и устаёт на третьей тысяче строк. Модель проходит все строки и не пропускает ничего, если в промпте задано правило сравнения. Второй блок шпаргалки закрывает пять типовых сверок финансиста.
Промпт 6. Сверка двух файлов по ключу
Базовый промпт блока. Работает для сверки регистра с выгрузкой, накладных с реестром, платежей с назначением.
У меня два файла: файл А и файл Б. Нужна сверка по ключу.

Порядок работы:
1. Определи, какая колонка в каждом файле может служить ключом (номер документа, ИНН, номер счёта). Если однозначного ключа нет, предложи составной ключ из двух-трёх колонок и объясни выбор.
2. Проверь ключи на уникальность: если в файле есть повторы ключа, скажи об этом до начала сверки.
3. Сделай полную сверку и раздели результат на четыре группы:
   - есть в обоих файлах, суммы совпадают;
   - есть в обоих файлах, суммы расходятся (покажи обе суммы и разницу);
   - есть только в файле А;
   - есть только в файле Б.
4. По каждой группе посчитай количество строк и общую сумму.
5. Выведи итоговую строку: сумма расхождений, количество расхождений, доля расхождений от общего числа строк.

Правила: не округляй суммы, сравнивай до копеек. Регистр букв в ключе не важен. Код на Python приложи.
Промпт 7. Сверка, где суммы разошлись из-за нескольких документов
Частая ситуация: одна накладная в одном файле разбита на три строки в другом, или наоборот. Простой построчный поиск такие случаи не находит.
Сверка с агрегацией. В файле А одна строка соответствует нескольким строкам файла Б (или наоборот).

Задача:
1. Сгруппируй оба файла по ключу и посчитай сумму внутри каждой группы.
2. Сравни агрегированные суммы, а не построчные.
3. Для каждой группы, где суммы совпали только после агрегации, покажи разбивку: сколько строк в каждой части.
4. Отдельно выдели группы, где расхождение осталось после агрегации, и приведи разницу в рублях.
5. Обрати внимание на возможность дублей внутри группы: если сумма расходится ровно в два раза или в три раза, отметь это отдельно.

Ничего не удаляй и не исправляй в исходных данных. Код на Python приложи.
Промпт 8. Критический пересчёт на Python
Самый сильный промпт всей шпаргалки. Он заставляет модель проверить себя внешним расчётом, а не собственной логикой. Применяйте к любой задаче, где итог уходит наружу.
Критический пересчёт.

Возьми результат, который ты только что получил, и проверь его независимым способом:
1. Посчитай всё заново на Python, не используя свои предыдущие рассуждения.
2. Покажи промежуточные итоги: количество строк на каждом шаге, сумму по каждой колонке, контрольные точки после каждой операции фильтрации или группировки.
3. Сравни новый расчёт с прежним ответом. Если цифры разошлись, найди, на каком именно шаге, и объясни причину.
4. Если расхождений нет, всё равно приведи контрольные суммы, чтобы я мог сверить их с Excel.
5. Специально поищи три самые вероятные ошибки: потерянные строки при фильтрации, неверное определение типа данных, задвоение при соединении таблиц. По каждой скажи, проверил ты её или нет.

Не подтверждай мой результат из вежливости. Если он неверен, скажи прямо.
Промпт 9. Сверка остатков на конец периода
Каркас для сверки сальдо.
Сверь входящий остаток, обороты и исходящий остаток по каждому счёту: должно выполняться равенство «входящий плюс обороты равно исходящий». Найди счета, где равенство нарушено, и покажи разницу. Отдельно перечисли счета, которые есть в одном источнике и отсутствуют в другом.Промпт 10. Подготовка акта сверки
Каркас для документа, который уходит контрагенту.
Сформируй проект акта сверки с контрагентом: шапка с реквизитами (заменёнными на маски), таблица операций по датам, колонки «по данным нас», «по данным контрагента», «расхождение», итоги по периодам. В конце список расхождений с суммами и предполагаемыми причинами. Ничего не добавляй от себя.Отдельно про сверку больших массивов: если строк десятки тысяч, разбейте сверку на части по месяцам. Так вы получите контрольные суммы по каждому периоду и сразу увидите, где именно расхождение, вместо одной непроверяемой цифры на выходе. Подробнее про такую схему читайте в статье про сверку двух Excel-файлов.
Блок 3. Формулы: 5 промптов, чтобы Excel считал то, что нужно
Формулы это та часть работы, где финансист чаще всего защищает свою репутацию. Ошибка в формуле живёт в таблице годами, потому что итог на экране выглядит правдоподобно. Третий блок шпаргалки закрывает и написание новых формул, и аудит старых.
Промпт 11. Написание формулы по описанию логики
Не просите «сделай ВПР». Просите формулу по правилу: так модель не выберет удобный ей, но неверный подход.
Нужна формула Excel. Не пиши её сразу, сначала разбери логику.

Контекст задачи:
- лист «Данные», в нём операции: дата (A), контрагент (B), договор (C), сумма (D), статус оплаты (E);
- лист «Свод», в нём список контрагентов (A) и месяцев (B);
- нужен итог: сумма оплаченных операций по контрагенту и месяцу.

Порядок работы:
1. Сформулируй правило расчёта своими словами и покажи, какие колонки в нём участвуют.
2. Предложи два варианта формулы: СУММЕСЛИМН и вариант с ЛЯМБДА или Power Query, если данных много. Объясни, когда какой лучше.
3. Выдай финальную формулу для ячейки C2 листа «Свод» с абсолютными ссылками, чтобы её можно было протянуть вниз и вправо.
4. Перечисли три типовые ошибки, из-за которых такая формула может дать неверный результат: разрывы диапазонов, текстовые суммы, разные форматы дат.
5. Покажи, как проверить формулу: контрольная сумма по одному контрагенту, посчитанная другим способом.

Формулу дай текстом, чтобы я скопировал её в Excel.
Промпт 12. Аудит существующих формул
Промпт для проверки книги перед сдачей отчёта. Он ищет логические ошибки, которые Excel не считает ошибками.
Проверь формулы в загруженном файле.

Ищи семь типов проблем:
1. Разорванный диапазон после вставки строки (часть строк выпала из суммы).
2. Ссылка на соседнюю строку вместо нужной.
3. Верная арифметика при неверной логике: например, сумма вместо процентного отношения.
4. Потерянная проверка на ноль или на пустое значение.
5. Разные формулы в одном столбце, хотя логика должна быть одинаковой.
6. Жёстко вписанные числа вместо ссылок на ячейки.
7. Формулы, чей результат не меняется при изменении исходных данных.

По каждой находке дай: адрес ячейки, саму формулу, объяснение, почему это проблема, и исправленный вариант. Если в столбце всё в порядке, скажи прямо, что проверено и замечаний нет.
Промпт 13. Перевод логики из головы в формулу
Частый случай: вы с коллегой обсуждаете правило словами, и никто не может записать его формулой. Нейросеть делает этот перевод.
Переведи бизнес-правило в формулу Excel.

Правило словами:
«Если контрагент из группы А и оплата пришла в течение 30 дней после отгрузки, ставим коэффициент 1. Если оплата позже 30, но в пределах 60 дней, коэффициент 0,8. Если позже 60 дней или оплаты нет, коэффициент 0,5. Для контрагентов группы Б все коэффициенты умножаются на 1,2, но не выше 1».

Что нужно:
1. Разложи правило на условия и покажи их списком, чтобы я проверил логику до написания формулы.
2. Отдельно перечисли пограничные случаи: ровно 30 дней, ровно 60 дней, пустая дата оплаты, отрицательное число дней.
3. Скажи, как правило ведёт себя в каждом пограничном случае, и предложи, как его уточнить.
4. Выдай формулу для Excel 365, затем её же вариант для старой версии.
5. Приведи три тестовых примера с исходными данными и ожидаемым результатом, чтобы я проверил формулу на них.
Промпт 14. Лямбда-функции и повторяющиеся расчёты
Каркас для тех, кто устал копировать одну и ту же формулу по сотне листов.
Напиши ЛЯМБДА-функцию для повторяющегося расчёта: [опишите расчёт]. Объясни, как её зарегистрировать через диспетчер имён, как вызвать на листе и как передать массив данных. Покажи, как та же логика выглядит в Power Query, и скажи, какой вариант выбрать, если листов станет 50.Промпт 15. Разбор чужой формулы
Каркас для ситуации «нашёл формулу в наследство, не понимаю, что она делает».
Объясни пошагово, что делает эта формула: [вставьте формулу]. Разбери её на части, покажи, что возвращает каждый блок, на каких данных она сломается и что вернёт при пустых значениях. Предложи более читаемый вариант с тем же результатом.Если ваша задача шире, чем формулы, и упирается в подготовку данных, посмотрите статью про Power Query и ChatGPT: там разобрано, как перенести чистку из ручных операций в повторяемый запрос.
Блок 4. Сводные и отчёты: 5 промптов для управленческой картинки
Сводные это то, что видит руководитель, и здесь нейросеть даёт самый заметный эффект по времени. Человек собирает сводную за полдня, модель за минуты, если в промпте описана структура будущей таблицы. Четвёртый блок шпаргалки закрывает пять задач: сводная, дашборд, динамика, отклонения и текст для собственника.
Промпт 16. Сборка сводной таблицы
Промпт описывает будущую структуру до того, как модель к ней приступит. Это исключает ситуацию «модель сделала красиво, но не то».
Собери сводную таблицу из загруженного файла операций.

Данные: дата операции, контрагент, статья ДДС, проект, сумма, валюта.

Структура сводной, которую мне нужно получить:
- строки: статьи ДДС, внутри статьи группировка по проектам;
- колонки: месяцы с января по декабрь плюс итог за год;
- значения: сумма, доля статьи в общем итоге в процентах, изменение к прошлому месяцу в процентах;
- внизу итоговая строка по всем статьям.

Порядок:
1. Сначала покажи, какие уникальные значения есть в колонках «статья ДДС» и «проект». Если увидишь похожие названия-дубликаты, скажи мне до сборки.
2. Собери сводную.
3. Отдельно выведи три проверки: общая сумма по исходным данным, общая сумма по сводной, разница между ними.
4. Отрицательные значения оставь отрицательными, не переводи в модуль.

Верни результат файлом, который я смогу открыть в Excel.
Промпт 17. Анализ отклонений план-факт
Один из самых востребованных промптов у финансистов. Работает как по бюджету, так и по любой другой паре «план и факт».
Проанализируй отклонения факта от плана.

Файл содержит: статья, план, факт за период, план и факт накопленным итогом.

Что нужно:
1. Посчитай отклонение в рублях и в процентах по каждой статье отдельно для периода и для накопленного итога.
2. Отсортируй статьи по величине отклонения в рублях, от самого крупного.
3. Раздели отклонения на четыре группы: перерасход существенный (более 10 процентов и более 100 000 рублей), перерасход несущественный, экономия существенная, экономия несущественная.
4. Для каждой статьи из первой группы дай три гипотезы причины отклонения, основанные только на данных файла. Если данных для гипотезы не хватает, напиши «недостаточно данных» вместо догадки.
5. Посчитай, сколько всего перерасхода дают пять крупнейших статей, и какую долю это составляет от общего перерасхода.
6. Отдельно проверь статьи, где план равен нулю, а факт нет. Это самая частая причина неверных процентов.

Тон ответа: сухо, только по данным, без общих слов про важность контроля бюджета.
Промпт 18. Сборка управленческого отчёта для собственника
Промпт для финального шага: превратить таблицы в короткий текст, который прочитает занятой человек.
Собери управленческий отчёт для собственника на одной странице.

Исходные данные: [приложите сводные, отчёт о прибылях, движение денег].

Структура:
1. Три главных вывода периода, каждый одной фразой с цифрой.
2. Отчёт о прибылях: выручка, валовая маржа, операционные расходы, прибыль. По каждой строке факт, план, отклонение в рублях и процентах, комментарий в одно предложение.
3. Движение денег: остаток на начало, поступления, платежи, остаток на конец, минимальный остаток внутри периода.
4. Риски: три пункта, каждый с цифрой и сроком.
5. Что требуется от собственника: список решений, если они нужны.

Правила:
- никаких прилагательных-усилителей («значительный рост», «серьёзное падение»), только цифры;
- каждое утверждение должно опираться на строку из моих данных;
- если по какому-то блоку данных нет, напиши «данных нет», а не заполняй пробел общими словами;
- объём: не более 400 слов.

В конце дай этот же отчёт в виде тезисов для устного доклада на пять минут.
Промпт 19. Динамика и тренды
Каркас для анализа ряда.
Посчитай по каждому месяцу: абсолютное значение, изменение к предыдущему месяцу, изменение к тому же месяцу прошлого года, долю в годовом итоге. Найди месяцы с аномальными скачками (отклонение от среднего более чем на 30 процентов) и покажи их отдельно. Ничего не сглаживай и не исключай из расчёта.Промпт 20. Готовый дашборд из таблицы
Каркас для визуализации.
Из загруженной таблицы построй дашборд: динамика выручки по месяцам, структура расходов, топ-10 контрагентов по сумме, отклонение факта от плана. Выбери типы графиков под смысл данных и объясни выбор. Оформи в едином стиле, подпиши оси и единицы измерения. Верни готовый файл и короткое описание, что видно на каждом графике.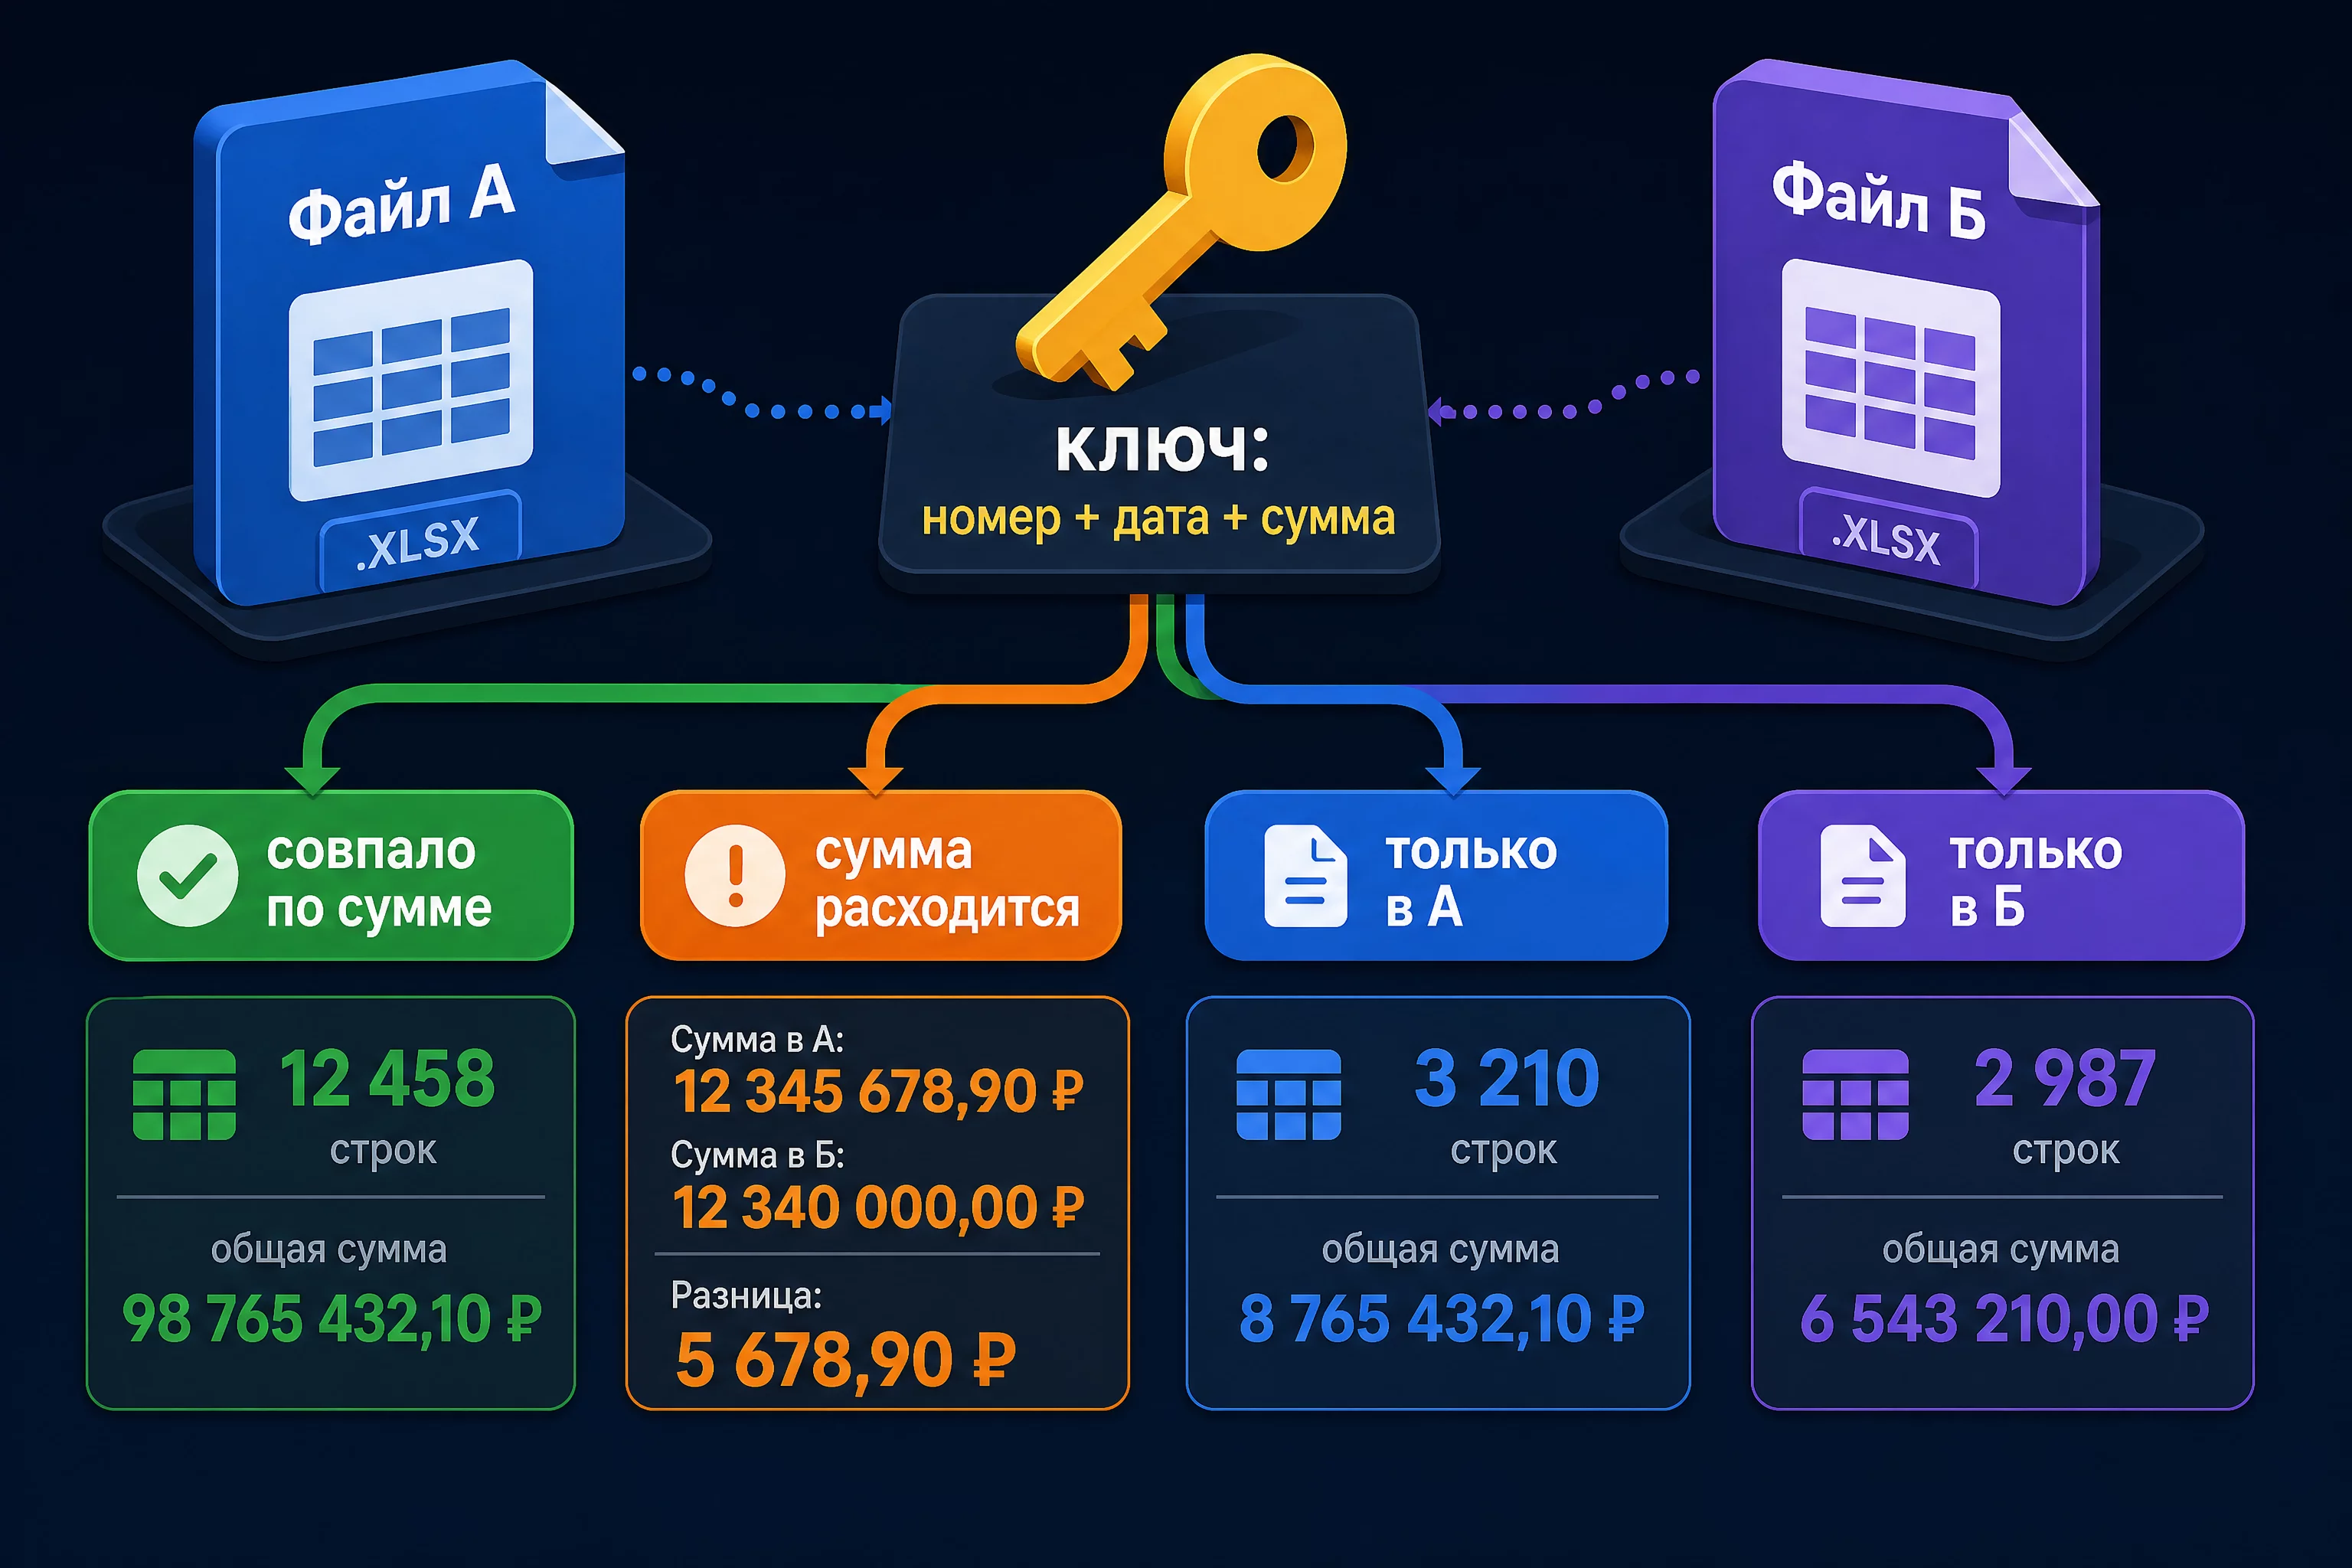
Какая нейросеть лучше для Excel в 2026 году: GPT-5.5, Claude Sonnet 4.6, Gemini 2.5 или DeepSeek V3.2
Для табличных задач подходит не любая модель, и разница между ними в 2026 году заметная. Общее правило простое: чем более массовая и механическая операция, тем менее требовательна модель; чем сложнее логика и длиннее книга, тем важнее качество рассуждений.
| Модель | Сильная сторона в Excel | Слабое место | Цена | Когда выбирать |
|---|---|---|---|---|
| GPT-5.5 | Чистка, массовые операции, сводные, экспорт готовых файлов | Может уйти в лишние рассуждения в ответе | Средняя | Основная рабочая модель для 80 процентов задач |
| Claude Sonnet 4.6 | Длинные книги, сложная вложенная логика, аккуратные формулировки | Иногда переносит условия из примеров в текущую задачу | Средняя | Аудит формул, разбор больших реестров, работа с договорами |
| Gemini 2.5 | Google Таблицы, совместная работа, интеграция с документами | Слабее на многошаговых преобразованиях внутри одного файла | Средняя | Если таблицы живут в Google Sheets |
| DeepSeek V3.2 | Бесплатные черновые прогоны, простые преобразования | Точность на сложной логике ниже | Низкая | Черновики на обезличенных данных, обучение |
Несколько практических замечаний, которые сэкономят вам часы.
Не гоняйтесь за самой дорогой моделью. На типовых табличных операциях разница между топовой и средней моделью в качестве результата часто меньше, чем разница в цене. Дорогую модель стоит брать там, где ошибка дороже прогона: аудит формул перед сдачей отчётности, сложная логика распределения, разбор длинного договора.
Дайте модели второй шанс на другой модели. Если результат сомнительный, прогоните ту же задачу через другую модель и сравните. Расхождение в цифрах это сигнал, что промпт где-то не задаёт правило. Совпадение на сложной задаче это хороший признак.
Следите за режимом рассуждений. По моим наблюдениям, более высокий уровень рассуждений не всегда даёт лучший результат: модель начинает рассуждать в ответе без запроса, добавлять оформление и спорить с формулировкой. Для таблиц выбирайте режим, где модель следует инструкции, а не тот, где она «думает больше».
Сравнение актуально на сентябрь 2026 года. Модели обновляются каждые несколько месяцев, поэтому перед крупной задачей проверяйте, что вы работаете на текущей версии, и не бойтесь переключаться. Если хотите общий разбор выбора модели под задачи финансиста, посмотрите статью какую нейросеть выбрать финансисту.
Три кейса: сколько часов и рублей экономит шпаргалка
Кейсы ниже из моей практики и практики выпускников курса. Имена и названия компаний изменены, цифры оставлены как есть.
Кейс 1. Закрытие месяца по выгрузке из 1С: 3 дня превратились в 2 часа
Было. Финансовый директор небольшой производственной компании закрывала месяц в одиночку. Выгрузка из 1С приходила с объединёнными ячейками, датами в трёх форматах и суммами текстом. Дальше следовали ручная чистка, сверка с банковской выпиской, пересборка формул в отчёте. Три дня каждый месяц, из них два полных дня на таблицы.
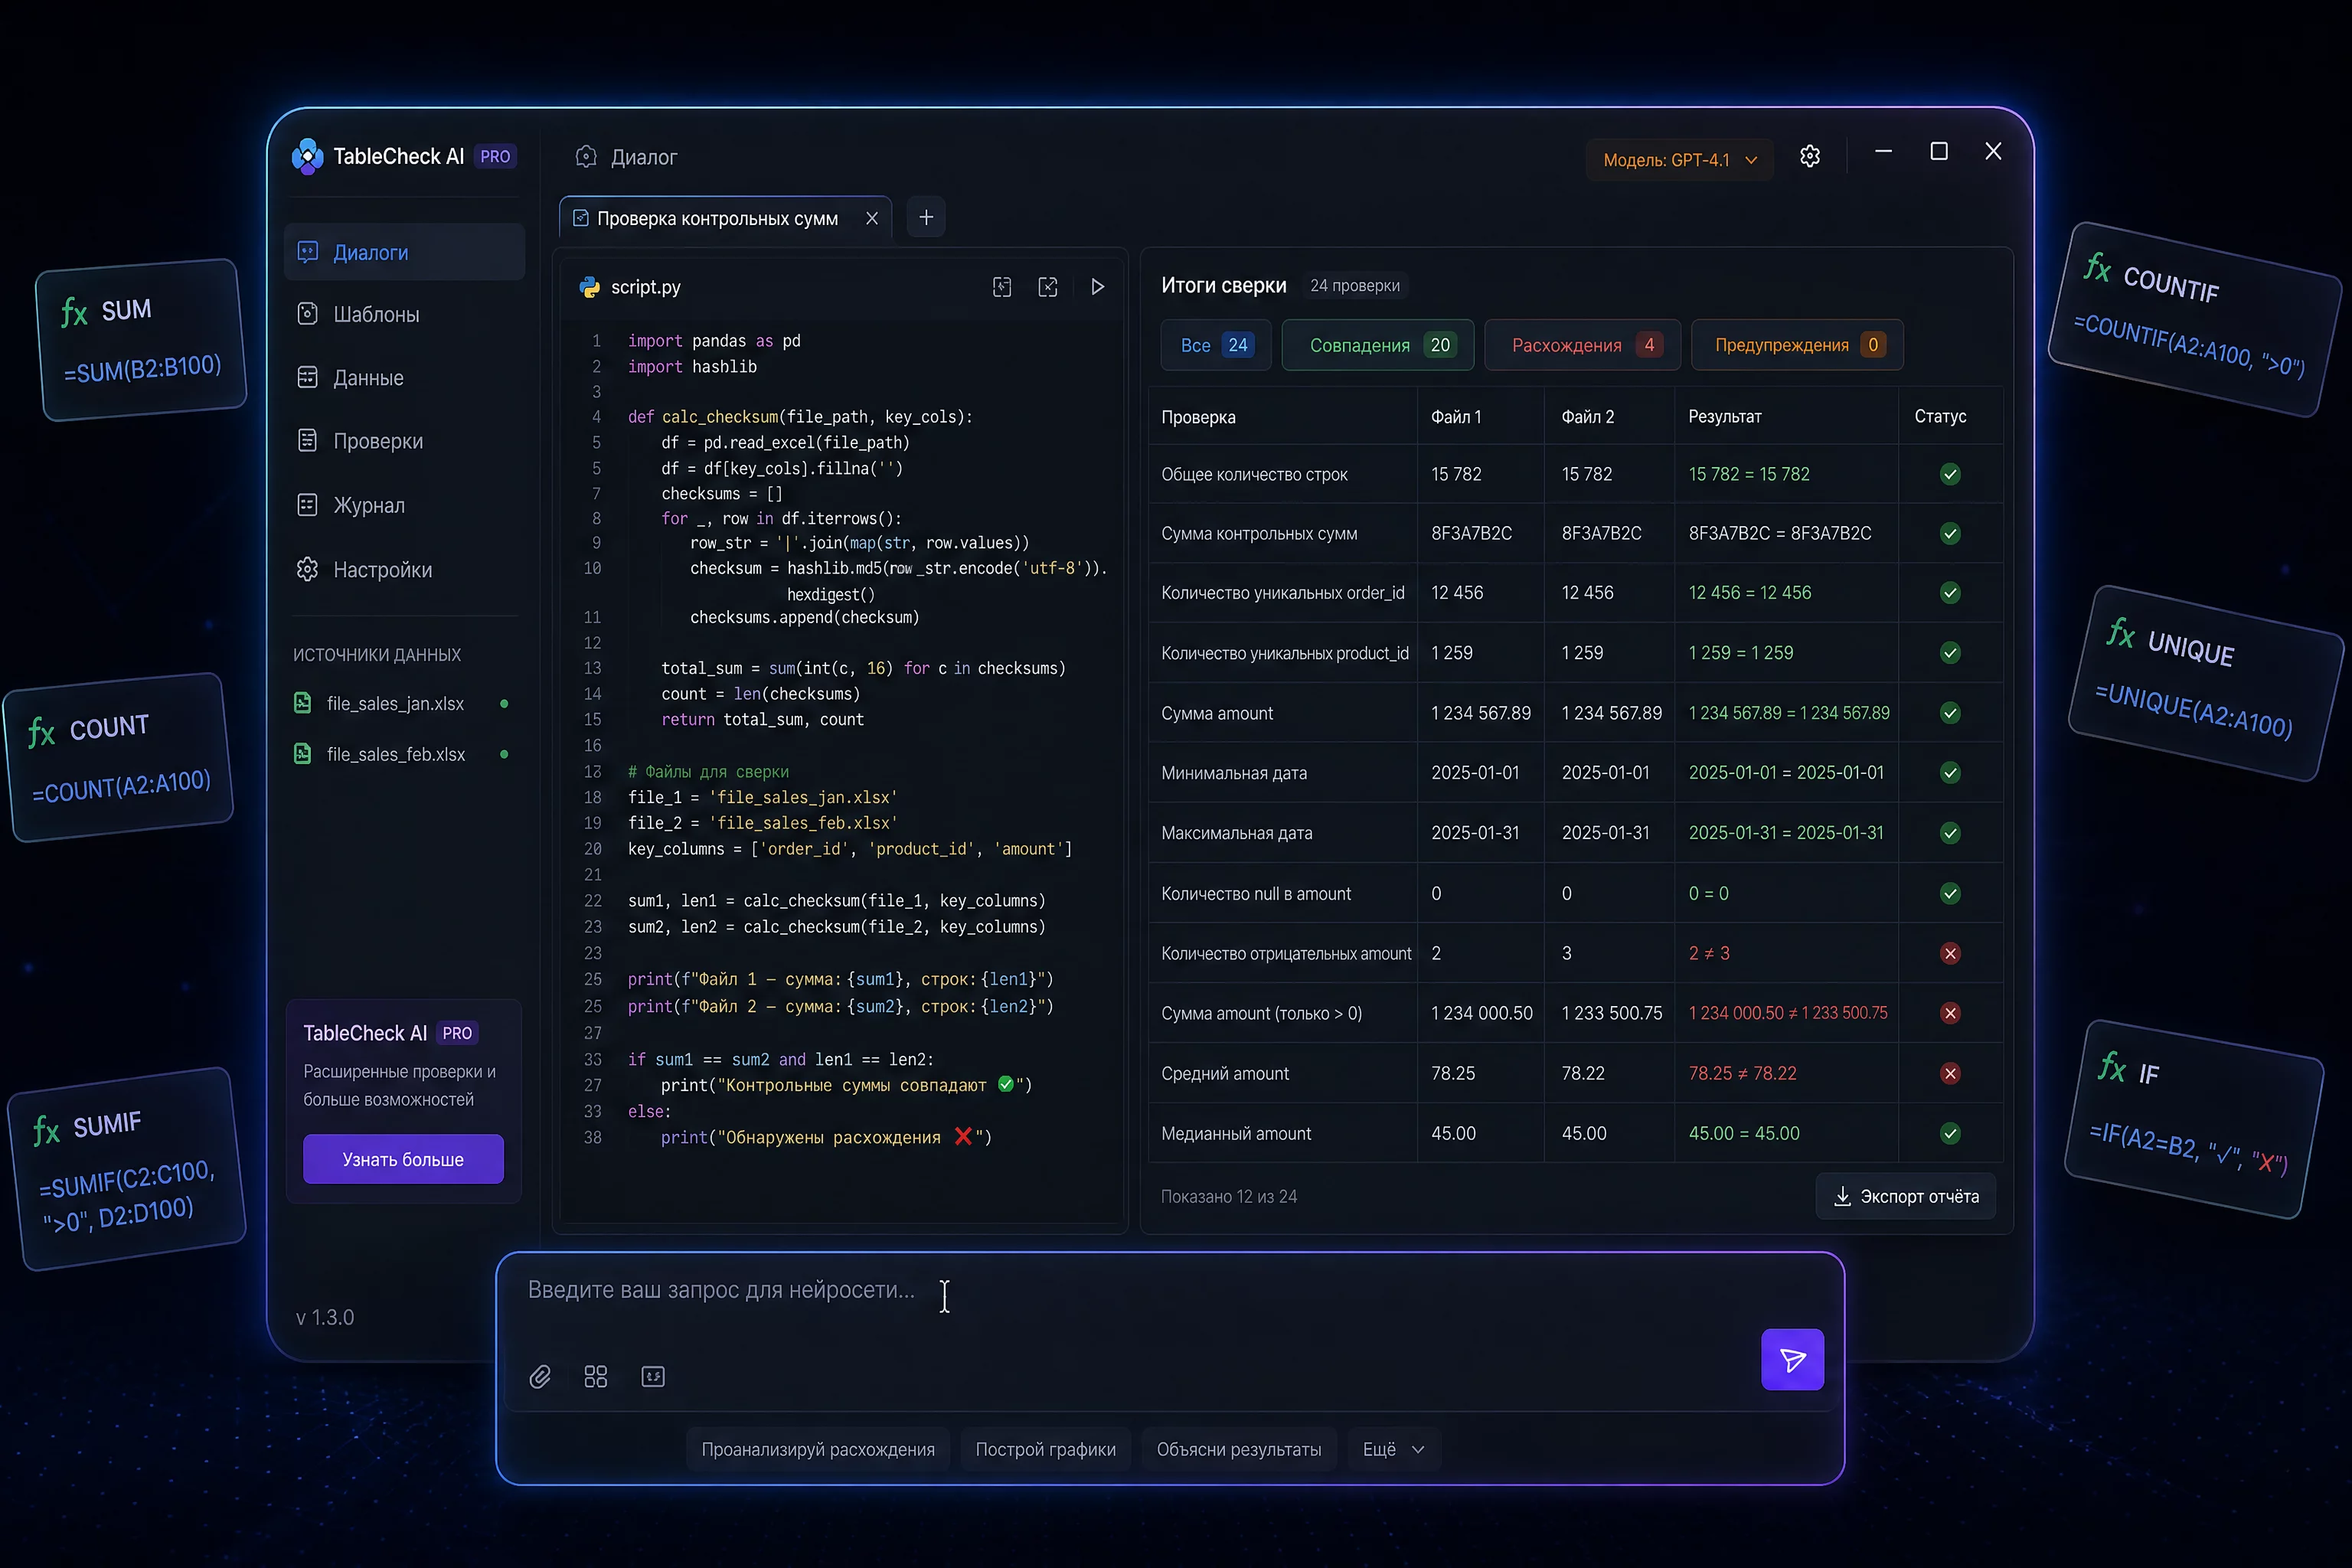
Что сделали. Собрали набор из пяти промптов: чистка структуры, приведение типов, поиск дублей, сверка с выпиской, критический пересчёт итогов. Первый прогон занял вечер, потому что пришлось описывать структуру выгрузки и дописывать правила. Второй и последующие месяцы шли по готовому шаблону.
Стало. Закрытие месяца с 3 дней до 2 часов, из которых заметная часть уходит на обезличивание и загрузку, а остальное на проверку находок. По моим оценкам, высвобождается порядка 15-20 часов в месяц. В деньгах это просто посчитать по своей ставке: в моей практике у финдиров производственных компаний это давало сотни тысяч рублей высвобожденного времени в год.
Кейс 2. Сверка двух регистров на 18 000 строк: 25 минут вместо 2 дней
Было. Бухгалтер крупной торговой компании сверяла реестр реализации с данными учётной системы. 18 000 строк, расхождения в единицах и в суммах, часть накладных разбита на несколько строк. Ручная сверка с ВПР занимала два дня и всё равно оставляла ощущение, что где-то пропущено.
Что сделали. Применили промпт сверки с агрегацией и промпт критического пересчёта. Отдельно попросили модель посчитать контрольные суммы по каждому месяцу, чтобы разбить поиск расхождений на части.
Стало. Первый прогон дал список расхождений за 25 минут. Часть находок подтвердилась как реальные ошибки, которые при ручной сверке не находили, часть оказалась не ошибками, а особенностью учёта, и это тоже сэкономило время на разбирательстве. Точные количество позиций и сумму здесь не привожу: это клиентские данные, а придумывать красивые цифры я не хочу. Два дня ручной работы превратились в 25 минут машинной и полдня на проверку находок.
Кейс 3. Управленческий отчёт для собственника: неделя превратилась в полтора часа
Было. Финансовый аналитик готовил ежемесячный отчёт для собственника по семи разрезам: выручка, маржа по направлениям, расходы, движение денег, дебиторка, кредитный портфель, отклонения от бюджета. Сбор данных и вёрстка занимали 4-5 рабочих дней, потому что каждый раз всё пересобиралось заново.
Что сделали. Разложили отчёт на четыре промпта: сводная по месяцам, анализ отклонений план-факт, движение денег, текстовый отчёт на одну страницу. Каждый промпт описывает фиксированную структуру результата, поэтому выходные файлы всегда выглядят одинаково.
Стало. Сбор отчёта занимает полтора часа. Главный эффект оказался не в скорости, а в том, что структура перестала меняться от месяца к месяцу. Собственник привык к одному виду отчёта, и обсуждение сразу начинается с цифр, а не с вопроса «а почему в этот раз по-другому». Отдельная экономия: аналитик освободил четыре дня в месяц под анализ, а не под вёрстку.
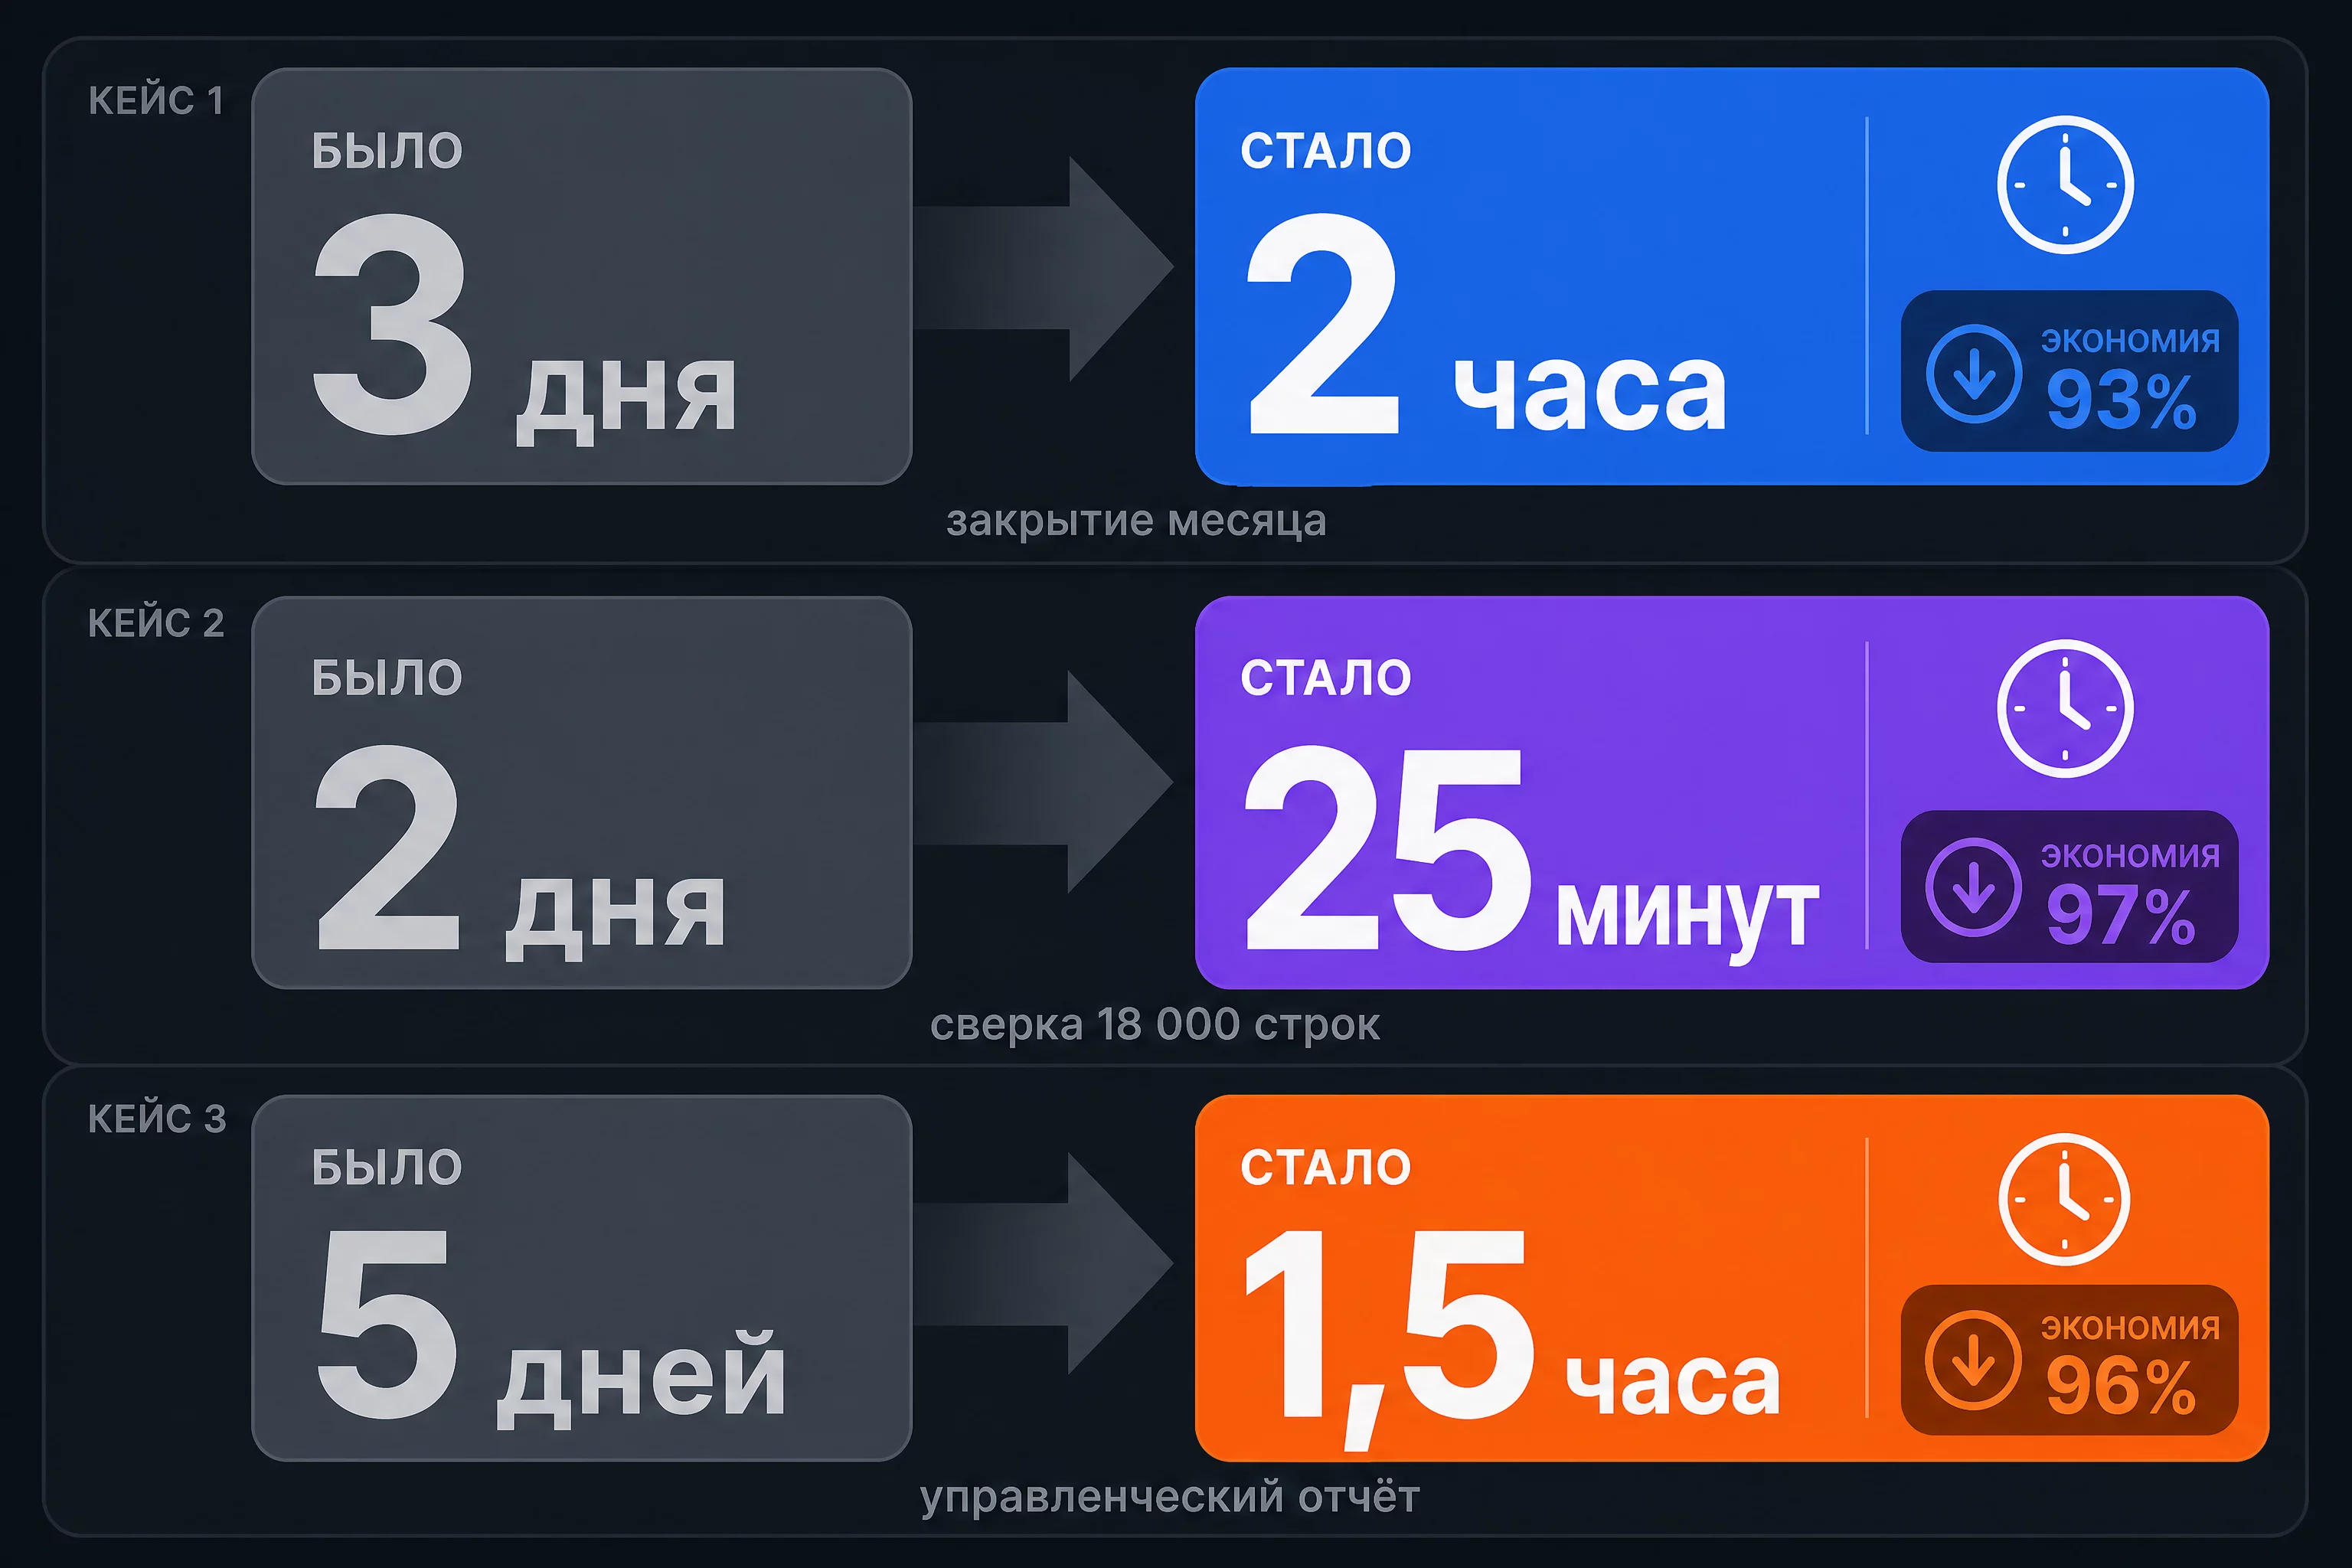
Общий вывод по трём кейсам: выигрыш даёт не отдельный промпт, а набор, в котором каждый следующий шаг опирается на результат предыдущего. Чистка без сверки бессмысленна, сверка без сводной не даёт картинки, сводная без текста не доходит до руководителя.
Как не потерять данные: правила безопасности при загрузке таблиц
Главный риск работы с таблицами в нейросети не в том, что модель ошибётся, а в том, что наружу уйдут данные, которые не должны покидать компанию. Правила ниже простые, и я советую превратить их в привычку, а не в разовую проверку.
Что можно грузить. Суммы, даты, коды статей, обезличенные названия, номера периодов, технические идентификаторы. Числовая часть таблицы нужна модели для работы, и она не раскрывает коммерческой информации сама по себе.
Что нельзя грузить. Названия контрагентов и их реквизиты, ИНН, номера банковских счетов, ФИО сотрудников, персональные данные, содержимое договоров под NDA, сведения, попадающие под банковскую или коммерческую тайну.
Как обезличивать. Замена идёт по простой схеме: «ООО Ромашка» становится «Контрагент 1», Иванов И.И. становится «Сотрудник 3», ИНН и счёт заменяются на маску из одинаковых символов. Важно сохранить уникальность: один и тот же контрагент должен получить один и тот же номер по всему файлу, иначе сверка сломается. Соответствие «номер и настоящее название» храните в отдельном файле у себя, в диалог его не отправляйте.
Что настроить в аккаунте. Отключите обучение на ваших данных в настройках. В платных тарифах это стандартная опция, и её стоит проверить до первой загрузки, а не после. Как это устроено на стороне сервиса, смотрите в официальной справке сервиса, которым пользуетесь: настройки и формулировки там меняются, поэтому сверяйтесь с текущей версией справки, а не с пересказом.
Когда нужен другой контур. Если документы под NDA или банковскую тайну грузить всё-таки надо, публичные тарифы не подходят. Варианты: корпоративный тариф с отдельными условиями обработки данных, локальная модель на своём компьютере или в контуре компании. О том, как это устроено, читайте в статьях про локальные модели без утечки данных и про обезличивание данных.
Отдельно про доступ. Часть сервисов и моделей может требовать определённых условий подключения. Если у вас что-то не открывается, проверяйте официальные каналы и инструкции сервиса, а не сомнительные зеркала: через них уходят ваши данные и платёжные реквизиты.
Практическое правило, которое я даю на курсе: перед загрузкой задайте себе один вопрос. Если этот файл завтра окажется в открытом доступе, будет ли мне некомфортно. Если ответ «да», обезличьте сильнее или перенесите работу в защищённый контур.
Семь ошибок, из-за которых промпт для Excel не работает
Девять из десяти неудачных прогонов объясняются не моделью, а промптом. Вот семь ошибок, которые я вижу чаще всего, и способ каждой избежать.
- Промпт без описания файла. «Сделай сводную» без указания, что в колонках, заставляет модель угадывать. Правильно: перечислите листы, колонки, типы данных и то, что каждая колонка означает.
- Разрешение догадываться. Если не написать «при нехватке данных задай вопрос», модель заполнит пробел предположением. Это главный источник выдуманных цифр в таблицах.
- Нет эталона. Модель не знает вашу учётную политику. Дайте правило расчёта или пример правильного результата, иначе получите правдоподобную, но не вашу логику.
- Нет контроля количества строк. Просите в ответе указывать, сколько строк было на входе и сколько на выходе. Потеря строк при фильтрации это самая незаметная ошибка.
- Один гигантский запрос вместо цепочки. «Почисти, сверь, посчитай и сделай отчёт» в одном промпте даёт поверхностный результат на каждом шаге. Разбивайте на этапы с проверкой между ними.
- Нет требования внешней проверки. Без пересчёта на Python модель проверяет себя своей же логикой и не находит ошибку в начале цепочки. Просите независимый расчёт и контрольные суммы.
- Нет указания формата ответа. Модель может выдать красивый текст вместо файла или добавить рассуждения там, где нужна таблица. Пишите прямо: «верни результат файлом XLSX», «ответ строго по шаблону», «без вступлений».
Отдельно про длину промпта. Начинающие стараются написать коротко, чтобы «не запутать модель». На практике всё наоборот: подробный промпт с правилами, ограничениями и форматом ответа даёт стабильный результат, а короткий приходится переделывать. Цена лишних токенов в 2026 году несопоставима с ценой вашего времени на переделку.
Чек-лист: как собрать свою шпаргалку промптов за один вечер
Это тот же процесс, что в блоке howto выше, но в виде короткого списка для распечатки или заметки.
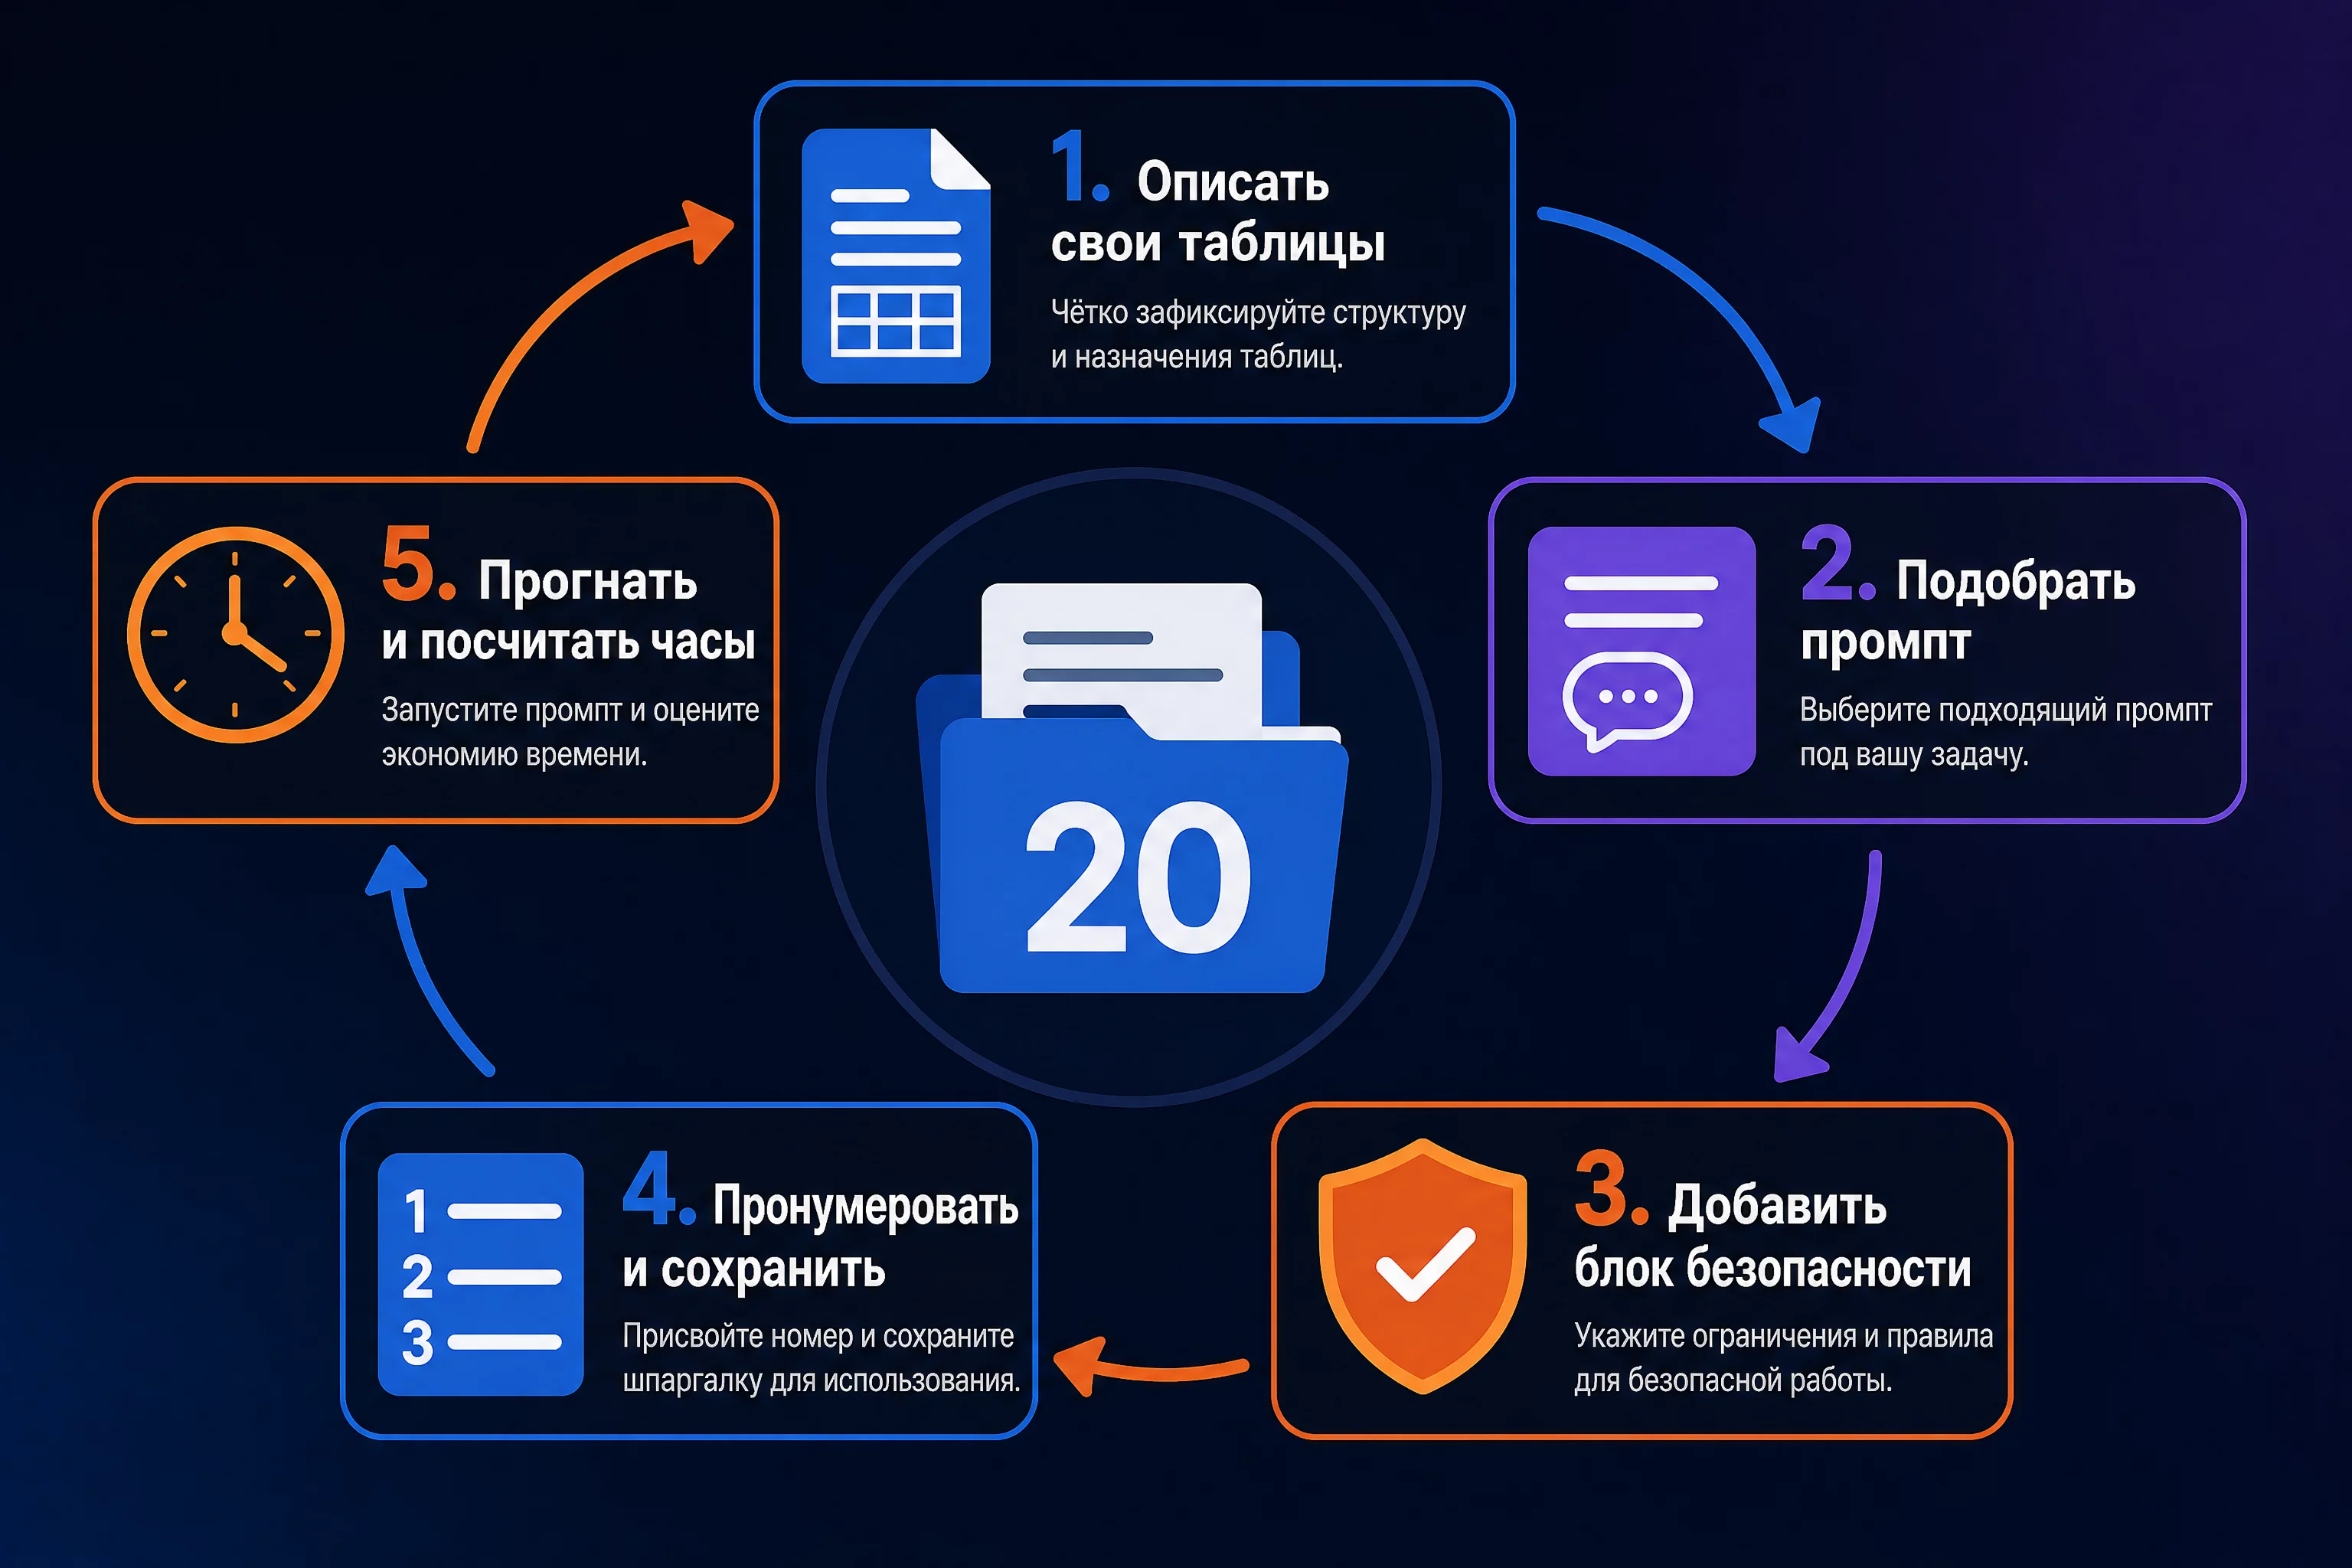
- Выпишите четыре свои самые частые таблицы. Обычно это выгрузка из учётной системы, банковская выписка, реестр договоров и бюджет. С них и начинайте.
- Опишите каждую таблицу в пять строк. Что за файл, сколько строк, что в ключевых колонках, что считается правильным результатом, что нельзя делать.
- Возьмите из статьи подходящий промпт и подставьте свои названия. Не переписывайте структуру: описание, правило, запрет на догадки, формат ответа, код на Python.
- Добавьте блок безопасности в конец каждого промпта. Одна строка: не добавляй данных, которых нет в файле, при нехватке информации задай вопрос.
- Пронумеруйте и сохраните в одном месте. От 1 до 20, названия короткие и по делу. Через месяц вы найдёте нужный за пять секунд.
- Прогоните каждый промпт на реальной задаче. Первый прогон покажет, где модель угадывает. Дописывайте правила, пока результат не станет повторяемым.
- Раз в квартал пересматривайте набор. Модели обновляются, часть промптов можно упростить, а часть задач перевести на автоматизацию. Проверяйте, что вы работаете на актуальной версии.
- Считайте эффект в часах. Заведите простую таблицу: задача, было часов, стало часов. Через два месяца у вас будет своя цифра экономии, а не обещание из чужой статьи.
FAQ: частые вопросы про промпты для Excel в ChatGPT
Какие промпты для Excel в ChatGPT работают лучше всего? Те, в которых есть четыре элемента: описание файла, правило или эталон правильного результата, запрет на догадки и требование показать ход расчёта. Второй по силе приём это просьба пересчитать итоги на Python внутри диалога. Такой пересчёт проверяет модель внешним расчётом, а не её же цепочкой рассуждений. Двадцать промптов из этой статьи построены именно по этой схеме.
Можно ли загружать рабочие таблицы из 1С в ChatGPT? Можно, если таблица обезличена до загрузки. Суммы, даты и проводки оставляем, а названия контрагентов, ИНН, номера счетов и ФИО заменяем масками вида «Контрагент 1», «Сотрудник 3». Обучение на данных отключаем в настройках. Документы под NDA и банковскую тайну в публичные тарифы не грузим: для них есть корпоративные тарифы и локальные модели.
Сколько времени экономит работа с Excel через ChatGPT? Ориентиры из кейсов статьи: закрытие месяца по выгрузке из 1С с трёх дней до двух часов, сверка двух регистров на 18 000 строк за 25 минут вместо двух дней, управленческий отчёт за полтора часа вместо пяти дней. В первый раз добавьте 20-40 минут на описание структуры файла и обезличивание. Дальше вы идёте по готовому шаблону.
Какая нейросеть лучше для работы с Excel в 2026 году? GPT-5.5 для чистки, массовых операций и сборки сводных, Claude Sonnet 4.6 для длинных книг и сложной логики расчётов, Gemini 2.5 если таблицы живут в Google Таблицах, DeepSeek V3.2 для бесплатных черновых прогонов на обезличенных данных. Разделение актуально на сентябрь 2026 года, подробная таблица есть выше в статье.
Нужно ли знать формулы Excel, чтобы пользоваться этими промптами? Понимать смысл нужно, а помнить синтаксис нет. Вам достаточно знать, что делает ВПР, чем отличается СУММЕСЛИМН от СУММЕСЛИ, зачем нужен ИНДЕКС с ПОИСКПОЗ. Формулу напишет модель. Понимание смысла нужно для другого: чтобы проверить результат и заметить случай, когда арифметика верна, а логика нет.
ChatGPT может сам вносить изменения в файл Excel? Нейросеть возвращает готовый файл или код, а не редактирует вашу книгу напрямую. В ChatGPT вы скачиваете новый файл, в Claude работаете с артефактами, через надстройки правки идут прямо в книге. Для финансовых таблиц я советую схему «нейросеть предлагает, человек вносит»: вы видите каждое изменение и контролируете результат.
Почему нейросеть ошибается в таблицах, если она умная? Типичный паттерн ошибок такой: модель понимает задачу, но ломается на точности исполнения. Второй источник это самопроверка: модель считает по своей же цепочке рассуждений и не замечает ошибку, сделанную в начале. Отсюда два правила: требовать независимый пересчёт на Python и всегда давать эталон для сверки.
Что делать, если промпт не дал результата? В девяти случаях из десяти дело в промпте, а не в модели. Проверьте по списку: описан ли файл, задан ли эталон, есть ли запрет на догадки, указан ли формат ответа, попросили ли вы код для повторного запуска. Часто помогает разбить задачу на два шага: сначала разбор структуры файла, потом сама операция.
Можно ли доверять нейросети итоговые цифры отчёта? Итоговую подпись ставит человек. Схема, которая работает: модель делает черновую работу и находит кандидатов в ошибки, человек подтверждает каждую находку и сверяет контрольные суммы. Чем дальше цифра уходит от вашего рабочего стола, тем строже проверка: отчётность для банка, налоговой и собственника проверяется обязательно, внутренние черновики можно прогонять выборочно.
Что дальше
Двадцать промптов из этой шпаргалки это не набор трюков, а каркас рабочего процесса. Чистка, сверка, формулы, сводные: четыре шага закрытия месяца, которые раньше занимали дни, а теперь укладываются в полтора-два часа. Первый вечер уйдёт на то, чтобы подставить в промпты свои названия колонок и обезличить файлы. Дальше вы просто идёте по шаблону и тратите время на анализ, а не на приведение таблиц в порядок.
Следующий шаг это перевести разовые промпты в систему: единый набор под свои процессы, правила безопасности, повторяемые шаблоны отчётов, автоматизация там, где ручная работа уже не нужна. На курсе «AI-навыки финансиста» онлайн-школы «Финансовый директор | Мастер CFO» разбираю именно это: от обезличивания данных и первых промптов до сборки отчётности, которую можно сдавать без страха за итоги. Программа из 10 модулей, 800+ выпускников курса, диплом установленного образца с лицензией и налоговый вычет 13 процентов. Начать можно с бесплатного эфира-экскурсии, где показываю весь процесс на живом примере.
Записаться на курс «AI-навыки финансиста»
Если хотите сначала попробовать формат, заберите бесплатный эфир-экскурсию «Навигация по нейросетям для финансиста»: покажу, как прогнать выгрузку из 1С через чистку, сверку и сборку сводной за один вечер, и отдам набор промптов для старта.
Забрать бесплатный эфир-экскурсию
Наши каналы для финансистов
@findir_pro. Основной Telegram-канал «Финансовый директор | Мастер CFO». 45 000 подписчиков. Ежедневно: практические разборы, кейсы выпускников, обновления инструментов, новые промпты для финансистов.
«АИ с Софьей и Натали». Канал об AI для финансистов. 13 000 подписчиков. Вместе с Софьей Бурцевой, основателем школы, разбираем новые модели, делаем живые тесты и публикуем обновлённые промпты сразу после выхода новых версий.
MAX. Закрытое сообщество для действующих финансовых директоров. 5 000+ участников. Кейсы коллег, шаблоны, закрытые эфиры по AI и стратегии CFO.
Об авторе
Натали Васильева. Эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO». С нейросетями в работе финансиста с февраля 2023 года. Через курс «AI-навыки финансиста» прошли 800+ финансистов, главбухов и финдиров. Веду Telegram-канал @findir_pro (45 000 подписчиков), канал «АИ с Софьей и Натали» (13 000) и MAX-канал «Финансовый директор» (5 000+).
Полезные материалы по теме: аудит формул в Excel через ChatGPT, сверка двух Excel-файлов, нейросеть и Excel для финансиста, Power Query и ChatGPT, Лямбда-функции в Excel, таблица из фото в Excel, продвинутый промпт-инжиниринг, Google Таблицы и ChatGPT, закрытие месяца с ChatGPT.