AI для финансиста
Нанять AI-бухгалтера: как составить ТЗ, принять работу и измерить KPI нейросети на участке

Найм AI-бухгалтера почти никогда не проваливается из-за модели. Он проваливается на двух шагах: участок не описан, а результат не измерен. Модель отвечает, человек радуется скорости, через месяц выясняется, что три суммы ушли в учёт неверно, а доказать экономию нечем, потому что никто не замерял, сколько участок занимал раньше.
Я эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO». С нейросетями в работе финансиста я работаю с февраля 2023 года, через наши разборы и курс «AI-навыки финансиста» прошли больше восьмисот финансистов, главбухов и финдиров. Ниже я разбираю то, что обычно остаётся за кадром разговоров про нейросети: как описать участок в техническом задании, как принять работу на реальных документах и как измерить результат так, чтобы цифра выдержала разговор с собственником.
Короткий ответ на главный вопрос. ТЗ на AI-бухгалтера состоит из семи блоков, приёмка делается на тест-наборе из 30-50 документов, а результат измеряется девятью KPI, из которых главный это не средняя точность, а количество критических ошибок. Дальше я разберу каждый элемент с промптами, формулами и цифрами по состоянию на сентябрь 2026 года.
Отдельная оговорка про доступ. ChatGPT, Claude и Gemini из России без VPN не открываются, это ограничение самих сервисов. Какой сервис поставить, выбираете сами, а пользоваться нейросетями из России не запрещено. DeepSeek V4.1 Flash работает без VPN и подходит для черновых задач с обезличенными данными.
Актуальный набор моделей на 17 сентября 2026 года: GPT-5.5, Claude Sonnet 4.6, Gemini 2.5 и DeepSeek V4.1 Flash. Все четыре справляются с разбором первички и выписок. Разница между ними на задачах участка меньше, чем разница между хорошим и плохим ТЗ.
Что такое AI-бухгалтер и можно ли его нанять как сотрудника?
AI-бухгалтер это участок учёта, описанный в техническом задании и закрытый нейросетью по регламенту, а не человек и не отдельный сервис. Нанимать в штат тут нечего: вы описываете работу, проверяете её на реальных документах и измеряете набором показателей.
Слово «нанять» здесь скорее метафора, но метафора полезная. Она включает тот же набор действий, что и при найме человека: понять, что сотрудник должен делать, дать инструкцию, посмотреть на пробной задаче, договориться, как проверять результат. Отличие в одном: у модели нет своей памяти о вашем учёте и нет ответственности. Всё, что не описано в ТЗ, модель додумает сама и сделает это правдоподобно.
Второе отличие в цене ошибки. Сотрудник, который не понял задачу, чаще переспрашивает. Модель не переспрашивает почти никогда, она выдаёт результат уверенным тоном. Поэтому приёмка и KPI здесь не бюрократия, а способ поймать ровно этот класс ошибок, пока они не ушли в учёт.
Три роли, которые часто путают. Разделите их сразу, это снимает половину проблем.
Первое: сервис. Готовый продукт с распознаванием документов, хранением сканов и интеграцией с учётной системой. Он делает то, что заложил разработчик, и вы мало влияете на правила.
Второе: модель. ChatGPT, Claude, Gemini, DeepSeek. Вы сами задаёте правила в запросе, сами отвечаете за формат. Это то, о чём эта статья.
Третье: человек на участке. Даже на самом автоматизированном участке остаётся владелец процесса: он принимает спорные решения, подписывает и отвечает за цифры.
Чем это отличается от автоматизации через 1С. В учётной системе правила исполняются детерминированно: если настроено, будет считаться одинаково каждый раз. У модели результат вероятностный, две одинаковые накладные могут разобраться по-разному. Отсюда главный принцип, который я повторяю на разборах: если шаг можно сделать без нейросети, делайте его без нейросети. Модель ставьте туда, где нужно прочитать смысл, а не посчитать по алгоритму. Подробный разбор этой границы есть в статье про то, заменит ли нейросеть бухгалтера и CFO.
Что «найм AI-бухгалтера» даёт бизнесу. Три вещи, и скорость тут не главная. Первое: предсказуемость, потому что участок работает по регламенту, а не по настроению. Второе: единый стандарт разбора документов, который переживает отпуск и смену исполнителя. Третье: измеримость, потому что у любого эффекта появляется цифра. Скорость приходит четвёртой.
Сколько стоит AI-бухгалтер и с чем его сравнивать?
На участке первички на 300-500 документов в месяц AI-участок обходится в 5-15 тысяч рублей прямых расходов и 8-16 часов вашего времени на старте. Для сравнения, аутсорс на таком объёме стоит от 25 до 60 тысяч рублей в месяц, а сотрудник в штате обходится заметно дороже с учётом рабочего места и налогов.
Цифры по прямым расходам такие. Подписка на модель от нескольких тысяч рублей в месяц, но точная цена меняется, поэтому проверяйте её на официальной странице сервиса. Сервис распознавания документов, если он нужен отдельно, добавляет 500-2 000 рублей в месяц. Для черновых задач подходит DeepSeek V4.1 Flash, он работает без VPN и закрывает часть работы вообще без расходов.
Скрытая часть расходов это ваше время. Первый участок забирает от 8 до 16 часов: четыре-шесть часов на описание и тест-набор, два-четыре часа на приёмку, остальное на первые недели работы и правки регламента. На втором и третьем участке это время падает в два-три раза, потому что файл правил и шаблон ТЗ уже есть.
Ниже сравнение четырёх схем по состоянию на сентябрь 2026 года. Оценки времени и стоимости взяты из моих разборов с бухгалтерами и финдирами, это не аудированная статистика.
| Схема | Прямые расходы в месяц | Скорость на 400 документах | Где ломается | Кому подходит |
|---|---|---|---|---|
| Сотрудник в штате | Зарплата, налоги, рабочее место | 3-5 рабочих дней | Отпуск, увольнение, зависимость от одного человека | Компания с большим объёмом и сложным учётом |
| Аутсорс | От 25 000 до 60 000 рублей | 2-4 рабочих дня | Очередь у исполнителя, разный уровень специалистов | Малый бизнес и ИП, которым нужен ответственный за подпись |
| AI-участок без человека | 5 000-15 000 рублей | 2-4 часа на разбор плюс 1-2 часа проверки | Ошибки, которые никто не ищет | Участки с низкой ценой ошибки и однотипными документами |
| Гибрид: модель плюс владелец процесса | 5 000-15 000 рублей плюс время специалиста | 4-6 часов вместе с проверкой | Требует регламента и дисциплины | Рабочий вариант для большинства компаний |
Рабочий вариант для большинства это третья и четвёртая строка. Чистый AI-участок без человека живёт только там, где цена ошибки близка к нулю: например, черновая подготовка писем или сборка сводки для внутреннего просмотра. Всё, что попадает в учёт или уходит наружу, проходит через владельца процесса.
Ещё один вариант расходов, о котором спрашивают на разборах, это обучение команды. Он не обязательный, но часто именно он определяет, дойдёт дело до работы или остановится на этапе энтузиазма. Как устроены такие программы, я разбирала отдельно в статье про курсы нейросетей для финансистов.
Что входит в ТЗ на AI-бухгалтера: разбор семи блоков
ТЗ на AI-участок состоит из семи блоков: границы участка, входные данные, выходной формат, правила разбора, исключения и эскалация, критерии приёмки и владелец процесса. На разборах я вижу, что пишут обычно только четвёртый блок, то есть правила, и удивляются, почему результат нестабилен.
Блок 1. Границы участка. Что входит и что не входит. Плохо: «разбор первички». Хорошо: «разбор входящих сканов от поставщиков за период, включая накладные, акты и счета-фактуры, без договоров, без банковских документов и без авансовых отчётов сотрудников». Граница нужна, чтобы модель не начала разбирать то, чего вы не просили, и чтобы вы потом могли честно измерить объём.
Блок 2. Входные данные. Что именно вы подаёте и в каком виде. Папка сканов, один PDF-файл со всеми документами, CSV из банка, письмо из почты. Здесь же описываются допустимые форматы и качество: снимок с телефона, скан с разрешением 300 точек, документ с печатью поверх текста. Отдельно укажите, что делать с несколькими документами в одном файле, это частая причина путаницы.
Блок 3. Выходной формат. Не «таблица», а конкретный набор столбцов с типами и порядком. Дата в формате день.месяц.год, сумма числом без пробелов и знака рубля, НДС отдельным столбцом, тип документа из закрытого списка. Формат ответа это половина качества: если он не задан, каждая итерация будет выглядеть по-новому, и сравнивать результаты будет нечем.
Блок 4. Правила разбора. Как принимать решения в спорных случаях. Что считать датой документа, если их две. Как разбирать НДС, выделенный отдельной строкой. Что делать с исправлениями, зачёркиваниями и рукописными пометками. Что делать с документом, где сумма цифрами и прописью расходится. Каждое правило пишите так, как объясняли бы новому помощнику, который впервые видит ваш учёт.
Блок 5. Исключения и эскалация. Самое важное и самое пропускаемое. Список условий, при которых модель обязана остановиться и позвать человека: поле не читается, сумма расходится с прописью, контрагент не найден в справочнике, документ похож на дубль, итог не сходится. Здесь же правило поведения: не придумывать значение, а помечать его как неподтверждённое и выносить в отдельный список. Именно этот блок превращает модель из генератора правдоподобных цифр в рабочего помощника.
Блок 6. Критерии приёмки. Числа, при которых участок считается принятым. Доля документов без ручной правки не ниже 85%, критические ошибки ноль на тест-наборе, время разбора 100 документов не больше 15 минут. Критерии пишутся до начала работы, а не после, иначе их всегда подгонят под фактический результат.
Блок 7. Владелец процесса. Кто отвечает за участок: проверяет, ведёт журнал ошибок, обновляет ТЗ и решает спорные случаи. Без имени в этом блоке участок умирает через месяц, потому что все считают, что им занимается кто-то другой.
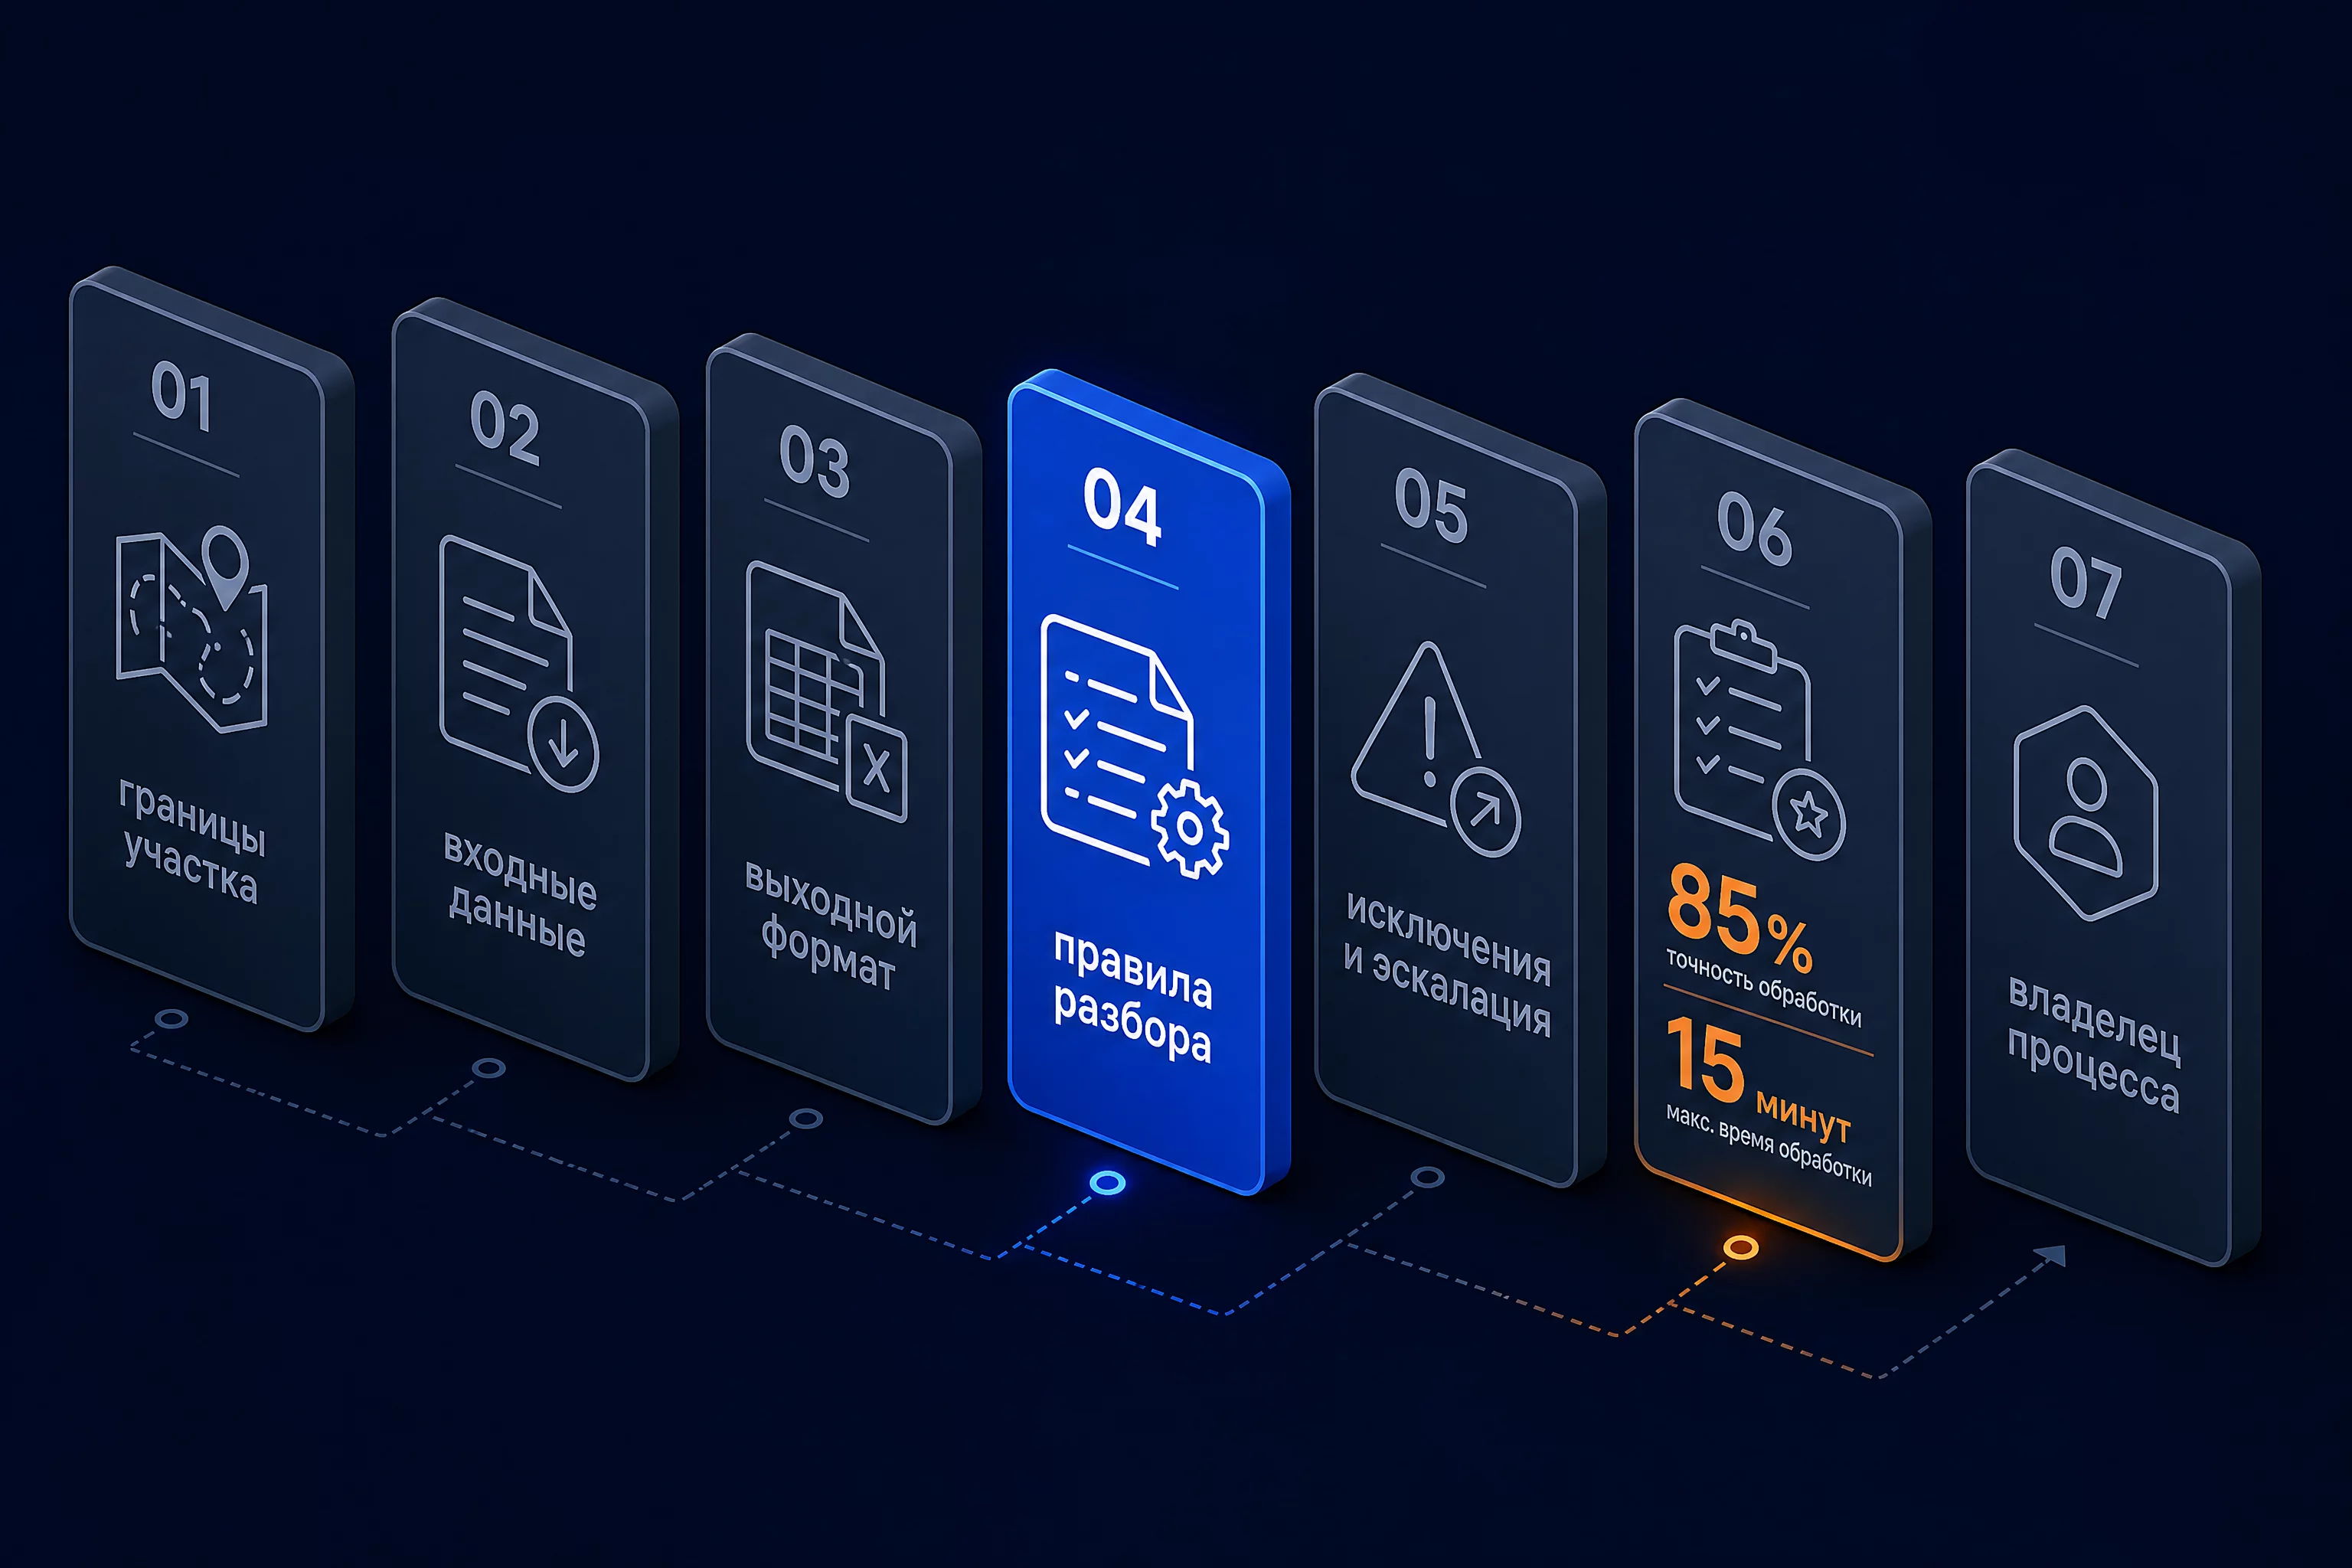
Как отличить хорошее ТЗ от плохого. Проверка простая: отдайте ТЗ коллеге, который не занимается этим участком, и попросите проделать работу по инструкции на пяти документах. Если у него получился другой результат, значит ТЗ неполное. Модель работает так же: она не знает того, что вы считаете очевидным.
Где хранить ТЗ. В одном файле, к которому есть доступ у всех, кто работает с участком. Не в истории переписки и не в голове. Практика показывает, что файл правил на одну-две страницы живёт годами и экономит десятки часов, а десять уточнений, разбросанных по чатам, теряются за неделю. Как устроены такие файлы для учёта, я подробно разбирала в статье про свою AI-бухгалтерию на ChatGPT.
Как написать ТЗ, если вы никогда этого не делали?
Этот промпт я даю на разборах первым. Модель выступает в роли методиста и вытаскивает из вас те блоки ТЗ, которые вы не подумали описать.
Ты методист, который помогает описать участок учёта для передачи нейросети.
Твоя задача: задать мне вопросы и собрать техническое задание на участок.

Работай по семи блокам и иди по порядку, не перескакивая:
1. Границы участка: что входит, что не входит.
2. Входные данные: что я подаю, в каком виде, какого качества.
3. Выходной формат: столбцы, типы, порядок.
4. Правила разбора: как решать спорные случаи.
5. Исключения и эскалация: когда ты обязан остановиться и позвать человека.
6. Критерии приёмки: числа, при которых участок принят.
7. Владелец процесса: кто проверяет и обновляет ТЗ.

На каждый блок задай мне не больше трёх вопросов, по одному за раз.
Если я отвечаю расплывчато, задай уточняющий вопрос и приведи пример
формулировки, которая была бы достаточной.
Когда соберёшь все семь блоков, выдай итоговое ТЗ одним документом
с заголовками по блокам, без воды, готовое к вставке в файл правил.
Не придумывай ничего за меня: если данных нет, оставь пометку
"НЕ ЗАПОЛНЕНО" и напомни в конце.
Как этим пользоваться. Отведите на разговор 20-30 минут и отвечайте конкретно, своими словами. Первый черновик ТЗ обычно получается на две страницы. Дальше вы редактируете его руками: убираете лишнее, добавляете свои формулировки статей и свой план счетов.
Чего делать не стоит. Не просите модель написать ТЗ целиком «по теме бухгалтерии». Получите красивый документ, в котором не будет ни одного вашего правила, и на приёмке он рассыплется. Ценность ТЗ в том, что оно описывает именно ваш учёт, с вашими поставщиками, вашими формулировками в назначениях платежей и вашими исключениями.
Как описать участок, если вы сами его плохо представляете. Есть рабочий приём: сделайте работу руками один раз и запишите каждый шаг, включая паузы и возвраты. Получится список вида «взял скан, посмотрел дату, не нашёл номер, полез в письмо, уточнил». Этот список и есть сырое ТЗ. Дальше промпт ниже превратит его в структуру.
Что делать с фразой «сделай аккуратно». Уберите её из ТЗ полностью. Все оценочные слова модель понимает по-своему, и каждый раз по-новому. Замените на проверяемое условие: не «аккуратно проверяй дубли», а «если два документа совпадают по дате, контрагенту и сумме, второй помечается как возможный дубль». На разборах я вижу, что перевод оценочных слов в условия разбора даёт больше прироста точности, чем смена модели.
Как выбрать участок для первого ТЗ. Не берите самый крупный и не берите самый болезненный. Берите тот, где результат виден за одну итерацию: первичка, выписка, черновики писем. Крупный участок вроде закрытия месяца разбирается на подучастки, иначе ТЗ получится на десять страниц и не сработает ни один блок.
Тест на готовность ТЗ перед приёмкой. Прочитайте ТЗ и мысленно пройдите по нему на трёх документах, которые помните наизусть. Если хотя бы на одном вы не знаете, что модель должна сделать, ТЗ не готово. Ещё одна проверка: попросите модель сыграть роль исполнителя и вслух проговорить, как она поняла каждый блок. Расхождения в понимании вылезают сразу.
Ниже список шагов, которые я делаю руками на участке учёта.
Разложи его по семи блокам ТЗ: границы, вход, выход, правила,
исключения и эскалация, критерии приёмки, владелец процесса.
Отметь шаги, которые можно автоматизировать полностью,
шаги, где нужна моя проверка, и шаги, которые модели недоступны.
Для каждого шага, который ты относишь к исключениям,
предложи одно правило: что модель должна сделать вместо догадки.

Мой список шагов:
[вставьте свои шаги]
Как описать правила разбора, чтобы модель не додумывала?
Правила разбора это место, где решается, будет ли у вас предсказуемый участок. Формулируйте их как условия, а не как пожелания. Не «разбирай внимательно», а «если в документе две даты, считай датой документа дату в правом верхнем углу, а дату в тексте выноси в отдельный столбец».
Шесть правил, которые я добавляю в любое ТЗ на первичку.
Правило пустого поля. Если поле не читается, ставь пометку «НЕ ЧИТАЕТСЯ» и описывай, что мешает. Не подставляй похожее значение. Это самое дорогое правило из всех, потому что оно закрывает класс ошибок, которые иначе уйдут в учёт незамеченными.
Правило закрытого списка. Тип документа, статья, контрагент выбираются из заранее заданного списка. Если подходящего значения нет, выносится отдельная строка «вне списка». Так вы сразу видите нетиповые операции, а не ищете их потом по всему массиву.
Правило расхождения. Если сумма цифрами не совпадает с суммой прописью, или итог по строкам не сходится с итогом документа, документ помечается как требующий ручной проверки, даже если распознавание прошло уверенно.
Правило дублей. Если два документа похожи по дате, контрагенту и сумме, второй помечается как возможный дубль. Повторная оплата одного счёта это типичная ошибка, которую человек замечает через месяц.
Правило неполного комплекта. Если к накладной полагается счёт-фактура или акт, а его нет, модель ставит пометку. Не додумывает «значит, документ один».
Правило формата. Все суммы числом, даты в едином формате, никаких прописей в выходной таблице. Формат ответа это половина качества, о ней я писала выше.
Ты помощник бухгалтера. Ниже мои правила разбора первичных документов.
Разбери загруженные документы строго по этим правилам.

ПРАВИЛА:
1. Если поле не читается, поставь "НЕ ЧИТАЕТСЯ" и опиши причину.
   Не подставляй похожее значение.
2. Тип документа и статья берутся только из закрытого списка:
   накладная, акт, счёт, счёт-фактура, кассовый чек, прочее.
3. Если сумма цифрами и сумма прописью расходятся, пометь документ
   как "ТРЕБУЕТ ПРОВЕРКИ" и укажи обе суммы.
4. Если два документа совпадают по дате, контрагенту и сумме,
   второй пометь как "ВОЗМОЖНЫЙ ДУБЛЬ".
5. Если у документа нет полного комплекта и он требует приложения,
   сделай пометку "НЕПОЛНЫЙ КОМПЛЕКТ" и напиши, что приложить.
6. Все суммы числом без пробелов, даты в формате дд.мм.гггг.

РЕЗУЛЬТАТ:
Таблица со столбцами: дата, номер, контрагент, назначение, сумма,
НДС, тип документа, статус, комментарий.
Под таблицей три списка: требующие проверки, возможные дубли,
неполные комплекты. Ничего не придумывай, чего нет в документе.
Отдельно про эскалацию. Опишите её как обязанность, а не как возможность. Формулировка «если сомневаешься, спроси» не работает, потому что модель почти не сомневается. Работает перечень конкретных условий, при которых она обязана остановиться. Список из пяти-семи условий закрывает основную часть рисков на участке первички.
Ниже условия, при которых ты обязан остановиться и вынести документ
на ручную проверку, не принимая решение сам:
- любое поле не читается или читается частично;
- сумма цифрами не совпадает с суммой прописью;
- итог по строкам не сходится с итогом документа;
- контрагент не найден в моём списке;
- дата документа выходит за пределы закрываемого периода;
- документ похож на дубль ранее обработанного.

По каждому такому документу выдай: что именно вызвало остановку,
какие варианты решения ты видишь, что нужно уточнить у человека.
Решение не принимай. Твоя задача - подготовить вопрос, а не ответ.
Как принять работу у AI-бухгалтера: три этапа приёмки
Приёмка проходит в три этапа: тест-набор, сценарий плохих документов и рабочий прогон на живом потоке. Каждый этап отвечает на свой вопрос, и пропуск любого из них приводит к тому, что участок принимается по завышенной оценке.
Сравнительная таблица этапов. Ниже три этапа с тем, что каждый проверяет и сколько времени занимает.
| Этап | Что проверяет | Объём | Время | Признак провала |
|---|---|---|---|---|
| Тест-набор | Базовую точность полей и полноту | 30-50 документов | 3-5 часов | Точность по сумме ниже 90% |
| Плохие документы | Поведение на испорченных данных | 10-15 документов | 1-2 часа | Подставляет значение вместо пометки |
| Рабочий прогон | Устойчивость на живом потоке | 2-3 недели работы | 15-20 минут в день | Критические ошибки находятся при сверке |
Кто должен участвовать в приёмке. Минимум два человека: тот, кто будет работать с участком каждый день, и тот, кто отвечает за результат, то есть главбух или финдир. Первый видит неудобства в работе, второй оценивает последствия ошибок. Если приёмку проводит один человек, оценка смещается в одну из сторон: исполнитель терпит неудобства, руководитель не видит деталей.
Этап 1. Тест-набор. Вы собираете 30-50 реальных документов за прошлый период и размечаете правильные значения руками. Разметка это скучная часть, но именно она превращает приёмку в измерение, а не в разговор о впечатлениях. На тест-наборе считаются три показателя: точность извлечения полей, полнота и доля документов без ручной правки.
Что обязательно должно быть в тест-наборе. Примерно треть документов должна быть неудобной. Мятая накладная, фотография под углом, документ с рукописной правкой, документ с двумя датами, документ, где НДС выделен отдельной строкой, нетиповой контрагент, документ с ошибкой в сумме, и один-два случая дублей, если они у вас бывают. Набор из одних аккуратных сканов даёт оценку 95% и выше, после которой вы примете неверное решение о внедрении.
Этап 2. Сценарий плохих документов. Отдельная проверка на устойчивость: что делает модель, когда документ испорчен. Правильное поведение это пометка «НЕ ЧИТАЕТСЯ» и вопрос к человеку. Неправильное, и самое опасное, это правдоподобное значение вместо непрочитанного. Проверяйте это отдельно, потому что на тест-наборе такая ошибка выглядит как обычная неточность, а в учёте превращается в тихо искажённую сумму.
Этап 3. Рабочий прогон. Две-три недели участок работает в связке с ручной проверкой. Вы сравниваете результат модели со своей проверкой и ведёте журнал ошибок. Это единственный способ увидеть, как участок ведёт себя на документах, которых не было в тест-наборе.
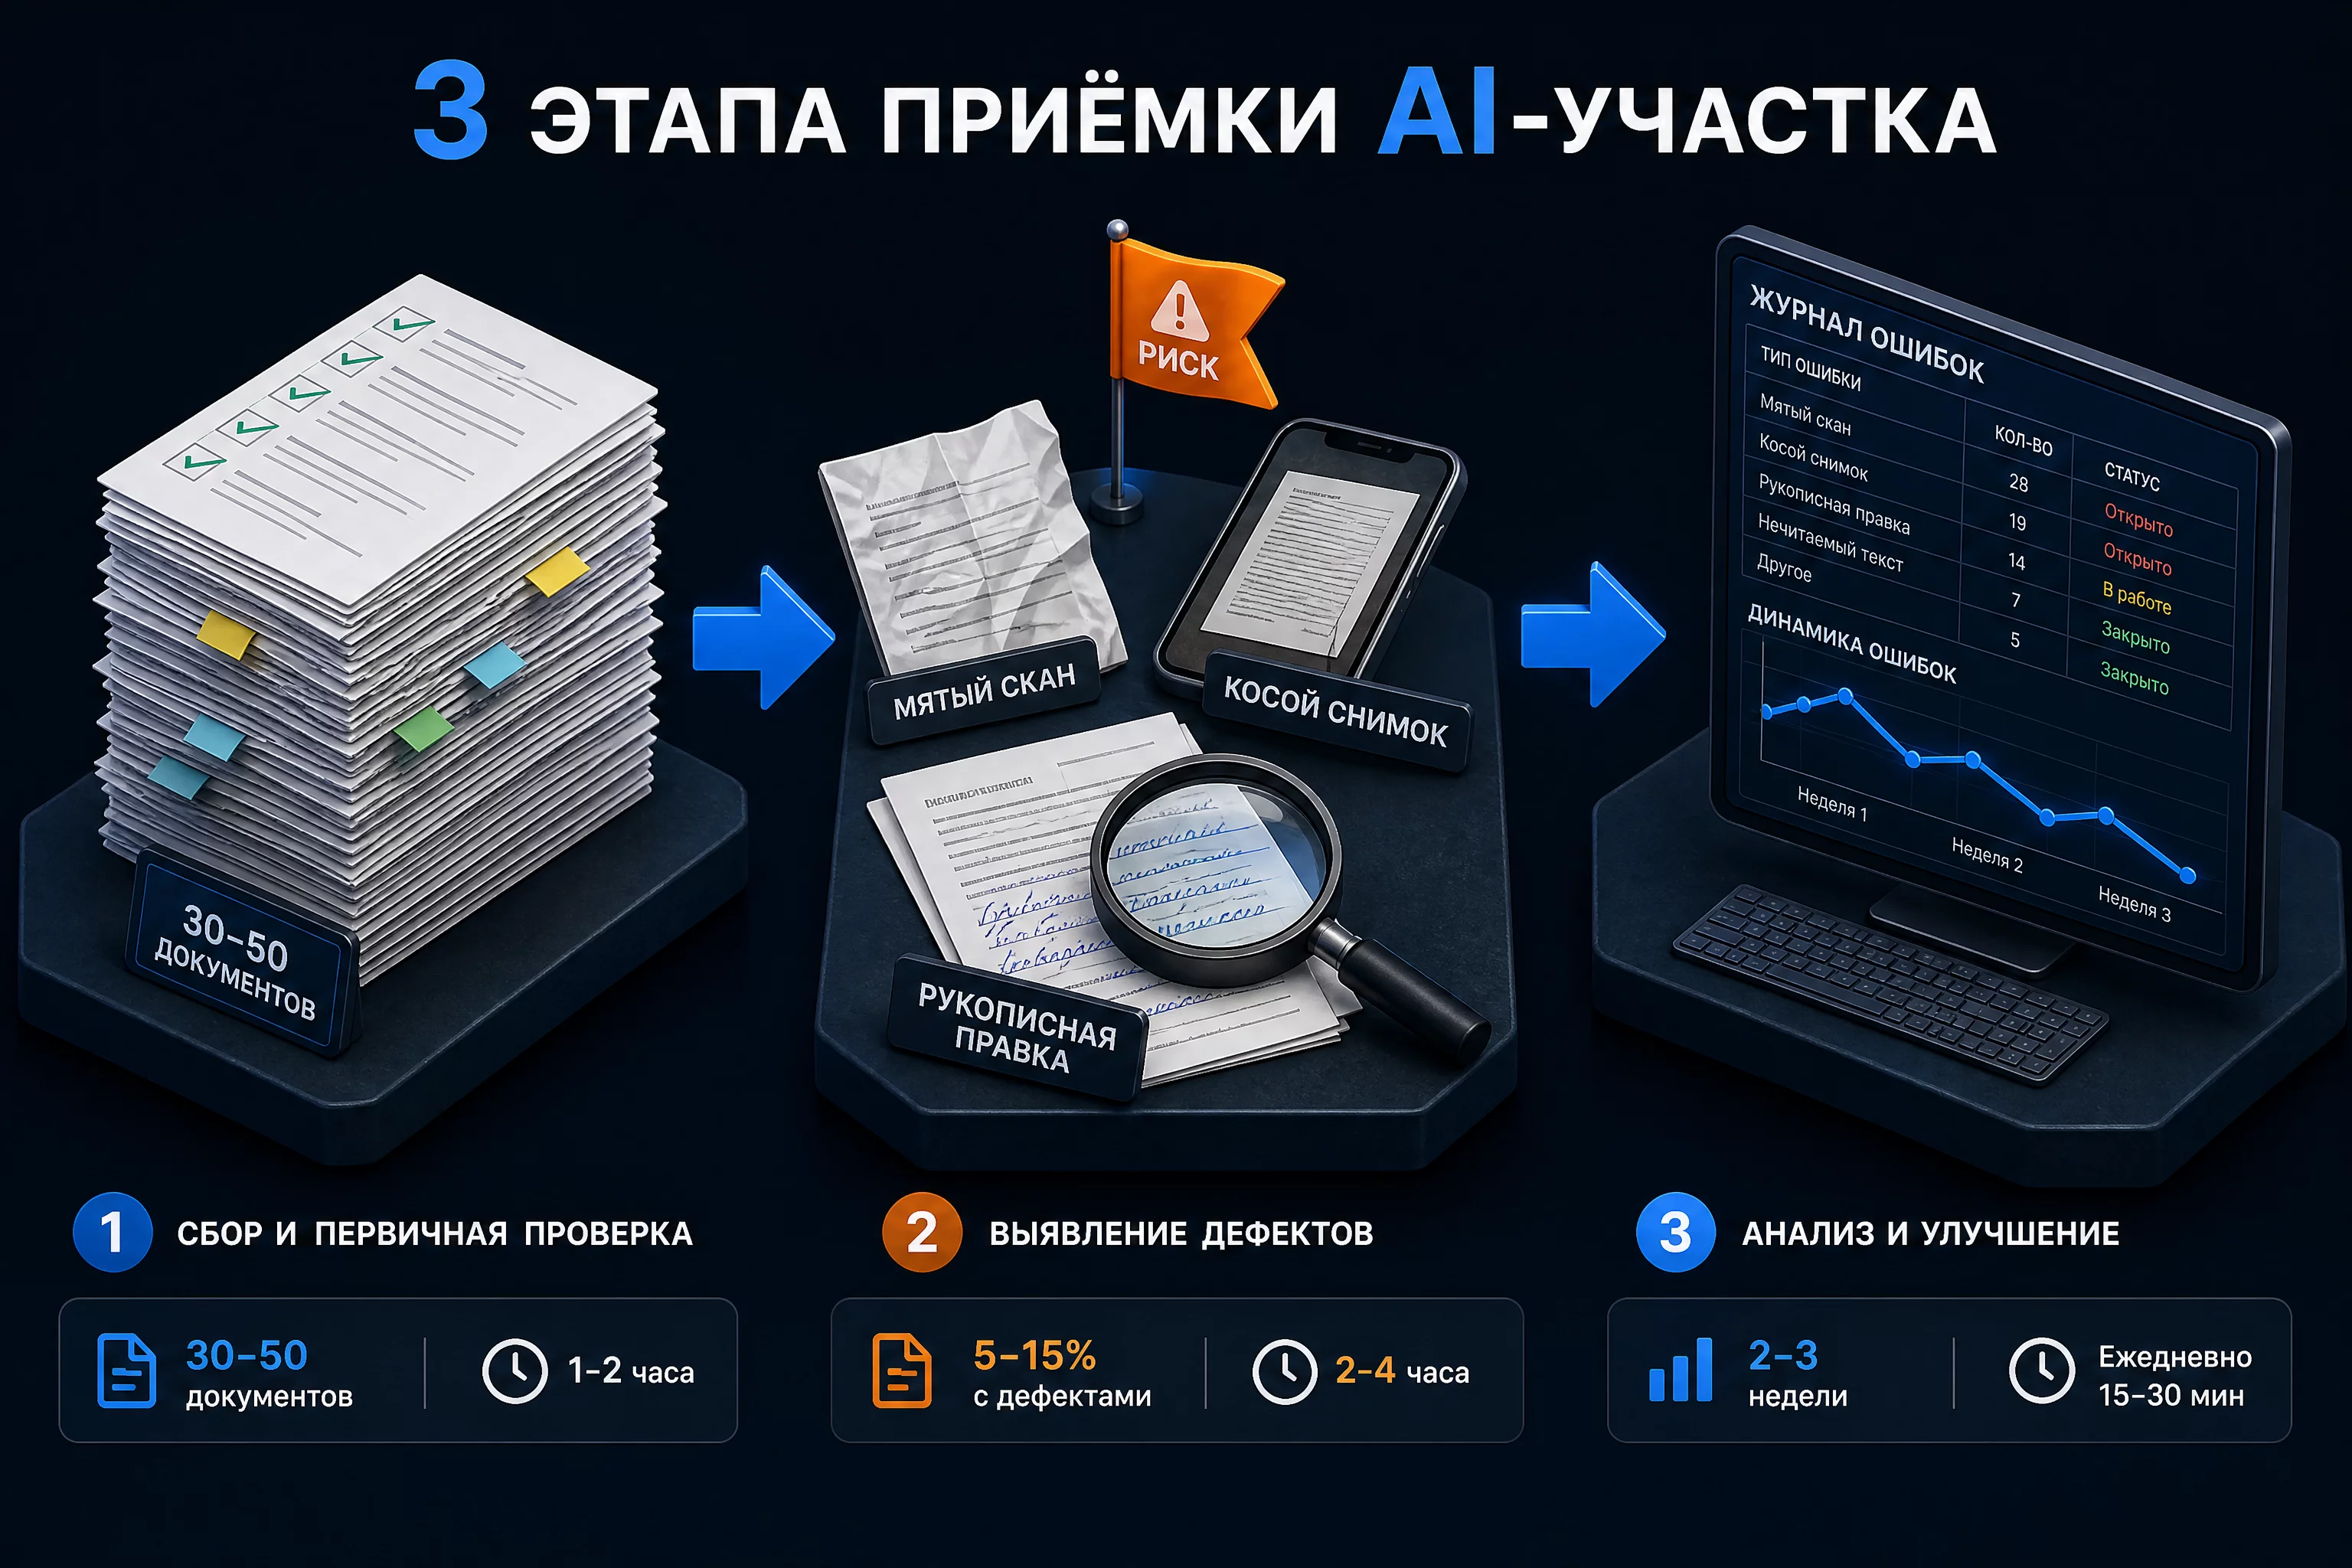
Промпт для сборки тест-набора. Этот запрос помогает не забыть неудобные типы документов.
Ты методист по приёмке AI-участка в бухгалтерии.
Мне нужно собрать тест-набор из 40 документов для проверки участка
[название участка, например: разбор входящей первички от поставщиков].

Составь мне чек-лист: какие типы документов обязательно включить,
чтобы оценка не была завышенной. Раздели на три группы:
1. Типовые документы (сколько штук и какие).
2. Неудобные документы (плохие сканы, рукописные правки,
   несколько дат, НДС отдельной строкой, нетиповые контрагенты).
3. Проблемные случаи (дубли, неполный комплект, расхождение сумм,
   документ вне периода).

Для каждой позиции напиши одной строкой, какой именно дефект
она проверяет и какую ошибку модели должна поймать.
Промпт для самой приёмки. Прогоняет документы и сразу считает показатели.
Ты проверяешь качество разбора первичных документов.
Я загружаю: (1) разбор, который ты сделал ранее по моим правилам,
(2) мою разметку с правильными значениями по каждому документу.

Сравни построчно и выдай:
1. Таблицу расхождений: документ, поле, значение модели, верное значение,
   тип расхождения (не прочитал, подставил похожее, сдвинул, потерял).
2. Точность по каждому полю отдельно (дата, номер, контрагент, сумма, НДС).
3. Список документов, которые ты пометил как "НЕ ЧИТАЕТСЯ",
   и правильно ли ты это сделал.
4. Отдельный список критических ошибок: случаи, где ты выдал
   правдоподобное значение вместо непрочитанного.
5. Итоговые показатели: точность полей, полнота, доля документов
   без ручной правки.

Считай только по фактам сравнения, не оценивай общее впечатление.
Промпт для разбора причин расхождений. Пригодится, когда показатели не дотягивают до критериев, а с первого взгляда непонятно почему.
Ниже список расхождений между разбором модели и моей разметкой.
Сгруппируй их по причинам и назови, какая причина даёт больше всего ошибок.

Для каждой группы:
1. Сформулируй правило для ТЗ, которое закрыло бы эту группу.
2. Оцени, реализуемо ли это правило в промпте, или нужна правка
   качества сканов на входе.
3. Скажи, какой KPI сдвинется, если правило внедрить.

Не предлагай менять модель, пока не исчерпаны правила.
Список расхождений:
[вставьте расхождения из приёмки]
Промпт для протокола приёмки. Собирает результат в один документ, который можно показать руководителю.
Ты готовишь протокол приёмки AI-участка в бухгалтерии.
Вот мои данные:
- участок: [название]
- версия ТЗ: [номер или дата]
- состав тест-набора: [сколько документов и какие типы]
- точность по полям: [значения]
- полнота: [значение]
- доля документов без ручной правки: [значение]
- критические ошибки: [список или "нет"]
- критерии приёмки из ТЗ: [значения]

Собери протокол на одну страницу:
1. Что проверяли и на чём.
2. Показатели рядом с критериями, с пометкой пройдено или нет.
3. Критические ошибки с описанием каждой.
4. Решение: принято, принято с условиями или не принято.
5. Условия и сроки, если решение "принято с условиями".
6. Что меняем в ТЗ по итогам.

Пиши сухо и по фактам, без оценок и без общих слов.
Протокол приёмки. Результат фиксируется одной страницей: дата, версия ТЗ, состав тест-набора, три показателя, список критических ошибок, решение (принято, принято с условиями, не принято). Документ нужен не для бюрократии, а чтобы через три месяца было с чем сравнить, когда качество изменится.
Что делать с формулировкой «принято с условиями». Это самый частый исход первой приёмки, и это нормально. Условия формулируются как список правок ТЗ с датой повторной проверки: правило про НДС отдельной строкой, порог суммы, правило по документам вне периода. Повторная проверка делается на том же тест-наборе плюс десять новых документов из живого потока.
Какие KPI измерять у нейросети на участке и как их считать?
KPI участка это девять показателей, разбитых на три группы: качество, скорость и деньги. Начинать измерение с денег не стоит, потому что цифра экономии без показателей качества ничего не значит.
| KPI | Формула | Норма для старта | Как часто мерить |
|---|---|---|---|
| Точность извлечения полей | Правильных значений / всего значений | 92-98% по сумме и дате | На приёмке и раз в месяц |
| Полнота | Найденных документов / всего загруженных | 100% с учётом пометок | Каждую партию |
| Доля документов без ручной правки | Документов без правок / всего | 85-95% | Раз в месяц |
| Время на 100 документов | Замер разбора плюс проверки | 40-60 минут | Раз в месяц |
| Стоимость одного документа | Расходы на сервисы / число документов | 5-30 рублей | Раз в месяц |
| Коэффициент эскалации | Документов на ручной проверке / всего | 5-15% | Каждую партию |
| Критические ошибки | Число незамеченных подстановок | 0 | Каждый случай отдельно |
| Время цикла участка | От получения документа до готовности | Сокращение в 3-5 раз | Раз в месяц |
| Экономия часов | Часы до минус часы после | 1,2 и больше | Раз в месяц |
Точность извлечения полей. Считается отдельно по каждому полю, а не одной цифрой по документу. Причина простая: сумма и НДС несопоставимы по цене ошибки с полем «назначение». Если считать всё вместе, ошибка в назначении платежа утопит в общей статистике пропущенный НДС.
Полнота. Доля документов, которые вообще попали в разбор. Модель может потерять документ из пачки, особенно если файл повреждён или документ вложен как изображение внутрь другого файла. Этот показатель проверяется простым сравнением: сколько файлов подали, сколько строк получили.
Доля документов без ручной правки. Самый понятный для бизнеса KPI. Показывает, сколько документов прошло насквозь, без вмешательства человека. Именно эту цифру стоит называть собственнику, потому что она напрямую переводится в часы.
Время на 100 документов. Замер делается от подачи файлов до готового результата, включая вашу проверку. Проверка обязательна в замере, иначе показатель превращается в фикцию: модель «разбирает» пачку за минуту, а вы потом правите её сорок минут.
Стоимость одного документа. Прямые расходы делятся на количество документов. При подписке за несколько тысяч рублей и объёме 400 документов это выходят единицы рублей, то есть меньше стоимости бумаги и печати. Считать этот показатель нужно только для понимания масштаба, а не как главный аргумент.
Коэффициент эскалации. Доля документов, которые модель вынесла на ручную проверку. Показатель двойственный. Слишком низкий означает, что модель не признаётся в неуверенности, и это тревожный признак. Слишком высокий, например выше 30%, означает, что правила разбора написаны плохо и модель сомневается там, где не должна. Комфортный коридор 5-15%.
Критические ошибки. Главный показатель из девяти. Считается не в процентах, а штуками, разбирается каждый случай. Критическая ошибка это правдоподобное значение вместо правильного, которое ушло в учёт незамеченным. Именно этот KPI отличает работающий участок от опасного.
Почему этот показатель не усредняется. Если у вас 500 документов и одна критическая ошибка, средняя точность по документу составит 99,8%, и на этом фоне ошибка выглядит статистическим шумом. Но в учёте она не шум: это неверная сумма, которая попала в отчётность. Поэтому показатель считается штуками и живёт отдельно от всех процентов. Разбор каждой ошибки занимает минут десять и отвечает на три вопроса: почему модель подставила значение, какое правило это закрыло бы, попали ли похожие документы в текущую партию.
Ниже описание критической ошибки на AI-участке первички.
Помоги разобрать её так, чтобы она не повторилась.

Данные:
- что было в документе: [описание или фрагмент]
- что выдала модель: [значение]
- правильное значение: [значение]
- как ошибка обнаружилась: [сверка, жалоба, случайно]
- сколько таких документов прошло за период: [оценка]

Ответь по пунктам:
1. Какие условия разбора могли привести к подстановке и почему.
2. Сформулируй правило для ТЗ, которое закрывает этот случай.
3. Сформулируй дополнительно правило-страховку на класс похожих случаев,
   а не только на этот один.
4. Скажи, какие ещё KPI стоит пересчитать после этой ошибки.
5. Напиши, как найти похожие случаи в уже обработанном массиве документов.

Не оправдывай модель и не предлагай заменить её целиком.
Предложи минимальную правку, которая закрывает причину.
Как считать KPI при малом объёме. Если документов меньше ста в месяц, проценты сильно скачут: одна ошибка меняет показатель на несколько пунктов. В этом случае смотрите на абсолютные числа и на динамику за три месяца, а не на месячный процент. Три ошибки на 250 документов и две на 240 это одна и та же картина, а не улучшение.
Время цикла. Сколько проходит от получения документа до готовности данных. Обычно цикл сокращается в разы даже без сокращения общего объёма работы, потому что исчезает ожидание «соберу пачку и сяду разбирать».
Экономия часов. Часы до внедрения минус часы после. Норма для старта это 1,2 и больше, то есть участок должен окупать затраченное на него время в первый же месяц. Если меньше, участок или описан плохо, или не стоило его автоматизировать.
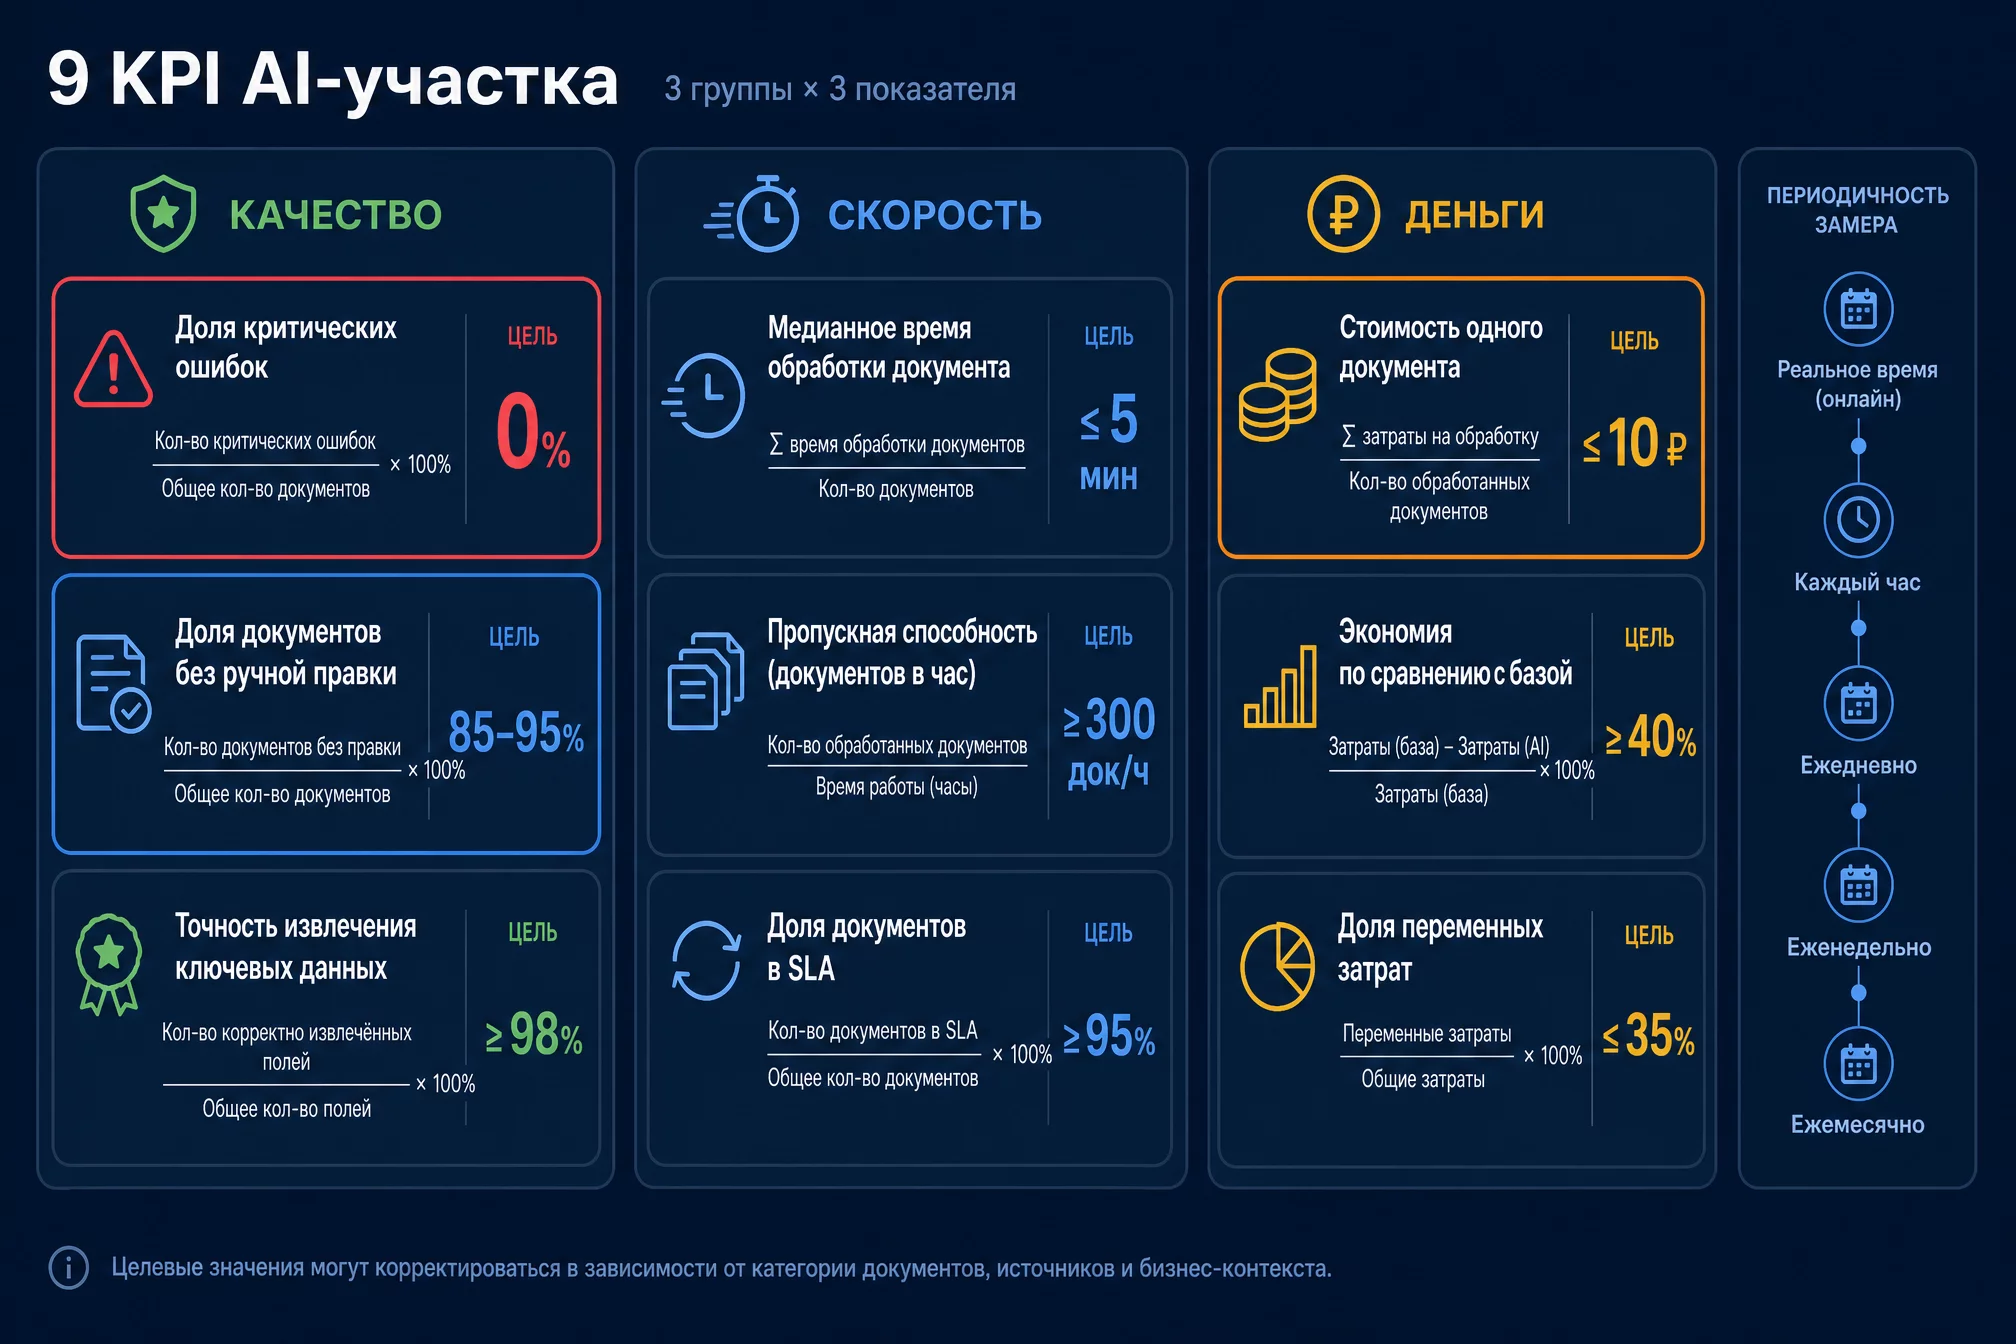
Чем KPI нейросети отличается от KPI сотрудника. У сотрудника измеряют результат работы: сдал в срок, ошибок нет, объём выполнен. У модели измеряют ещё и поведение: как часто она признаётся в неуверенности, как ведёт себя на плохих данных, сколько документов теряет по дороге. Второе важнее первого, потому что модель не устаёт и не ошибается от усталости, но тихо подставляет значения.
Если хотите собрать инструмент целиком, а не по кускам, начните с записи эфира «Навигация по нейросетям для начинающих»: там разбираются базовые сценарии работы с моделями, из которых потом вырастает любой участок. Забрать запись эфира.
Как считать KPI без самообмана: замер «до» и честная база
Любой KPI считается только от замера «до». Если вы не посчитали, сколько участок занимал раньше, цифра экономии превращается в самообман, и первый же вопрос собственника «а откуда вы взяли эти часы» разваливает отчёт.
Как сделать замер «до» за одну неделю. Возьмите один рабочий цикл участка, например закрытие недели по первичке, и запишите три числа. Сколько часов ушло на весь участок. Сколько документов прошло через ваши руки. Сколько ошибок нашлось при проверке. Этого достаточно, чтобы через месяц честно посчитать эффект.
Что считается частью участка. Считайте всё, включая дорогу до документа: поиск письма с накладной, скачивание, переименование файла, разбор переписки. Именно эти шаги съедают время, и именно они исчезают на AI-участке. Если считать только ввод данных, замер будет заниженным и эффект покажется слабее, чем он есть.
Правило одной переменной. Меняйте на участке одну вещь за раз. Автоматизировали первичку и одновременно перешли на новую учётную систему, значит не поймёте, что дало эффект. Двух недель на один участок обычно хватает, чтобы увидеть динамику.
Что делать, если замер «до» не сделан. Ситуация частая, и выход есть: считайте базу оценочной и указывайте это прямо. Сравните себя с нормой по рынку, возьмите среднее время на документ у коллег, честно напишите в отчёте «база оценочная, замер не проводился». Это нормальная практика, которая вызывает больше доверия, чем точная цифра из ниоткуда.
Ты финансовый аналитик. Помоги мне посчитать эффект от AI-участка
без самообмана.

Вот мои данные:
- участок: [название]
- период: [например, сентябрь 2026]
- часов на участок до внедрения: [число] (замер / оценка)
- часов на участок после внедрения: [число]
- документов за период: [число]
- расходы на сервисы за период: [сумма]

Посчитай:
1. Экономию часов в месяц и в пересчёте на рабочие дни.
2. Стоимость одного документа обработки.
3. Экономию в рублях по моей ставке [ставка в час] с оговоркой,
   что это альтернативная стоимость, а не прямая экономия денег.
4. Отдельно назови всё, что в расчёте является допущением,
   и укажи, как это допущение меняет результат.

Не преувеличивай эффект. Если данных для вывода не хватает, скажи об этом.
Как показать цифру собственнику. Три числа, не больше: часы, которые вернулись в работу, количество ошибок, которые стали находиться раньше, и стоимость обработки одного документа. Если время не превратилось в деньги напрямую, так и говорите: часы ушли в работу с клиентами, а не в экономию фонда оплаты труда. Честная формулировка вызывает больше доверия, чем округлённая выгода.
Типичные способы завысить результат. Считать время модели, а не время человека. Сравнивать новую скорость с идеальным днём, а не со средним. Не учитывать две недели на старте. Считать, что качество со временем вырастет само, без обновления ТЗ. Любой из этих приёмов даёт красивую цифру в первом отчёте и разочарование в третьем.
Сколько стоит час вашего времени. Чтобы посчитать экономию в рублях, нужна ставка. Возьмите либо свою часовую ставку, либо стоимость аутсорса, делённую на часы, либо среднюю стоимость часа специалиста вашего уровня на рынке. Важно понимать, что это альтернативная стоимость, а не прямая экономия: деньги не появляются в кассе, они появляются в виде освободившегося времени. Называйте это честно, иначе первый же вопрос «а где эти деньги» поставит вас в неудобное положение.
Как показать эффект, если часы не превратились в деньги. Есть три формулировки, которые работают. Первая: расхождения находятся до сверки, а не после, то есть уменьшился риск. Вторая: участок не зависит от одного человека, то есть уменьшилась хрупкость процесса. Третья: появилась возможность брать больше объёма без найма, то есть вырос потолок. Любая из этих формулировок проверяема и не требует выдуманных рублей.
Когда участок стоит закрыть. Бывает и так, что замер «до» и «после» показывает экономию в один-два часа в месяц при десяти часах, потраченных на внедрение. В этом случае честный вывод такой: участок не окупается, автоматизировать его не нужно. Это нормальный результат разбора, а не провал. Зато вы точно знаете, что проверили гипотезу за месяц, а не за год энтузиазма.
Что нейросеть на участке не сделает никогда?
Четыре вещи остаются за человеком независимо от модели и от качества ТЗ: подпись, профессиональное суждение, норма и переговоры. Это не недостаток технологии, это граница ответственности, которую нельзя передать программе.
Подпись и ответственность. Отчётность подписывает человек. Вместе с подписью он принимает ответственность за цифры. Если вы отправляете отчёт, который собрала модель, а сами его не читали, вы подписали то, чего не проверяли. Это правило не меняется ни от качества модели, ни от размера компании.
Профессиональное суждение. Создавать резерв или нет, признавать выручку в этом периоде или в следующем, признавать контрагента надёжным или нет. Модель выдаст варианты и аргументы, но выбор влияет на деньги и риски, поэтому его делает человек.
Норма. Ставки, лимиты, сроки, формы, номера пунктов. Модель называет их уверенным тоном, и уверенный тон усыпляет бдительность. Рабочее правило простое: логику берите у модели, норму у первоисточника. Как выстроить эту проверку системно, я разбирала в статье про ответственность за ошибки AI в отчётности.
Переговоры. Разговор с налоговой, банком или клиентом, который не платит. Модель готовит письмо и аргументы, но разговор ведёт человек со своим пониманием ситуации. Интонация, пауза и уступка в нужный момент пока недоступны.
Граница проходит по вопросу «можно ли откатить». Всё, что можно перепроверить и откатить, можно смело отдавать модели. Всё, что уходит наружу или влияет на решение необратимо, проходит через человека. Этот критерий проще, чем списки запретов, и работает в любой отрасли.
Как звучит эта граница для собственника. Простая формулировка: модель делает всю подготовительную работу, человек принимает решение и отвечает. Если собственник спрашивает, кто виноват в ошибке, ответ не «нейросеть», а имя владельца процесса из седьмого блока ТЗ. Такая честная постановка снимает большую часть внутреннего сопротивления: люди не боятся, что их заменят, когда понимают, что ответственность остаётся на них и она ценнее, чем раньше.
Что это значит для команды. Работа меняется не в сторону сокращения, а в сторону смещения: меньше ввода, больше проверки и разбора. Кому-то из команды это даётся тяжело, потому что меняется привычный ритм. С этим нужно работать отдельно: показать на цифрах, что уходит рутина, и дать время на адаптацию. Команда, которая поняла свою новую роль, работает с моделью заметно лучше той, которой просто выдали доступ.
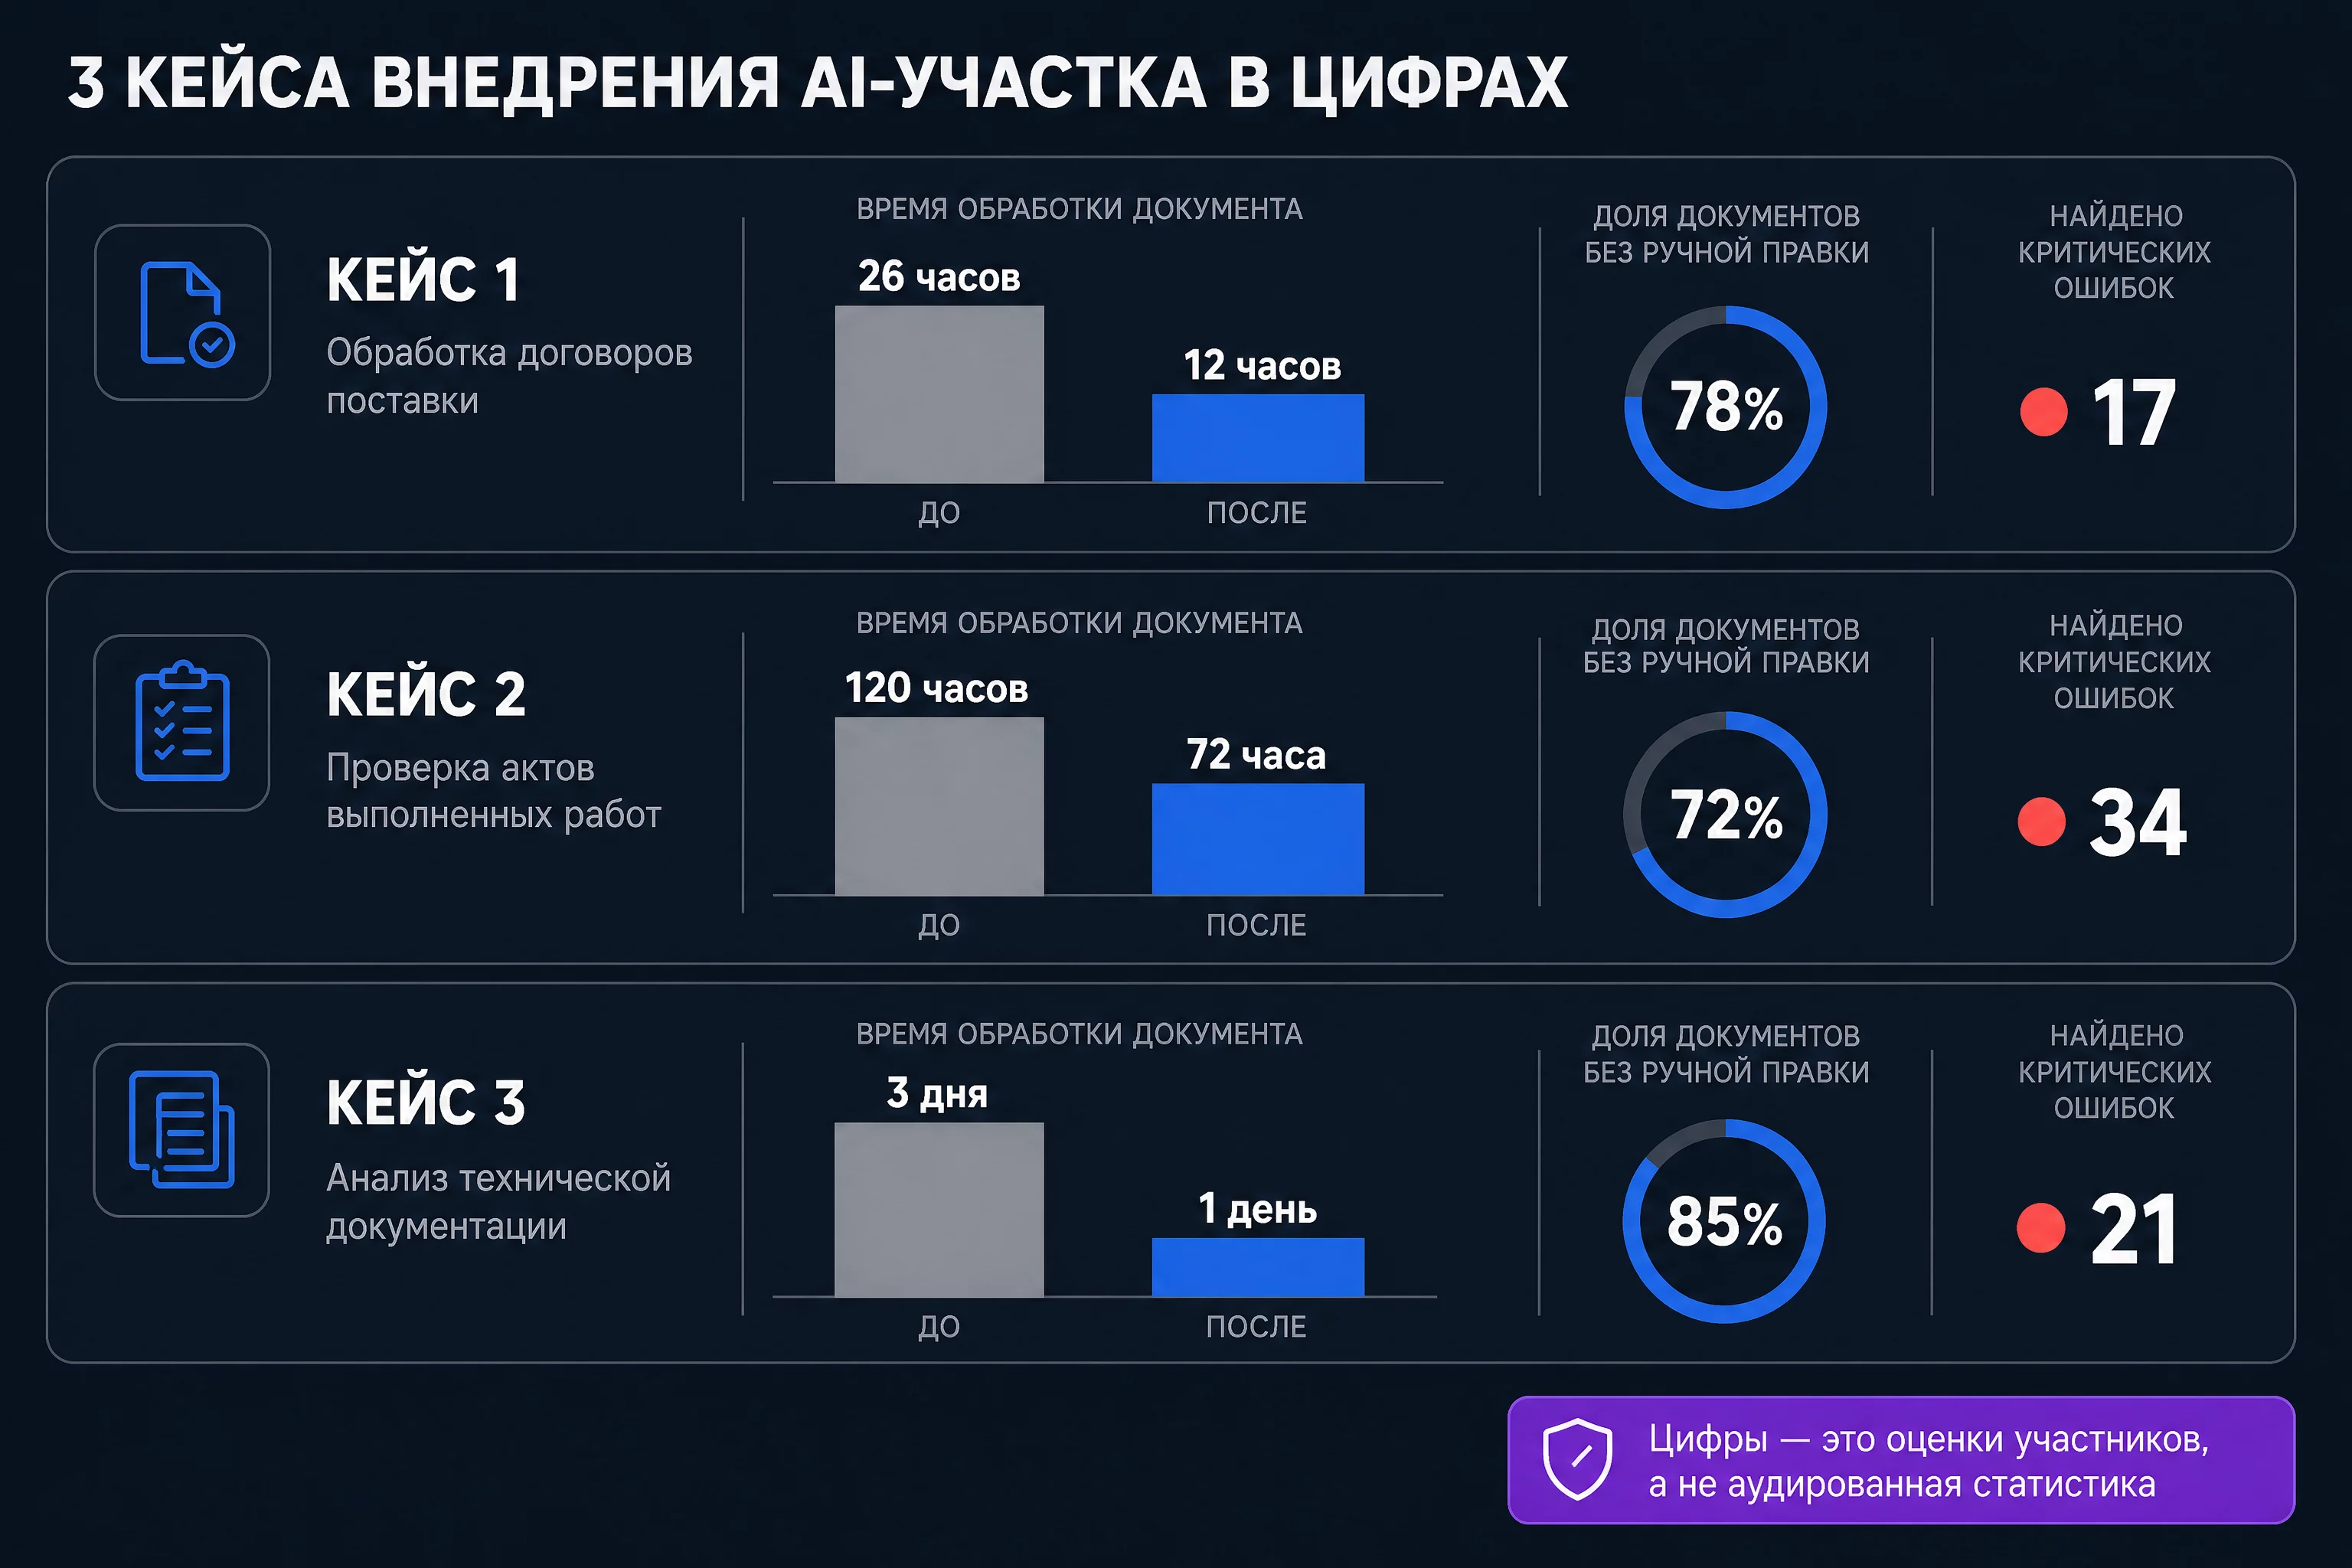
Три кейса: приёмка, KPI и что пошло не так
Кейсы ниже собраны на наших разборах и в работе с выпускниками. Имена изменены, цифры приведены так, как их называли участники, и это их собственные оценки, а не аудированная статистика.
Кейс 1. Участок первички в компании на ОСНО: 420 документов в месяц, минус 14 часов
Вводные. Производственная компания, упрощённый оборот около 180 млн рублей в год, бухгалтер на первичке и главбух на проверке. Участок разбора входящих документов занимал около 26 часов в месяц, из них большая часть уходила на ручной ввод с бумаги. Средняя точность ручного ввода, по замерам главбуха, давала одну-две ошибки в месяц, которые находились уже при сверке.
Что сделали. Замерили участок за две недели до старта. Описали ТЗ по семи блокам, собрав тест-набор из 50 документов, из которых 18 были заведомо неудобными. Провели приёмку, зафиксировали результат протоколом. После этого запустили рабочий прогон с построчной проверкой на две недели и выборочной проверкой дальше.
Результат приёмки. Точность по сумме 97%, по дате 99%, по контрагенту 94%. Доля документов без ручной правки 88%. На плохих сканах точность падала до 71%, но при этом модель помечала такие документы как требующие проверки в 82% случаев. Критических ошибок на тест-наборе ноль.
Результат в работе. Через два месяца участок занимал 12 часов вместо 26, то есть 14 часов экономии. По ставке бухгалтера это порядка 35 000 рублей в месяц в пересчёте на альтернативную стоимость. Время вернулось не в экономию, а в сверку с поставщиками, которая раньше делалась по остаточному принципу.
Что пошло не так. На третьей неделе нашлась тихо подставленная сумма: модель прочитала «1 250,00» как «1 250 000» на накладной с размытой печатью. Ошибку поймали на сверке. После разбора в ТЗ добавили правило: любая сумма выше установленного порога на документе этого типа выносится на ручную проверку без исключений. Порог поставили по максимальной исторической сумме поставки с запасом 30%.
Кейс 2. Бухгалтер на аутсорсе, восемь клиентов: KPI вместо ощущений
Вводные. Бухгалтер ведёт восемь ИП и небольших ООО, суммарно около 120 часов в месяц. Участок первички и выписки по каждому клиенту занимал от 8 до 18 часов в месяц в зависимости от объёма. Решения принимались на ощущениях: «кажется, стало быстрее».
Что сделали. Замерили время по каждому клиенту отдельно, потому что средняя цифра по портфелю ничего не показывает. Собрали отдельное ТЗ и отдельный тест-набор по каждому клиенту: у всех свои поставщики, свои статьи и свои формулировки в назначениях платежей. Ввели один общий набор из девяти KPI и журнал ошибок на каждого клиента. Раз в месяц разбор: три-пять ошибок и одна новая версия ТЗ.
Результат. Среднее время на клиента упало с 15 до 9 часов, суммарно освободилось около 48 часов в месяц. Доля документов без ручной правки вышла на 91% по типовым клиентам и на 84% по двум сложным, где много рукописных документов. Появилась возможность взять ещё двух клиентов без найма помощника.
Что пошло не так. Первый месяц ушёл на четыре ТЗ вместо одного, и бухгалтер оказалась на грани выгорания: объём вырос, а отдача ещё не пришла. Пришлось остановиться, довести до конца одного клиента, а остальных вести по накатанному шаблону. Второй заход занял втрое меньше времени. Вывод простой: не автоматизируйте восемь участков одновременно, даже если очень хочется.
Отдельная находка. Коэффициент эскалации на двух клиентах оказался 28%, то есть модель сомневалась почти в каждом третьем документе. Причина была не в модели, а в правилах: в ТЗ не описали, что делать с документами, где НДС выделен отдельной строкой. После добавления одного правила показатель упал до 11%, а точность выросла.
Кейс 3. Финдир в торговой компании: участок сводки для собственника
Вводные. Торговая компания с оборотом около 700 млн рублей в год, финансовый директор и два аналитика. Сводка для собственника собиралась три дня и состояла из выгрузок, которые сводились руками в Excel. Основная проблема была не в часах, а в том, что к моменту готовности часть цифр уже устаревала.
Что сделали. Разбили участок на две части: сбор и первичная сводка данных, разбор отклонений и выводы. Первую часть отдали модели по ТЗ, вторую оставили за финдиром. KPI поставили три: время цикла, доля расхождений, найденных до отправки, и количество правок после отправки собственнику.
Результат. Время цикла сократилось с трёх дней до одного рабочего дня, при этом изменилась не скорость модели, а исчезли простои на ожидании выгрузок. Количество правок после отправки упало с четырёх-шести до одной-двух на выпуск. Третий KPI оказался самым полезным: он показывал, что именно не сходится в правилах сборки.
Что пошло не так. Первая версия ТЗ описывала выходной формат «как в прошлый раз». На приёмке выяснилось, что «как в прошлый раз» никто не может сформулировать: у каждого аналитика был свой вид сводки. Пришлось сначала зафиксировать формат на бумаге, и только потом отдавать его модели. Это тот самый блок ТЗ, который чаще всего пропускают.
Какие ошибки убивают приёмку и KPI?
Я собрала шесть ошибок, которые повторяются почти в каждом внедрении. Все они стоят времени, а некоторые и денег, и почти все связаны не с моделью, а с организацией работы.
Ошибка 1. Принимать работу по хорошим документам. Аккуратные сканы дают точность 95% и выше, после чего участок принимается, а на живом потоке начинаются проблемы. Лечится тестом на неудобных документах из общего объёма, а не из личного архива.
Ошибка 2. Не фиксировать ТЗ письменно. Правила живут в переписке, у каждого своя версия, при смене исполнителя участок умирает. Файл правил на одну-две страницы это не бюрократия, а рабочий инструмент.
Ошибка 3. Считать среднюю точность по всем полям вместе. Ошибка в поле «назначение» смазывает статистику по сумме и НДС. Считайте поля отдельно, вес у них разный. Как связаны ошибки в цифрах и деньги, я разбирала в статье про галюцинации нейросетей в финансовых данных.
Ошибка 4. Менять модель вместо правил. Типовая реакция на ошибки: «попробуем другую модель». В девяти случаях из десяти причина в ТЗ, а не в модели. Сначала допишите правило, потом сравнивайте модели. Полезно помнить: качество даёт ваш файл правил и отлаженный запрос, а не название модели. Обзор актуальных моделей есть в статье какую нейросеть выбрать финансисту.
Ошибка 5. Загружать реальные данные без обезличивания. Уберите ФИО сотрудников, номера договоров и ИНН контрагентов там, где они не нужны для разбора. Для черновых задач подходит DeepSeek V4.1 Flash, он работает без VPN. Настройки сервисов проверяйте до загрузки данных, а не после. Подробнее об этом в статье про обезличивание данных при работе с ChatGPT.
Ошибка 6. Не вести журнал ошибок. Без журнала вы разбираете одни и те же случаи по кругу и не видите прогресса. Журнал это три столбца: дата, что пошло не так, какое правило добавили. Через месяц он превращается в самый ценный документ участка.
Отдельно про ошибку, которая выглядит как успех. Иногда доля документов без ручной правки растёт, а качество падает. Причина в том, что человек перестаёт проверять. Показатель поднимается, а критические ошибки никто не считает. Держите эти два KPI рядом: один без другого не значит ничего.
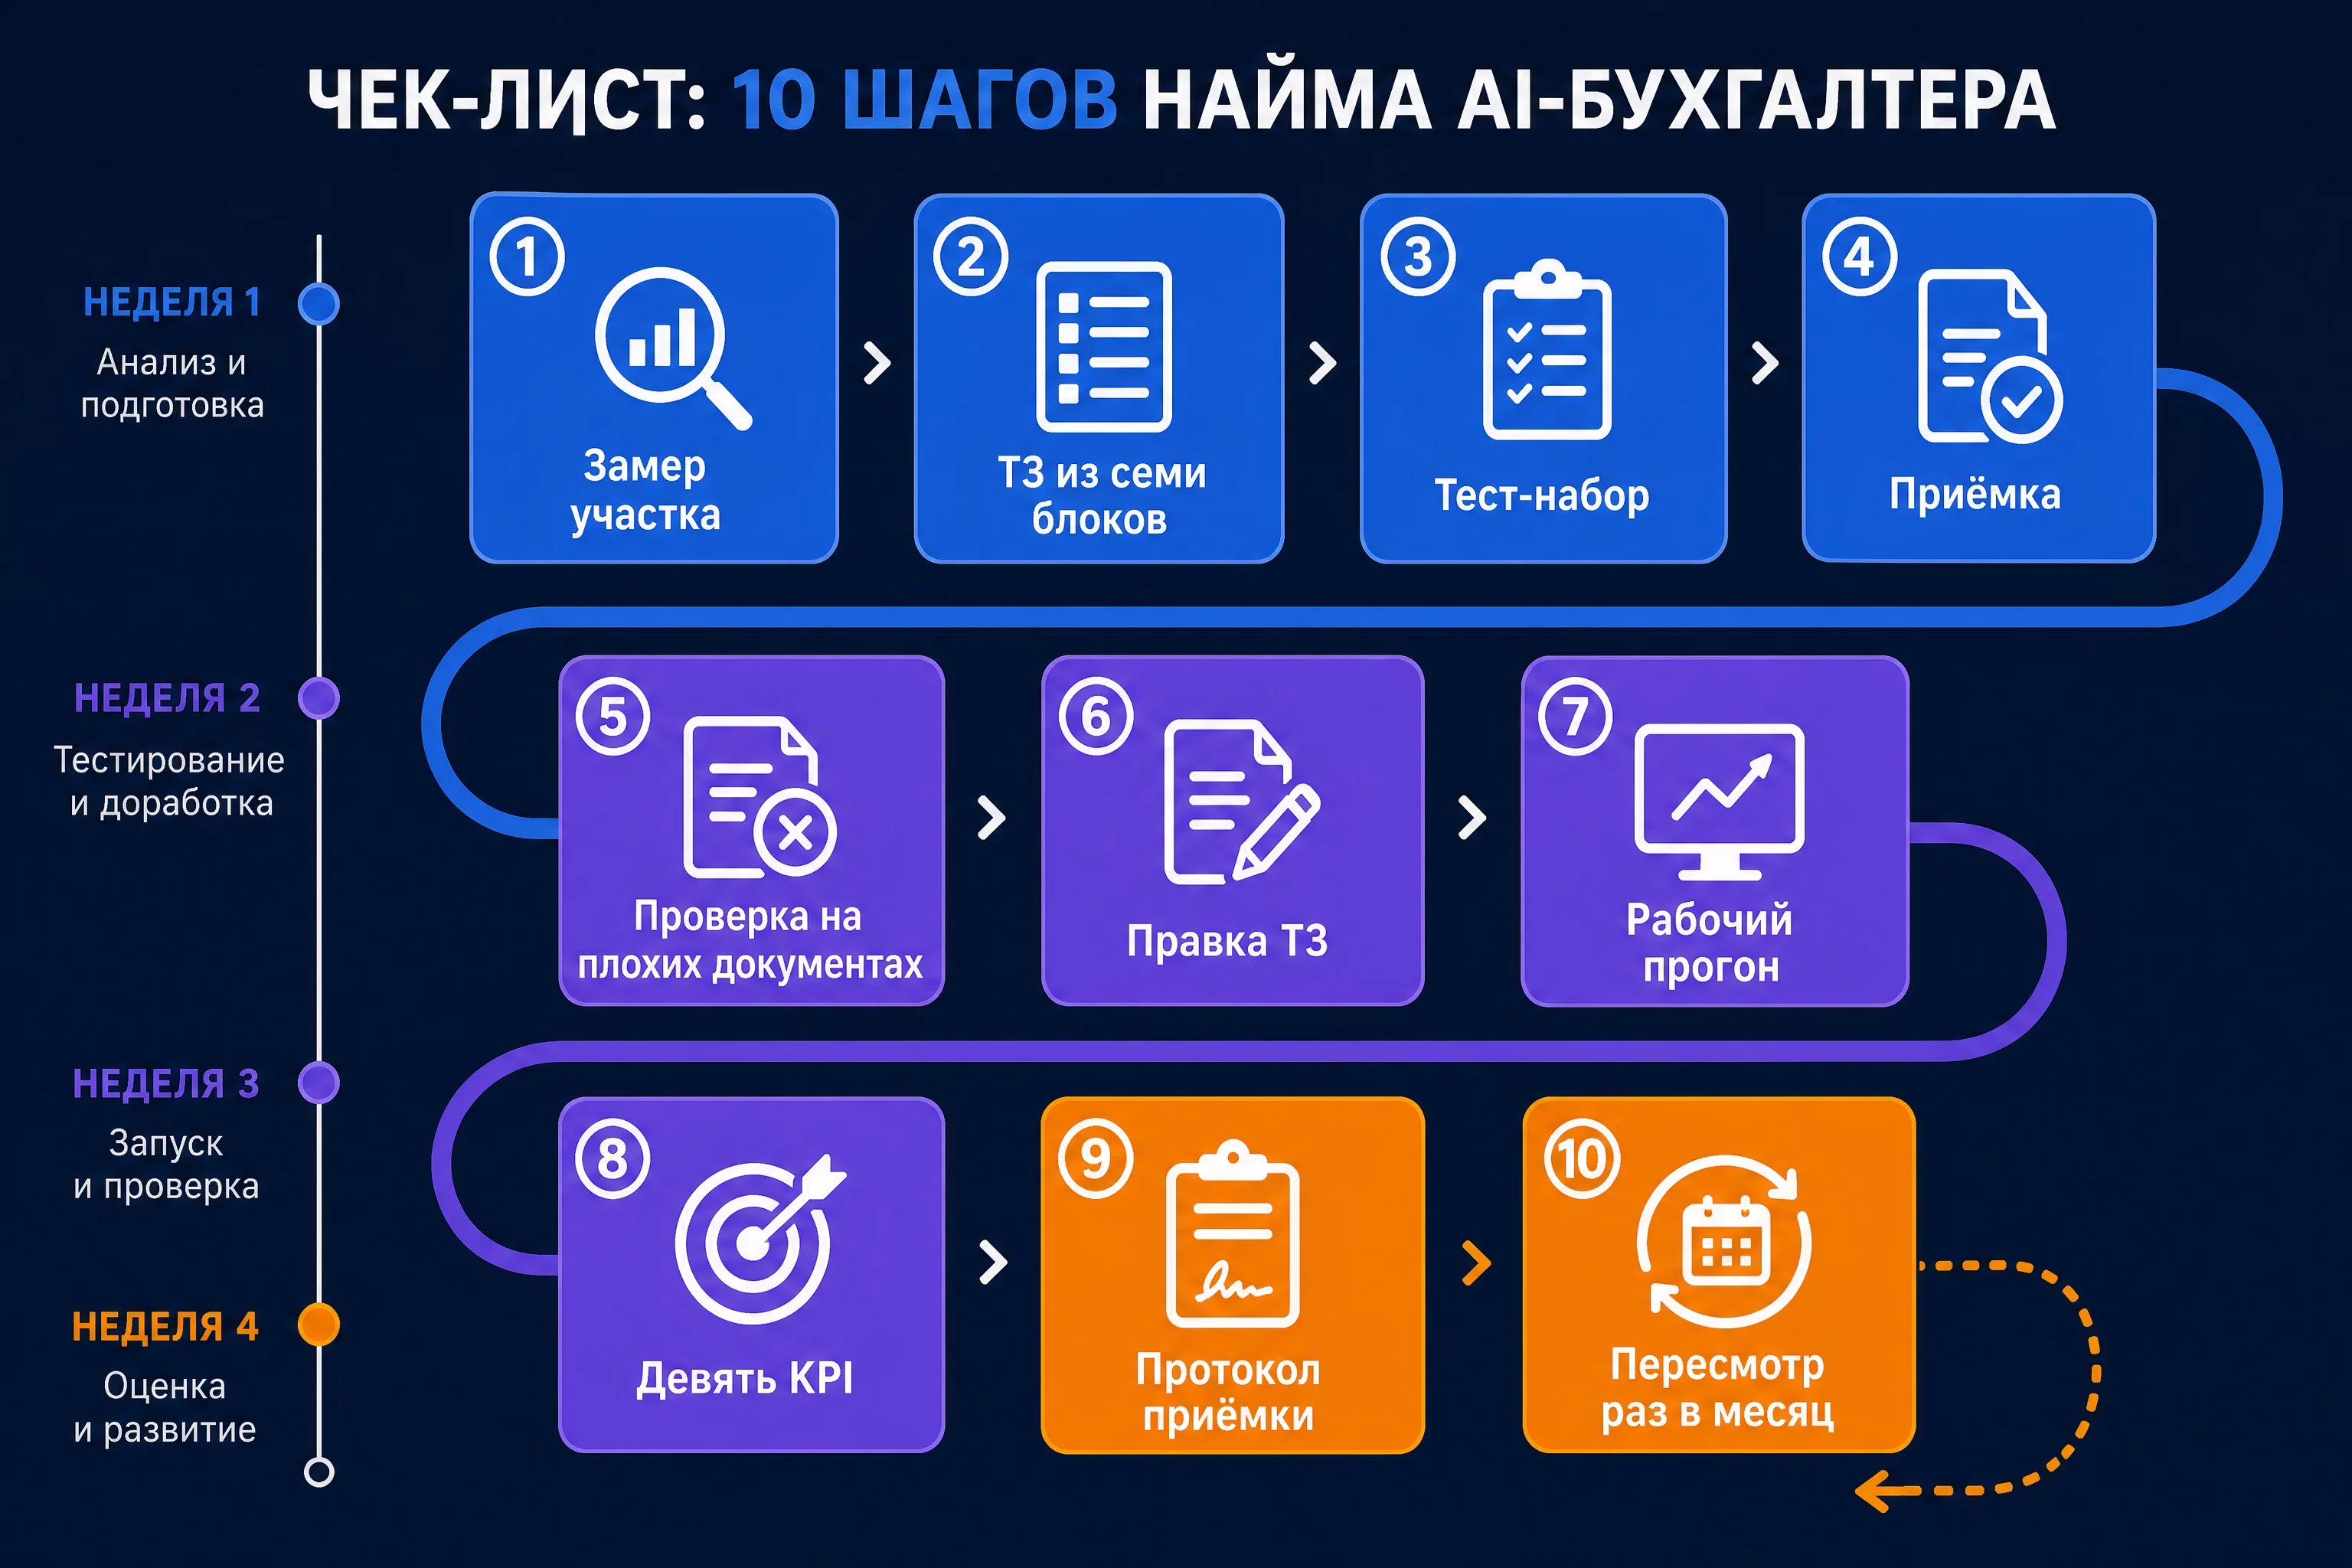
Чек-лист: нанять AI-бухгалтера за четыре недели
Ниже порядок, по которому я советую идти. Каждый шаг проверяемый, и после каждого понятно, двигаться дальше или остановиться.
- Замерьте участок руками. Один цикл, три числа: часы, документы, найденные ошибки. Без этого шага все следующие цифры будут спорными.
- Опишите ТЗ по семи блокам. Границы, вход, выход, правила, исключения, критерии приёмки, владелец процесса. Двадцать-тридцать минут разговора с моделью в роли методиста.
- Соберите тест-набор из 30-50 документов. Треть должна быть неудобной. Разметьте правильные значения заранее, руками.
- Проведите приёмку на тест-наборе. Посчитайте точность по полям, полноту, долю документов без ручной правки. Каждую ошибку в журнал.
- Проверьте поведение на плохих документах. Модель должна помечать непрочитанное, а не подставлять похожее. Это отдельный тест, не совмещайте его с первым.
- Перепишите ТЗ по результатам приёмки. Два-три уточнения обычно дают заметный рост точности. Не переписывайте всё, дописывайте правила точечно.
- Запустите рабочий прогон на две-три недели. Первые две недели проверяйте построчно, дальше выборочно. Построчная проверка это нормальный этап, а не признак провала.
- Введите девять KPI и считайте их раз в месяц. Критические ошибки считайте штуками и разбирайте каждый случай отдельно.
- Фиксируйте результат протоколом приёмки. Одна страница: версия ТЗ, состав набора, показатели, решение. Через три месяца вы сравните с ней и увидите деградацию вовремя.
- Пересматривайте ТЗ раз в месяц. Один разбор ошибок, одна новая версия. Участок без пересмотра деградирует, потому что меняются поставщики и правила учёта.
Что делать, если участок не прошёл приёмку. Не бросайте сразу. Сначала посмотрите на три вещи: качество входных данных, полноту ТЗ и тип ошибок. Если ошибки однотипные, вам не нужна новая модель, вам нужно одно правило. Если ошибки разные и на плохих документах, участок просто не подходит для автономной работы, оставьте его в режиме «модель готовит черновик, человек доводит». Это тоже рабочий результат, просто с другой экономией.
Что изменится на участках к 2027 году?
Три изменения я ожидаю увидеть на участках учёта в течение ближайшего года, и они уже видны по тому, как меняются модели.
Первое: приёмка станет быстрее. Сейчас значительная часть времени уходит на ручную разметку тест-набора. Инструменты сравнения двух таблиц и автоматической сверки результата с документом уже работают хорошо, и эта часть будет занимать минуты вместо часов. Разметку будет делать модель, а человек только утверждать спорные случаи.
Второе: KPI сместятся с точности на предсказуемость. Точность разбора первички уже высокая у всех основных моделей, и она перестаёт быть точкой различия. Различать участки будет поведение на плохих данных: сколько документов помечено как непрочитанные, сколько потеряно, как быстро модель признаёт, что не справляется.
Третье: ТЗ станет обычным рабочим документом. Сегодня это ещё эксперимент для энтузиастов. Через год описание участка в файле правил будет таким же обязательным элементом, как учётная политика. Причина простая: без ТЗ участок не масштабируется на второго и третьего сотрудника.
Что это значит для вас практически. Не ждите, пока появятся идеальные инструменты приёмки. Начните с одного участка и одного тест-набора на 30 документов, и за месяц у вас будет работающий регламент и честная цифра. Инструменты догонят, а понимание участка останется у вас.
Чего не изменится. Подпись, ответственность и профессиональное суждение останутся за человеком, и это не техническое ограничение, а вопрос ответственности. KPI будут измерять поведение модели на плохих данных, но решение о том, что делать с найденной ошибкой, всё равно примет человек. Поэтому навык описывать участок и проверять результат останется базовым независимо от того, насколько умными станут модели.
Частые вопросы про найм AI-бухгалтера
Что такое AI-бухгалтер и это человек или сервис?
Ни то, ни другое в привычном смысле. Это участок учёта, описанный в ТЗ и закрытый моделью по регламенту. Вы описываете границы, правила и критерии приёмки, а работает модель. Владельцем процесса остаётся человек: он проверяет, ведёт журнал ошибок и отвечает за цифры. Подробный разбор в разделе «Что такое AI-бухгалтер и почему его нельзя нанять».
Сколько стоит нанять AI-бухгалтера в рублях?
Прямые расходы от 5 000 до 15 000 рублей в месяц: подписка на модель от нескольких тысяч рублей и, при необходимости, сервис распознавания документов за 500-2 000 рублей. Плюс ваше время на первый участок: от 8 до 16 часов. Через месяц участок обычно обходится дешевле аутсорса на сопоставимом объёме. Полная таблица сравнения схем есть в статье.
Какой KPI у нейросети главный?
Критические ошибки. Это случаи, когда модель подставила правдоподобное значение вместо правильного и это ушло в учёт незамеченным. Считайте их штуками, а не процентами, и разбирайте каждый случай. Средняя точность 96% с двумя критическими ошибками хуже, чем 92% без них. Таблица из девяти KPI с нормами есть в статье.
Сколько документов нужно для честной приёмки?
Минимум 30, рабочий вариант 50. Треть должна быть неудобной: мятые сканы, фотографии под углом, рукописные правки, две даты, НДС отдельной строкой, нетиповые контрагенты. Если набрать только аккуратные документы, точность выйдет 95% и выше, и решение о внедрении будет принято по завышенной оценке.
Можно ли отдать участок модели полностью, без проверки?
Только там, где цена ошибки близка к нулю: черновики писем, внутренние сводки, справочные подборки. Всё, что попадает в учёт или уходит наружу, проходит через владельца процесса. Рабочая схема такая: модель разбирает всё, человек проверяет расхождения и помеченные поля. Это занимает 10-15% времени от ручного ввода.
Что делать, если модель ошибается на одном типе документов?
Дописать правило в ТЗ, а не менять модель. Однотипная ошибка почти всегда означает, что в описании участка не хватает условия. Заведите журнал ошибок, разберите три-пять случаев, добавьте правило. Если ошибки разные и держатся на плохих документах, оставьте участок в режиме черновика, который доводит человек. Про журнал ошибок есть раздел «Какие ошибки убивают приёмку и KPI».
Нужен ли AI-бухгалтер при объёме 50 документов в месяц?
При таком объёме экономия в часах будет небольшой, а время на ТЗ и приёмку сопоставимо с ручной работой. Смысл появляется, если документы неудобные или если вам важнее единый регламент, а не скорость. Для объёма меньше 100 документов начинайте с одной задачи, а не с целого участка.
Как часто пересматривать ТЗ и KPI?
ТЗ раз в месяц, KPI тоже раз в месяц. Разбор ошибок и одна новая версия файла правил. Участок без пересмотра деградирует: меняются поставщики, появляются новые формулировки в назначениях платежей, обновляются формы документов. Если через полгода ТЗ не менялось ни разу, скорее всего участок просто перестали смотреть.
Разовые запросы к модели дают разовые ответы и ничего не меняют в работе. Участок даёт накопление: ТЗ на две страницы, тест-набор на 40 документов и девять KPI превращают переписку с чатом в рабочее место, за которое кто-то отвечает. Промпты, таблица KPI и чек-лист из этой статьи закрывают инструментальную часть. Дальше вопрос одного участка и одного замера, который вы сделаете на этой неделе.
Если вы хотите собрать такую систему под свой участок, приходите на курс «AI-навыки финансиста». Программу собрала основатель школы Софья Бурцева, в ней 11 модулей, больше 75 практических уроков и свыше 50 промптов и шаблонов, включая блок по описанию процессов и приёмке работы нейросети. Записаться на курс.
Если хотите начать с бесплатного, заберите запись эфира «Навигация по нейросетям для начинающих» (0 ₽, 19:00 МСК) и базовый курс, на котором строится вся работа с моделями. Забрать запись эфира.
Натали Васильева. Эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO». С нейросетями в работе финансиста с февраля 2023 года. Через курс «AI-навыки финансиста» прошли 800+ финансистов, главбухов и финдиров. Веду Telegram-канал @findir_pro (45 000 подписчиков), канал «АИ с Софьей и Натали» (13 000 подписчиков) и MAX-канал «Финансовый директор» (5 000+ участников).
Три канала школы, где выходят разборы
@findir_pro (45 000 финансистов): промпты, разборы кейсов, инструменты для CFO и главбуха каждый день.
«АИ с Софьей и Натали» (13 000 подписчиков): обзоры моделей и честные тесты применения AI в финансах, включая разборы ТЗ и приёмки.
MAX (5 000+ участников): закрытое сообщество выпускников онлайн-школы, живые разборы задач и нетворкинг с коллегами.
Полезные источники. Работать с моделями удобнее на официальных страницах сервисов: ChatGPT и Claude. Нормы учёта и налоги всегда сверяйте по первоисточникам: Налоговый кодекс РФ и документы Минфина России, а не по ответу модели.
Модель не станет сотрудником и не возьмёт на себя ответственность. Но участок, описанный в ТЗ, принятый на реальных документах и измеренный девятью KPI, работает предсказуемо и освобождает часы, которые уходят в работу, а не в перепроверку. Начните с одного замера и одного тест-набора, и через месяц у вас будет не впечатление, а цифра.