Профессия и защита
KPMG, Polymarket и аномальные ставки: чему скандал учит финансиста и как ChatGPT находит отклонения в данных раньше аудитора

12 сентября 2026 года The Wall Street Journal рассказала историю, которая на первый взгляд не имеет к российскому финансисту никакого отношения. Аналитическая компания Bubblemaps проследила движение средств на рынке предсказаний Polymarket и показала, что за 19 кошельками стоит одна группа. Группа сделала 42 ставки на то, превысят ли квартальные результаты публичных компаний ожидания аналитиков, и угадала 41 раз. Прибыль оказалась смешной по меркам Уолл-стрит, около 22 тысяч долларов, а вот состав компаний куда интереснее: почти все они проверяются одной и той же аудиторской фирмой, KPMG. Параллельно американские следователи ведут дело против сотрудника KPMG, подозреваемого в ставках на непубличной информации о клиентах.
Я Натали Васильева, отвечаю за направление нейросетей в онлайн-школе «Финансовый директор | Мастер CFO» и с февраля 2023 года разбираю с финансистами практические задачи. Меня в этой истории интересует не биржа и не крипта, а механика: как отклонение в данных становится видно снаружи раньше, чем внутри, и что из этого может забрать себе обычный финдиректор с подпиской на ChatGPT. Актуально на 13 сентября 2026 года.
Коротко: семь тезисов для тех, у кого нет времени
Ниже версия на минуту чтения, без пояснений. Дальше каждый пункт разобран отдельно: с промптами, цифрами из моих разборов и таблицами.
- Сигнал был не в ставках, а в концентрации. 42 сделки, 41 в плюс, один и тот же круг компаний, одни и те же счета.
- Аудитор идёт по плану и выборке, рынок смотрит на всё сразу. Отсюда и разрыв в скорости.
- Аномалия это не ошибка, а отклонение, которому нужно объяснение.
- ChatGPT не заменяет аудитора, он прогоняет восемь маркеров по всей выгрузке, а не по тридцати операциям из выборки.
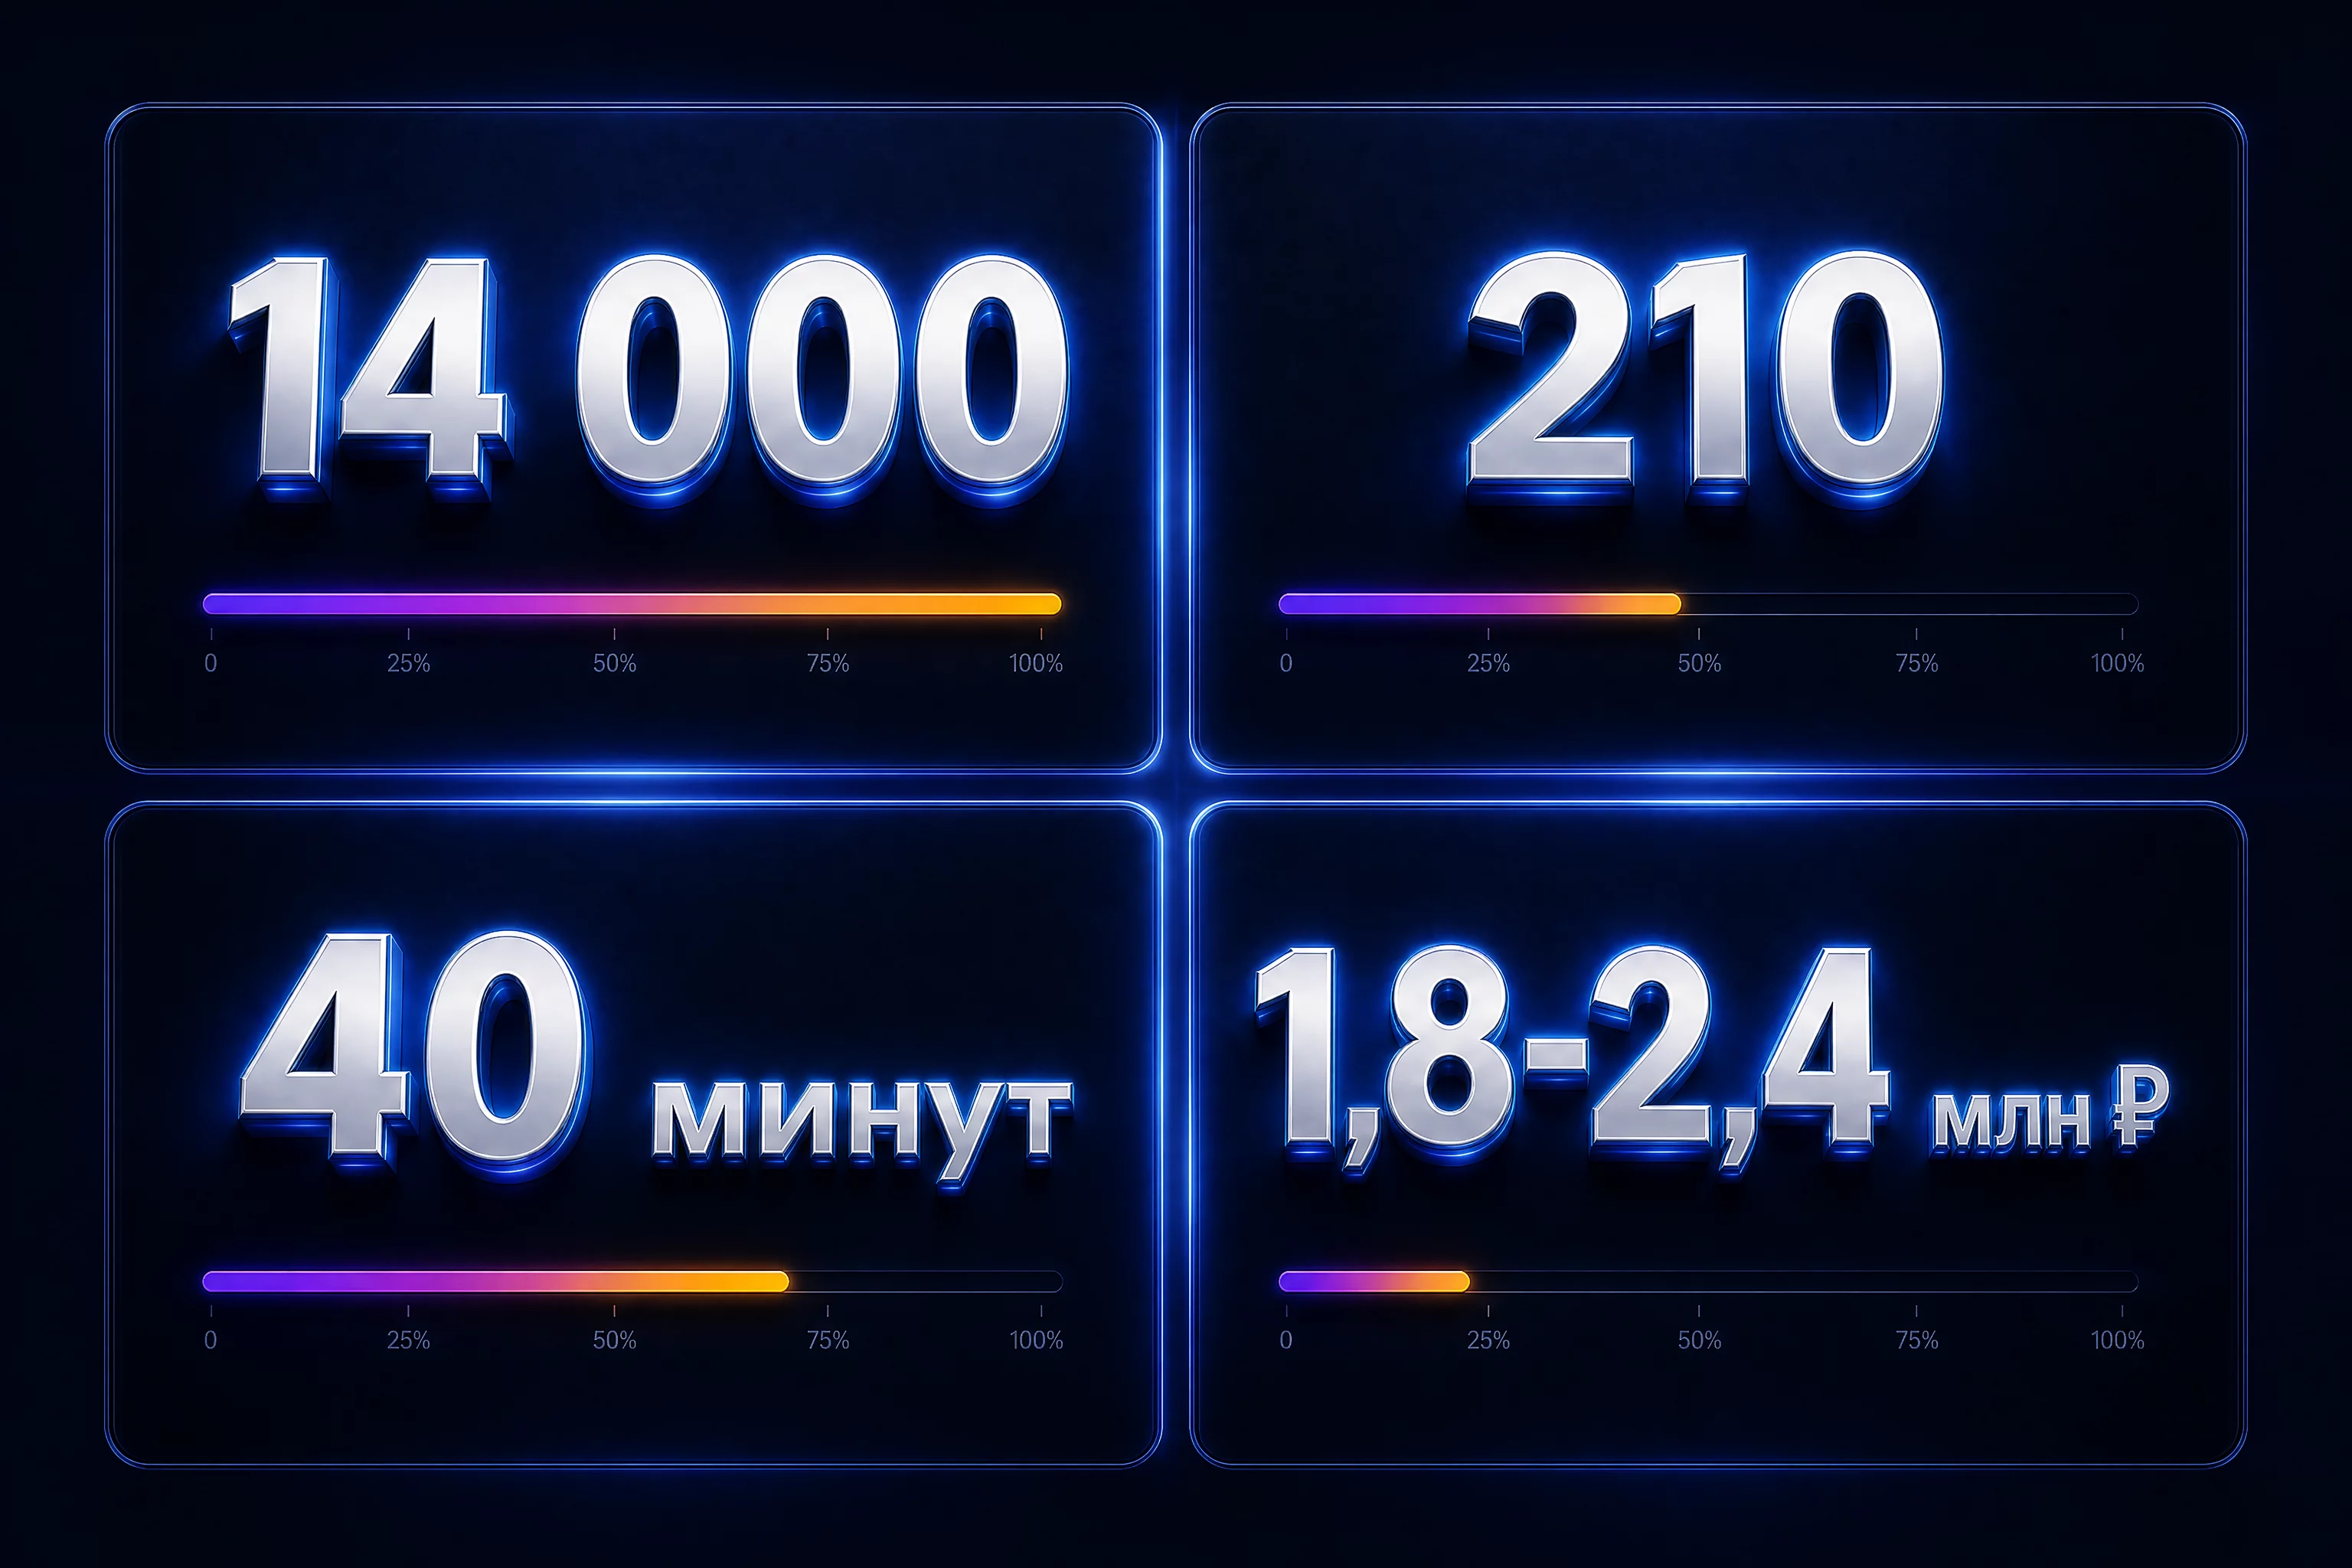
- Разбор выгрузки на 10-15 тысяч строк занимает от 40 минут до двух часов против нескольких дней ручной сверки.
- Без письменного объяснения по каждому отклонению отчёт превращается в красивую картинку с нулевой пользой.
- Контроль работает только там, где у необъяснённого отклонения есть цена для конкретного человека. В разборе из четвёртого кейса вопрос собственника звучал не «сколько мы потеряли», а «почему не видели вы».
Что случилось: 19 счетов, 42 сделки и одно совпадение
Разложу факты по порядку, потому что в пересказе они обычно теряют самое интересное.
Разбор сделала Bubblemaps, компания, которая занимается анализом блокчейна. Она проследила, как средства двигались между 19 кошельками на Polymarket, и показала, что кошельки связаны между собой. Счета на протяжении нескольких месяцев ставили на исходы квартальных отчётов. Результат: 42 сделки, 41 прибыльная, это около 98 процентов попаданий. Точность выше 97 процентов для рынка, где даже сильные прогнозисты редко уходят выше 60, это не мастерство, а доступ к информации.
Дальше начинается самая показательная часть. Компании в этих ставках были не случайные: Wells Fargo, Home Depot, DoorDash, General Mills и другие, всего 18 эмитентов. Общее у них одно: отчётность проверяет KPMG. Для финансиста здесь важна не сама связь, а её тип. Это не совпадение по отрасли, не совпадение по размеру выручки и не совпадение по сезонности. Это совпадение по единственному признаку, который к рыночному поведению компании отношения не имеет вообще: по имени аудитора. Именно такие пересечения по служебному признаку и выдают схему, потому что нормальный инвестор выбирает бумагу по бизнесу, а не по тому, кто её проверяет. Сумма прибыли при этом всего около 22 тысяч долларов, что для инсайдера выглядит почти комично, но юридического веса это не снимает: схему оценивают не по размеру выигрыша, а по способу его получить. Одновременно следователи в США ведут дело против сотрудника KPMG, которого подозревают в ставках на непубличных данных о клиентах.
Отдельно отмечу, чего в этой истории нет, потому что вокруг неё уже выросло несколько мифов. Официально не подтверждено, что группа кошельков и подозреваемый сотрудник это одни и те же люди. Обвинения никому не предъявлены, решения суда нет. KPMG со своей стороны заявила, что у компании действует политика нулевой терпимости к торговле на непубличной информации клиентов, и добавила, что усилила мониторинг таких операций. Самые важные слова здесь, впрочем, принадлежат Bubblemaps: её разбор инсайд не доказывает. Анализ показал связь между кошельками и совпадение по эмитентам, причину этой связи он не объясняет. Для нашей темы это ровно то, что нужно: перед нами не обвинение, а аномалия. Сигнал, который требует объяснения.
Что такое аномальная ставка и почему рынок замечает её раньше проверяющего
Аномальная ставка это сделка или группа сделок, чей результат статистически несовместим с обычным поведением участников рынка. Формулировка звучит академично, но за ней стоит простая вещь: кто-то получает результат слишком стабильно, чтобы это объяснялось везением.
Прежде чем разбирать механику, посчитаю, почему 41 попадание из 42 это не везение. Если бы участник просто угадывал направление, шанс выдать такой результат был бы исчезающе мал: серия из сорока с лишним независимых попаданий подряд при честной монетке практически не встречается. Даже при точности в 70 процентов, недостижимой для систематического прогноза на квартальных отчётах, шанс выдать 41 из 42 остаётся исчезающе малым. Именно поэтому аналитики говорили не о мастерстве, а о доступе к информации. Для финансиста здесь полезен сам приём: любое отклонение в ваших данных имеет свою базовую вероятность, и пока вы её не прикинули, вы не знаете, странная перед вами цифра или обычная.
Почему это заметили снаружи, а не внутри? Потому что у двух сторон разные задачи и разные инструменты.
Рынок смотрит на всё. Аналитическая система не выбирает тридцать документов из тысячи. Она прогоняет весь массив и сравнивает профили: кто ставит, как часто, на что, как меняется поведение счёта до и после события. Совпадение по 18 эмитентам, связанным одним аудитором, вылезает автоматически, потому что это пересечение по признаку, а не совпадение по случайности.
Проверяющий работает по плану. Аудитор строит выборку исходя из оценки рисков, сроков и бюджета часов. Он не может проверить всё, иначе проверка станет дороже бизнеса. Он идёт по существенности: крупные суммы, спорные участки, зоны, где уже были замечания.
Это не упрёк аудиторам, а описание ограничения профессии. И ровно здесь появляется место для нейросети на стороне финансиста. Задача не в том, чтобы работать быстрее человека. Задача в том, чтобы посмотреть на весь массив, а не на часть.
Ключевая мысль. Рынок предсказаний заметил аномалию не потому, что там работают гении. Он заметил её потому, что смотрел на полный массив данных, а не на выборку. Ровно то же самое может сделать финдиректор со своей выгрузкой из 1С.
Почему аудитор не видит отклонение первым: четыре слепые зоны
Здесь я разберу не теорию, а то, что наблюдаю в разборах со специалистами. Есть четыре причины, по которым странность в данных живёт внутри компании годами и всплывает только при смене команды или при запросе извне.
Первая: план проверки. Наличие плана означает, что участки вне плана не проверяются вовсе. Если участок не попал в оценку риска, он просто не существует для проверяющего. Человек снаружи, у которого плана нет, смотрит ровно туда, куда план не заглядывал.
Вторая: существенность. Порог существенности задан в деньгах. Всё, что ниже порога, проверяется по остаточному принципу. Именно поэтому мелкие схемы живут дольше крупных: они физически ниже линии, за которой начинается внимание.
Третья: привычка к объяснению. Когда отклонение повторяется третий год подряд, оно перестаёт восприниматься как отклонение. Люди, которые работают с участком давно, объясняют его «так исторически сложилось» и перестают замечать. Это самое частое, что я вижу: не сокрытие, а привыкание.
Четвёртая: физическое время. Ручная сверка выгрузки на 12 тысяч строк это несколько дней монотонной работы. Люди ошибаются на второй тысяче строк, и это нормальная физиология, а не непрофессионализм. Модель на это не жалуется.
| Слепая зона | Почему возникает | Что меняет нейросеть |
|---|---|---|
| План проверки | Участок не попал в оценку риска | Проверяется весь массив без плана и приоритетов |
| Существенность | Порог в деньгах отсекает мелочь | Ищутся паттерны, а не суммы: повторяемость важнее размера |
| Привыкание | Отклонение повторяется годами | Модель не знает истории и не считает странное нормальным |
| Время | Ручная сверка тысяч строк физически тяжела | Массив обрабатывается за один проход, без усталости |
Таблица 1. Четыре слепые зоны контроля и то, чем они закрываются. По моим разборам со специалистами школы, 2024-2026.
Что такое аналитическая процедура и при чём тут ChatGPT
Аналитическая процедура это проверка данных через сравнение, расчёт и поиск взаимосвязей, а не через просмотр первичных документов по одному. Классический пример: сравнить выручку по месяцам, увидеть рост на 40 процентов и пойти искать причину. Вы не открываете каждую накладную, вы ищете отклонение и только потом спускаетесь к документам.
До недавнего времени это работало так: аналитик выгружает данные, строит сводные, смотрит на графики, глазами ищет горбы и провалы. Дальше начиналось самое дорогое: надо было придумать, почему там горб, и проверить гипотезу.
Что изменилось. Модель забирает не саму проверку, а первый проход: чисто механическую часть, где надо просмотреть весь массив и выписать всё, что выбивается. Это ровно та работа, которую человек делать не любит и делает плохо. А вот объяснение, проверку по документу и решение о том, что с этим делать, по-прежнему делает человек.
Чего модель не делает. Она не знает вашего бизнеса. Она не отличает сезонный рост от схемы, потому что не знает, что у вас в августе начинается сезон. Она не понимает юридического веса документов. И она не несёт ответственности, а значит, любое её утверждение это гипотеза, пока вы не открыли первоисточник.
Как нейросеть получает данные: три способа, от простого к рабочему
Прежде чем перейти к маркерам, разберу техническую сторону, потому что именно на ней спотыкаются почти все, кто пробует это впервые. Есть три способа отдать модели выгрузку, и они очень разные по возможностям.
Способ первый: скопировать в чат. Вы копируете из Excel диапазон и вставляете в окно диалога. Работает только на маленьких срезах, примерно до 200-300 строк, дальше модель начинает терять строки и путать столбцы. Годится для быстрой проверки журнала за неделю или списка из тридцати платежей. Для квартальной выгрузки этот способ не подходит физически.
Способ второй: файлом. Вы прикладываете XLSX или CSV в диалог, и модель читает его целиком. Это основной рабочий вариант. Здесь важно помнить две вещи. Первая: файл должен быть плоской таблицей, без объединённых ячеек, промежуточных итогов и нескольких листов с разной структурой, потому что на такой файл модель реагирует как на ребус и начинает угадывать. Вторая: подписывайте колонки так, как их поймёт человек со стороны: «Дата документа», «Сумма без НДС», «Наименование контрагента». Колонка с названием «Сумма2» или «Поле_17» почти гарантированно получит неверную трактовку.
Способ третий: через анализ данных. В ChatGPT это режим с интерпретатором кода, в Claude аналогичная работа с файлами, в Gemini таблицы Google. Модель не читает таблицу как текст, а запускает по ней расчёты: группировки, сводные, поиск совпадений. Для задачи поиска аномалий это лучший вариант, потому что счётная часть выполняется кодом, а не «на глазок». Именно поэтому в промптах я всегда прошу результат в виде таблицы с номерами строк: так его можно проверить построчно.
| Способ | Объём данных | Где ломается | Когда использовать |
|---|---|---|---|
| Копирование в чат | до 200-300 строк | Теряет строки, путает столбцы | Журнал за неделю, список платежей |
| Файл в диалоге | до нескольких тысяч строк | Ошибается на объединённых ячейках и лишних листах | Квартальная выгрузка по одному участку |
| Анализ данных | десятки тысяч строк | Требует чистой плоской таблицы | Регулярный разбор, поиск совпадений и дублей |
Таблица 2. Три способа передать данные модели. Для поиска аномалий рабочий вариант это третий, но начинать можно и со второго.
Есть ещё четвёртый вариант, про который спрашивают реже: свой бот или автоматизация, которая делает выгрузку и прогон по расписанию. К этому стоит идти, когда разбор стал регулярным и вы уже понимаете, какие маркеры работают. Как это устроено на примере дебиторки, я разбирала отдельно.
Какие сигналы ищет ChatGPT: восемь маркеров аномалии
Это ядро статьи. Ниже восемь маркеров, которые я проверяю на каждой выгрузке. Они работают вне зависимости от отрасли и от того, используете вы 1С, SAP или таблицы в Google.
1. Круглые суммы. Платёж ровно 500 000 рублей встречается в нормальной хозяйственной жизни, но не каждый день и не у одного и того же контрагента. Серия круглых сумм это либо авансовая схема, либо основания, которые дописывали после факта.
2. Дубли. Один и тот же документ, проведённый дважды с разницей в несколько дней. Классика, которая ловится по совпадению суммы, контрагента и основания при разных номерах документов.
3. Отклонение от среднего. Сумма операции резко выбивается из обычного профиля контрагента. Тут важно смотреть не на абсолютное значение, а на отклонение от личной истории этого контрагента.
4. Время проведения. Операции, проведённые в выходные, ночью или в последний день месяца пачкой. Само по себе это не нарушение, но в сочетании с другими маркерами даёт сильный сигнал.
5. Концентрация. Доля одного контрагента в обороте участка растёт из месяца в месяц. Особенно если параллельно появляются новые контрагенты с похожими реквизитами.
6. Разрывы в нумерации. Пропущенные номера документов, документы с нетипичными префиксами, номера, которые не соответствуют хронологии дат.
7. Текстовые заглушки. В поле «основание» стоят формулировки вида «услуги», «по договору», «прочие расходы» без конкретики. Это не аномалия сама по себе, но нормальный профиль участка выглядит иначе, и отклонение видно.
8. Смена поведения. Контрагент, который работал годами ровно, вдруг меняет ритм: появляется в новом типе операций, резко наращивает объём, меняет схему платежей.
| Маркер | Что искать в данных | Частая нормальная причина |
|---|---|---|
| Круглые суммы | Совпадение сумм у одного контрагента | Авансовая система расчётов |
| Дубли | Совпадение суммы, контрагента и основания | Техническая ошибка выгрузки |
| Отклонение от среднего | Разрыв с личным профилем контрагента | Разовая крупная поставка |
| Время проведения | Ночь, выходные, последний день месяца | Аврал перед закрытием |
| Концентрация | Рост доли одного контрагента | Смена основного поставщика |
| Разрывы нумерации | Пропуски и несоответствие датам | Ручная нумерация в филиале |
| Текстовые заглушки | Общие формулировки в основании | Привычка заполнять быстро |
| Смена поведения | Резкое изменение ритма работы | Реорганизация, новый куратор |
Таблица 3. Восемь маркеров, которые я гоняю по выгрузке. Каждый маркер отдельно почти ничего не значит, силу даёт их пересечение.
Как выглядит разбор на данных: от выгрузки до списка вопросов
Теперь практическая часть. Ниже последовательность, которую я повторяю каждый раз, и промпты к ней. Всё, что в промптах, работает в ChatGPT на модели GPT-5.5, в Claude на Sonnet 4.6, в Gemini на версии 2.5 и в DeepSeek V3.2.
Шаг первый: подготовка файла. Выгружаете срез за период в CSV или XLSX. Минимальный набор колонок: дата, сумма, контрагент (маска), документ, основание, счёт учёта, тип операции. Убираете промежуточные итоги и группировки, они ломают разбор.
Шаг второй: обезличивание. Названия контрагентов, ИНН, ФИО, номера счетов и адреса заменяете масками. Соответствие храните отдельно. Подробный порядок я разбирала в статье про обезличивание данных для ChatGPT.
Шаг третий: первичный прогон по маркерам. Промпт 1.
Ты финансовый контролёр. Я загрузил выгрузку операций за период.
Колонки: дата, сумма, контрагент, номер документа, основание, счет учета, тип операции.

Задача: найти отклонения по восьми маркерам.
1. Повторяющиеся или близкие круглые суммы у одного контрагента.
2. Возможные дубли: совпадение суммы, контрагента и основания при разных номерах.
3. Суммы, которые резко выбиваются из профиля конкретного контрагента.
4. Операции в выходные, ночью и пачками в последний день месяца.
5. Рост доли одного контрагента в обороте по месяцам.
6. Разрывы и несоответствия в нумерации документов.
7. Общие формулировки в основании без конкретики.
8. Резкая смена ритма работы контрагента.

Формат ответа строго таблица:
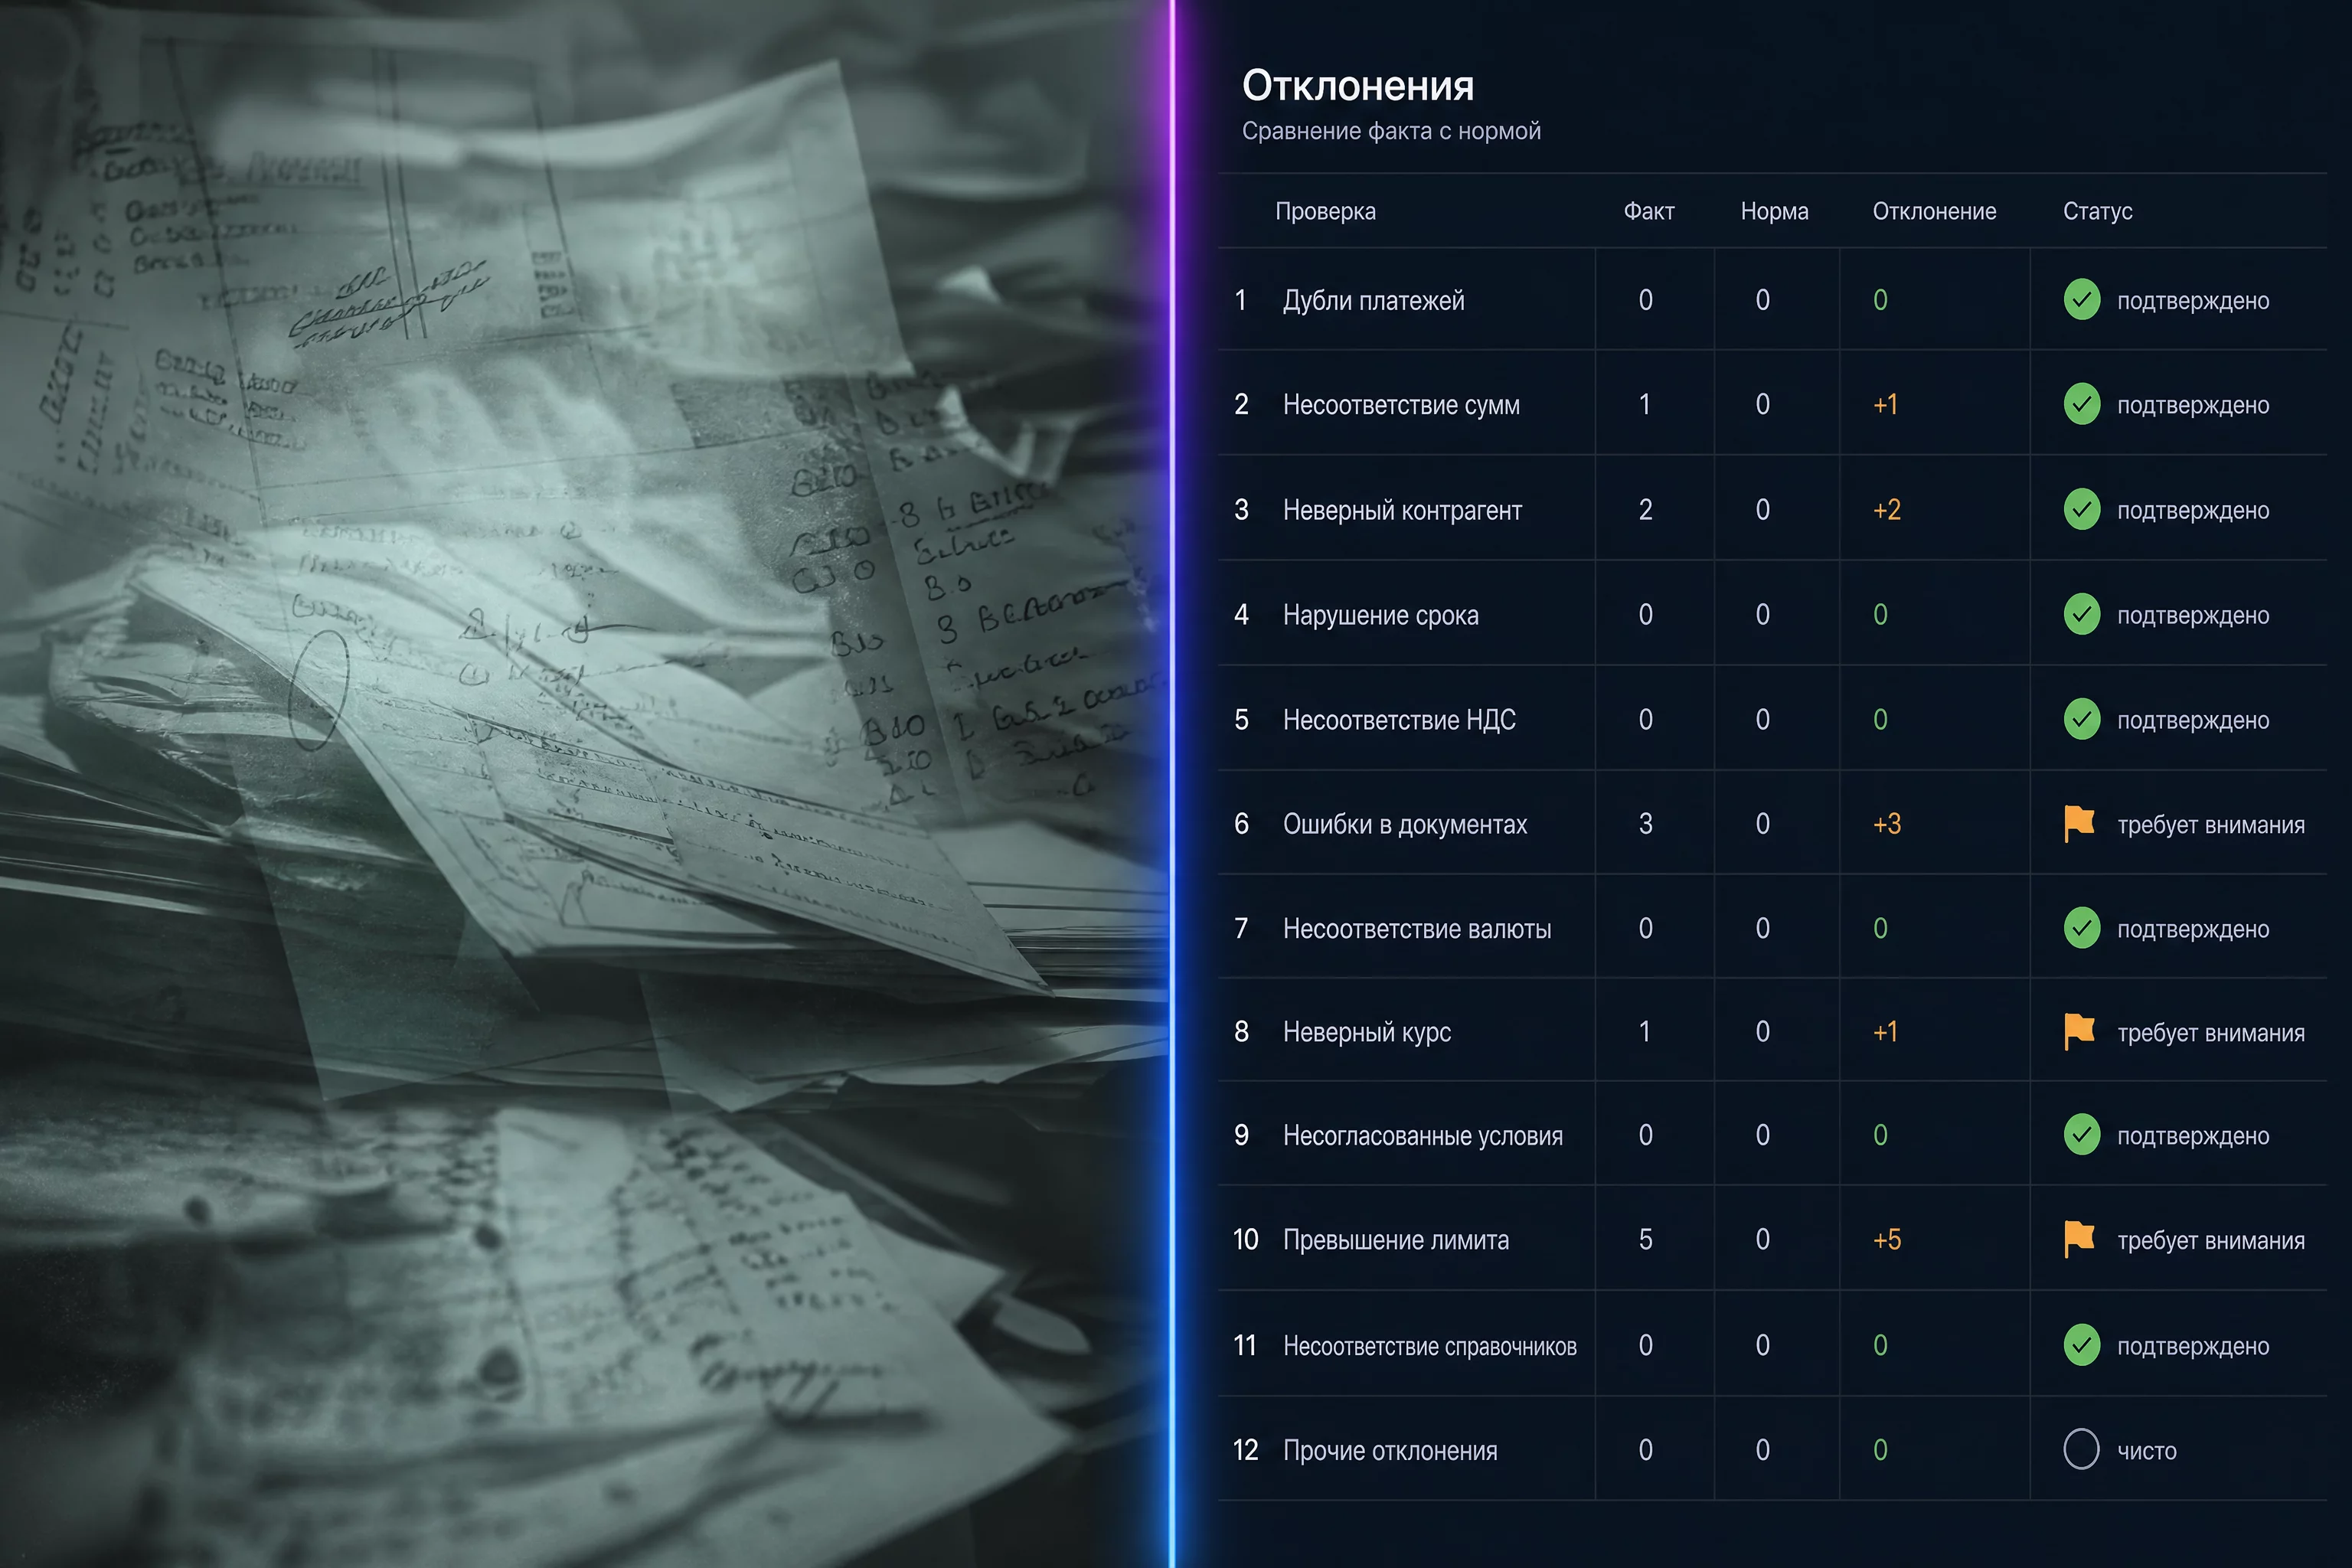
маркер | строки (номера) | контрагент | сумма | дата | почему это отклонение

Правила: не выдумывай данные, которых нет в файле. Если по маркеру
ничего не нашел, напиши "чисто". Не предлагай выводов о виновности.
Шаг четвертый: проверка по первоисточнику. Каждую строку из таблицы открываете в учётной системе и смотрите сам документ. Это не обсуждается.
Шаг пятый: объяснения. По каждому отклонению пишете, что это было и где подтверждение. С этого момента список становится рабочим документом, а не набором подозрений.
Мои кейсы: четыре разбора с часами и рублями
Ниже четыре истории из разборов со специалистами школы. Названия компаний не привожу, диапазоны оставляю там, где разброс между компаниями разного размера действительно большой, и называю одну цифру там, где могу. У каждого кейса есть точка А: что мешало работать до разбора, и чем это мерилось.
Кейс первый: дистрибуция, 14 тысяч строк и три двойные поставки
Точка А. Компания с оборотом в несколько сотен миллионов рублей, закрытие месяца вручную. Три поставщика давали около 60 процентов объёма, сверка шла по крупным суммам, потому что до остального физически не доходили руки. Финансист тратил на сверку поставок 12 часов за закрытие, в пиковые месяцы до 14.
Что сделали. Выгрузили реестр поставок за квартал, около 14 тысяч строк, обезличили, прогнали через промпт с маркерами дублей и круглых сумм. Первый проход занял меньше часа.
Стало. Модель вернула 46 строк-кандидатов. После проверки по документам подтвердились три двойные поставки на общую сумму 1,1 миллиона рублей, самый дорогой месяц квартала дал подтверждённый минимум 700 тысяч. Часть кандидатов оказалась нормальными предоплатами, у которых совпало основание. Время на сверку сократилось до полутора часов, то есть примерно на 85 процентов, а главное, проверка перестала зависеть от того, попала ли поставка в выборку по сумме.
Что тут важнее всего. Двойные поставки нашлись не потому, что модель умная, а потому что она посмотрела все 14 тысяч строк. При ручной сверке до них просто не доходили руки.
Кейс второй: подотчёт и 210 авансовых отчётов
Точка А. Компания с разъездным характером работы, 210 авансовых отчётов за квартал, шесть подотчётных лиц, из них двое закрывали больше половины отчётов. Проверка шла выборочно, и проблема была не в суммах, а в основаниях: часть отчётов закрывалась документами, которые дублировались по сути.
Что сделали. Прогнали выгрузку по маркерам круглых сумм, текстовых заглушек и концентрации. Отдельным промптом попросили сгруппировать отчёты по подотчётному лицу и найти повторяющиеся сочетания суммы и назначения.
Стало. Из 210 отчётов 11 оказались с признаками повторного возмещения одних и тех же расходов на общую сумму 480 тысяч рублей. Три случая подтвердились как ошибка, остальные закрылись уточнением. Разбор занял два часа против примерно двух дней ручной работы, то есть тот же объём был проверен за четверть времени. По итогам в регламент добавили правило: один и тот же тип расхода не может быть возмещён дважды в пределах месяца без письменного обоснования.
Кейс третий: выручка по точкам и ошибка выгрузки
Точка А. Розничная сеть из семи точек. Собственник заметил, что одна точка показывает рост выручки, которого нет по товарообороту: расхождение держалось три месяца. Внутренняя проверка ничего не находила, потому что данные сходились в учётной системе, и на уровне сводных отчёт выглядел ровным.
Что сделали. Взяли дневную выручку по всем точкам за полгода и попросили модель найти дни, где профиль одной точки расходится с профилем остальных. Промпт номер три.
Стало. Нашлись четыре дня, когда выручка конкретной точки совпадала с выручкой соседней точки до копейки. Это оказалась не кража, а техническая ошибка интеграции: при сбое связи данные одной кассы записывались дважды под разными точками, и рост был не ростом, а приписанным оборотом. Ошибка искажала управленческую отчётность и привела бы к неверному решению по аренде. Разбор занял 40 минут. Если считать по деньгам, речь шла о риске решения по аренде площадки стоимостью несколько миллионов рублей в год.
Кейс четвёртый: сигнал пришёл снаружи, а не изнутри
Этот кейс я ставлю последним, потому что он ближе всего к истории, с которой началась статья.
Точка А. Производственная компания, около 900 миллионов рублей выручки, свой отдел закупок и три человека в финансовой службе. Внутренние проверки поставок шли по плану и замечаний не давали. Сигнал пришёл со стороны: поставщик при сверке расчётов прислал акт, из которого следовало, что компания оплатила партию, которой в его отгрузках нет.
Что сделали. Подняли реестр оплат за год, около 11 тысяч строк, обезличили и прогнали по маркерам дублей, круглых сумм и смены поведения. Дополнительно попросили модель сравнить ритм платежей каждого поставщика по месяцам и найти тех, у кого в одном месяце резко выросло число операций при сохранении средней суммы.
Стало. Нашлись два эпизода: партия, оплаченная дважды с разницей в одиннадцать дней под разными номерами счетов, на 1,9 миллиона рублей, и предоплата на 450 тысяч по договору, который был расторгнут за месяц до платежа. Подтверждённая сумма по этой части 1,9 миллиона, вторая операция осталась спорной и ушла в отдельный разбор с юристом. Разбор занял два дня вместе с перепиской с поставщиком. Отдельная цена вопроса: сам факт того, что расхождение нашёл поставщик, а не компания, стоил финансовому директору нескольких неприятных разговоров с собственником, хотя к самим операциям он отношения не имел.
Что тут важнее всего. Внутренняя проверка шла по плану и смотрела крупные суммы. Обе операции были ниже порога существенности и обе выглядели нормально по отдельности: одна как обычная предоплата, вторая как техническая повторная оплата. Их объединяло только одно: и та и другая выбивались из ритма конкретного поставщика, а не из общего профиля участка. Такой признак не виден в сводных и не проверяется по порогу.
Сравнение моделей на задаче поиска аномалий
Задача поиска отклонений предъявляет к модели два требования, которые редко совпадают: она должна держать много строк и не путать даты. Второе важнее первого, потому что ошибка в дате не выглядит как ошибка, она выглядит как связный вывод.
| Модель | Сильная сторона на этой задаче | Где плывёт | Мой рабочий балл |
|---|---|---|---|
| GPT-5.5 | Хорошо строит таблицу отклонений и держит формат ответа | На очень длинных выгрузках теряет часть строк без предупреждения | 8/10 |
| Claude Sonnet 4.6 | Лучше всех держит даты и порядок событий на длинных цепочках | Хуже работает с тяжелыми сканами без текстового слоя | 10/10 на строках и датах, 7/10 на сканах |
| Gemini 2.5 | Уверенно читает сканы документов и таблицы с картинки | Слабее в свободной аналитике, нужен жёсткий формат промпта | 8/10 |
| DeepSeek V3.2 | Доступен без дополнительных средств доступа, крепко считает по таблице | На больших объёмах начинает сдвигать даты соседних строк | 7/10 |
Таблица 4. Сравнение по задаче «найти отклонения в выгрузке», актуально на 13 сентября 2026 года. Баллы это моя рабочая оценка по разборам, не результат лабораторного теста.
Сразу про 10 из 10 у Claude, чтобы не выглядело пристрастно. Это оценка не «лучшая модель вообще», а «лучшая на этой конкретной задаче»: здесь идёт работа со строками, датами и порядком событий. На тяжелых сканах без текстового слоя Claude уступает, поэтому в паре мест таблицы у него стоит 10/10 на строках и 7/10 на сканах, а общий балл в графе это сумма впечатлений по разборам. Если ваш участок держится на фотографиях первички, а не на выгрузке, для вас верхняя строка этой таблицы будет другой.
Как этим пользоваться на практике. Длинные реестры и всё, где критичен порядок событий, я гоняю в Claude Sonnet 4.6 и режу на порции по 60-80 строк. Сканы первички и таблицы с фотографий идут в Gemini 2.5. Черновую разметку и быстрые срезы я делаю в GPT-5.5. DeepSeek V3.2 использую там, где нет доступа к остальным сервисам, и всегда перепроверяю даты глазами. Общий разбор моделей под задачи финансиста есть в статье какую нейросеть выбрать финансисту.
Ручной разбор, ChatGPT или готовый сервис: что выбрать на старте
Этот вопрос мне задают на каждом разборе, и ответ зависит не от бюджета, а от того, понимаете ли вы, что именно ищете. Разберу три варианта по честному.
Ручной разбор в Excel. Сводные таблицы, условное форматирование, поиск дублей через формулы. Работает и не стоит ничего. Предел наступает по объёму: на 10-15 тысячах строк вы физически не удерживаете внимание, а формулы под каждый новый маркер надо писать заново. Для месяца работы небольшой компании этого достаточно, для квартала по крупному участку уже нет.
ChatGPT с вашими промптами. Даёт полный проход по массиву и, что важнее, гибкость: сегодня вы ищете дубли, завтра добавили маркер на аномалии по времени. Стоимость это подписка и ваше время на подготовку промптов. Слабые места два: нужна дисциплина по обезличиванию и нужна проверка каждой находки по первоисточнику.
Готовый сервис контроля. Автоматизирует типовые сценарии, умеет работать по расписанию, часто имеет готовые отчёты. Стоит денег и внедрения, требует настройки под вашу учётную систему. Главный минус на старте другой: вы получаете результат, но не понимаете логику, по которой он получен, и не можете её поменять под свою специфику.
| Критерий | Ручной разбор в Excel | ChatGPT с промптами | Готовый сервис |
|---|---|---|---|
| Стоимость входа | Ноль, кроме времени | Подписка и время на промпты | Внедрение и подписка |
| Предел по объёму | 2-3 тысячи строк на внимание | 10-15 тысяч строк за проход | Ограничен только системой |
| Гибкость маркеров | Низкая, формулы под каждый случай | Высокая, маркер меняется за минуту | Средняя, в рамках настроек |
| Прозрачность логики | Полная | Полная | Часто закрыта |
| Что нужно от вас | Время | Обезличивание и проверка | Дисциплина процесса |
Таблица 5. Три пути к контролю аномалий. Начинать я советую со второго: он даёт понимание, а понимание потом превращается в требования к системе.
Логика выбора простая. Сначала промпты, потому что они показывают, какие маркеры работают именно в вашей специфике. Через два-три месяца регулярных разборов у вас появится список того, что нужно проверять всегда, и вот тогда имеет смысл смотреть в сторону автоматизации. Если начать с сервиса, вы купите готовый набор проверок и не будете знать, чего в нём не хватает.
Двенадцать промптов, которые я использую на разборах
Дальше промпты. Каждый самодостаточен, подставляйте свои колонки и период. Первый промпт с восемью маркерами я уже привела выше, дальше идут остальные одиннадцать. Разбиты они по задачам: проверка дублей, сравнение профилей, концентрация, время, учётная политика, подотчёт, связанность контрагентов, второе мнение, карточка для аудитора, сводка для собственника и два новых, про пересечение контрагента с сотрудниками и про аномалии в суммах НДС.
Промпт 2. Проверка на дубли.
Проверь реестр операций на возможные дубли.
Признак дубля: совпадение суммы и контрагента при разных номерах документов,
разница по дате не более 10 дней, совпадающее или близкое основание.

Верни таблицу: сумма | контрагент | документ 1 | дата 1 | документ 2 | дата 2 | уверенность (высокая/средняя/низкая)
Уверенность "высокая" ставь только там, где совпали все три признака.
Отдельным списком выведи строки, где совпала только сумма, это не дубли.
Промпт 3. Сравнение профилей точек или подразделений.
В файле дневная выручка по точкам за период: колонки дата, точка, выручка.
Задача: найти дни, где профиль одной точки выбивается из общего поведения.

Метод: для каждой даты посчитай отклонение выручки точки от ее собственного
среднего за период и сравни с отклонениями остальных точек в тот же день.
Отдельно отметь дни, где значение одной точки совпадает со значением другой
до копейки или отличается менее чем на 0,5 процента.

Формат: таблица дата | точка | выручка | отклонение | точки-совпадения | версия причины
Не делай выводов о причинах, только перечисли версии для проверки.
Промпт 4. Поиск концентрации у одного контрагента.
Посчитай по месяцам: долю каждого контрагента в общем обороте участка,
количество операций и среднюю сумму. Найди контрагентов, у которых доля
росла три месяца подряд или выросла более чем в два раза за период.

Дополнительно проверь: есть ли среди новых контрагентов совпадения
по первым символам в наименовании, одинаковые банки, одинаковые адреса.
Результат таблицей с колонкой "на что обратить внимание".
Промпт 5. Аномалии по времени проведения.
В выгрузке есть дата и время создания документа. Определи:
1. Операции в выходные и нерабочие часы (после 20:00 и до 8:00).
2. Дни с аномально высокой плотностью операций относительно среднего.
3. Цепочки операций, созданные одним автором подряд в течение короткого времени.

Для каждой группы укажи количество операций, общую сумму и автора.
Учти, что часть операций в выходные может быть нормой для вахтового
графика, поэтому выведи их отдельным блоком "требует уточнения режима".
Промпт 6. Согласованность с учётной политикой.
Ниже выдержка из учетной политики компании и реестр операций.
Найди операции, которые противоречат политике: не тот счет учета,
не тот порядок признания, отсутствие обязательного согласования
по сумме выше лимита.
Формат: пункт политики | операция | в чем расхождение | что запросить у автора
Цитируй пункт политики дословно, чтобы я могла проверить.
Промпт 7. Разбор подотчётных отчётов.
Загружен реестр авансовых отчетов: подотчетное лицо, дата, сумма, назначение, тип расхода.
Задача: сгруппируй по подотчетному лицу и найди повторяющиеся сочетания
«тип расхода плюс примерная сумма» в пределах одного месяца.
Отметь отчеты с общими формулировками назначения без конкретики.
Отдельно: отчеты, закрытые позже установленного срока.
Формат таблицей, отсортируй по сумме убывания.
Промпт 8. Проверка контрагентов на признаки связанности.
По списку контрагентов из выгрузки определи признаки возможной связанности:
совпадение адресов и телефонов, регистрация в близкие даты, совпадение
банковских реквизитов, пересечение наименований, синхронное появление
и исчезновение из оборота.
Учти, что указанные данные могут быть неполными, поэтому каждый признак
помечай уровнем: косвенный или прямой.
Промпт 9. Второе мнение по готовому списку.
Ниже список отклонений, которые я уже нашла в данных.
Выступи в роли скептика: по каждому пункту предложи самое простое
нормальное объяснение, которое не связано с нарушением.
Если объяснение выглядит правдоподобным, помечай пункт как «снять».
Оставь в списке только то, для чего простого объяснения не нашлось.
Этот промпт я считаю обязательным. Он экономит больше времени, чем все остальные, вместе взятые, потому что снимает с вас необходимость объяснять очевидное.
Промпт 10. Карточка объяснения для аудитора.
По каждому отклонению из финального списка составь карточку:
что обнаружено | какие документы подтверждают | версия причины |
проверено кем и когда | что изменено в процессе, чтобы не повторилось.
Пиши коротко, без оценок и без признания вины.
Формат: готовый текст для вставки в таблицу.
Промпт 11. Итоговая сводка для собственника.
Собери результаты разбора в одну страницу для собственника:
сколько операций проверено, сколько отклонений найдено,
сколько подтвердилось, сколько снято, на какую сумму,
что изменено в регламенте.
Тон нейтральный, без обвинений в адрес сотрудников.
Одна страница, максимум 300 слов.
Промпт 12. Пересечение контрагента с сотрудниками.
В выгрузке две таблицы: реестр операций и список сотрудников компании.
Найди пересечения, которые могут указывать на связанность интересов:
совпадение фамилии контрагента или его руководителя с фамилией сотрудника,
совпадение адреса регистрации контрагента с адресом сотрудника,
операции по контрагенту, где автор документа и получатель выгоды
относятся к одному подразделению.

Верни таблицу: контрагент | сотрудник | тип совпадения | насколько прямое
(фамилия = прямое, адрес = косвенное, подразделение = косвенное) |
какие документы посмотреть для проверки.

Не делай выводов о конфликте интересов, только перечисли совпадения
и укажи, что проверить руками.
Отдельно скажу про НДС, потому что этот участок проверяется автоматически и поэтому прощает меньше всего. Три вещи я прошу модель пересчитать самостоятельно, не доверяя колонкам файла: расхождение между суммой без НДС, ставкой и суммой НДС больше рубля по строке, применение расчётной ставки там, где по виду операции должна быть прямая, и счета-фактуры, полученные в последние дни квартала, по которым вычет заявлен позже, чем позволяет учётная политика. Расхождение в копейки выглядит мелочью ровно до первого запроса пояснений.
Подборка промптов под другие участки, в том числе под сверку двух файлов и проверку формул, лежит в статьях про сверку двух Excel-файлов и про аудит формул.
Где нейросеть ошибается и как это ловится
Отдельный раздел, потому что без него статья превращается в рекламу, а мне интереснее, чтобы вас не подставило. Разберу четыре типовые ошибки, которые я вижу на разборах чаще всего.
Ошибка первая: сдвиг дат. На длинных цепочках модель начинает путать даты соседних строк и склеивать разные эпизоды в один. Это худший вид ошибки, потому что внешне всё выглядит связно. Лечится только одним: длинные реестры гоняются частями по 60-80 строк, а даты в итоговом списке сверяются глазами по первоисточнику.
Ошибка вторая: достройка реальности. Модель может приписать строке контрагента, которого в файле не было, если колонка названа непонятно. Отсюда правило: заголовки колонок должны быть однозначными, а в промпте должно стоять прямое запрещение брать данные вне файла.
Ошибка третья: уверенный тон на пустом месте. Модель отвечает одинаково ровно и когда нашла 40 совпадений, и когда нашла одно. Не путайте длину ответа с качеством находок. Проверяйте не текст, а таблицу.
Ошибка четвёртая: ложное чувство полноты. Если модель не нашла аномалий, это не значит, что их нет. Это значит, что маркеры не попали в ваш случай. Меняйте набор маркеров и способ нарезки данных. Подробнее о механике таких ошибок я писала в статье про галлюцинации нейросетей в финансовых данных.
Отдельно про персональные данные. Обезличивание обязательно до загрузки. Если в файле остались ФИО, паспортные данные, номера счетов или адреса сотрудников, вы не просто рискуете утечкой, вы формируете документ, который нельзя показать третьим лицам, а значит, теряете весь смысл работы.
Что делать, если аномалия нашлась у вас самого
Отдельный разговор, который в статьях обычно пропускают, а он самый неприятный. Рано или поздно разбор покажет отклонение в операциях, которые проводили именно вы или ваш отдел. Что делать в этом случае.
Первое: не удаляйте и не правьте. Соблазн поправить документ задним числом огромен, и он же самый опасный. Правка задним числом превращает ошибку в сокрытие, а это уже другая категория последствий. Ошибка с объяснением стоит несопоставимо дешевле.
Второе: посчитайте сумму и оцените существенность. Часто речь идёт о единицах тысяч рублей, которые закрываются сторнированием и уточнённой отчётностью. Пока вы держите это в голове как катастрофу, вы не можете принимать решения.
Третье: сообщите первым. Тот, кто приносит проблему с готовым планом исправления, воспринимается совершенно иначе, чем тот, чью проблему находят снаружи. В моих разборах это правило срабатывало без исключений.
Четвёртое: закройте причину, а не только следствие. Если ошибка возникла из-за того, что у вас в регламенте не было шага проверки, добавьте шаг. Если из-за настройки в учётной системе, поменяйте настройку. Исправленная проводка без исправленного процесса означает, что через квартал всё повторится.
Пять мифов об аномалиях в данных, которые мешают начать
За годы разборов я собрала устойчивый набор заблуждений. Каждое из них звучит разумно и каждое останавливает людей на старте.
Миф первый: «аномалия это всегда мошенничество». Нет. По моим разборам устойчиво примерно одно подтверждённое нарушение на пять найденных отклонений. Остальные четыре это сезонность, разовые сделки, ошибки выгрузки и просто нестандартные, но законные решения. Если вы идёте искать только нарушения, вы их найдёте там, где их нет, и испортите отношения в команде.
Миф второй: «для этого нужны чистые и полные данные». Ждать идеальных данных можно бесконечно, потому что их не будет никогда. Работает другой подход: взять то, что есть, прогнать, посмотреть, где данные врут, и уточнить источник. Первый разбор почти всегда показывает больше проблем в данных, чем в операциях, и это нормальный результат, а не провал.
Миф третий: «модель сама разберётся». Модель не знает вашего бизнеса и не отличает нормальное от странного, пока вы ей это не описали. Промпт без описания нормального профиля участка даёт список из сотни строк, в котором утонет и само полезное. Описание профиля это половина работы, и её нельзя делегировать.
Миф четвёртый: «достаточно один раз настроить и дальше работает само». Работает ровно до момента, когда участники привыкают к контролю. Дальше отклонения переезжают в места, которые вы не проверяете, а старые маркеры начинают выдавать пустые списки. Обновлять набор маркеров надо регулярно, я делаю это раз в квартал.
Миф пятый: «это работа для аналитика, а не для финансиста». В российский практике финансовый отдел в небольшой и средней компании это два-четыре человека, и отдельного аналитика там нет. Финансист, который умеет гонять выгрузку через модель, закрывает эту задачу сам. Именно поэтому я считаю этот навык базовым, а не продвинутым.
Как устроен контроль на стороне аудитора и чем он отличается от вашего
Короткий раздел, потому что про слепые зоны я уже написала выше. Здесь только два понятия из чужой логики, которых там не было, и они нужны вам ровно в тот момент, когда вы несёте аудитору свою таблицу отклонений.
Существенность. Это порог, выше которого искажение считается значимым для пользователей отчётности. Порог считается в деньгах, чаще всего как процент от выручки или от прибыли. Практический вывод для разговора: спор с аудитором почти никогда не идёт о том, заметил он операцию или нет. Он идёт о том, попадает ли операция выше порога. Поэтому в своей таблице отклонений полезно сразу писать сумму и то, относительно какого порога вы её смотрите, иначе разговор быстро съедет в «это же мелочь».
Риск и выборка. Часы распределяются по зонам, где вероятность искажения выше. Если участок в оценку риска не попал, он не проверяется вообще, и это не небрежность, а следствие того, что часы конечны. Отсюда ваш главный аргумент в разговоре: у вас нет плана, по которому надо идти, поэтому своим разбором вы закрываете ровно те участки, которые в чужой план не попали. Аналитические процедуры, то есть сравнение показателей и поиск необычных взаимосвязей, аудитор как раз и применяет, но по сводным данным и по ограниченному набору срезов. Вы делаете то же самое, только по строкам.
Теперь про то, как это выглядит в разговоре. Когда вы приходите к аудитору с таблицей, где по каждому отклонению уже написано, что это было и где лежит подтверждение, вы переводите разговор из плоскости «покажите документы» в плоскость «вот документы, остались три открытых вопроса». Практика показывает, что это заметно сокращает объём запросов. Обратная сторона тоже есть: если вы приносите список подозрений без объяснений, вы создаёте аудитору новую работу и продлеваете проверку.
Что делать, если вы работаете в небольшой компании и аудитора нет
Меня часто спрашивают: а есть ли смысл во всём этом, если у нас микробизнес, три бухгалтера и отчётность сдаёт один человек. Отвечу конкретно.
Смысл есть, но другой. В крупной компании контроль нужен, чтобы ловить нарушения. В небольшой он нужен, чтобы у собственника не возникало вопросов к вам. Это разные задачи, и решаются они одним и тем же инструментом.
Начните с одного участка и одного правила. Самый частый кейс в моих разборах это подотчёт и платежи подрядчикам, потому что там деньги уходят наружу и там же чаще всего возникают вопросы у собственника задним числом. Один прогон раз в месяц по этим двум участкам закрывает основную часть риска.
Держите таблицу отклонений в общем доступе. Не в личной папке. Если собственник в любой момент может открыть файл и увидеть, что вы проверяете и что нашли, вопрос «чем ты вообще занимаешься» перестаёт возникать. Это же снимает подозрение, что вы скрываете найденное.
Пишите объяснения коротко. Три колонки: отклонение, объяснение, подтверждение. Не нужно оформлять отчёт на десять страниц, его никто не прочитает. Нужна таблица, которую можно открыть и за минуту понять.
Не превращайте контроль в отчётность ради отчётности. Если вы раз в месяц присылаете собственнику красивую сводку, которую он не читает, контроль превратился в ритуал. Работающий признак один: по итогам разбора в компании появилось хотя бы одно новое правило или один закрытый вопрос.
Как это выглядит в разных участках: подотчёт, закупки, выручка, зарплата
Универсальный набор маркеров работает везде, но акценты в каждом участке свои. Ниже подсказки из практики: на что смотреть в первую очередь, если вы начинаете с конкретного блока.
Все цифры про объём программы курса и число выпускников, которые встречаются в статье, я привожу по данным школы на момент публикации. Цифры аудитории каналов и числа по кейсам это мои рабочие оценки по разборам со специалистами, а не лабораторный замер.
Закупки и расчёты с поставщиками. Первые кандидаты это дубли и круглые суммы, дальше концентрация. Здесь важна связка с договорами: модель не знает условий, поэтому после разбора надо открыть договор и проверить, попадает ли операция в его рамки. Часто выясняется, что операция законна, но превышает лимит, который в договоре прописан, и это уже вопрос к процессу согласования, а не к людям.
Подотчёт. Главные маркеры это повторяющиеся сочетания расхода и суммы, общие формулировки в назначении и отчёты, закрытые позже срока. Тонкость: если в компании много разъездов, часть отклонений будет нормой, поэтому первым делом надо описать нормальный профиль, иначе список получится на сотню строк и утонет сам в себе.
Выручка. Здесь ищут совпадения между точками или между днями, провалы и горбы относительно собственной истории, и расхождения между выручкой и товарооборотом. Именно в этом участке чаще всего находят не злоупотребления, а ошибки интеграции и учёта, как в третьем кейсе выше.
Зарплата и премии. Маркеры это выплаты, не предусмотренные положением о премировании, расхождения между расчётом и приказом, повторные выплаты одному сотруднику в разных документах. Это самый чувствительный участок с точки зрения отношений в команде, поэтому здесь особенно важно правило про нейтральные формулировки.
| Участок | Первые маркеры | Типичная находка |
|---|---|---|
| Закупки | Дубли, круглые суммы, концентрация | Превышение лимита по договору без согласования |
| Подотчёт | Повтор расхода, заглушки в назначении, сроки | Возмещение одного расхода дважды |
| Выручка | Совпадения между точками, провалы, разрыв с товарооборотом | Ошибка интеграции, а не хищение |
| Зарплата и премии | Выплаты вне положения, расхождение с приказом | Ошибка расчёта или неоформленная договорённость |
Таблица 7. На что смотреть в первую очередь в четырёх самых частых участках.
Этическая граница: где анализ превращается в обвинение
Поиск отклонений устроен так, что его легко превратить в поиск виноватых, и я видела, чем это заканчивается для команды. Четыре правила ниже я проговариваю с каждой группой, которая начинает такой разбор.
Правило первое: отклонение не равно вина. Формулировки в отчёте должны быть нейтральными. Не «Иванов завысил расходы», а «по операции номер такой-то обнаружено отклонение, требуется объяснение».
Правило второе: сначала проверяем процесс, потом человека. В большинстве случаев, которые я разбирала, причина была в дыре в процессе: не было лимита, не было двойного согласования, не настроили контроль в учётной системе. Люди действовали в рамках, которые им оставили.
Правило третье: не превращайте разбор в слежку. Как только сотрудники понимают, что контроль ищет виноватого, данные начинают жить отдельно от реальности: появляются красивые основания, договоры оформляются задним числом, переписка уходит в личные мессенджеры. Вы теряете не контроль, вы теряете картину.
Правило четвёртое: объяснение обязательно, даже если оно скучное. Больше половины найденных отклонений закрываются нормальной причиной, и это нормальный результат. Ценность разбора не в числе наказанных, а в том, что у каждого необычного движения денег появляется письменное объяснение.
Чек-лист: десять шагов, чтобы внедрить контроль аномалий
Эта же последовательность вынесена в HowTo-разметку статьи, чтобы её находили в поиске. Здесь она без пояснений: десять пунктов, по которым можно идти и отмечать пройденное. Если нужны причины, по которым каждый пункт вообще появился, они разобраны выше.
- Выберите один участок. Закупки, подотчёт, платежи подрядчикам или выручка. Не весь учёт сразу.
- Опишите нормальный профиль. Типичная сумма, день недели, число документов, круг контрагентов.
- Выгрузите срез за период с минимальным набором колонок в CSV или XLSX.
- Обезличьте файл до загрузки: контрагенты, ИНН, ФИО, счета, адреса.
- Прогоните промпт с маркерами, требуйте таблицу, а не рассуждение.
- Проверьте каждую строку по первоисточнику в учётной системе.
- Зафиксируйте объяснение по каждому пункту: что было, кто подтвердил, где лежит.
- Отделите системное от разового и закройте системное изменением процесса.
- Поставьте разбор в регламент до подписания отчётности, а не после вопроса.
- Меняйте маркеры раз в квартал, потому что привыкание работает с обеих сторон.
Смежная тема, которую стоит держать рядом, это проверка контрагентов и сверка регистров через Code Interpreter.
Практикум по этим восьми маркерам и шаблон таблицы отклонений я отдаю на бесплатном эфире. Забрать запись эфира с разбором живой выгрузки.
Чему скандал учит финансиста: четыре вывода
Теперь вернусь к истории, с которой всё началось, и соберу выводы. Они не про биржу и не про криптовалюту.
Первый вывод: аномалия видна в пересечении признаков, а не в отдельной сделке. В истории с рынком предсказаний сигналом была не сумма ставки, а совпадение по 18 компаниям, связанным одним аудитором. У вас в выгрузке сигнал выглядит так же: не подозрительная сумма, а сочетание контрагента, дня, основания и ритма операций. Поэтому бесполезно искать «странные» операции по величине. Ищите пересечения.
Второй вывод: скорость заметить отклонение становится конкурентным преимуществом. Тот, кто видит проблему на первом проходе, обсуждает с собственником числа. Тот, кто видит её через год, обсуждает свою роль в случившемся. Разница между этими двумя позициями не в карьере, а в том, сколько часов в месяц вы проводите в разговорах, которые не про работу. В четвёртом кейсе выше вопрос звучал не «сколько мы потеряли», а «почему не видели вы», и вот эта цена измеряется не в рублях: даже при небольшой сумме финансовый директор несколько недель занимался не финансами, а объяснениями. Тот, кто нашёл отклонение первым, тратит эти недели на то, ради чего его вообще наняли.
Третий вывод: цена отклонения зависит от того, кто его нашёл. Разница между «мы сами нашли и исправили» и «нам показали со стороны» измеряется не в рублях, а в доверии. В четвёртом кейсе выше сумма была небольшой, а разговор с собственником тяжёлым, потому что вопрос звучал не «сколько мы потеряли», а «почему вы не видели». Тот, кто приносит отклонение первым, обсуждает процесс. Тот, кому его приносят, обсуждает свою работу.
Четвёртый вывод: объяснение важнее находки. В конечном счёте ценится не список отклонений, а таблица, где у каждого отклонения есть версия причины, подтверждение и решение. Именно этот документ показывает, что в компании работает внутренний контроль, а не интуиция одного человека. Как связать такой документ с защитой от необоснованных претензий, я разбирала в статье про аудит-трейл, а тему привыкания к странным процессам в разборе фразы «мы всегда так делали».
Отдельно скажу про рынки предсказаний как явление. Они полезны как источник сигнала: там видно, что происходит с ожиданиями, когда появляется доступ к непубличной информации. Но встраивать их в финансовую модель компании я бы не советовала по простой причине: вы не знаете, чем закончится регуляторная история, а управленческое решение требует опоры, которая переживёт несколько лет. Интереснее другое: та же механика поиска пересечений работает с вашим собственным платёжным календарём и реестром договоров без всяких ставок.
Что делать со всем этим в первую неделю: план по дням
Чек-лист выше отвечает на вопрос «что делать». Этот раздел отвечает на другой: «когда». Я разложила первый цикл по дням, потому что «найдите время» это не план, а пожелание, и потому что на каждом дне есть ровно одно место, где разборы срываются. Тайминги мои, из разборов с финансистами разного размера компаний.
День первый, 40 минут. Где срывается: профиль участка пишут формально. Пять строк текста про нормальное поведение участка нужны не модели, а вам: без них вы не отличите отклонение от сезонности. Формально написанный профиль («платежи поставщикам, ежемесячно») не отсекает ничего, и на четвёртый день вы получите сотню строк кандидатов вместо двадцати.
День второй, 30 минут. Где срывается: файл приводят в порядок наполовину. Промежуточные итоги, объединённые ячейки и несколько листов разной структуры остаются, потому что жалко ломать привычную форму. Модель читает такую таблицу как ребус и начинает угадывать смысл полей. Это самый дорогой по последствиям день: ошибка здесь не видна до самого конца.
День третий, 20 минут. Где срывается: маски хранят в чате. Таблица соответствия масок и реальных названий должна лежать отдельным файлом в рабочей папке. Если она осталась в переписке с моделью, вы обезличили выгрузку и тут же вернули ей настоящие данные.
День четвёртый, час. Где срывается: хочется сразу проверить находки. Прогоняете промпт 1 и промпт 2, получаете таблицу и смотрите только на объём: больше сотни строк означает, что профиль из первого дня слишком широкий. Идти по этим строкам в учётную систему рано.
День пятый, полтора часа. Где срывается: статус ставят «на глаз». Открываете учётную систему и идёте по строкам. Три статуса, и третий нужен обязательно: «требует дополнительных документов» это не отложенное решение, а отдельный список, с которым вы идёте к исполнителю. День без этого статуса превращается в спор о том, что считать доказанным.
День шестой, 30 минут. Где срывается: сводку пишут в обвинительном тоне. Карточки по промпту 10 остаются у вас, сводка по промпту 11 идёт собственнику. Разница между ними в том, что в сводке нет фамилий и оценок, только операции, статусы и суммы.
День седьмой, 20 минут. Где срывается: фиксируют дату, но не правило. В регламент уходит одно новое правило по итогам недели. Именно правило, а не найденные отклонения, и есть результат этих семи дней.
Итого около четырёх с половиной часов на первый цикл. Второй цикл по тому же участку занимает вдвое меньше, потому что профиль уже описан, а выгрузка собирается по знакомому шаблону. Если времени нет на семь дней, берите дни со второго по пятый: это минимальный рабочий набор, остальное можно дописать позже.
Где следить за AI для финансиста
Практические разборы и промпты я публикую в @findir_pro: разборы моделей, кейсы выпускников, готовые шаблоны под бухгалтерские и финансовые задачи. Живые эфиры и тесты моделей на реальных документах идут в канале «АИ с Софьей и Натали».
Если вы хотите выстроить систему поиска аномалий под свои участки и разобрать восемь маркеров на своей выгрузке, приходите на курс «AI-навыки финансиста». fin-academy.pro/ai
Рассказ про 19 кошельков и почти безошибочные 42 сделки забудется через месяц, а привычка смотреть на полный массив данных, а не на тридцать операций из выборки, останется с вами. Начните с одной выгрузки и одного промпта, и через пару месяцев вы будете приходить к аудитору не с вопросом, а со своей таблицей отклонений. Это принципиально другая позиция в разговоре.
От себя добавлю то, что вижу на каждом разборе: модели здесь не для того, чтобы заменить вашу голову, а для того, чтобы забрать у вас первый проход. Проверку, объяснение и решение не заберёт никто, и именно они остаются вашей работой. Программу курса собрала основатель школы Софья Бурцева, ссылка на него есть выше в блоке с курсом.
Натали Васильева. Эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO». С нейросетями в работе финансиста с февраля 2023 года. Через курс «AI-навыки финансиста» прошли 800+ финансистов, главбухов и финдиров. Веду Telegram-канал @findir_pro (45 000 подписчиков), канал «АИ с Софьей и Натали» (13 000 подписчиков) и MAX-канал «Финансовый директор» (5 000+ участников).
Три канала школы, где выходят разборы
@findir_pro (45 000 финансистов): промпты, разборы кейсов, инструменты для CFO и главбуха каждый день.
«АИ с Софьей и Натали» (13 000 подписчиков): обзоры моделей и честные тесты применения AI в финансах.
MAX (5 000+ участников): закрытое сообщество выпускников онлайн-школы, живые разборы задач и нетворкинг с коллегами.
Полезные источники. Разбор кошельков на Polymarket сделала компания Bubblemaps, публикацию о нём выпустила The Wall Street Journal. Позицию самой фирмы по непубличной информации клиентов смотрите в официальных заявлениях KPMG. По регулированию рынков предсказаний и их сходству с инструментами ставок в США полезны материалы CFTC, по внутреннему контролю и аналитическим процедурам опирайтесь на первоисточники COSO. Официальные страницы сервисов, с которыми я работаю: chatgpt.com, anthropic.com, deepseek.com.
Вопросы и ответы
Часть вопросов вынесена в короткий FAQ в начале статьи. Здесь остались те, что задают на разборах чаще всего.
Сколько времени занимает разбор одной выгрузки?
От 40 минут до двух часов на выгрузку в 10-15 тысяч строк, если брать один участок и восемь маркеров. Из этого времени на модель уходит 10-20 минут, остальное на подготовку файла и проверку найденного по первоисточникам. Первый раз будет дольше, потому что вы ещё не знаете своих маркеров.
Что делать, если в компании нет нормальной выгрузки?
Начинайте с того, что есть. Часто достаточно экспорта операций из учётной системы в Excel, пусть даже кривого. Если и этого нет, соберите данные за один месяц вручную в таблице с пятью колонками. Модель работает с тем, что ей дали, а не с тем, что вы хотели бы иметь. Участки, где данных нет вообще, это отдельный сигнал: там контроль отсутствует физически.
Можно ли доверять результату, если модель иногда ошибается?
Доверять можно только тому, что вы проверили. Результат модели это не вывод, а список гипотез, отсортированный по вероятности. Правило простое: ни одна строка из отчёта не идёт дальше, пока вы не открыли первоисточник своими глазами. При таком порядке работы ошибки модели стоят вам времени на проверку, а не репутации.
Как часто нужно повторять разбор?
Закрытие месяца это минимум. Если участок подвижный, например платежи подрядчикам, имеет смысл делать недельный срез: пять минут на прогон и вы видите отклонение, пока его ещё можно объяснить словами, а не документами задним числом. Дальше раз в квартал обновляйте набор маркеров.
Что делать, если аномалия подтвердилась и касается коллеги?
Сначала зафиксировать факт нейтрально и собрать документы. Потом идти по процедуре, которая есть в компании, а не обсуждать это в переписках. И обязательно проверить, не было ли причиной дырявый процесс: отсутствие лимита, двойного согласования, настроек в учётной системе. Если процесс дырявый, следующий случай будет с другим человеком, и разбор без изменения процесса ничего не даст.
Не проще ли купить готовый сервис контроля вместо промптов?
Готовые сервисы закрывают типовые сценарии и стоят отдельных денег и внедрения. Промпты на первом этапе дают вам то, чего сервис не даст: понимание, какие маркеры вообще работают в вашей специфике. Начните с промптов, а когда поймёте, что именно ищете, вам будет что осмысленно требовать от системы. Как это устроено в связке с автоматизацией, разобрано в статье про AI-агента для дебиторки.