AI для финансиста
«Бухгалтерия — это открыть один файл, чтобы понять, почему не сходится другой»: ChatGPT находит причину расхождений в отчётности за 10 минут

Конец квартала. Управленческий отчёт не сходится с бухгалтерским на 4,7 миллиона рублей. Главбух говорит, что в 1С всё верно. Финансовый директор говорит, что в Excel всё верно. А где-то между ними лежат данные, которые разошлись. Классика жанра: чтобы понять, почему не сходится один файл, нужно открыть другой. Вручную на это уходит от двух часов до рабочего дня, и чаще всего причина находится случайно, когда уже никто не ждёт. ChatGPT через Code Interpreter делает то же самое за 10 минут. Вы загружаете два файла, модель сравнивает их по строкам, находит расхождения, группирует их по причинам и объясняет, что именно и где не сошлось.
Я Натали Васильева, эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO». С февраля 2023 года помогаю финансистам и бухгалтерам внедрять нейросети в работу, через курс «AI-навыки финансиста» прошли 800+ выпускников, наши каналы читают 45 000 подписчиков в Telegram. В этой статье разбираю, как ChatGPT находит причину расхождений в отчётности: пошаговый алгоритм, 10 готовых промптов, три кейса с часами и рублями, сравнительную таблицу инструментов, чек-лист и правила безопасности. Материал актуален на 29 августа 2026 года.
Почему в отчётности появляются расхождения? Пять типичных причин
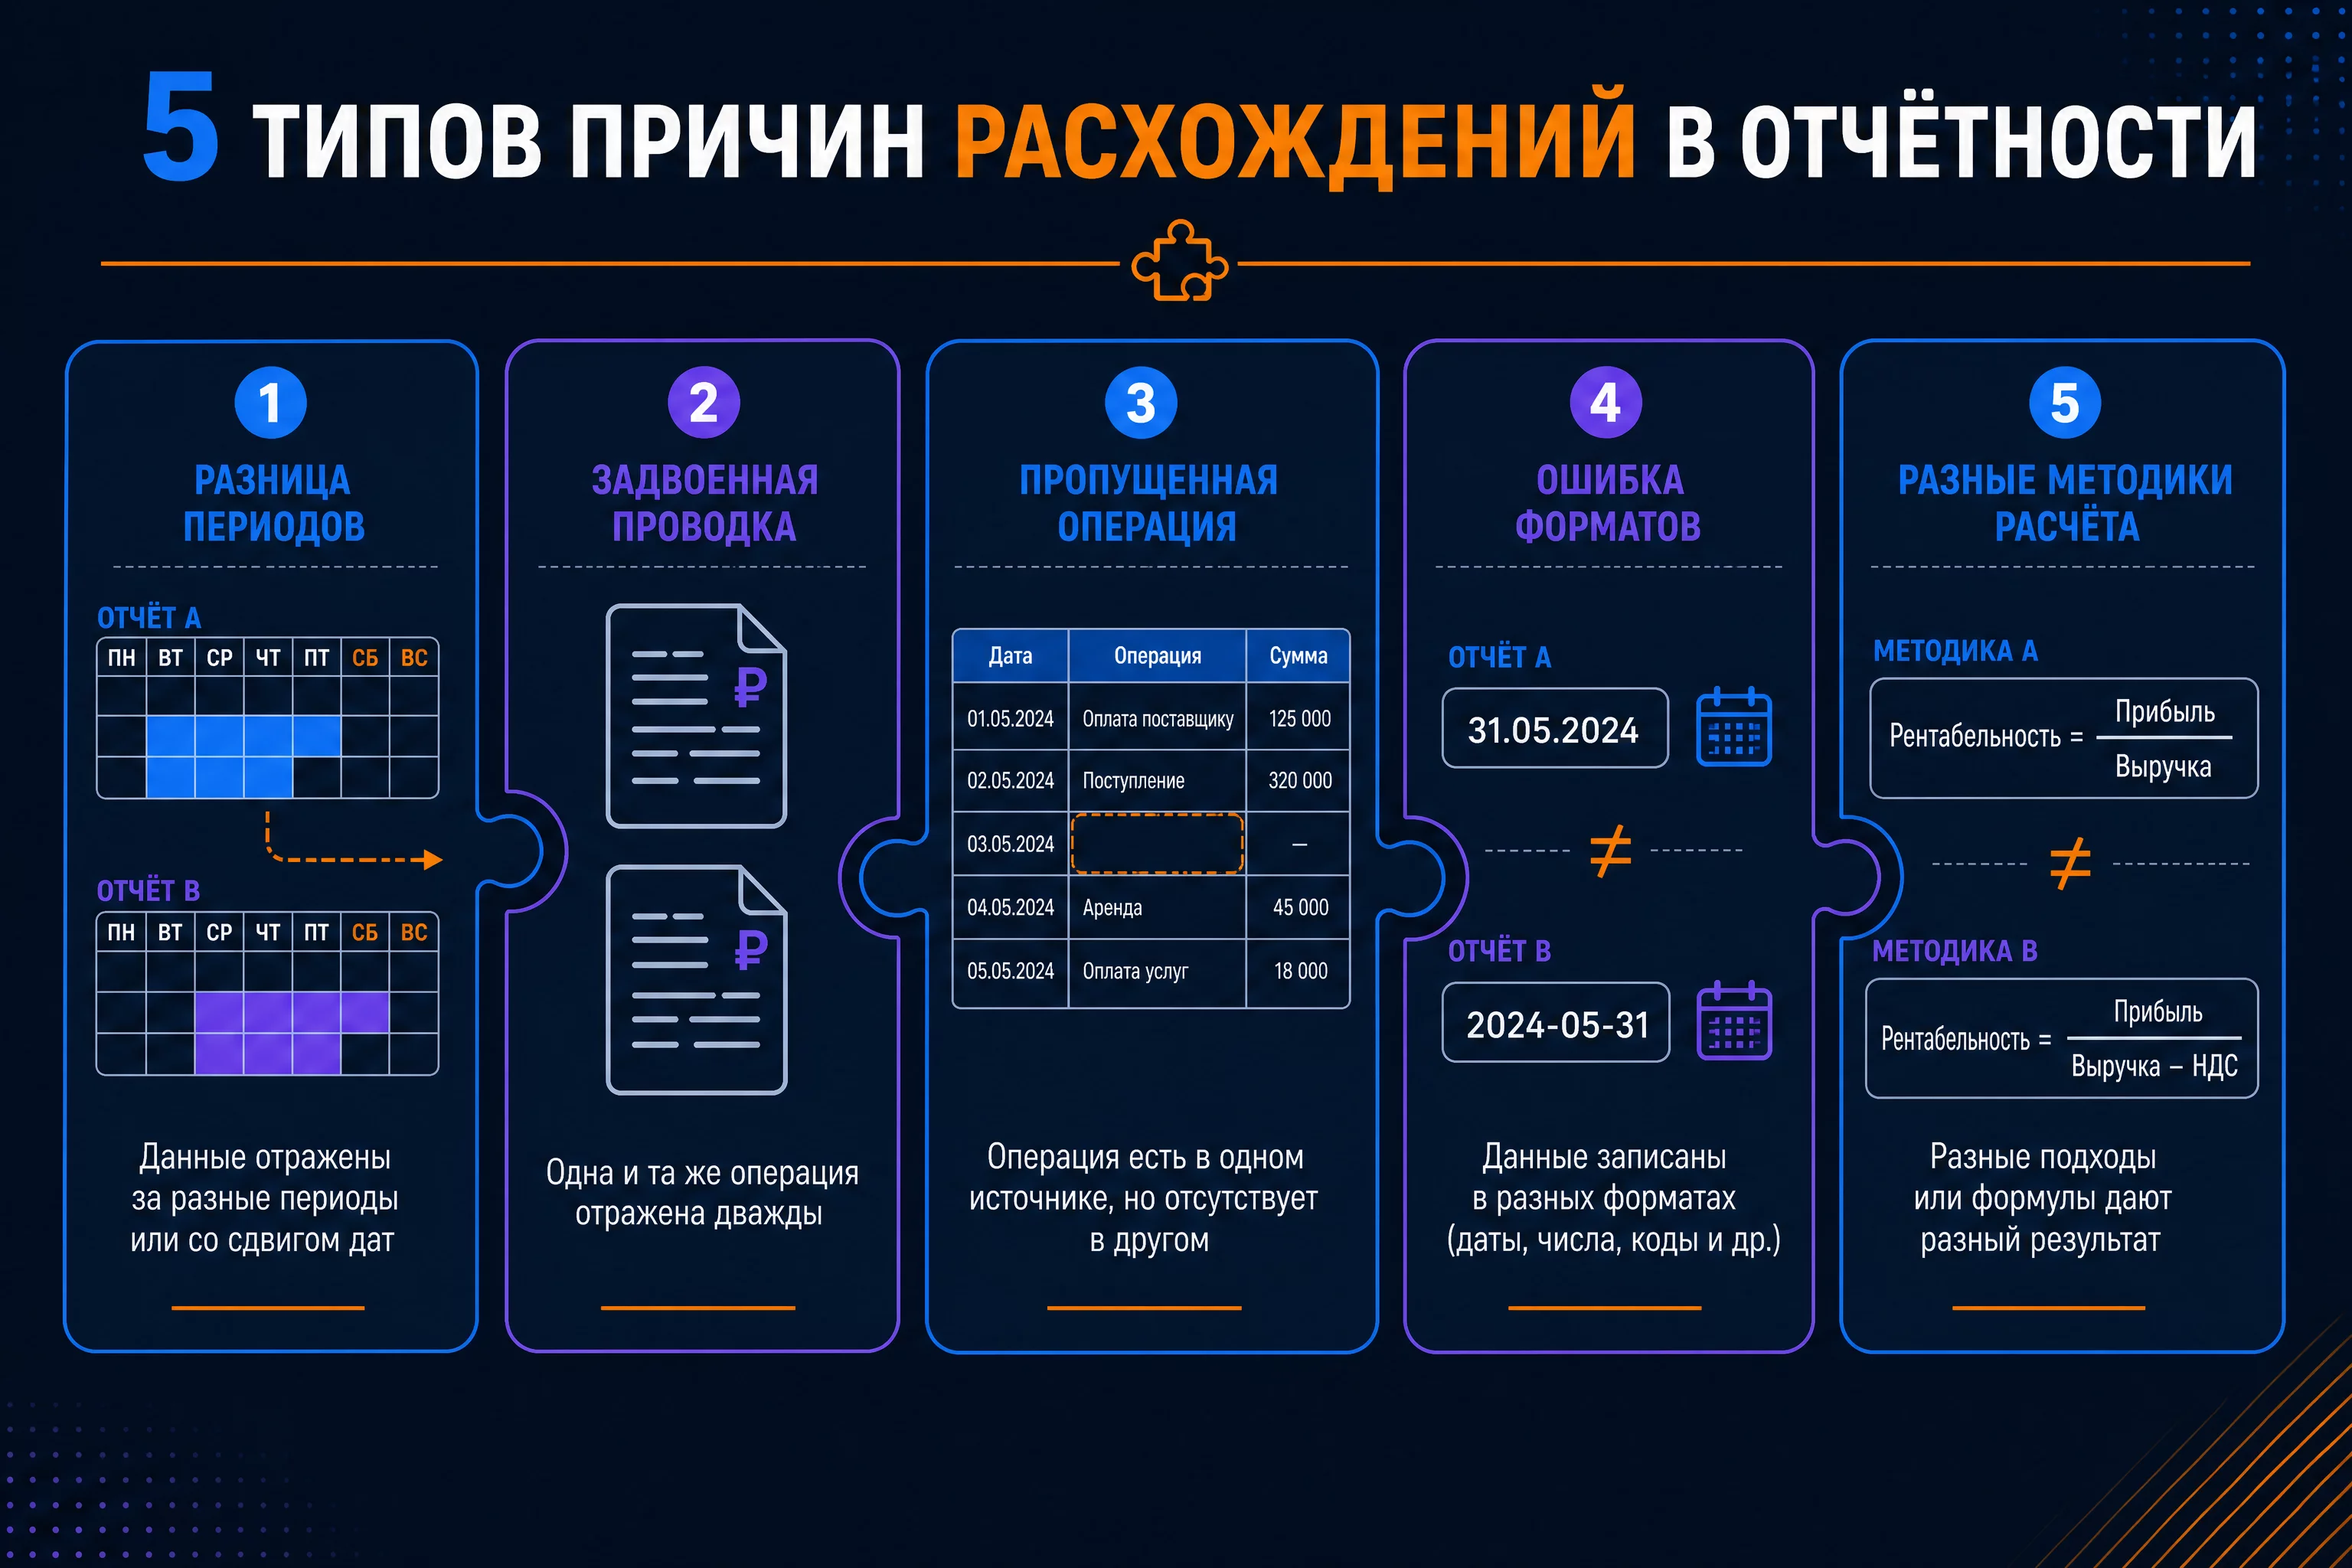
Пять причин закрывают почти все расхождения, которые я вижу в практике: разница периодов, задвоенные проводки, пропущенные операции, ошибки форматов и разные методики расчёта. Остальные случаи это их комбинации.
Причина первая: разница периодов. Операция прошла в одном учёте в конце месяца, а в другом попала в начало следующего. Банк провёл платёж 31-го числа, бухгалтер оформил документ 1-го числа следующего месяца. Оба учёта честные, оба верные, а при сверке строка не находит пару. Это самый частый источник расхождений при закрытии месяца, и он не требует исправлений, только переноса даты или признания разницы.
Причина вторая: задвоенная проводка. Один и тот же документ проведён дважды. Чаще всего из-за того, что платёж в банке разбился на две строки, а в 1С его отразили целиком, или наоборот. Отдельный случай: документ провели, потом отменили, а отмену забыли. При сверке сумма задвоения выглядит как лишняя операция.
Причина третья: пропущенная операция. Операция есть в одном учёте и полностью отсутствует в другом. Классика: банковская комиссия списана банком, а в бухгалтерии проводку не сделали. Или расход признан в управленческом учёте, а в бухгалтерский не передан. Пропуски находят только сверкой, глазами такие строки теряются.
Причина четвёртая: ошибки форматов. Дата в одном файле записана как 28.06.2026, в другом как 28/06/2026 или 28 июня 2026. Сумма с неразрывным пробелом вместо разделителя тысяч становится текстом, и Excel не считает её числом. Контрагент в одном учёте «ООО РОМАШКА», в другом «ООО “Ромашка”». Формально это не ошибка учёта, но именно из-за форматов ВПР не находит до 80% строк.
Причина пятая: разные методики расчёта. Один и тот же показатель считается по-разному. В управленческом учёте амортизация линейная, в бухгалтерском по сумме чисел лет. Курс валюты взят на дату операции в одном учёте и на конец месяца в другом. База для процентов разная. Методические расхождения не лечатся проводками, их нужно согласовывать на уровне учётной политики.
Практический вывод простой: перед тем как искать виноватого, полезно разложить расхождения по этим пяти группам. ChatGPT это умеет автоматически, если дать ему правильный промпт. Он классифицирует каждую строку и отдельно выводит то, что требует решения человека.
Что такое расхождение в отчётности и почему его ищут вручную?
Расхождение в отчётности это разница между двумя источниками данных, которые по смыслу должны совпадать. Остаток по счёту в 1С и остаток в управленческой таблице. Оборот по расчётному счёту в банке и в учёте. Сумма задолженности в акте сверки контрагента и в вашей системе. Пока оба источника описывают одно и то же, их итоги сходятся. Как только они разошлись, появляется задача найти, где именно и почему.
Поиск вручную медленный не потому, что задача сложная. Данные из разных систем никогда не приходят в одинаковом формате, и большую часть времени занимает подготовка к сравнению, а не само сравнение. Надо привести даты к одному виду, очистить суммы от пробелов, разобраться, почему ВПР не находит очевидные пары. На это уходит первый час. Потом ещё час на саму сверку и разбор пограничных строк. Платёж в 23:58, у банка это 30 июня, в 1С он попал в июль. Один перевод разбился на два транша в разные дни. Комиссия банка идёт отдельной строкой, а в 1С её нет. К концу второго часа концентрация падает, и именно тогда появляются «непонятные» расхождения, которые откладываются на следующую неделю и забываются.
Вот откуда берутся два-три часа на каждую сверку. Не потому что бухгалтер медленный, а потому что форматирование, сравнение и разбор причин свалены в один ручной процесс. ChatGPT разделяет эти этапы: нормализацию и сравнение берёт на себя Python, а разбор причин делает модель. Человеку остаётся принять решение по пограничным случаям.
Какие файлы сравнивать и как ChatGPT читает отчётность?
ChatGPT через Code Interpreter умеет читать Excel, CSV и PDF, нормализовать данные и сравнивать таблицы по заданному ключу. Это инструмент, а не замена учётной системе: он работает с выгруженными файлами, а не подключается к 1С.
Excel и CSV работают лучше всего. Суммы в них числовые, колонки имеют названия, структура понятная. CSV предпочтительнее: в нём нет объединённых ячеек и скрытых строк, а суммы всегда числа. Excel требует проверки: иногда суммы записаны текстом из-за неразрывных пробелов, иногда шапка отчёта занимает несколько строк сверху. Обе проблемы решаются одной строкой в промпте.
PDF подходит для крайнего случая. GPT-5.5 читает PDF с таблицами, но качество зависит от структуры документа. Для стандартных отчётов работает, для сканов и нестандартной разметки каждую строку нужно проверять. Если есть выбор, выгружайте в Excel.
Что именно умеет Code Interpreter в задаче поиска расхождений:
- Читать файл и показывать структуру: колонки, типы данных, первые строки
- Нормализовать данные: убрать пробелы из сумм, привести даты к одному формату
- Сравнивать два файла по ключу: счёт, документ, сумма, контрагент
- Разложить результат на три группы: совпадения, только в первом, только во втором
- Находить дубли внутри одного файла
- Объяснять вероятные причины расхождений по-русски
- Сохранять итоговую таблицу как Excel для скачивания
Одну деталь стоит добавить про память. В июне 2026 года OpenAI прокачала память ChatGPT: модель сама собирает факты из истории диалогов, сводку можно посмотреть и отредактировать на странице управления памятью. Для финансиста это удобно. Один раз описали свою компанию, структуру счетов и правила учётной политики, и в новых чатах модель уже знает контекст. Только следите за тем, что попадает в память: правила и методики туда писать можно, персональные данные нельзя.
Чего Code Interpreter не умеет: выходить в интернет во время выполнения кода, подключаться к 1С напрямую, вносить изменения в учёт. Он работает только с тем, что вы загрузили.
Как подготовить данные 1С для поиска расхождений?
Качество сверки наполовину зависит от того, как выгружены данные из 1С. Разбираю три варианта.
Оборотно-сальдовая ведомость по счетам. Самый частый выбор для сверки управленческой и бухгалтерской отчётности. Путь в 1С:Бухгалтерия: Отчёты, Стандартные отчёты, Оборотно-сальдовая ведомость. Выбираете организацию и период, показываете счета, которые нужны для сравнения. ОСВ выдаёт обороты по дебету и кредиту и остатки на начало и конец периода по каждому счёту. Для сверки с управленческим учётом этого достаточно, потому что расхождение обычно видно уже по сальдо: счёт, по которому остатки разошлись, и есть зона поиска.
Карточка счёта. Подходит, когда расхождение уже локализовано по конкретному счёту и нужна детализация по документам. Карточка счёта 51 покажет все движения по расчётному счёту, карточка 60 или 62 движения по расчётам с поставщиками и покупателями. Для сверки с банком или контрагентом карточка лучше ОСВ, потому что в ней видны номера документов и суммы каждой операции.
Специальная выгрузка из управленческой системы. Управленческие системы вроде Excel-моделей, ФинТабло или внутренних контуров часто позволяют выгрузить данные в том же разрезе, что и 1С: счёт, дата, документ, сумма. Если такой выгрузки нет, сводите через ОСВ: счёт плюс оборот, потом уже расшифровка по карточке.
Три вещи всегда проверяю в файле перед загрузкой:
- Суммы в числовом формате. В Excel числовые суммы выравниваются по правому краю, текстовые по левому. Если суммы текстовые, Code Interpreter увидит их как строки, и сравнение по сумме не сработает.
- Даты в едином формате во всём файле. Смешанные форматы, где-то 28.06.2026, где-то «30 июня 2026», главная причина ложных расхождений.
- Нет скрытых строк и итогов. Скрытые строки Python не видит, а строка «Итого» читается как операция без пары.
Если данные готовы, остальная сверка за моделью. Но без правильной выгрузки даже самая умная нейросеть будет сравнивать мусор с мусором.
Как читать результат сверки? Три группы расхождений
ChatGPT раскладывает сравнение на три группы: совпадения, только в первом файле, только во втором. Это и есть карта расхождений, и читать её нужно в определённом порядке.
Группа 1. Совпадения. Строки, которые нашли пару в обоих файлах по ключу. Их не трогаем, но смотрим на сумму: она должна быть близка к итогу файлов. Если сумма совпадений сильно меньше итога, значит, большая часть данных разошлась, и разбор будет долгим.
Группа 2. Только в первом файле. Операции, которые есть в первом учёте и отсутствуют во втором. Для управленческого Excel против 1С это часто расходы, которые признали в управленке, но не передали в бухгалтерию. Для банка против 1С это операции, которые банк провёл, а бухгалтер ещё не отразил. Здесь живут пропущенные проводки и временные разницы.
Группа 3. Только во втором файле. Операции, которые есть во втором учёте и отсутствуют в первом. Для 1С против управленки это обычно документы, которые провели в бухгалтерии, но не внесли в управленческую модель: амортизация, резервы, переоценка, налоговые корректировки. Здесь тоже живут методические разницы.
Дальше для каждой строки из групп 2 и 3 просите модель указать вероятную причину. Порядок разбора рекомендую такой: сначала строки с максимальной суммой, потому что они меняют итог, потом строки с подозрительными датами (конец и начало периода), потом всё остальное. Строки, которые модель отнесла к «нужна проверка документа», собираете в отдельный список для бухгалтера.
Один нюанс: не удаляйте строки из групп 2 и 3 после первого разбора. Сверка это итеративный процесс. Исправили пропуск, перезапустили сравнение, часть строк перешла в совпадения. Так расхождение тает на глазах, и в конце остаются только методические разницы, которые решаются на уровне учётной политики.
Как сверять с банком, контрагентами и внутри компании? Три сценария
Поиск причин расхождений это общий механизм, но у каждого сценария свои ключи сравнения и свои типичные причины. Разбираю три самых частых.
Сценарий 1. Сверка с банком. Сравниваете банковскую выписку с карточкой счёта 51 из 1С. Ключ сравнения: контрагент плюс сумма, допуск на округление. Типичные причины: платёж прошёл по банку в конце месяца, в 1С попал в следующий; банковская комиссия не отражена в учёте; платёж разбился на два транша. Подробный алгоритм с промптами я собрала в отдельной статье про банковскую сверку.
Сценарий 2. Сверка с контрагентом. Сравниваете данные по счётам 60 и 62 из 1С с актом сверки, который прислал контрагент. Ключ сравнения: номер документа плюс сумма. Типичные причины: разные номера документов в двух системах, частичная оплата, возвраты, которые одна сторона учла, а другая нет. Итоговая таблица расхождений по документам это готовый ответ на претензию контрагента, с ним уже не поспоришь на словах.
Сценарий 3. Сверка управленческой и бухгалтерской отчётности. Сравниваете управленческий Excel или учётную систему с ОСВ из 1С. Ключ сравнения: счёт плюс оборот. Типичные причины: методические разницы, курс валют, амортизация, резервы. Этот сценарий самый сложный, потому что зачастую расхождения это разные правила ведения учёта, и их нужно согласовывать в учётной политике, а не исправлять проводками.
| Сценарий | Что сравниваем | Ключ сравнения | Типичные причины |
|---|---|---|---|
| Сверка с банком | Выписка vs счёт 51 | Контрагент + сумма | Временные разницы, комиссии |
| Сверка с контрагентом | Счета 60/62 vs акт контрагента | Документ + сумма | Разные номера, частичная оплата |
| Управленка vs бухгалтерия | Excel/модель vs ОСВ | Счёт + оборот | Методики, курс, амортизация |
Для всех трёх сценариев работает один и тот же набор промптов, меняются только описания файлов и ключ. Поэтому первый настроенный сценарий становится шаблоном для остальных: скопировали промпт, поменяли колонки, и через полчаса второй сценарий готов.
Как ChatGPT находит причину расхождения за 10 минут? Пошаговый алгоритм
Разбираю конкретный сценарий: управленческий отчёт в Excel и оборотно-сальдовая ведомость из 1С за один и тот же период. Цель: найти, где и почему данные разошлись.
Минуты 0-3. Подготовка файлов. Выгружаете первый файл из управленческой системы, второй из 1С (ОСВ по счетам или карточка счёта). Обезличиваете по справочнику замен: ИНН на К01, К02, названия контрагентов на Контрагент 1, 2, 3. Суммы и даты не трогаете. Сохраняете оба файла как Excel или CSV.
Минуты 3-5. Загрузка и проверка. Новый чат на chatgpt.com, тариф Plus. Загружаете оба файла через кнопку прикрепления. Модель показывает первые строки каждого. Проверяете: если в колонке суммы написано object вместо числа, значит суммы текстовые, нужна очистка. Об этом говорит тип данных в ответе модели.
Минуты 5-8. Запуск сравнения. Пишете структурированный промпт (промпт 2 из следующего раздела) с описанием файлов и ключа сравнения. ChatGPT пишет Python-код, выполняет его и выдаёт три таблицы: совпадения, только в первом файле, только во втором. В каждой строке: счёт, документ, сумма, даты из обоих источников.
Минуты 8-10. Разбор причин. Просите модель объяснить каждую строку из разделов «только в первом» и «только во втором»: временная разница, задвоение, пропуск, разный формат, методика. Затем просите вывести контрольную арифметику: сумма совпадений плюс сумма строк только в первом файле должна равняться итогу первого файла. Если не сходится, где-то потерялись строки, и модель их найдёт.
Минута 10. Сохранение. Просите сохранить итог как Excel и вывести Python-код отдельным блоком. Код сохраняете в библиотеку. В следующем месяце меняете две переменные с именами файлов, и весь процесс занимает 7-8 минут.
На первый запуск уходит 20-30 минут, потому что вы описываете структуру своих файлов и подбираете промпт. Со второго месяца это чистые 10 минут: структура уже описана, код уже написан, вы только меняете файлы и период.
Какие промпты использовать для диагностики расхождений? Десять готовых
Все промпты работают в ChatGPT Plus с GPT-5.5. Перед каждым загружайте файлы через кнопку прикрепления. Текст в [КВАДРАТНЫХ СКОБКАХ] заменяйте на свои данные.
Промпт 1. Диагностика файла перед сверкой
Я загрузила файл "[ФАЙЛ].xlsx" с данными отчётности.

Проверь и покажи:
1. Сколько строк данных, сколько колонок, какие названия колонок
2. Тип данных в каждой колонке: числа, текст, даты
3. В каком формате записаны даты и суммы
4. Есть ли строки-заголовки, итоговые строки или пустые строки
   в середине данных
5. Есть ли колонка, которая выглядит как ключ записи
   (номер документа, счёт)

Покажи первые 5 строк таблицы.
Если найдёшь проблемы с форматами, предложи код исправления.
Промпт 2. Основное сравнение двух файлов отчётности
Я загрузила два файла:

1. "[ФАЙЛ_1].xlsx": управленческий отчёт за [ПЕРИОД].
   Колонки: Счёт, Дата, Документ, Контрагент, Сумма.

2. "[ФАЙЛ_2].xlsx": бухгалтерский отчёт за тот же период.
   Колонки: Счёт, Дата, Документ, Контрагент, Сумма.

Сравни два файла по ключу: Счёт + Номер документа + Сумма.
Перед сравнением:
- приведи даты к единому формату ГГГГ-ММ-ДД
- очисти суммы от пробелов и знаков валюты, переведи в числа
- удали пустые строки и строки с итогами

Результат в трёх разделах:
1. Совпадения: Счёт, Документ, Сумма, Дата_1, Дата_2
2. Только в первом файле: Счёт, Документ, Сумма, Дата_1
3. Только во втором файле: Счёт, Документ, Сумма, Дата_2

Покажи итоговую сумму по каждому разделу.
Сохрани результат как Excel для скачивания.
Промпт 3. Поиск временных разниц между двумя учётами
Файлы те же: "[ФАЙЛ_1].xlsx" и "[ФАЙЛ_2].xlsx" за [ПЕРИОД].

Найди временные расхождения:
1. Строки из раздела «только во втором файле» с датой в первых
   3 днях периода (1-3 число) и суммой, которая есть в первом
   файле с датой в последних 3 днях предыдущего периода
2. Сопоставь их по Счёт + Сумма, допуск ±1 рубль
3. Покажи таблицей: Счёт, Сумма, Дата_в_первом,
   Дата_во_втором, Разница_в_днях

Это частая причина, когда операция проведена по одному учёту
в конце месяца, а по другому в начале следующего.
Промпт 4. Поиск задвоенных проводок
Файл "[ФАЙЛ].xlsx": отчётность за [ПЕРИОД].

Найди подозрительные дубли внутри файла:
1. Точные дубли: одинаковые Документ + Сумма + Счёт
   в пределах одного дня
2. Возможные дубли: одинаковые Сумма + Счёт в пределах 3 дней
   с разными номерами документов
3. Частичные дубли: несколько строк одного счёта и контрагента
   за день, которые в сумме равны крупной сумме соседнего дня

Для каждого дубля покажи строки-кандидаты рядом.
Покажи общую сумму потенциально задвоенных операций.
Промпт 5. Разбор причин по каждой строке расхождения
Вот таблица расхождений из сравнения двух файлов:
[вставь разделы «только в первом» и «только во втором»]

Для каждой строки предложи наиболее вероятную причину:
- операция учтена в другом периоде, временная разница
- проводка проведена дважды, задвоение
- операция не отражена, пропуск
- один и тот же документ записан по-разному в двух системах
- разные методики расчёта: курс, округление, база

Расставь причины по строкам.
Отдельно выдели топ-5 расхождений по абсолютной сумме.
Если данных для причины не хватает, напиши «нужна проверка
документа».
Промпт 6. Контрольная арифметика итогов
Файлы "[ФАЙЛ_1].xlsx" и "[ФАЙЛ_2].xlsx" и результат их сравнения.

Проверь контрольную арифметику:
1. Итоговая сумма по первому файлу
2. Итоговая сумма по второму файлу
3. Сумма раздела «совпадения» + сумма раздела «только в первом»
4. Сумма раздела «совпадения» + сумма раздела «только во втором»

Правило: пункт 3 должен равняться пункту 1, пункт 4 пункту 2.
Если не сходится, найди строки, которые потерялись при сравнении,
и покажи их отдельно.
Промпт 7. Сводный отчёт для финансового директора
На основе результата сравнения составь отчёт для финансового
директора, максимум одна страница.

Структура:
1. Общая картина: сколько операций в каждом файле, итоговые суммы
2. Расхождения: количество и сумма по каждому разделу
3. Топ-5 расхождений по сумме с предполагаемой причиной
4. Что нужно проверить бухгалтеру: список конкретных документов
5. Оценка влияния на отчётность: критично или нет

Деловой стиль, конкретные цифры.
Промпт 8. Сверка управленческой и бухгалтерской отчётности
Я загрузила два файла:
1. "[УПРАВЛЕНЧЕСКИЙ].xlsx": управленческий отчёт за [ПЕРИОД]
2. "[БУХГАЛТЕРСКИЙ].xlsx": бухгалтерский отчёт из 1С
   за тот же период

Это разные системы с разной структурой. Сверь их по счёту и сумме:
1. Приведи структуры к общему виду: Счёт, Сумма, Дата
2. Найди счета, по которым суммы отличаются
3. Для каждого счёта покажи: сумма в управленческом,
   сумма в бухгалтерском, разница
4. Отсортируй по модулю разницы по убыванию
5. Предложи причины расхождений по каждому счёту

Покажи сводную таблицу по счетам с разницами.
Промпт 9. Сохранение кода для ежемесячного использования
Ты только что провёл сравнение двух файлов отчётности.

Сделай три вещи:
1. Сохрани итоговую таблицу расхождений как Excel
2. Выведи полный Python-код в отдельном блоке. В начало добавь
   переменные, которые меняются каждый месяц:
   FILE_1 = "uprav_june.xlsx"
   FILE_2 = "buh_june.xlsx"
   PERIOD = "июнь 2026"
3. Добавь русские комментарии к ключевым блокам: чтение файлов,
   нормализация, ключ сравнения, три раздела

Код должен работать без изменений при смене переменных выше.
Промпт 10. План исправлений по найденным причинам
На основе разобранных причин расхождений составь план исправлений:

1. Список проводок, которые нужно добавить, операция не отражена
2. Список проводок, которые нужно сторнировать, задвоение
3. Список документов для перепроверки: разные форматы,
   не хватает данных
4. Порядок действий: что исправлять первым, что вторым
5. Как проверить после исправлений: контрольные суммы по счетам

Формат: таблица с колонками Действие, Документ, Сумма,
Ответственный, Срок. Если данных о документе нет, ставь прочерк.
Эти десять промптов покрывают полный цикл: диагностика файлов, сравнение, поиск временных разниц, задвоения, разбор причин, контроль, отчёт, план исправлений. Собирайте их в свою библиотеку по мере работы, и через месяц у вас будет рабочий контур под регулярную сверку.
Забери бесплатный эфир «Экскурсия по ChatGPT для финансиста и бухгалтера»: получить доступ. Показываю на живом примере, как загрузить два файла отчётности и получить список расхождений с причинами за 10 минут.
Сколько стоит ручной поиск расхождений? Экономика в цифрах
Переведу время в деньги, потому что именно так руководитель считает пользу от автоматизации. Возьмём средние ставки 2026 года для финансовой функции: бухгалтер на участке 1 800-2 200 рублей в час, главный бухгалтер 3 000-4 000 рублей в час, финансовый директор 6 000-10 000 рублей в час.
Одна ручная сверка двух отчётов занимает 2-3 часа. При ставке главного бухгалтера 3 500 рублей в час это 7 000-10 500 рублей на одну сверку. В месяц при закрытии таких сверок две-три: банк, контрагенты, управленка против бухгалтерии. Итого 15 000-30 000 рублей в месяц уходит на поиск расхождений вручную, и это только стоимость времени, без учёта риска пропущенного расхождения.
Теперь посчитаем ту же работу через ChatGPT. Тариф Plus стоит от 20 долларов в месяц, и он закрывает не только сверки, а вообще все задачи с файлами. На саму сверку уходит 10-15 минут, это примерно 600-900 рублей времени бухгалтера. Разница между ручным поиском и нейросетью от десяти до пятидесяти раз по стоимости. Даже с учётом первого часа на настройку промптов окупаемость наступает в первую же неделю.
| Параметр | Ручной поиск | ChatGPT | Разница |
|---|---|---|---|
| Время на одну сверку | 2-3 часа | 10-15 минут | В 12-15 раз меньше |
| Стоимость при ставке 3 500 руб/час | 7 000-10 500 руб | 600-900 руб | В 10-12 раз дешевле |
| Время в месяц на 2-3 сверки | 6-9 часов | 30-45 минут | 8-9 часов экономии |
| Риск пропущенного расхождения | Высокий | Низкий при контроле | Контрольная арифметика |
| Перенастройка под новые файлы | Каждый раз заново | Один раз, потом шаблон | Код сохраняется |
Плюс скрытая экономия, которую не видно в таблице: расхождение, найденное через неделю, исправляется одной проводкой. Расхождение, найденное через квартал, это уже пересчёт трёх месяцев отчётности, объяснительная, а иногда и пересданная отчётность. Стоимость позднего обнаружения на порядок выше стоимости самого поиска, поэтому регулярная быстрая сверка работает как снижение риска, а не просто оптимизация времени.
Сколько экономит ChatGPT? Три кейса с цифрами
Цифры из практики школы и учеников. Имена обезличены, суммы и время привожу как в разборе.
Кейс 1. Главный бухгалтер торговой компании, Москва
Было: ежемесячная сверка управленческого Excel с 1С. Расхождение каждый месяц в диапазоне от 1,2 до 4,7 миллиона рублей. Поиск причины вручную занимал 3-4 часа: сначала ВПР, потом ручной разбор непонятных строк, потом звонки в отдел продаж с вопросом, что за операции они забыли передать. Раз в квартал одно расхождение оставалось неразобранным и всплывало в следующем месяце уже с процентами.
Что сделали: выгрузили оба файла за месяц, обезличили контрагентов, загрузили в ChatGPT и запустили промпт сравнения по ключу счёт плюс документ плюс сумма. Модель разложила расхождение на три группы: 14 строк временных разниц на 2,1 миллиона, 3 задвоенные проводки на 380 тысяч, 5 пропущенных операций на 940 тысяч. Остальное закрылось разницей в округлении курса на 46 тысяч.
Стало: первая сверка заняла 25 минут вместе с настройкой промпта. Со второго месяца 9-11 минут на месяц. Расхождения, которые раньше искали 3-4 часа, теперь разобраны в тот же день. Задвоения на 380 тысяч в месяц перестали попадать в отчётность, потому что сверка стала ежемесячной, а не квартальной.
Экономия: 2,5-3 часа каждый месяц. Три задвоения на 380 тысяч рублей найдены в первый же месяц вместо квартала.
Кейс 2. Аутсорсинговый бухгалтер, Санкт-Петербург
Было: на обслуживании 11 организаций. Для каждой в конце месяца сверка учёта с первичкой и управленческими таблицами клиента. По 40-60 минут на организацию, это почти два полных рабочих дня только на поиск расхождений. Каждый клиент со своим форматом, со своими особенностями, и под каждый формат приходилось переписывать формулу в Excel.
Что сделали: для каждой организации сделали единый справочник обезличивания и один шаблон промпта с описанием структуры файлов. Python-код первой сверки сохранили в библиотеке, дальше меняли только переменные с именами файлов и периодом.
Стало: каждая организация 10-15 минут, все 11 за 2-2,5 часа. Появился промежуточный контроль 20-го числа для трёх активных клиентов, раньше времени на него не было. При ставке 2 800 рублей за час освободилось около 13 часов в месяц, это примерно 36 000 рублей дополнительного дохода на новых клиентов.
Экономия: 12-14 часов в месяц. Около 36 000 рублей освобождённого времени при ставке 2 800 рублей за час.
Кейс 3. Финансовый директор производственного холдинга, Екатеринбург
Было: перед советом директоров расхождение между управленческой и бухгалтерской отчётностью на 6,2 миллиона рублей. Финансовый директор получил от главбуха объяснение «это по-разному считаются расходы», но совет потребовал конкретики: по каким счетам, на какие суммы, почему. Сбор объяснений занял два рабочих дня, цифры в итоге не сходились между собой.
Что сделали: сверили две отчётности по счетам промптом 8 из статьи. Модель выдала таблицу: по 23 счетам разницы от 3 тысяч до 1,8 миллиона, по каждому счёту вероятная причина. Из них 8 счетов с методическими разницами, 6 с временными, 4 с пропущенными проводками, остальное мелочь в округлениях.
Стало: полный разбор за 40 минут вместо двух дней. На совет директоров пошла одна страница с таблицей по счетам и причинами, вопросы «а почему так» закрылись на месте. Методические разницы оформили отдельной справкой к учётной политике, и на следующее закрытие квартала разногласия между двумя учётами сократились вдвое.
Экономия: два рабочих дня на подготовку. Разбор за 40 минут вместо двух дней, с цифрами по каждому счёту.
Общая картина по трём кейсам: ручной поиск расхождений занимает от 2 часов до 2 дней, ChatGPT закрывает его за 10-40 минут. Выигрыш не только в часах. Главное, что расхождения перестают откладываться и забываться, потому что разобрать их теперь быстрее, чем отложить.
Стоит добавить и то, что сверка через нейросеть меняет поведение команды. Когда поиск занимает 3-4 часа, его откладывают до обязательного момента: закрытие месяца, подготовка к совету директоров, приход аудиторов. Когда он занимает 10 минут, сверку делают каждую неделю, а то и чаще. А чем чаще сверка, тем меньше расхождений накапливается: ошибка, найденная через неделю, это одна проводка, ошибка, найденная через квартал, это уже расследование на два дня. Регулярность важнее инструмента, и нейросеть делает регулярность доступной.
Что такое галлюцинация и почему модель может придумать причину?
Когда ChatGPT объясняет причину расхождения, он не всегда прав. Модель может уверенно написать «задвоение» там, где реально временная разница, а в худшем случае придумать причину, которой в данных нет. Это не злой умысел, а устройство модели: она предсказывает следующий токен текста, поэтому на неполных данных дозаполняет пробелы правдоподобным продолжением.
В задачах поиска причин это самый опасный сценарий. Арифметическую ошибку видно при пересчёте, а правдоподобно сформулированную причину, за которой нет данных, на глаз не отличить. Единственная защита это требование источника в промпте. Рабочее правило: модель должна для каждой причины указать, на каких строках и суммах она основана. Если причина не подтверждается конкретными строками, модель пишет «нужна проверка документа», а не додумывает. Такое правило я добавляю во все промпты на разбор причин, и оно заметно снижает количество лишних объяснений.
Второй способ проверки: разбор причин отдельно от сравнения. Сначала модель сравнивает файлы и выдаёт три группы, вы проверяете итоги контрольной арифметикой. Потом в отдельном чате просите разобрать причины по строкам. Так модель не тянет контекст из предыдущего обсуждения, а каждая причина проверяется на свежих данных.
Третье правило из практики: не просите модель исправлять учёт. Просите показать, что именно не сошлось, и предложить, что проверить. Ответственность за причину и за исправление всегда на бухгалтере, модель лишь сужает область поиска. Такая схема «модель находит, человек подписывает» снижает риски до приемлемого уровня.
Какие расхождения нейросеть находит хорошо, а с какими ошибается?
Не все типы расхождений одинаково удобны для нейросети. Полезно знать зону уверенности и зону риска до начала работы.
| Тип расхождения | Как справляется ChatGPT | Что делать |
|---|---|---|
| Пропущенная операция | Хорошо, видна в разделе «только в одном файле» | Проверить документ и провести |
| Временная разница | Хорошо, ловит по датам начала и конца периода | Перенести дату или признать разницу |
| Задвоенная проводка | Хорошо, находит по ключу документ + сумма | Сторнировать лишнюю |
| Ошибка форматов | Отлично, нормализует автоматически | Правильный промпт с очисткой |
| Разные методики расчёта | Средне, нужен контекст учётной политики | Объяснить методику в промпте |
| Расхождение из-за курса валют | Средне, путается в датах курса | Указать правила курсирования |
| Нелогичная ошибка вручную | Слабо, правдоподобная причина | Проверить первичные документы глазами |
Главное правило из таблицы: чем больше внешних правил в задаче, тем выше риск галлюцинации. Пропуск и задвоение модель находит по данным, которые уже в файлах. Методики и курсы модель не знает, пока вы не объясните их в промпте. Поэтому перед массовой сверкой полезно описать в персонализации ChatGPT правила своей учётной политики: какие счета считаются как, как учитывается курс, где живёт амортизация. Тогда и причины модель будет предлагать в контексте вашей компании, а не в вакууме.
ChatGPT vs Claude vs Gemini vs Excel: что выбрать для поиска расхождений?
Выбор инструмента зависит от объёма данных, формата вывода и требований к безопасности. Сводная таблица для задачи поиска причин расхождений в отчётности.
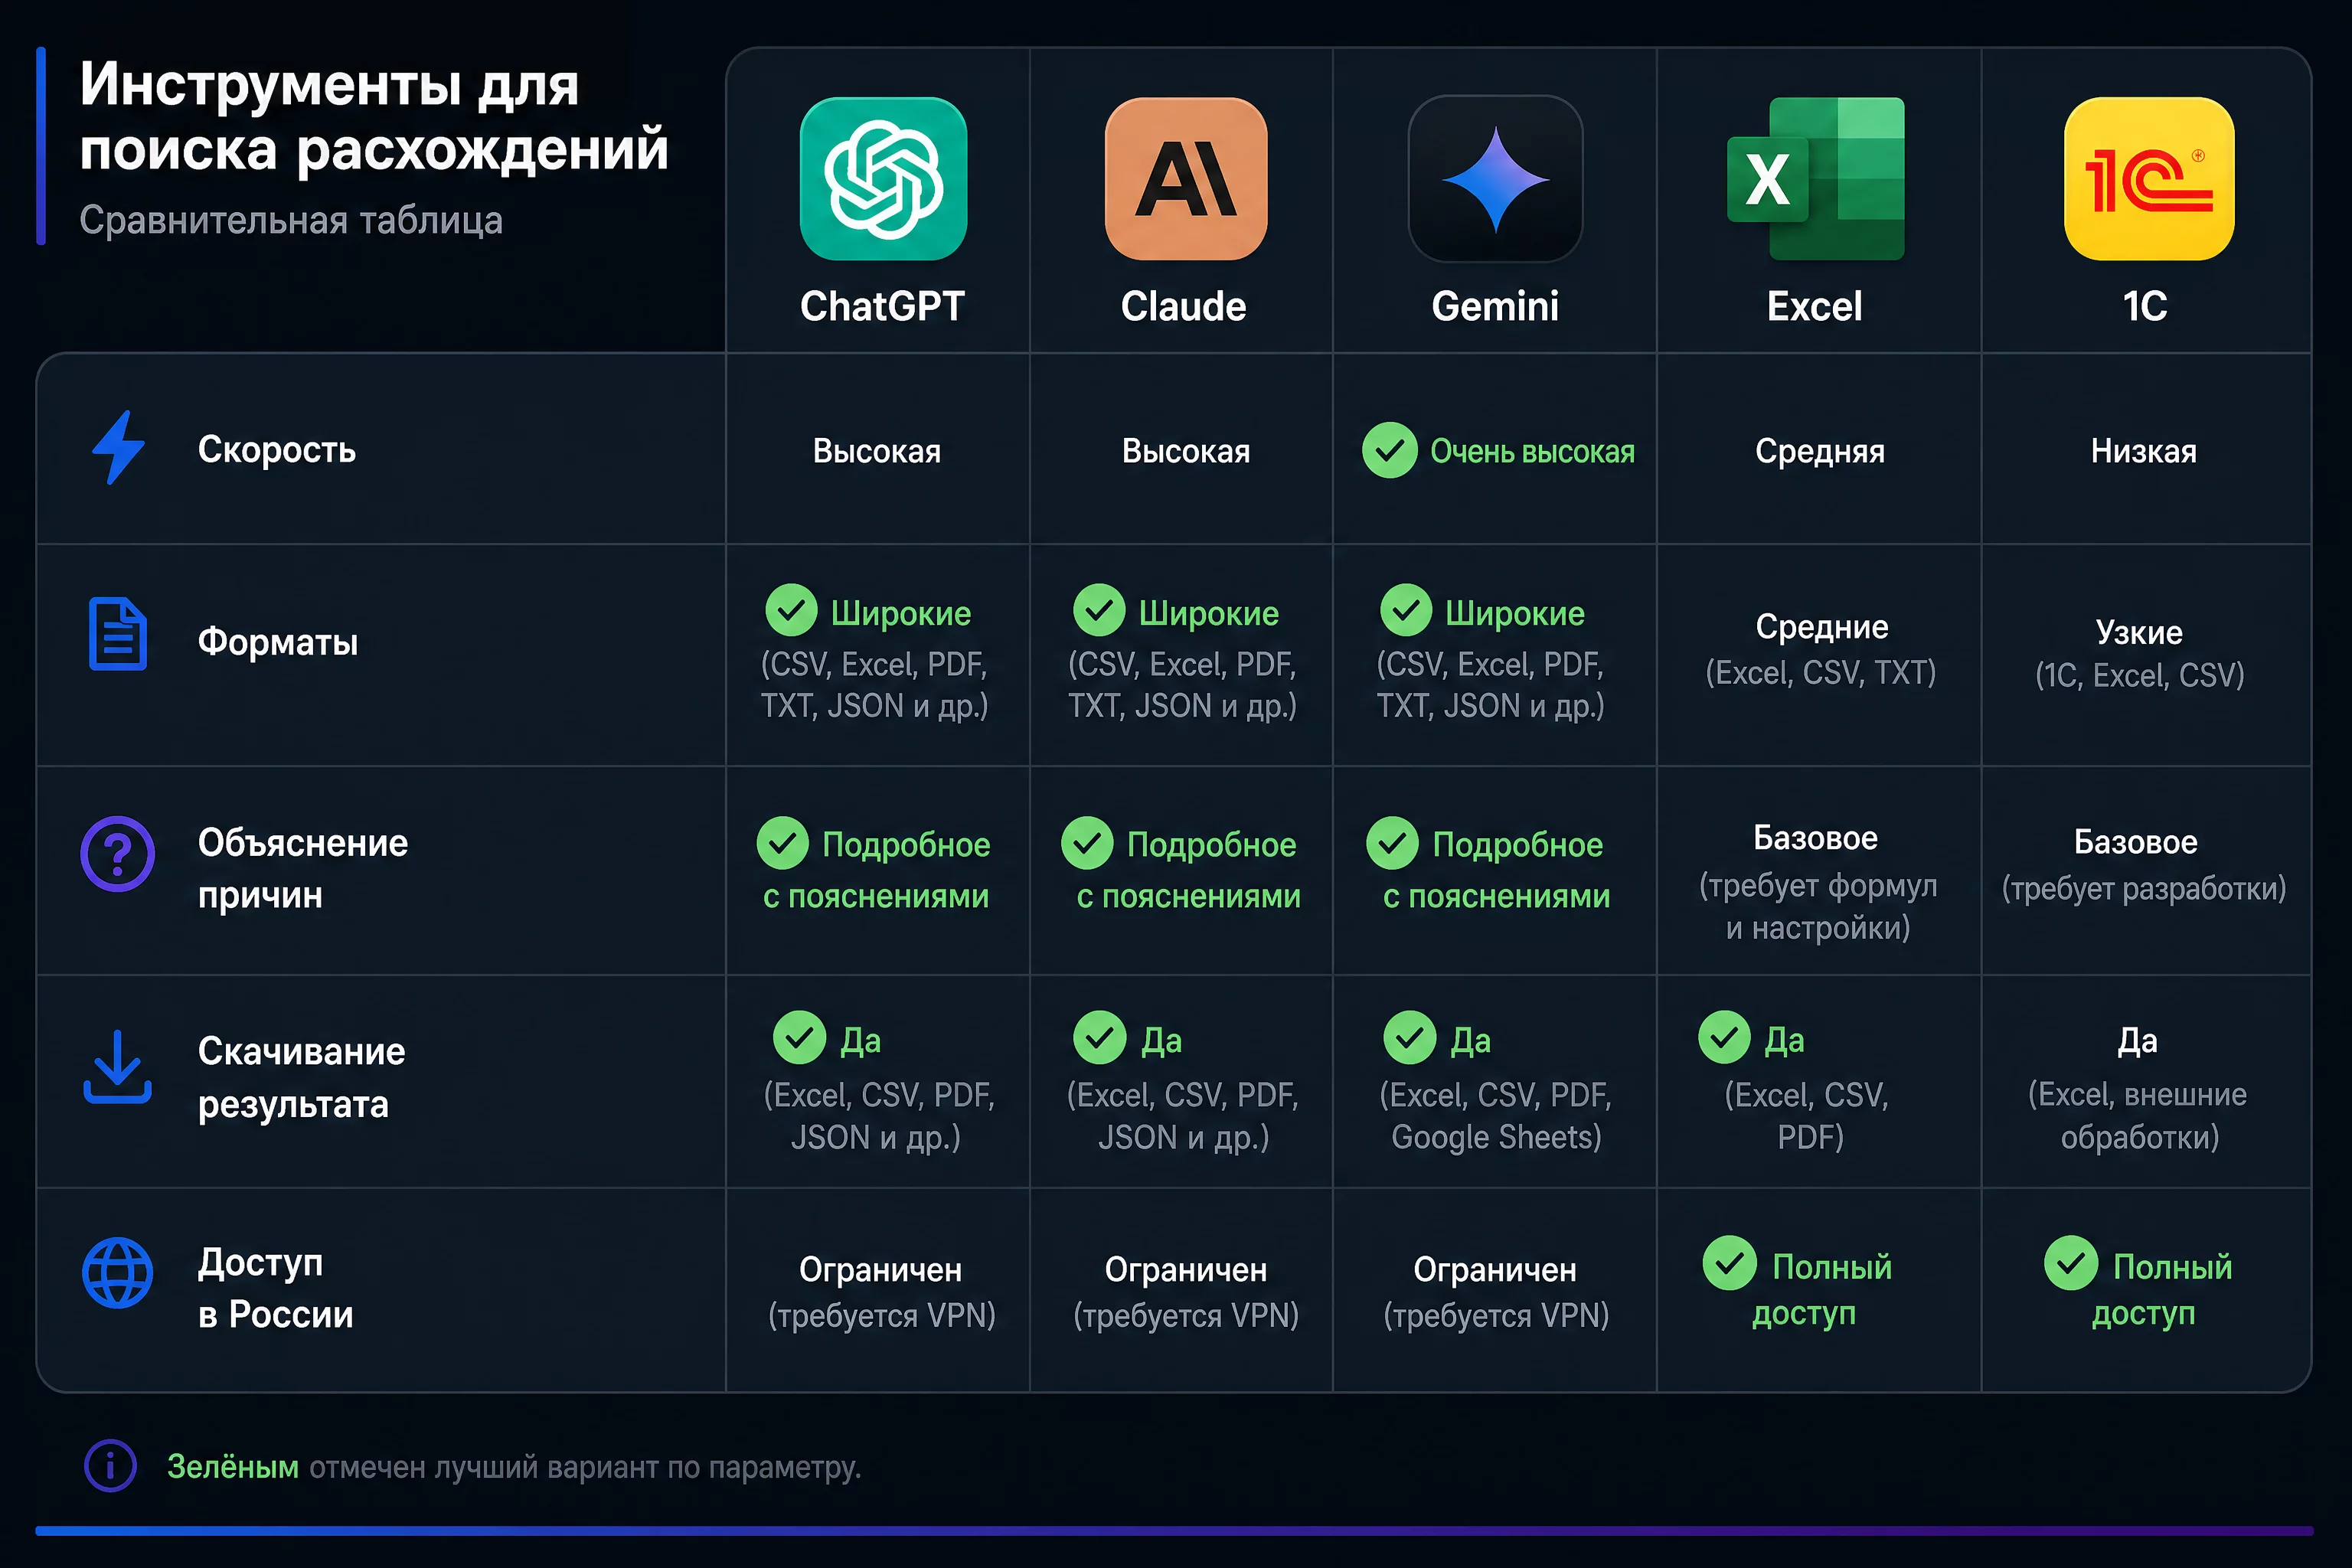
| Параметр | ChatGPT Plus (GPT-5.5) | Claude Sonnet 4.6 | Gemini 2.5 | Excel (ВПР/Power Query) | 1С встроенные отчёты |
|---|---|---|---|---|---|
| Загрузка двух файлов отчётности | Да, Code Interpreter | Ограниченно | Да, в Workspace | Да | Только данные 1С |
| Нормализация форматов автоматически | Да | Да с промптом | Да | Вручную | Автоматически |
| Сравнение по ключу счёт + документ + сумма | Да, Python | Да, через код | Да | ВПР, Power Query | Да |
| Поиск задвоений и временных разниц | Да, отдельными промптами | Да | Частично | Сложно | Ограниченно |
| Объяснение причин по-русски | Отлично | Отлично | Хорошо | Нет | Нет |
| Формирование отчёта для финдира | Да | Отлично | Хорошо | Вручную | Нет |
| Скачивание результата как Excel | Да | Нет напрямую | Нет напрямую | Да | Да |
| Доступ в России | Специальные средства | Специальные средства | Специальные средства | Без ограничений | Без ограничений |
| Нужно обезличивать | Да | Да | Да | Нет | Нет |
| Стоимость | ChatGPT Plus, цены на openai.com | Claude Pro, цены на anthropic.com | Частично бесплатно | Входит в Office | В составе лицензии 1С |
| Лучше для | Массовая сверка с кодом | Разбор причин и длинные объяснения | Экосистема Google | Стандартные сверки | Данные внутри 1С |
Актуально на август 2026 года. Тарифы и функции меняются, проверяйте на официальных сайтах.
Мой практический выбор: для массовой сверки двух файлов с кодом и скачиванием результата это ChatGPT Plus с Code Interpreter. Для разбора сложных причин и составления объяснительной записки для собственника это Claude Sonnet 4.6, он точнее формулирует длинные выводы. Gemini 2.5 беру, когда данные живут в Google Таблицах и выгрузка не нужна. DeepSeek V3.2 бесплатный вариант для черновиков на обезличенных данных, когда важна скорость, а не точность формулировок.
ChatGPT, Claude и Gemini из России напрямую не работают, это ограничение сервисов. Пользоваться нейросетями из России не запрещено, инструмент доступа каждый выбирает сам. Обезличивание обязательно в любом случае.
Что делать, если расхождение не находится? Продвинутые приёмы
Бывает, что сверка прошла, расхождение есть, а причина неясна. Строка в разделе «только в первом» есть, а почему она там, модель не объясняет, и документ не находится. Для таких случаев три приёма.
Приём 1. Разбейте период и сузьте поиск. Если расхождение за квартал, запустите сверку за каждый месяц отдельно. Разница в одну проводку за месяц видна лучше, чем в массе квартала. Когда месяц найден, сузьте до декады, потом до дня. Так область поиска сжимается до одной-двух операций, и причина становится очевидной.
Приём 2. Сверьте в другом разрезе. Если сверка по счетам не дала результата, сверьте по контрагентам или по документам. Расхождение может быть внутри счёта: две операции разного знака скомпенсировали друг друга, и сумма по счёту сошлась, а структура разъехалась. Сверка в разрезе контрагентов покажет, кто именно не сходится.
Приём 3. Попросите модель построить дерево причин. Вместо ответа «причина неясна» попросите ChatGPT вывести гипотезы с проверкой каждой: «предложи три версии, для каждой укажи, какие данные подтверждают и опровергают». Модель в режиме рассуждения выдаёт структурированные версии, и часто одна из них наводит на правильный след, даже если сам ответ не точный. Подробно про приёмы точного рассуждения я разбирала в статье про ошибки ChatGPT в цифрах.
Когда ни один приём не помог, честный вывод такой: расхождение лежит вне данных, которые вы загрузили. Возможно, операция вообще не попала в выгрузку, или в учётной системе есть ручная корректировка, которую не видно в отчёте. Тогда поиск уходит в первичные документы, и это уже работа человека, а не нейросети.
Какие ошибки мешают найти расхождение через нейросеть?
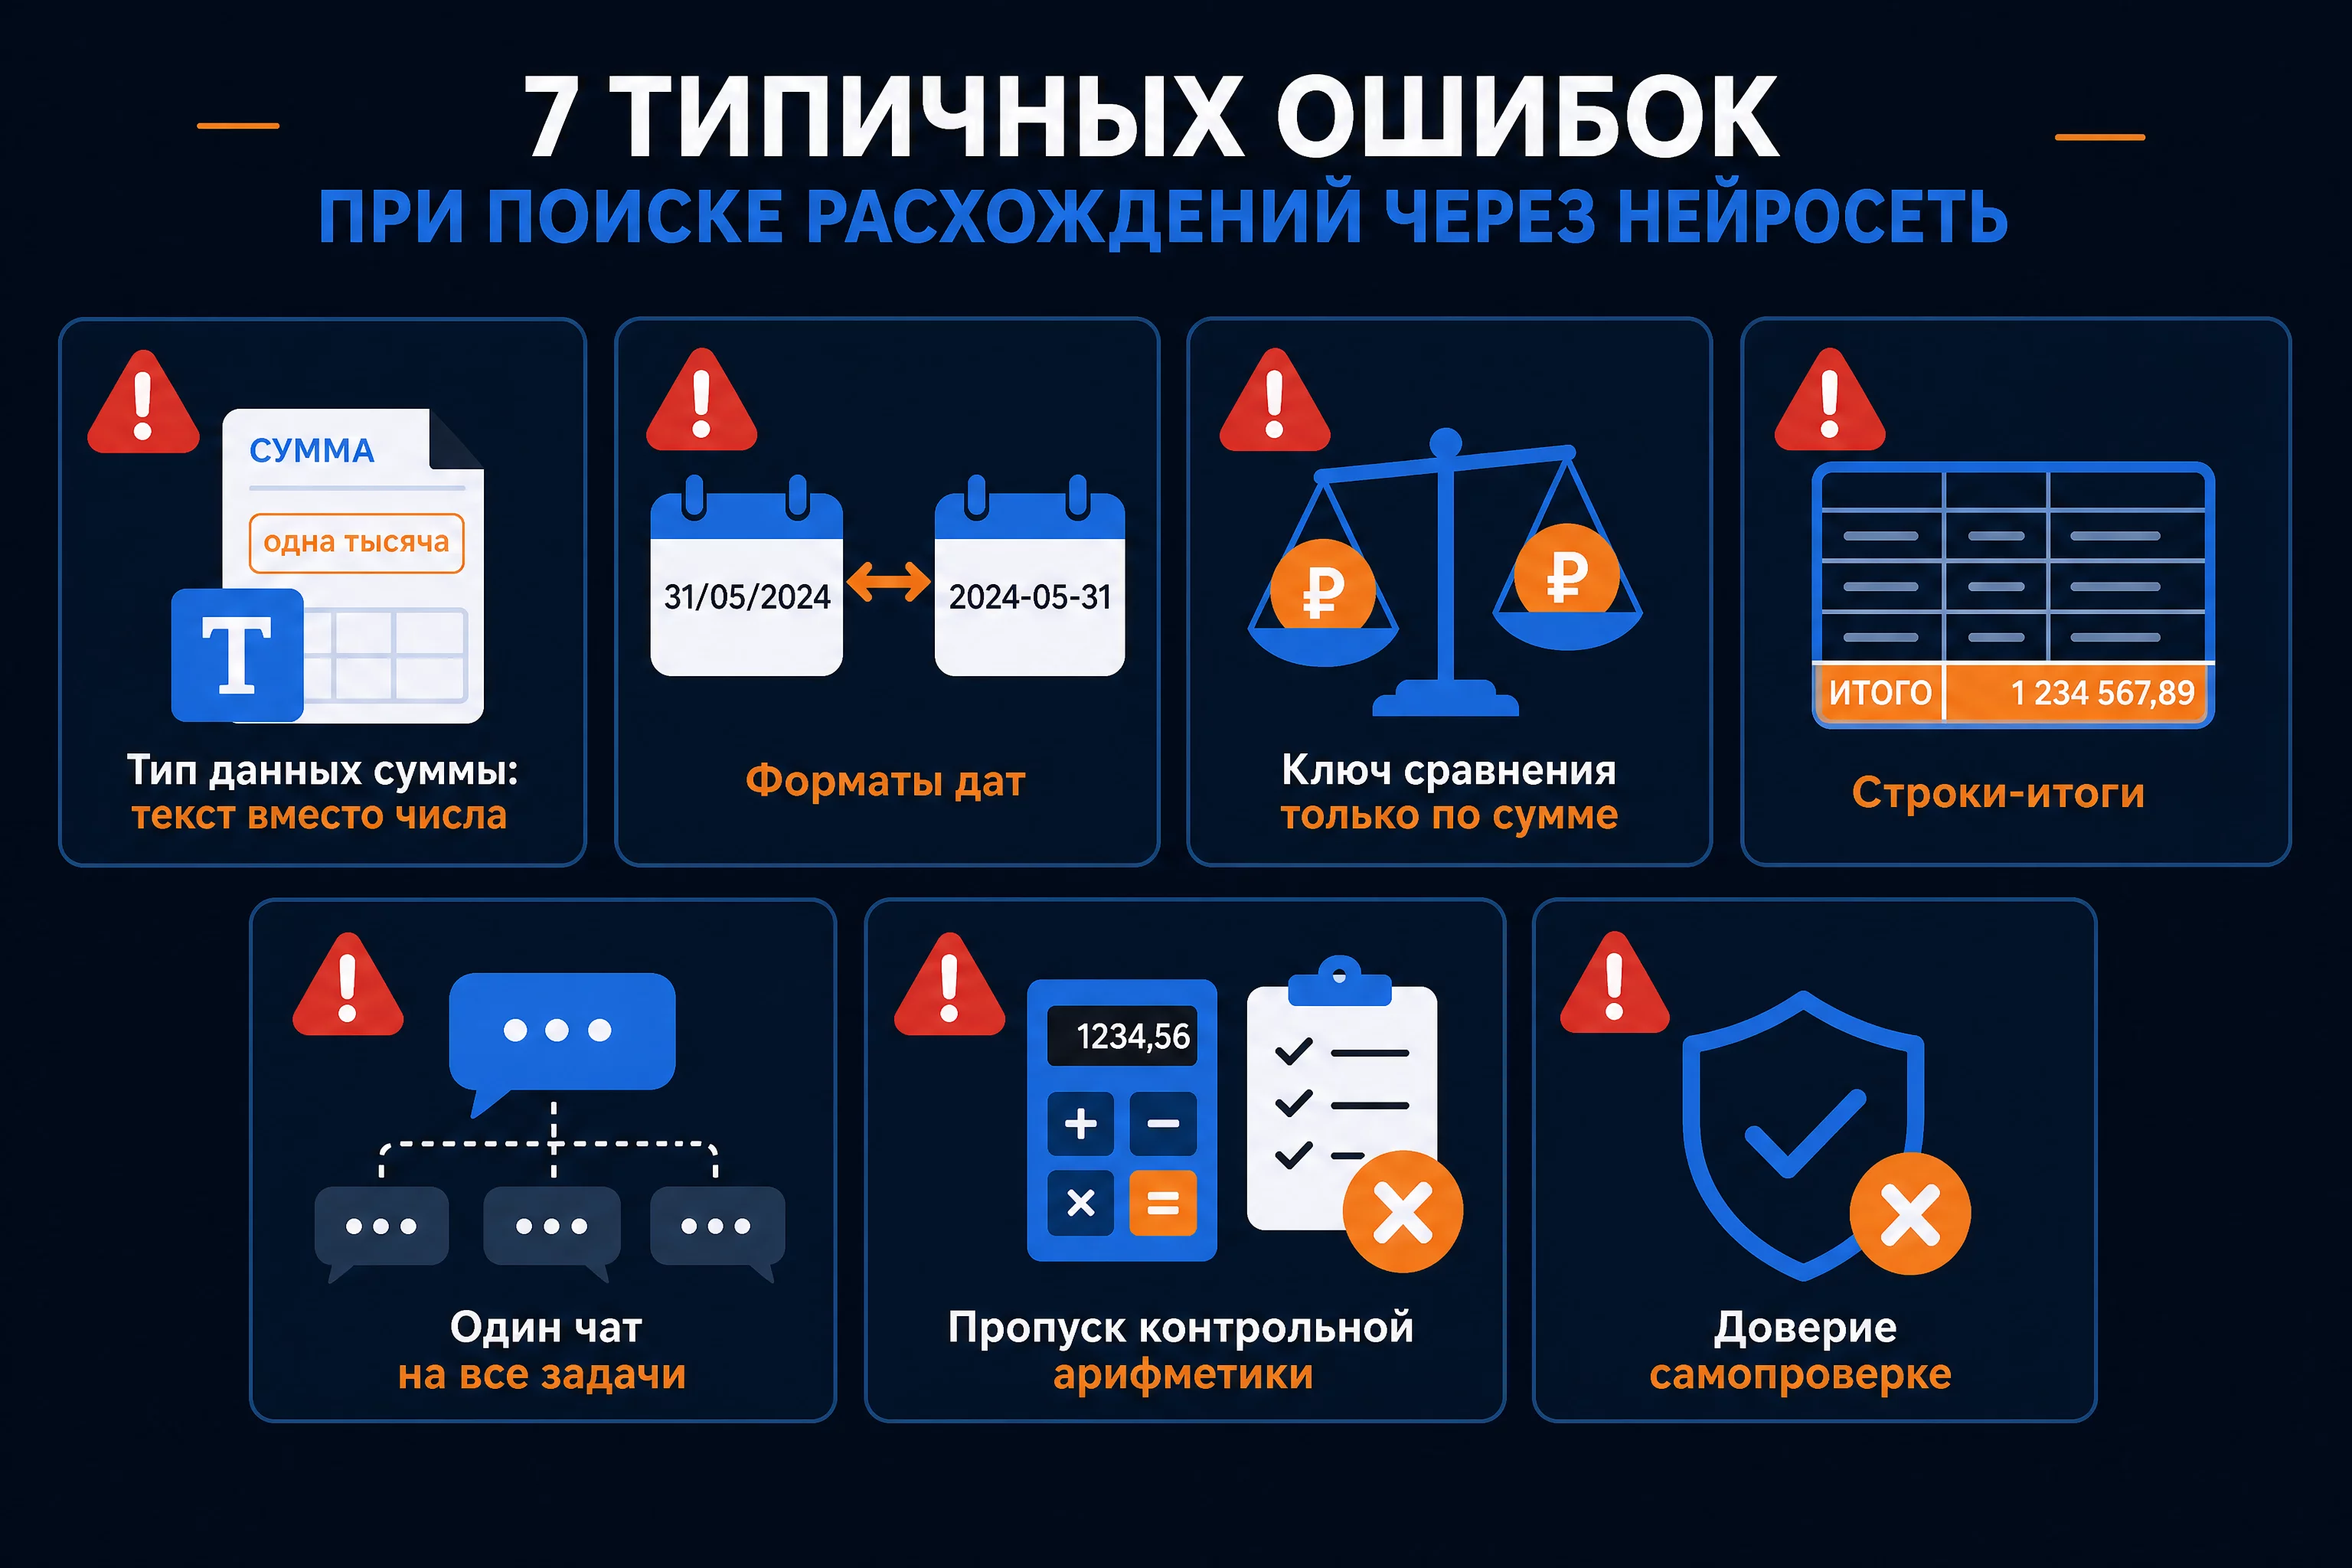
Семь ошибок, которые я вижу у учеников на первых сверках. Каждая стоит от получаса до дня.
Прежде чем перейти к списку, пара слов о том, почему ошибки на первых сверках неизбежны. Промпт под свои файлы невозможно написать идеально с первого раза: вы не знаете заранее, как модель прочитает ваши колонки, какие строки примет за итоги, где сломается формат дат. Первая сверка это всегда отладка, и это нормально. Ошибки из списка ниже повторяются у большинства, их легче предотвратить, если знать, где искать.
Ошибка 1. Не проверить тип данных суммы. Число 1 234 567,89 с неразрывным пробелом вместо разделителя тысяч Python читает как текст. Проверка: если модель пишет, что в колонке суммы тип object вместо float64, значит суммы текстовые. Решение: добавить в промпт строку «очисти разделители тысяч в колонке Сумма и переведи в числа».
Ошибка 2. Разные форматы дат в двух файлах. В одном файле 28.06.2026, в другом 28/06/2026. Python видит разные строки и не находит пары по дате. Решение: указать форматы в промпте или попросить «приведи все даты к формату ГГГГ-ММ-ДД перед сравнением».
Ошибка 3. Ключ сравнения только по сумме. Два разных документа на одну и ту же сумму от разных контрагентов дают ложные совпадения. Минимальный ключ для отчётности это счёт плюс документ плюс сумма. Если номеров документов нет, ключ счёт плюс контрагент плюс сумма с допуском на округление.
Ошибка 4. Не исключить строки-итоги. В конце отчёта часто стоит строка «Итого за период». Code Interpreter читает её как операцию с суммой оборота, которая не найдёт пары. Удалите строки-итоги перед загрузкой или добавьте в промпт «исключи строки, где колонка Счёт пустая или есть слово Итого».
Ошибка 5. Один чат на все задачи. Если в одном чате сначала сравнить файлы, потом разбирать причины, потом составлять отчёт, контекст засоряется, и модель начинает путать данные разных задач. Для каждой задачи открывайте отдельный чат и загружайте файлы заново.
Ошибка 6. Пропустить контрольную арифметику. Самая дорогая ошибка: поверить результату сравнения без проверки итогов. Всегда просите модель вывести суммы по трём разделам и сравнить с итогами исходных файлов. Если сумма совпадений плюс сумма «только в первом» не равна итогу первого файла, в коде потерялись строки.
Ошибка 7. Доверить модели самопроверку. Когда модель проверяет свой же расчёт, она часто подтверждает свой ответ, даже если он неверный. Внешний пересчёт кодом или вторым способом ловит то, что самопроверка пропускает. Подробно про этот механизм я разбирала в статье про ошибки ChatGPT в цифрах.
После первой сверки прогоните результат через эти семь пунктов. На второй сверке половина ошибок уйдёт сама, потому что промпты уже подогнаны под ваши файлы.
Когда ChatGPT не поможет найти причину? Честные ограничения
Я не убеждаю переехать из Excel в ChatGPT навсегда. У инструмента есть границы, и их полезно знать до старта.
Не подключается к 1С напрямую. Данные нужно выгружать вручную. Для автоматической выгрузки из 1С в ChatGPT нужна интеграция через API или n8n, это следующий уровень автоматизации.
Не имеет памяти между сессиями без настройки. Файлы и код существуют в пределах одного чата. Открыли новый чат, загружаете заново. Решение: сохраняйте код в библиотеку после каждой сверки и настройте память под правила компании.
Не заменяет решение человека. Модель находит расхождение и предлагает причину, но решение, как исправить, принимаете вы. Временная разница не требует проводок, задвоение требует сторно, методическая разница требует согласования учётной политики. Ответственность за исправление всегда на человеке.
Ошибается на нестандартных форматах. Некоторые отчёты выгружаются с объединёнными ячейками, многоуровневыми заголовками или вообще только в PDF со сканами. На отладку промпта под такой формат уходит 15-30 минут, но потом шаблон работает.
Замедляется на очень больших файлах. ChatGPT Plus принимает файлы до 512 МБ, но на таблицах с сотнями тысяч строк скорость падает. Для таких объёмов агрегируйте данные в учётной системе перед выгрузкой или разбивайте на периоды.
Требует обезличивания. Это обязательное правило безопасности, которое немного ограничивает удобство: маски приходится расшифровывать обратно в результатах. Реальные ИНН, счета и ФИО в публичные тарифы не грузим.
Границы не отменяют пользы. Они говорят, что ChatGPT это инструмент первого прохода, который сжимает ручную работу в десять раз, а финальную проверку и решение оставляет вам.
Что загружать в ChatGPT безопасно, а что нельзя? Правила обезличивания
Отчётность содержит данные, которые охраняются законом. Разбираю конкретно, что под запретом, а что допустимо после обезличивания.
Нельзя загружать в публичный ChatGPT:
- Реальные ИНН организаций и физических лиц
- Расчётные счета, БИК, корреспондентские счета
- Полные наименования контрагентов, по которым можно идентифицировать компанию
- ФИО сотрудников и руководителей
- Данные под жёстким NDA и банковскую тайну
Можно после обезличивания:
- Структуру операций: счета, даты, суммы, типы операций
- Номера документов без привязки к реальным контрагентам
- Агрегированные данные по периодам
Как обезличить отчётность за 10 минут:
- Создайте таблицу замен в Excel: две колонки «Реальное» и «Маска». ИНН 7712345678 становится К01, ООО «Ромашка» становится Контрагент 1. Для каждого уникального контрагента своя маска.
- Через Ctrl+H замените каждый реальный ИНН и название на маску. Суммы, даты и номера документов не трогайте, они критичны для сверки.
- Счета и БИК замените на «Счёт К01», «БИК1». Сохраните справочник замен у себя, он нужен для расшифровки результата.
Настройки ChatGPT перед загрузкой:
В Settings, Data Controls выключите переключатель «Improve model for everyone» или «Улучшить модель для всех». Это запрещает использовать ваши чаты для обучения модели. Для корпоративного уровня есть ChatGPT Enterprise с изолированным контуром или локальные модели, которые не отправляют данные наружу. Полный разбор правил обезличивания я собрала в отдельной статье.
Правовой фрейм коротко: ФЗ-152 о персональных данных требует законного основания для передачи персональных данных иностранному оператору. За утечки с 2025 года действуют оборотные штрафы: при повторных нарушениях от 1% до 3% годовой выручки, не менее 20 и не более 500 миллионов рублей. Банковская тайна охраняется ФЗ «О банках и банковской деятельности», её разглашение это потенциально уголовная статья. Ответственность несёт должностное лицо организации, не ChatGPT.
Как перейти от разовой проверки к ежемесячной сверке отчётности?
ChatGPT в ручном режиме закрывает большинство задач. Но если вы сверяете отчётность каждый месяц по одной схеме, это повод пойти дальше.
Уровень 1. Ручная сверка через ChatGPT. Загружаете файлы руками, используете шаблонные промпты, скачиваете результат. Экономия: 2-3 часа в месяц. Порог входа: 20-30 минут на первую настройку. Описано в этой статье.
Уровень 2. Полуавтоматизация Python-скриптом. Берёте код, который ChatGPT написал для вашей сверки, сохраняете в .py-файл, меняете три строки с именами файлов и периодом, запускаете через Google Colab бесплатно или локально. Данные никуда не уходят. Занимает 1-2 часа на настройку, знание Python не нужно, модель помогает и с этим.
Уровень 3. Полная автоматизация через n8n. Сценарий: выгрузка из учётной системы по расписанию, Python-скрипт запускается, результат записывается в Google Таблицы, уведомление приходит в Telegram. Бухгалтер только проверяет итог. Подробно про автоматизацию рутинных сверок я разбирала в статье про n8n для финансиста и в обзоре сверки регистров через Code Interpreter.
Рекомендация: не перескакивайте на уровень 3, не освоив уровень 1. Автоматизировать нужно рабочий процесс, а не ломаный. Сначала промпты под ваши форматы, потом код, потом расписание.
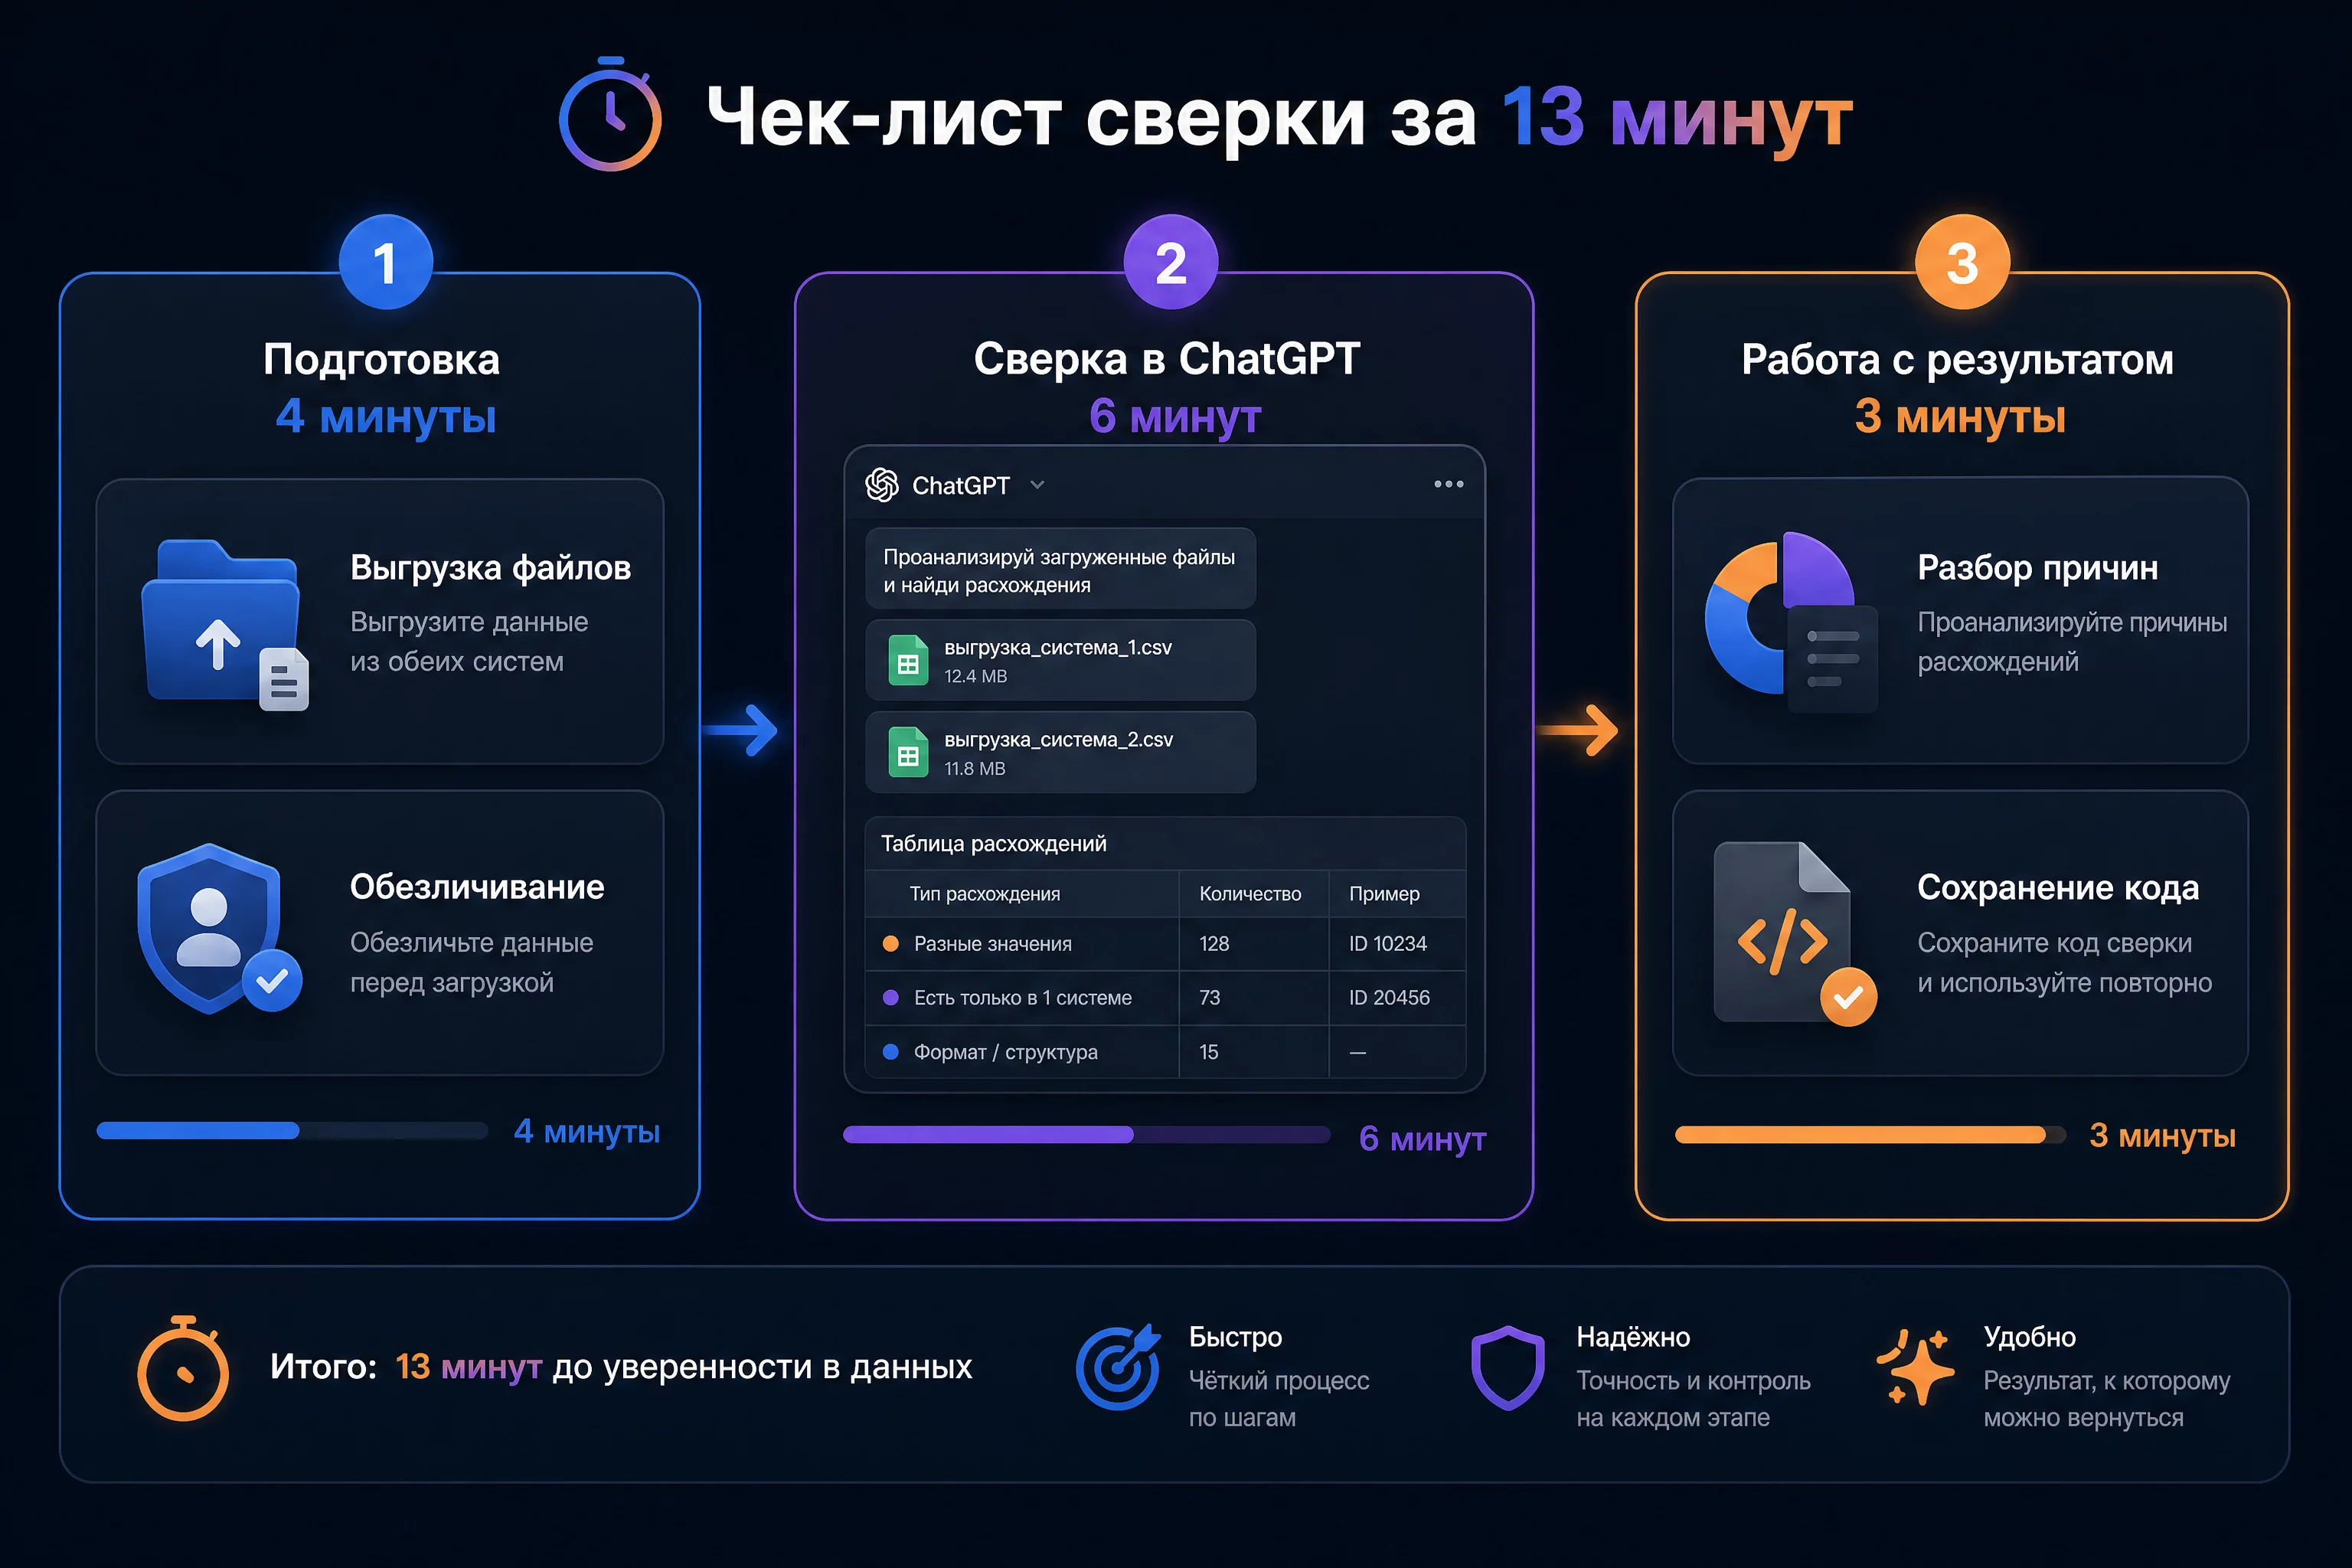
Чек-лист: как найти причину расхождения за 10 минут
Подготовка (3-4 минуты)
- Выгрузите первый файл из управленческой системы, второй из 1С за один период.
- Обезличьте оба файла по справочнику замен: ИНН на К01, К02, контрагенты на маски.
- Проверьте форматы: суммы числовые, даты в одном формате, нет объединённых ячеек.
- Удалите строки «Итого» из обоих файлов.
- Сохраните файлы как .xlsx или .csv.
Сверка в ChatGPT (5-6 минут)
- Откройте chatgpt.com, тариф Plus, новый чат.
- Загрузите оба файла через кнопку прикрепления.
- Проверьте первые строки в ответе модели: суммы должны быть числами.
- Отправьте промпт 2 с описанием структуры и ключа сравнения.
- Дождитесь выполнения кода, при ошибке просите «исправь и повтори».
- Попросите модель объяснить причины по каждой строке расхождений.
- Запустите контрольную арифметику промптом 6.
Работа с результатом (2-3 минуты)
- Разберите разделы «только в первом» и «только во втором».
- Для топ-расхождений по сумме спросите модель о причинах отдельно.
- Сформируйте план исправлений промптом 10.
- Скачайте итоговую таблицу и сохраните Python-код в библиотеку.
- Расшифруйте маски по справочнику замен и передайте документы в работу.
Как настроить ChatGPT под свою компанию? Память и персонализация
Постоянные правила лучше держать не в каждом промпте, а в настройках ChatGPT. Два инструмента для этого: персональные инструкции и память.
Персональные инструкции. В Settings, Personalization, Custom instructions вставляете блок с правилами вашей компании: какие счета участвуют в сверке, как считается курс, какие методы амортизации используются, как называются контрагенты в масках. Модель будет учитывать эти правила в каждом ответе, и промпты для сверки станут короче: не нужно каждый раз объяснять, что такое ОСВ и почему счёт 60 это расчёты с поставщиками.
Шаблон персональной инструкции для финансиста:
Ты помощник главного бухгалтера и финансового директора.

Контекст компании:
- Учётная система: 1С:Бухгалтерия 3.0
- Управленческий учёт: Excel-модель, обновляется ежемесячно
- Основные счета сверки: 51, 60, 62, 76, 90, 91
- Амортизация линейная, в управленке ускоренная
- Курс валют: в бухгалтерии на дату операции,
  в управленке на конец месяца
- Данные в файлах обезличены, контрагенты обозначены К01, К02

Правила работы:
- Сначала показывай ход, потом итог
- Для каждой причины расхождения указывай строки и суммы,
  на которых она основана
- Если данных не хватает, пиши «нужна проверка документа»
- Язык ответа: деловой русский
Память. В июне 2026 года OpenAI сделала память умнее: модель сама собирает факты из истории диалогов, сводку можно посмотреть на странице управления памятью, добавить или удалить записи. Для сверки это значит, что после первого месяца работы ChatGPT запомнит структуру ваших файлов и типичные причины расхождений. Во втором месяце промпт можно сократить до одной строки: «сверь те же два файла за июль», и модель вспомнит ключ сравнения.
Три правила при работе с памятью:
- Просматривайте сводку памяти раз в месяц. Если модель запомнила что-то лишнее, удалите запись.
- Не позволяйте памяти хранить персональные данные. Правила учёта и методики пусть запоминает, ИНН и счета нет.
- Проверяйте, что память не противоречит новой задаче. При смене учётной политики обновите инструкцию и очистите старые записи.
Настройка персонализации и памяти занимает полчаса один раз, а дальше каждый промпт из этой статьи работает точнее и требует меньше правок.
Как не дать расхождениям накапливаться? Регулярная сверка
Самая дорогая ошибка в работе с отчётностью это не расхождение само по себе, а расхождение, которое накопилось за несколько месяцев. Одна пропущенная проводка в январе, во втором квартале это уже три месяца разных итогов, к декабрю это расследование на два дня. Чем раньше найдено расхождение, тем дешевле его исправление. Отсюда правило: сверка должна быть регулярной, а не авральной.
ChatGPT меняет экономику регулярности. Ручная сверка 2-3 часа, поэтому её делают раз в месяц перед закрытием, а то и раз в квартал. Сверка через нейросеть 10 минут, поэтому её можно делать еженедельно без потери времени. На еженедельной сверке расхождение живёт максимум неделю, это одна проводка или один документ. На квартальной сверке расхождение живёт три месяца, и это уже клубок из взаимосвязанных причин.
Как выстроить регулярную сверку:
- Выберите один день недели, например пятницу, и 30 минут в календаре.
- Загрузите свежие выгрузки за неделю и запустите шаблонный промпт.
- Разберите найденные расхождения в тот же день, пока контекст свежий.
- Ведите журнал расхождений: дата, счёт, сумма, причина, как исправлено.
- Раз в квартал смотрите статистику: какие причины повторяются, и закрывайте их на уровне учётной политики.
Журнал расхождений это недооценённый инструмент. Через два-три месяца в нём видно, что 60% расхождений это три типичные причины. Дальше вы либо автоматизируете их исправление, либо меняете процесс так, чтобы причина не возникала. Нейросеть находит расхождения, а журнал превращает их в управляемый список.
Что дальше: как превратить разовый поиск в систему?
Десять промптов из этой статьи закрывают конкретную боль: страх открыть два файла и понять, почему они не сходятся. Но это часть большой системы работы с ИИ в финансах. Следующий шаг собрать вокруг нейросетей весь контур: точные расчёты, сверка отчётности, проверка данных, автоматизация рутины и подготовка к закрытию месяца.
На курсе «AI-навыки финансиста» онлайн-школы «Финансовый директор | Мастер CFO» разбираю, как выстроить такую систему: от обезличивания данных до мастер-промптов под ваши процессы и автоматизации через n8n. 10 модулей, 800+ выпускников, диплом установленного образца с лицензией и налоговый вычет 13%. Начать можно с бесплатного эфира-экскурсии, где показываю процесс на практике.
Записаться на курс «AI-навыки финансиста»
Смежные материалы на нашем блоге: как автоматизировать банковскую сверку, проверка расчётов нейросети на точность, аудит формул Excel через ChatGPT, сверка регистров через Code Interpreter, обезличивание данных, поиск аномалий в отчётности.
Часто задаваемые вопросы
Что такое расхождение в отчётности? Расхождение это разница между двумя источниками данных, которые по смыслу должны совпадать: остаток в 1С и в управленческом Excel, оборот по счёту в банке и в учёте, сумма в акте сверки контрагента и в вашей системе. Причины: пропущенная проводка, задвоение, разница периодов, ошибка форматов или разные методики расчёта.
Почему ChatGPT хорошо находит причины расхождений? ChatGPT через Code Interpreter пишет и исполняет Python-код прямо в диалоге. Код нормализует форматы, сравнивает строки по ключу и раскладывает результат на три группы: совпадения, только в первом, только во втором. Модель не устаёт на тысячах строк, а причины объясняет по-русски.
Какие файлы можно загружать в ChatGPT для сверки? Excel и CSV подходят лучше всего. PDF читается хуже, для сканов каждую строку нужно проверять. В бесплатной версии загрузка файлов ограничена, для работы с Code Interpreter нужен тариф Plus или выше.
Нужен ли платный ChatGPT для поиска расхождений? Для работы с файлами да. ChatGPT Plus с GPT-5.5 даёт доступ к Code Interpreter: загрузка Excel и CSV, выполнение Python-кода, скачивание таблицы результата. В бесплатной версии можно вставить данные текстом для небольших таблиц.
Сколько времени экономит ChatGPT на поиске причин расхождений? Ручной поиск занимает от двух часов до рабочего дня. С ChatGPT 10-15 минут при первом запуске и 7-10 минут со второго месяца, когда код сохранён в библиотеке.
Безопасно ли загружать отчётность в ChatGPT? Только в обезличенном виде. ИНН, счета, ФИО и названия контрагентов заменяем масками, суммы и даты оставляем. В настройках Data Controls выключаем обучение на данных. Под NDA и банковскую тайну используем корпоративный контур или локальную модель.
Может ли ChatGPT сам исправить ошибку в учёте? Нет. Он находит расхождение и предлагает причину, а план исправлений формирует в виде списка действий. Проводки в 1С вносит бухгалтер, ответственность несёт человек.
Какая модель лучше для поиска причин расхождений? Для массовой сверки с кодом удобнее GPT-5.5. Claude Sonnet 4.6 точнее формулирует причины и объяснения. Gemini 2.5 удобен для Google Таблиц. DeepSeek V3.2 бесплатный вариант для черновиков на обезличенных данных.
Наши каналы для финансистов
@findir_pro. Основной Telegram-канал онлайн-школы «Финансовый директор | Мастер CFO». 45 000 подписчиков. Ежедневно: практические разборы, кейсы выпускников, обновления инструментов, новые промпты для финансистов.
«АИ с Софьей и Натали». Канал об AI для финансистов. 13 000 подписчиков. Вместе с Софьей Бурцевой, основателем школы, разбираем новые модели, делаем живые тесты и публикуем обновлённые промпты сразу после выхода новых версий.
MAX. Закрытое сообщество для действующих финансовых директоров. 5 000+ участников. Кейсы коллег, шаблоны, закрытые эфиры по AI и стратегии CFO.
Об авторе
Натали Васильева. Эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO», основатель школы Софья Бурцева. С нейросетями в работе финансиста с февраля 2023 года. Через курс «AI-навыки финансиста» прошли 800+ финансистов, главбухов и финдиров. Веду Telegram-канал @findir_pro, 45 000 подписчиков, и канал «АИ с Софьей и Натали», 13 000 подписчиков.