AI для финансиста
Проверка расчёта резервов на отпуска через ChatGPT vs Excel: где нейросеть чаще ошибается

Главбух пересчитывает резерв на отпуска раз в квартал, находит расхождение на пару тысяч рублей и не может объяснить, откуда оно взялось. Руки не доходят разобраться, поэтому в отчётность идёт цифра «как в прошлый раз». Знакомо каждой бухгалтерии, где расчёт резерва живёт в Excel-файле с формулами, которые кто-то когда-то настроил и уже никто не проверяет.
В 2026 году этот цикл закрывается за один вечер: нейросеть пересчитывает резерв с нуля по исходным данным, сравнивает с вашим файлом и показывает расхождения построчно. Но у этого подхода есть обратная сторона, о которой почти не пишут. ChatGPT умеет ошибаться в этом расчёте своими, специфическими ошибками, и если их не знать, можно получить уверенный неверный ответ, который выглядит идеально правдоподобно.
Я Натали Васильева, эксперт по нейросетям и продюсер онлайн-школы «Финансовый директор | Мастер CFO» (основатель школы, Софья Бурцева, 45 000 подписчиков в @findir_pro, 13 000 в «АИ с Софьей и Натали», 5 000+ в MAX, 800+ выпускников курса AI-навыков). Тема резервов регулярно всплывает на консультациях, потому что это расчёт с тремя блоками данных и дюжиной методологических ловушек, где и Excel, и нейросеть находят свои способы ошибиться.
В этой статье разбираю по-честному, где ошибается Excel, где ChatGPT, как отличить одну ошибку от другой и как построить проверку, которая ловит оба типа. Одиннадцать готовых промптов, три кейса с цифрами и сравнительная таблица внутри. Актуально на 14 августа 2026 года, актуальные модели: GPT-5.5, Claude Sonnet 4.6, Gemini 2.5, DeepSeek V3.2. Сайт chatgpt.com в России открывается через специальные средства доступа, упоминаю один раз и к этому не возвращаюсь.
Что такое резерв на отпуска и почему его расчёт проверяют каждый раз
Резерв на отпуска это оценочное обязательство компании, сумма, которую нужно зарезервировать, чтобы в момент ухода сотрудника в отпуск или выплаты компенсации за неиспользованные дни у компании были деньги. В России расчёт регулируется ПБУ 8/2010 «Оценочные обязательства, условные обязательства и условные активы», а методику компания закрепляет в учётной политике.
Звучит как рутина, но на практике это один из самых «текучих» расчётов в бухгалтерии. Каждый месяц меняются три величины: у сотрудников накапливаются новые дни отпуска, у кого-то меняется заработок, кто-то увольняется и получает компенсацию. Поэтому резерв нельзя посчитать один раз и забыть, его пересчитывают на каждую отчётную дату, обычно ежемесячно или ежеквартально.
Почему именно этот расчёт так часто проверяют? Потому что цена ошибки не абстрактная. Заниженный резерв означает, что в момент массовых летних отпусков у компании не хватит денег на выплаты, и придётся срочно перекраивать бюджет. Завышенный резерв занижает прибыль и искажает управленческую отчётность, а при аудите это прямой вопрос: почему величина оценочного обязательства не сходится с кадровыми данными.
Отдельная боль в том, что расчёт почти всегда живёт в персональном Excel-файле. Формулы настроил один человек, никто не документировал логику, а при каждом обновлении штата файл правится вручную. Именно такие файлы дают самый большой урожай ошибок, и именно их проще всего проверить нейросетью, если проверку построить правильно.
Если вы только знакомитесь с тем, как нейросети вообще встраиваются в финансовые процессы, стоит начать с общего обзора нейросетей для финансиста и бухгалтера. Здесь же я иду глубже: в конкретный расчёт, в его типовые ошибки и в промпты, которые эти ошибки ловят.
Как устроен расчёт резерва: три блока, которые нужно проверить
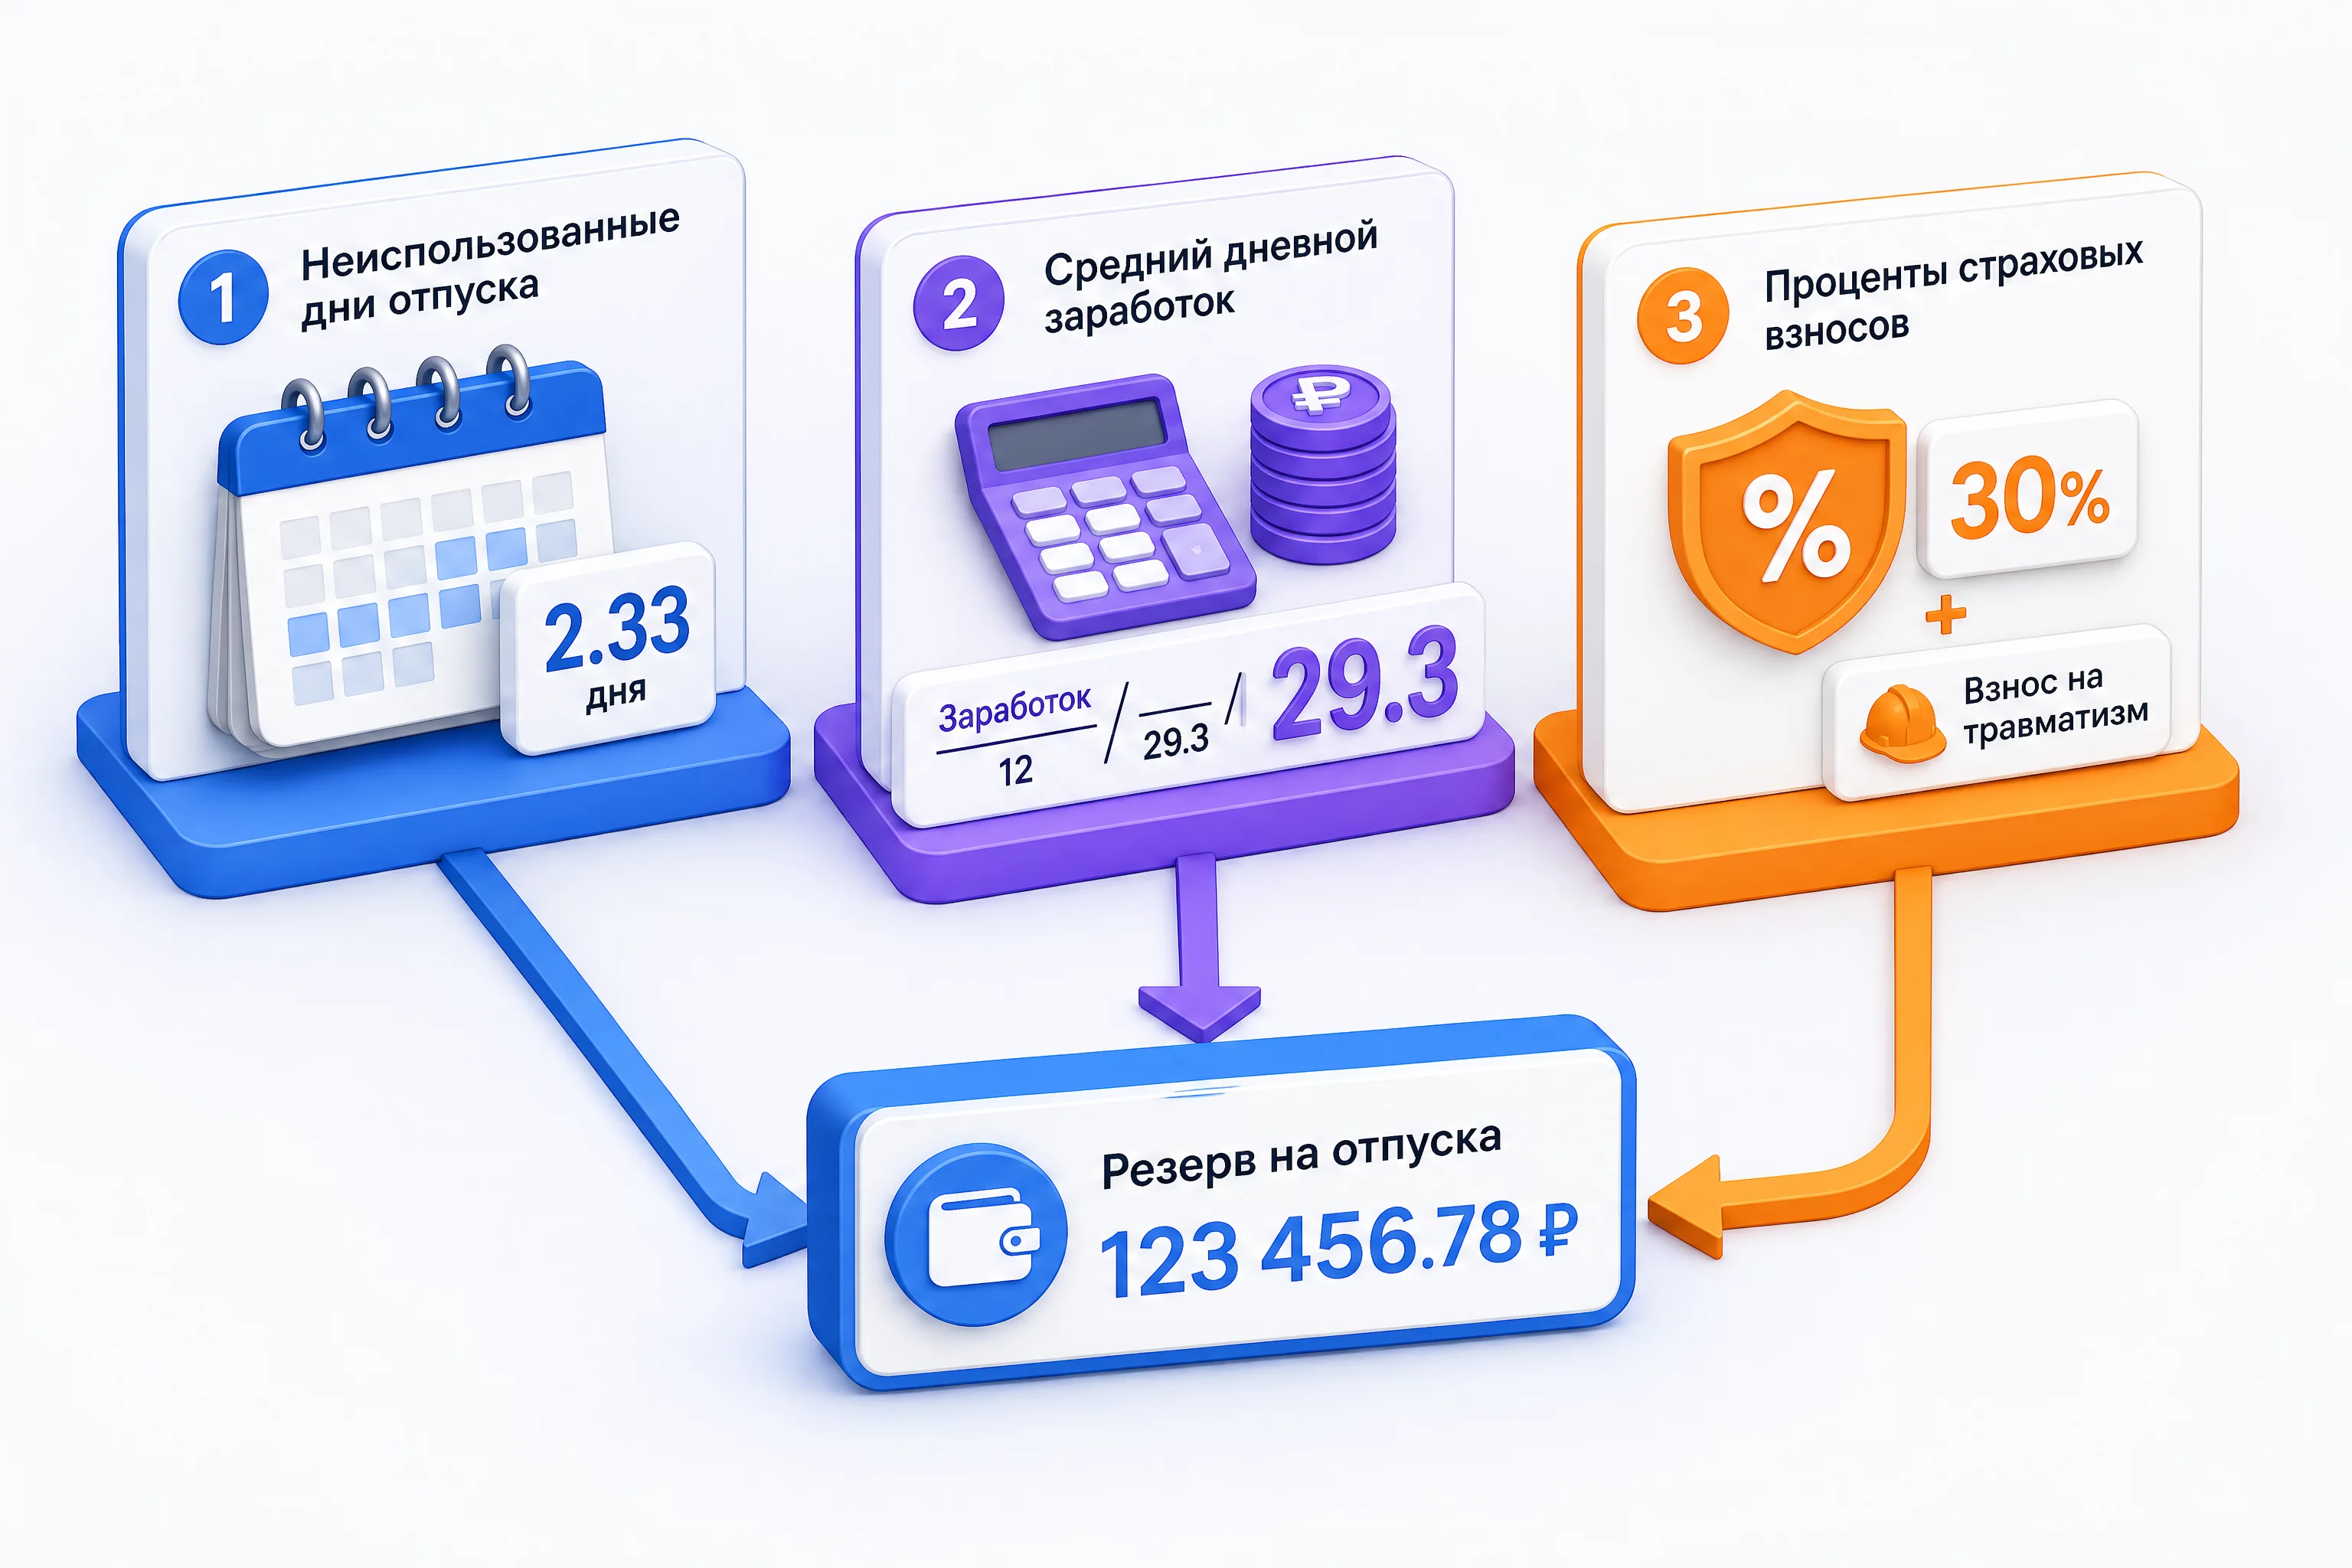
Расчёт резерва на отпуска состоит из трёх блоков, и каждый из них ошибается по-своему. Если проверять резерв как одну сумму, ошибки будут маскировать друг друга. Если проверять по блокам, каждая ошибка показывает себя отдельно.
Первый блок: неиспользованные дни отпуска. На каждого сотрудника берётся количество неиспользованных дней на отчётную дату. За год сотруднику положено 28 календарных дней, за месяц накапливается примерно 2,33 дня. Сюда же попадают перенесённые дни с прошлых периодов и дни, за которые уже выплачена компенсация. Ошибки в этом блоке: неверное округление, двойной учёт дней, забытые переносы.
Второй блок: средний дневной заработок. Считается по Постановлению Правительства № 540 от 24.04.2025 «Об особенностях порядка исчисления средней заработной платы»: заработок за 12 месяцев делится на 12 и на среднемесячное число календарных дней 29,3. Здесь самые частые ловушки: использование устаревшего значения 29,4 вместо 29,3, неверное включение премий (годовая премия включается без деления на 12 или с ним), исключение или включение лишних выплат, учёт неполных месяцев при повышении оклада.
Третий блок: страховые взносы. На сумму резерва начисляются взносы по единому тарифу, в общем случае 30% (в пределах предельной базы, охватывает пенсионное, медицинское и социальное страхование) плюс взносы на травматизм от 0,2% до 8,5% в зависимости от класса профессионального риска. Ошибка здесь одна из самых дорогих: модель или человек забывает этот блок целиком, и резерв занижается примерно на четверть.
Ещё один элемент методологии, который добавляет путаницы: резерв можно считать балансовым методом (на отчётную дату по фактическим остаткам дней) или методом интервалов (по каждому будущему месяцу с учётом планируемых выходов в отпуск). Оба метода законны, но дают разные суммы, и если в учётной политике закреплён один, а в файле реализован другой, расхождение с «правильной» цифрой будет стабильным и системным.
Для большинства компаний с численностью до 150-200 человек балансовый метод проще и прозрачнее, и именно его я рекомендую для проверки через нейросеть: он опирается на фактические данные, которые легко выгрузить из кадровой системы, и не требует прогнозов. Дальше в статье все промпты настроены на балансовый метод, если не указано иное.
Почему Excel ошибается в расчёте резерва: семь типовых причин
Прежде чем перекладывать проверку на нейросеть, стоит честно разобрать, где ошибается Excel. Это важно по двум причинам. Первая: если вы не знаете типовых ошибок файла, нейросеть будет проверять неизвестно что. Вторая: часть ошибок, которые приписывают нейросети, на самом деле пришли из файла, который она честно проверила.
Ошибка 1. Смещение строк при копировании формул. Самая частая и самая коварная. Формула тянется на 50 строк, в середине одна строка вставляется или удаляется, и ссылки начинают съезжать на соседние ячейки. Резерв посчитан по чужим остаткам дней, а визуально файл выглядит нормально.
Ошибка 2. Жёстко прописанные значения вместо формул. Кто-то однажды заменил формулу на число «чтобы не пересчитывалось». При следующем обновлении данных это число не обновляется, и расхождение растёт молча.
Ошибка 3. Устаревшая ставка взносов в справочнике. Ставка страховых взносов менялась неоднократно, и в старом файле может стоять прежняя цифра. Файл считает «правильно по своим данным», но данные устарели.
Ошибка 4. Неверные ссылки на листы. Резерв собирает данные из листа с остатками дней и из листа с заработком. Ссылки настроены на конкретные диапазоны, при добавлении строк диапазон не расширяется, и часть сотрудников выпадает из расчёта.
Ошибка 5. Округление копеек при суммировании. Excel хранит полные значения, а показывает округлённые. При суммировании округлённых значений итог может разойтись на несколько копеек или рублей, и при проверке это выглядит как ошибка, хотя по сути это особенность отображения.
Ошибка 6. Отсутствие контроля версий. Файл резерва существует в трёх копиях: рабочая, черновая и «финальная точно». Никто не помнит, какая актуальна. Расчёт может вестись в старой версии, а в отчётность попадать из новой.
Ошибка 7. Ручной ввод без защиты. Ячейки с формулами не защищены, при заполнении данных кто-то случайно перезаписывает формулу значением. Ошибка обнаруживается через кварталы, когда сумма перестаёт сходиться.
Обратите внимание на общую черту всех семи ошибок Excel: они механические и стабильные. Файл ошибается одинаково каждый раз, потому что ошибается его структура. Такую ошибку можно найти аудитом формул, и это первая задача для нейросети, с которой она справляется отлично. Про то, как это устроено, я подробно рассказываю в статье про бесплатные нейросети вместо Excel, здесь же главное: Excel ошибается в структуре, а не в логике.
Что ChatGPT делает хорошо в проверке резерва
У ChatGPT в этой задаче три сильные стороны, и они дополняют слабые места Excel.
Первое: построчный пересчёт больших таблиц через код. Если в промпте стоит требование «считай в коде на Python», ChatGPT Plus запускает код-интерпретатор и реально пересчитывает каждую строку, а не оценивает таблицу на глаз. Для файла на 100-200 строк это означает настоящую независимую арифметику с показом хода расчёта. Я подробно разбирала механику этого подхода в статье про ошибки финансиста в нейросетях, здесь просто подчеркну: без этого требования результат нейросети нельзя считать расчётом, это лишь оценка.
Второе: аудит формул Excel. Модель читает формулы в файле и объясняет, что каждая делает, на какие ячейки ссылается и где могут быть логические дыры. Человек, который не писал этот файл, тратит на такой разбор часы. Нейросеть находит смещённые диапазоны, жёстко прописанные значения и ссылки на чужие листы за пару минут.
Третье: объяснение расхождений человеческим языком. Когда пересчёт не сходится с файлом, ChatGPT формулирует причину так, что её можно показать главбуху или аудитору: «в строке 17 остаток дней взят из ячейки C18, где стоит значение сотрудника из соседнего подразделения». Это превращает проверку из «что-то не сходится» в конкретный список действий.
Ещё один плюс, который редко называют: нейросеть не устаёт. Ручная сверка резерва на 100 человек к концу третьего часа превращается в скольжение глазами по цифрам. Модель обрабатывает строку 1 и строку 150 с одинаковым вниманием, если промпт требует построчного вывода.
Проверка резерва логично ложится в более широкий контур расчётов, который я описываю в статье про рекуррентные начисления и агентов для проводок. Резерв на отпуска там как раз упоминается как классический рекуррентный расчёт с переменной базой, которая подтягивается из кадрового учёта.
Где нейросеть ошибается чаще всего: шесть типовых ошибок
Теперь главное, ради чего написана эта статья. ChatGPT ошибается в расчёте резерва не там, где его обычно ловят, и не так, как Excel. У нейросети свой профиль ошибок, и он опасен тем, что ответ выглядит уверенным и правдоподобным.
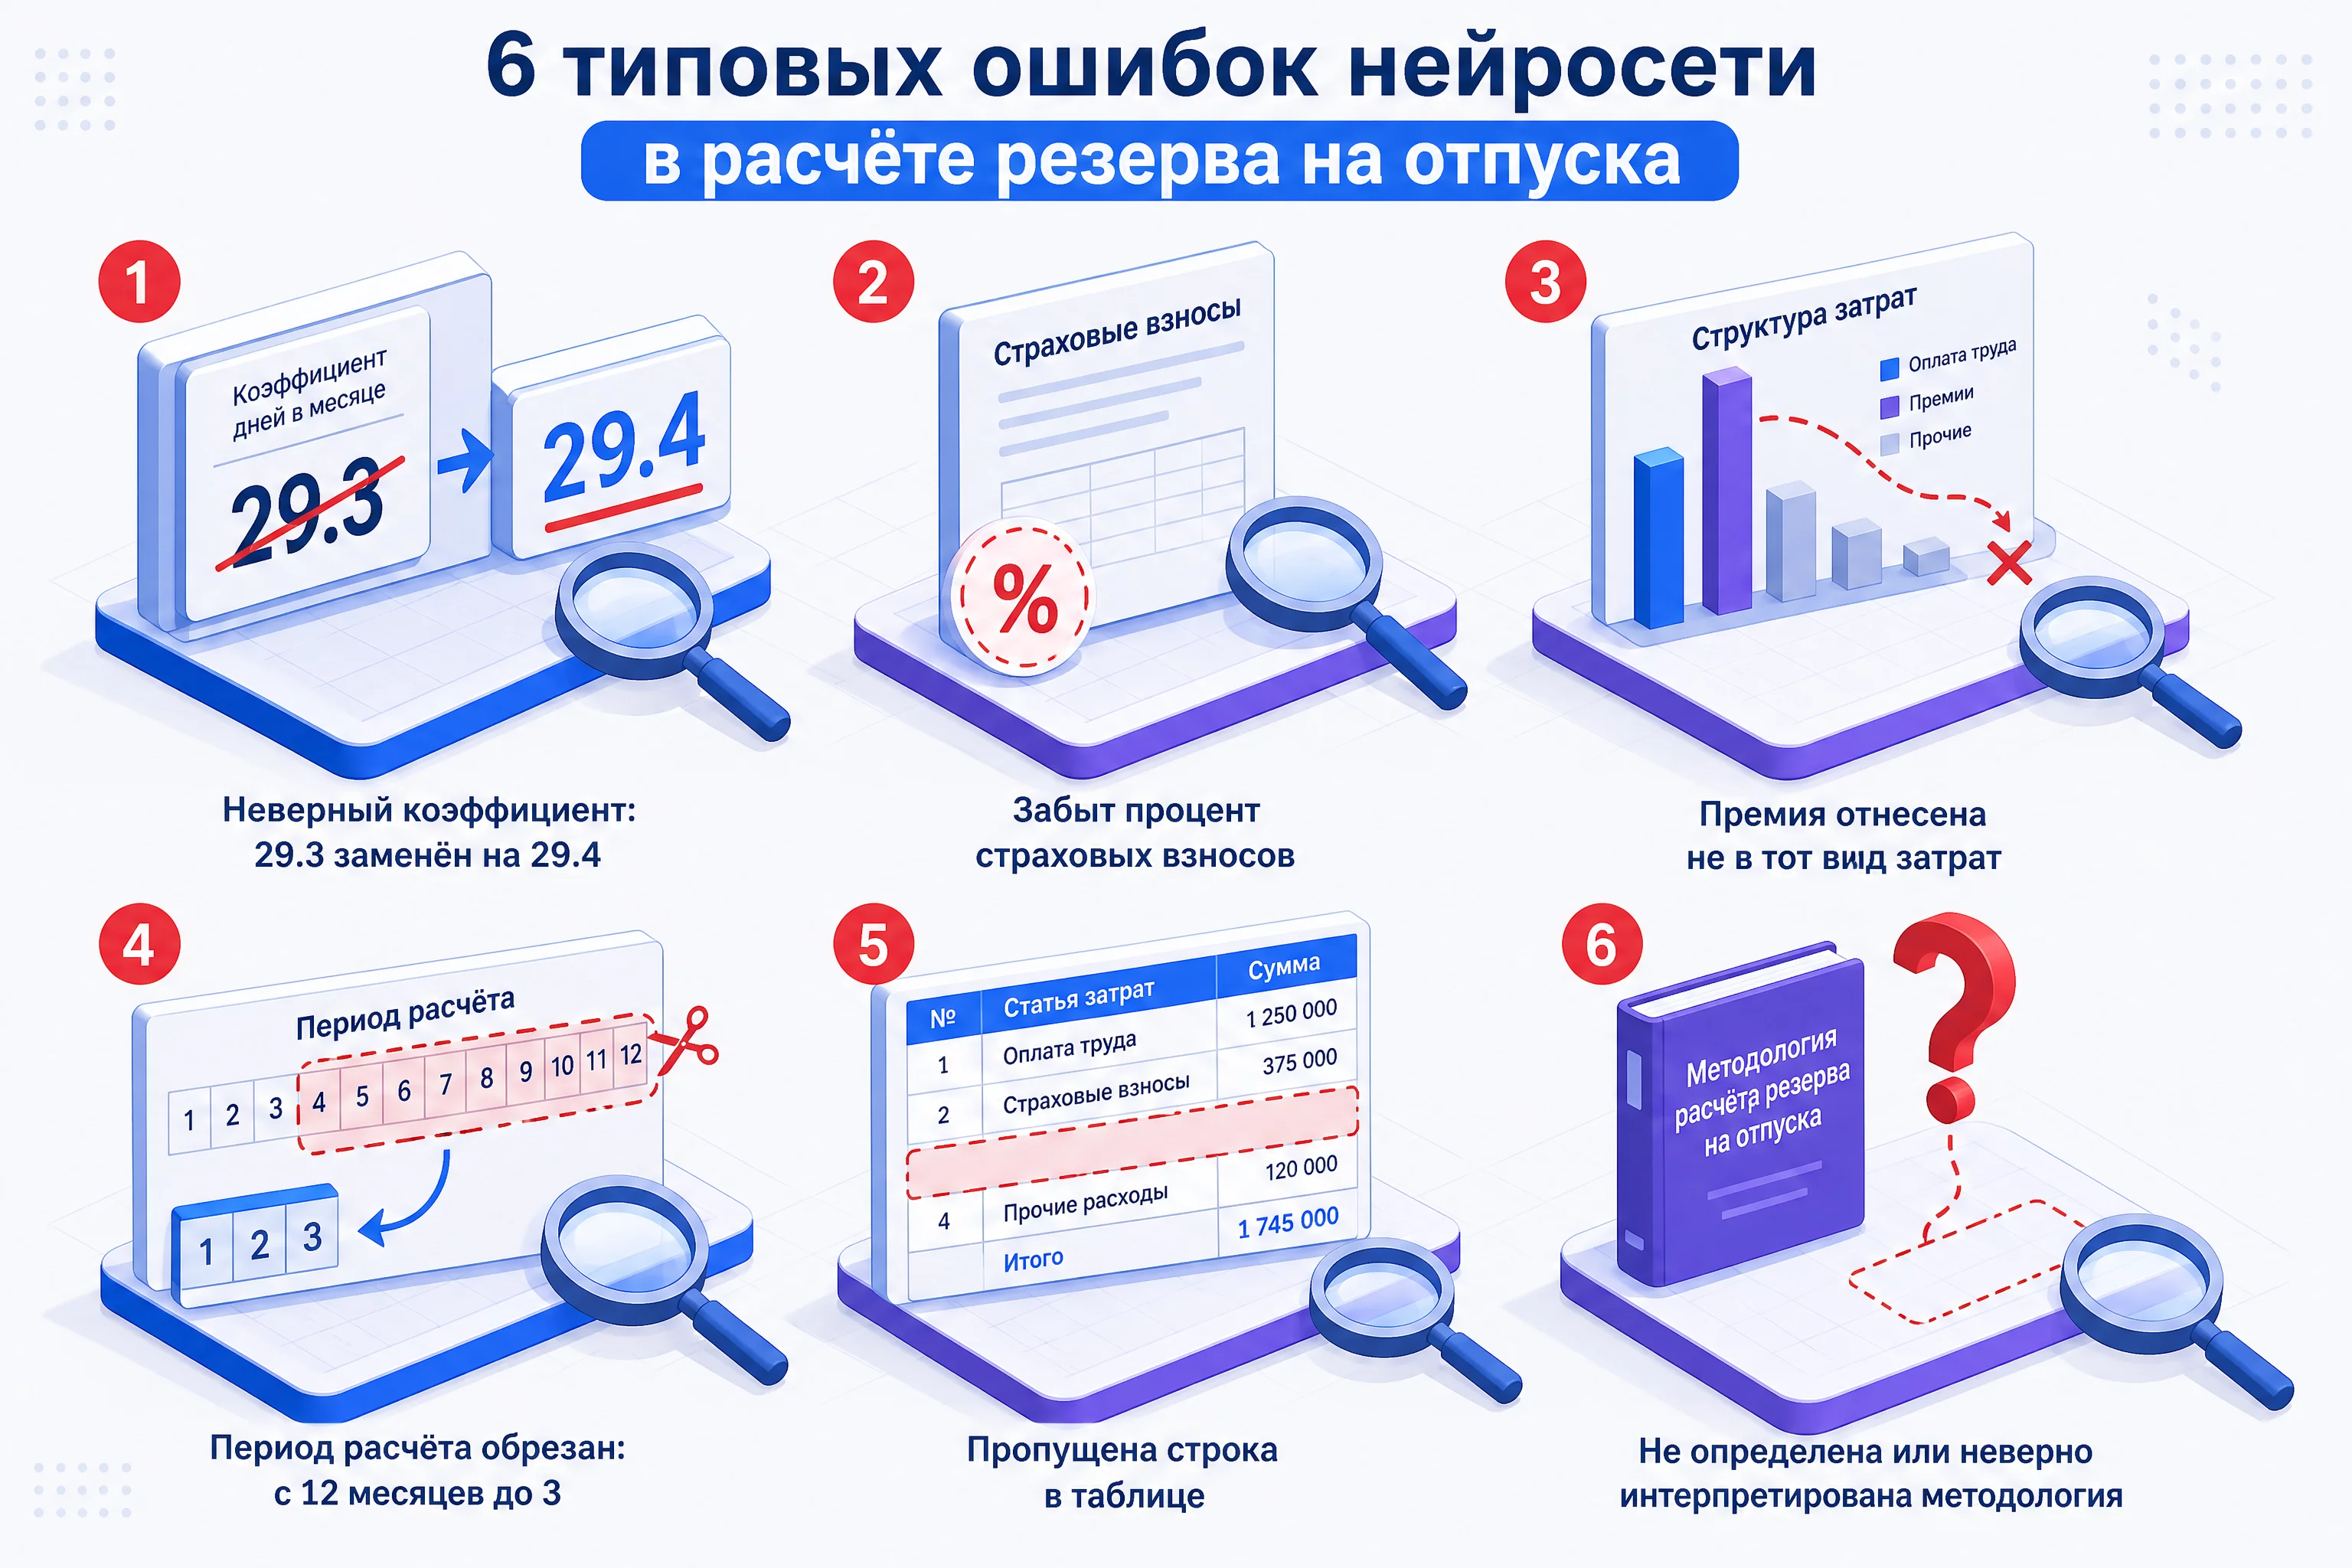
Ошибка 1. Путаница коэффициента 29,3 и 29,4. Среднемесячное число календарных дней 29,3 действует с 2014 года, но в обучающих данных модели достаточно материала с прежним значением 29,4. Модель может взять старый коэффициент, посчитать «красивый» ответ и не заметить подмены. Разница между коэффициентами составляет около трети процента резерва: на одном человеке почти незаметно, но на сотню человек это уже ощутимая сумма, которая уходит в отчётность как незаметное расхождение.
Ошибка 2. Забытые страховые взносы. Самый дорогой тип ошибки. Модель считает произведение дней на средний заработок и останавливается, забывая добавить 30% взносов. Итог занижается примерно на четверть. Ошибка характерна тем, что ответ выглядит абсолютно логичным: сумма дней на заработок это ровно то, что и просили посчитать.
Ошибка 3. Неверное включение премий в средний заработок. Годовая премия в средний заработок включается как одна двенадцатая за каждый месяц расчётного периода, а не целиком за один месяц. Модель часто включает годовую премию полностью в месяц выплаты, завышая средний заработок в разы для этого месяца. Это заметно завышает резерв, в моей практике обычно на несколько процентов и выше.
Ошибка 4. Неполный расчётный период. Модель может молча взять не 12 месяцев, а последние 3 или 6, если так удобнее по данным или так «показалось правильным». Это частный случай известной особенности языковых моделей: они склонны подгонять проверку под собственное же промежуточное значение, а не под исходное условие, и не замечают накопленную ошибку. С резервом происходит ровно то же самое: модель берёт неполные данные и уверенно считает по ним.
Ошибка 5. Игнорирование отдельных строк таблицы. На таблице в 150 строк модель может «не заметить» несколько сотрудников, особенно если у них нулевые остатки дней или пустые ячейки в заработке. В ручной проверке человек хотя бы видит пропуск строки, модель выдаёт результат, в котором пропущенные люди просто отсутствуют, и это не бросается в глаза.
Ошибка 6. Применение чужой методологии. Если в чате всплыла память о прошлых диалогах (в новых версиях ChatGPT появилась долговременная память, которая сама формирует сводку из истории чатов), модель может применить метод интервалов, хотя у компании закреплён балансовый метод, или подтянуть устаревшие параметры из старого обсуждения. Ответ будет методологически правильным для другого файла.
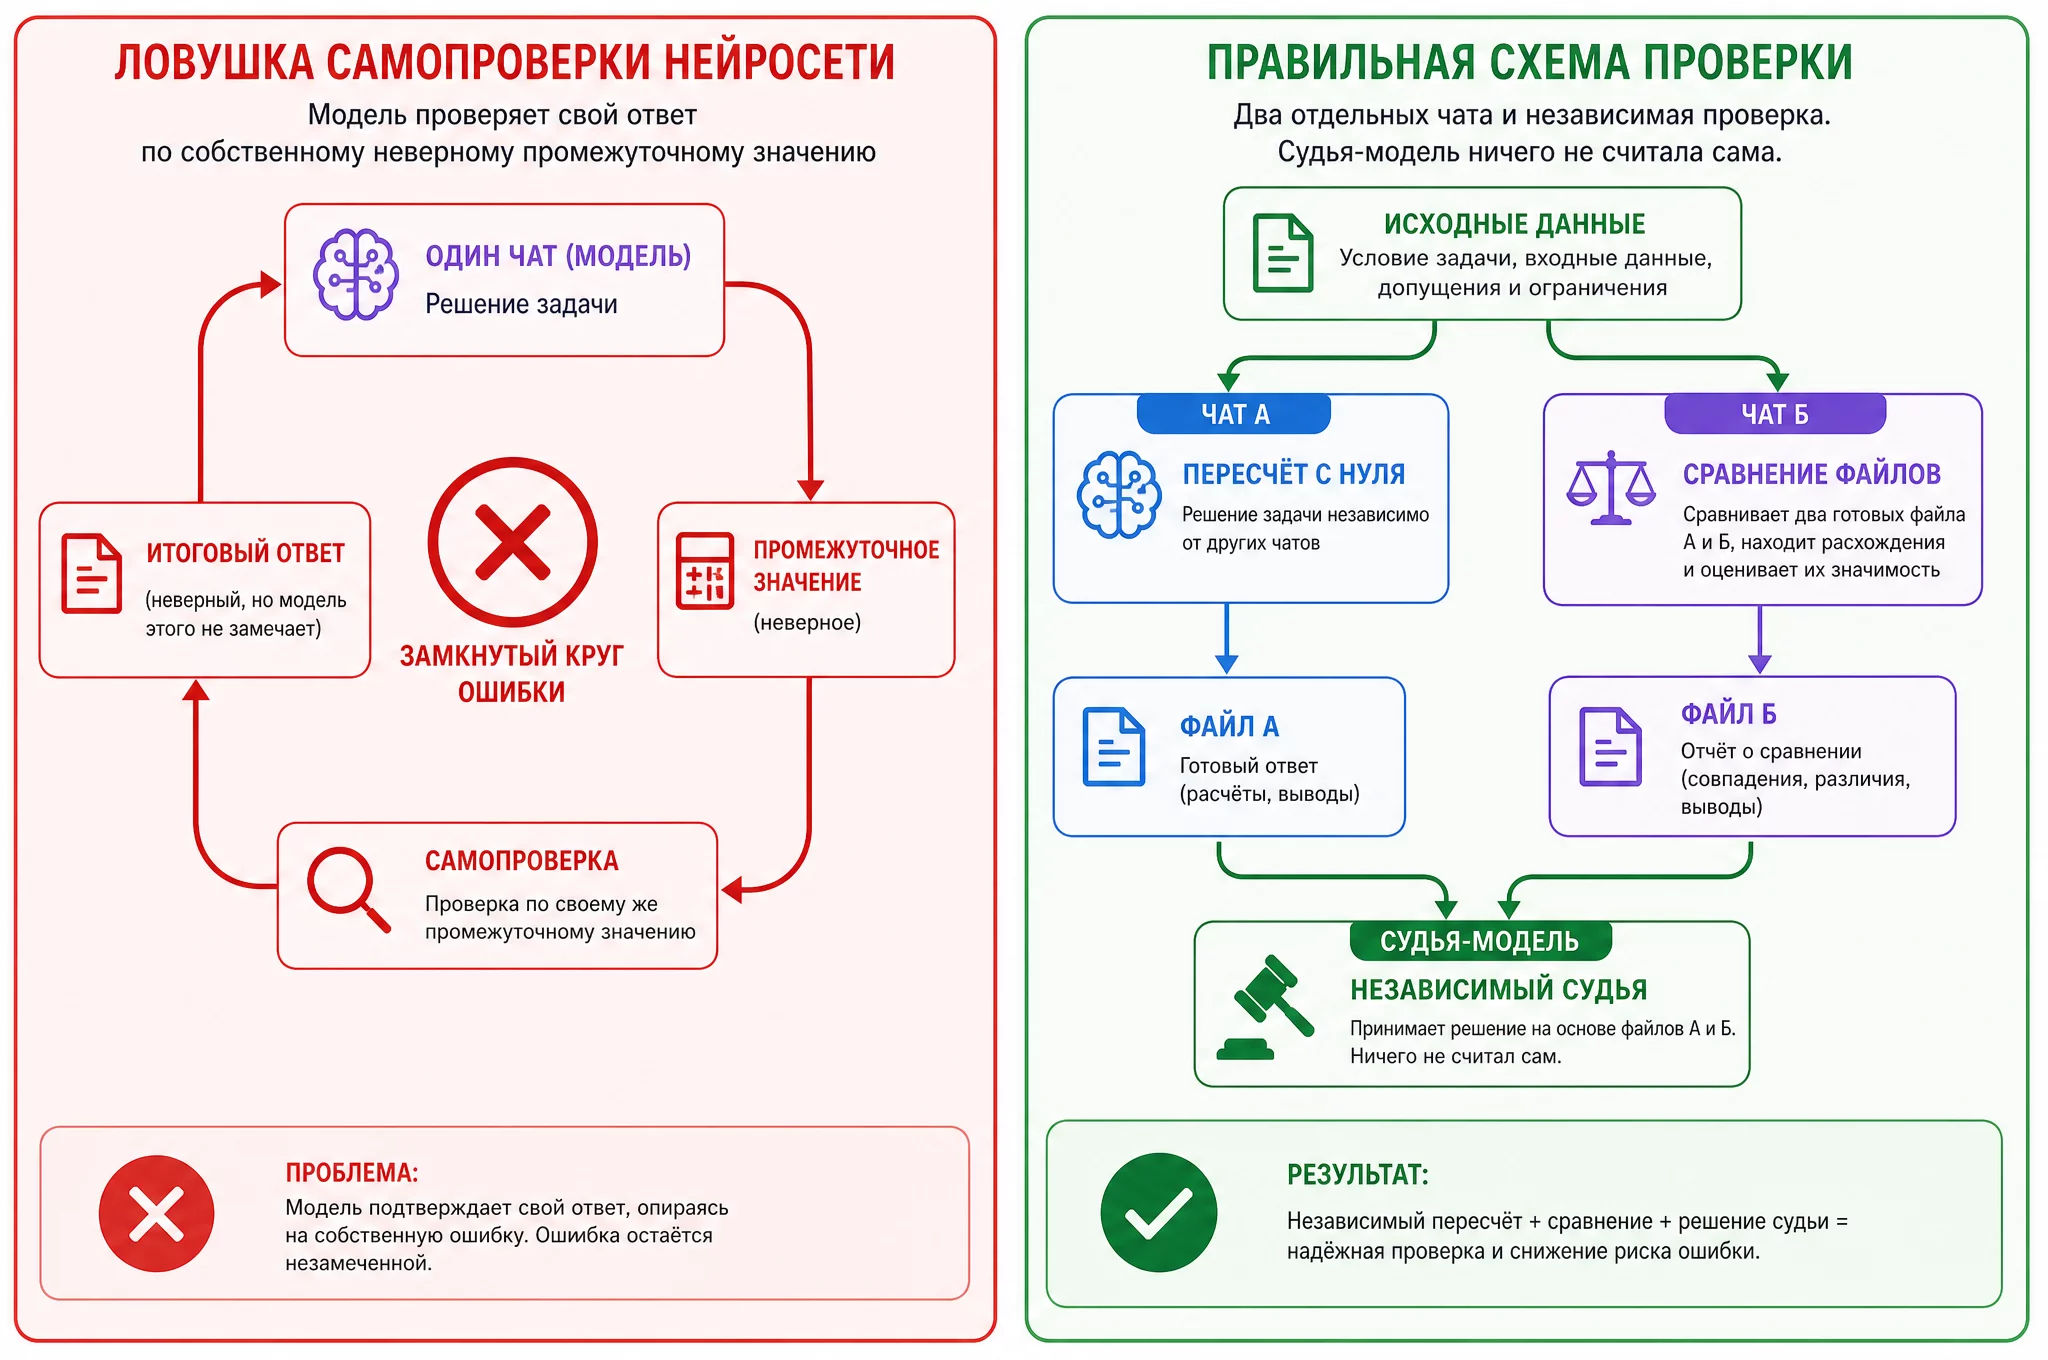
Все шесть ошибок объединяет одно: модель не сомневается. Она выдаёт уверенный ответ с ровной интонацией, и проверить его можно только извне. Поэтому ключевой принцип проверки резерва через нейросеть звучит так: никогда не просите модель проверить собственный расчёт, всегда запускайте независимый пересчёт с нуля в отдельном чате.
Ошибка самопроверки: почему «проверь ещё раз» не работает
Про эту ловушку стоит рассказать отдельно, потому что она ломает самую распространённую схему использования нейросети для проверки. Бухгалтер загружает файл, получает расчёт, просит «проверь, всё ли верно», получает ответ «всё верно» и успокаивается. Это самая дорогая иллюзия в работе с нейросетями.
Механика такая: когда модель просят проверить её же расчёт, она сверяет ответ со своими промежуточными значениями, а не с исходными данными. Если на входе была ошибка (например, неполный период или неверный коэффициент), промежуточное значение тоже неверное, и проверка сходится с ним. В тестах на многошаговых вычислениях именно так выглядит большинство провалов: модель перепутала одно значение из условия, подогнала под него весь расчёт, и все её внутренние проверки сошлись, потому что сверялись с той же ошибкой, а не с условием.
С резервом на отпуска это выглядит так. Вы просите модель проверить файл, модель пересчитывает, но берёт неполный период для среднего заработка, получает свою сумму, сверяет с вашей, видит расхождение и «объясняет» его погрешностью округления. На самом деле расхождение системное, но модель не знает об этом, потому что проверяла себя на собственном укороченном отрезке.
Второй вариант той же ловушки: модель в ответ на «проверь» не пересчитывает вообще, а подтверждает то, что видит в файле, потому что в её понимании «проверить» значит «посмотреть и сказать, что всё в порядке». Без явного требования пересчитать с нуля и показать ход расчёта вы получаете не проверку, а вежливое согласие.
Есть и обнадёживающая часть. Когда проверку принудительно делают независимой, точность резко растёт. В тех же тестах модель с принудительной внешней верификацией набирала в разы больше правильных ответов, чем та же модель в свободном режиме, где она проверяла себя сама. Вывод простой: нейросеть отлично проверяет чужой расчёт, но почти бесполезна как судья собственному.
Правило, которое я вкладываю ученицам курса и которое снимает большинство проблем: расчёт и проверка это два разных чата. В чате А модель считает с нуля по исходным данным. В чате Б модель сравнивает два готовых результата: ваш файл и результат чата А. Модель в чате Б никогда не видела ни одного из расчётов в процессе, поэтому у неё нет любимчика, и она честно находит расхождения.
Разберу, как это выглядит по шагам, на примере файла на 80 сотрудников.
Чат А, пересчёт. Открываете новый чат, вставляете методологию и исходные данные без итога. Модель считает в коде на Python, показывает построчную таблицу и сводку. Копируете результат в отдельный файл «пересчёт».
Чат Б, сравнение. Открываете ещё один новый чат и вставляете две вещи: итог вашего файла и итог пересчёта, а также оба файла построчно. Используете промпт 7 из этой статьи. Модель сопоставляет строки по номерам сотрудников и показывает топ-10 расхождений с вероятными причинами.
Разбор. Смотрите топ-10 расхождений. Для каждого решаете: это ошибка файла, ошибка методологии или ошибка пересчёта. Если одно и то же расхождение повторяется из раза в раз, оно почти наверняка системное, и его источник живёт в файле, а не в нейросети.
Фиксация. Записываете в заметку тип ошибки, где найдена, чем исправлена. Через два-три месяца у вас накопится карта типовых ошибок именно вашей компании, и проверка будет занимать заметно меньше времени, потому что вы будете смотреть только на знакомые точки риска.
Вся схема держится на одном условии: ни в один из чатов не попадает готовый расчёт «противника». Чат А не видит ваш файл, чат Б ничего не считал сам. Судья всегда третий, который не участвовал в расчёте, и именно поэтому ему можно верить.
Сравнительная таблица: Excel против ChatGPT для проверки резерва
Сводим всё в одну таблицу. Актуально на август 2026 года. Сравниваю не «что лучше в принципе», а что каждый инструмент делает в задаче проверки резерва на отпуска.
| Критерий | Excel | ChatGPT (GPT-5.5) | Связка Excel + ChatGPT |
|---|---|---|---|
| Где хранить расчёт | Лучший вариант, формулы прозрачны | Не предназначен для хранения | Расчёт в Excel, нейросеть как внешний аудитор |
| Арифметика на больших таблицах | Точная, если формулы верны | Точная только с требованием «считай в коде на Python» | Пересчёт в Excel, дублирующий пересчёт в ChatGPT |
| Тип ошибок | Механические: смещение строк, устаревшие ссылки, округление | Контекстные: 29,3 вместо 29,4, забытые взносы, неполный период | Ошибки двух типов ловятся независимо друг от друга |
| Аудит формул | Вручную, часами, нужен автор файла | Быстро объясняет, что делает каждая формула | Excel хранит, ChatGPT объясняет логику |
| Проверка методологии | Не проверяет, файл реализует то, что в нём написано | Может сверять с текстом учётной политики | Политика в промпте, файл сверяется с ней |
| Самопроверка | Не применимо | Ловушка: подтверждает собственный неверный ответ | Нейросеть не проверяет свой расчёт, сравнивает два внешних файла |
| Стоимость | Уже есть в компании | Платная подписка или бесплатные тарифы с лимитами | Плюс одна подписка к уже имеющемуся Excel |
| Контроль версий | Проблема: копии файлов | Промпт фиксирует методологию, легко воспроизводится | Промпт как документированная методология |
Короткий вывод из таблицы: спорить, что лучше, Excel или ChatGPT, бессмысленно, потому что они ошибаются в разных местах и в паре закрывают слабости друг друга. Excel ошибается в структуре файла, ChatGPT в контексте расчёта. Связка ловит оба типа, если проверка построена по правилу «расчёт и проверка в разных чатах».
Для полноты картины добавлю про остальные модели. Claude Sonnet 4.6 аккуратнее всех работает с текстом учётной политики и реже выдумывает нормативку, для разбора методологии он удобнее ChatGPT. Gemini 2.5 неплохо считает таблицы и доступен бесплатно с ограничениями, на небольшой штат его хватает. DeepSeek V3.2 бесплатный и показывает ход рассуждения, что удобно для проверки, но в России его я рекомендую только с обезличенными данными. Подробнее про сравнение моделей для бухгалтерских задач я писала в статье ChatGPT, Claude и другие в тесте для бухгалтерии.
Промпты: от независимого пересчёта до аудита формул
Все промпты ниже можно копировать и адаптировать под свой файл. Они выстроены в порядке рабочего процесса: сначала слепой пересчёт с нуля, потом проверка каждого блока, потом аудит формул и анализ динамики. В каждом промпте места для ваших данных обозначены квадратными скобками.
Расчёт резерва опирается на те же данные, что и расчёт отпускных и зарплаты, поэтому если вы уже работали с расчётом зарплаты и кадровым учётом через ChatGPT, часть выгрузок у вас уже готова: остатки дней, заработок за 12 месяцев, исключаемые выплаты. Остаётся только собрать их в одну таблицу под промпты ниже.
Промпт 1. Независимый пересчёт резерва с нуля (слепой режим)
Это главный промпт всей статьи, и он должен запускаться в новом, чистом чате. Модель не видит ни ваш файл с резервом, ни предыдущие расчёты. Только исходные данные и методологию.
Ты бухгалтер-аудитор с опытом расчёта оценочных обязательств по ПБУ 8/2010.

Я даю тебе исходные данные по сотрудникам компании и методологию
расчёта резерва на отпуска. Никакого готового результата в чате нет,
я хочу получить независимый расчёт с нуля.

Методология (балансовый метод):
1. Для каждого сотрудника берём количество неиспользованных дней
   отпуска на отчётную дату.
2. Средний дневной заработок считаем по Постановлению Правительства
   № 540 от 24.04.2025: начисленный заработок за 12 месяцев / 12 / 29,3.
3. Резерв по сотруднику = дни отпуска х средний дневной заработок.
4. К сумме резерва добавляем страховые взносы 30% плюс взнос на
   травматизм [укажи свой процент, например 0,2%].

Требования к расчёту:
- Считай в коде на Python, покажи код и результат по каждому
  сотруднику.
- Используй только данные из моего файла, ничего не додумывай.
- Если для сотрудника не хватает данных, напиши это отдельной
  строкой, а не пропускай его молча.
- Итог представь таблицей: номер сотрудника, дни, средний заработок,
  резерв без взносов, взносы, резерв итого.
- В конце сводку: итоговая сумма резерва и количество сотрудников.

Данные (CSV):
[вставить таблицу: номер сотрудника, подразделение, неиспользованные
дни, заработок за 12 месяцев, исключаемые выплаты]
Почему этот промпт работает: модель получает только исходные данные, у неё нет вашего ответа, который она могла бы «подтвердить». Требование считать в коде убирает угадывание, требование не пропускать строки закрывает ошибку с потерянными сотрудниками. Если ваш файл правильный, расхождение с его итогом будет нулевым или в пределах копеечного округления. Если расхождение есть, дальше разбираем по блокам.
Промпт 2. Проверка среднего дневного заработка
Первый блок, который стоит проверить отдельно. Здесь живут ошибки с коэффициентом 29,3, премиями и неполным периодом.
Ты аудитор, проверяешь расчёт среднего дневного заработка для
резерва на отпуска.

Для каждого сотрудника у меня есть:
- заработок за каждый из 12 месяцев расчётного периода
- суммы, исключаемые из расчёта (больничные, отпускные, командировки)
- годовые и квартальные премии с месяцем начисления
- дата повышения оклада, если было

Проверь расчёт по Постановлению Правительства № 540 от 24.04.2025:
1. Правильный ли расчётный период (12 месяцев).
2. Корректно ли исключены выплаты, которые не входят в средний.
3. Правильно ли включены премии: годовая как 1/12 за каждый месяц
   периода, квартальная по фактическому времени.
4. Учтено ли повышение оклада с коэффициентом индексации.
5. Используется ли коэффициент 29,3, а не устаревший 29,4.

Для каждой найденной ошибки укажи: номер сотрудника, что не так,
какая сумма должна быть вместо текущей, на сколько процентов
расходится средний заработок.

Считай в коде на Python и покажи ход расчёта по 3-4 примерам.
Данные:
[вставить таблицу]
Отдельно про премии: это самый частый источник завышения резерва. Годовая премия, начисленная в январе за прошлый год, в средний заработок включается не целиком в январе, а как одна двенадцатая в каждый месяц расчётного периода. Модель без явной инструкции часто включает её полностью в месяц начисления, и средний заработок этого месяца вырастает в разы.
Промпт 3. Проверка остатков неиспользованных дней отпуска
Второй блок, ошибки в котором дают пропущенные строки и неверные суммы из-за округления дней.
Ты проверяешь расчёт остатков неиспользованных дней отпуска на
отчётную дату [дата].

У меня есть данные по каждому сотруднику:
- количество дней отпуска, заработанное за текущий рабочий год
- использованные дни за период
- перенесённые дни с прошлых периодов
- дни, за которые уже выплачена компенсация при увольнении

Проверь для каждого сотрудника:
1. Остаток = заработано + перенесено минус использовано.
2. Дни, за которые выплачена компенсация, не учтены повторно.
3. Округление дней корректное: не округляем в большую сторону
   произвольно, дробные дни допустимы в расчёте резерва.
4. Нет ли отрицательных остатков (признак двойного учёта).
5. Все ли сотрудники из списка присутствуют в расчёте, никто
   не пропущен.

Выведи таблицу: номер сотрудника, заработано, использовано,
перенесено, компенсировано, остаток. Отдельным списком покажи
строки с отрицательными остатками и подозрительными округлениями.
Считай в коде на Python.
Данные:
[вставить таблицу]
Промпт 4. Проверка страховых взносов в резерве
Третий блок, ошибка в котором стоит дороже всего, потому что забытые взносы занижают резерв примерно на треть.
Ты проверяешь расчёт страховых взносов в резерве на отпуска.

У меня есть:
- сумма резерва по каждому сотруднику без взносов
- применяемая ставка страховых взносов [30%]
- ставка взносов на травматизм [укажи, например 0,2%]

Проверь для каждого сотрудника:
1. Взносы = резерв без взносов х (ставка страховых + ставка на
   травматизм).
2. Не забыт ли блок взносов целиком.
3. Правильная ли итоговая ставка: 30% по единому тарифу страховых
   взносов в пределах предельной базы.
4. Нет ли округления, которое даёт расхождение больше копеек.

Выведи таблицу: номер сотрудника, резерв без взносов, взносы,
резерв с взносами. В конце сводку по всей сумме и отдельно
строкой «если бы взносы не начислялись, резерв был бы меньше на X».
Данные:
[вставить таблицу]
Промпт 5. Аудит формул Excel в файле расчёта
Это промпт для случая, когда подозрение падает на сам файл, а не на методологию. Модель разбирает формулы и объясняет, что реально делает файл.
Ты аудитор Excel-файлов с расчётом резерва на отпуска.

Загружаю файл [название] с расчётом. Он считается формулами,
но их логику никто не документировал.

Задача: проверить структуру файла, а не пересчитывать сумму.

1. Пройдись по всем формулам, которые участвуют в расчёте итога,
   и опиши, что каждая делает и на какие ячейки ссылается.
2. Найди места, где значение вставлено как число вместо формулы.
3. Найди ссылки, которые указывают на диапазон, не охватывающий
   все строки данных (например, суммируется 100 строк, а данных 120).
4. Найди формулы, скопированные со смещением: ссылки съехали
   на соседние строки.
5. Проверь, откуда берётся ставка страховых взносов: из ячейки
   или зашита в формулу числом.
6. Оцени, есть ли риск, что часть сотрудников выпадает из расчёта.

Выведи отчёт по каждому пункту: что найдено, какая строка или
ячейка, какой риск. Без исправлений, только аудит.
Файл:
[прикрепить Excel]
Этот промпт превращает файл, который «кто-то когда-то настроил», в прозрачный документ. Если файл большой и формул сотни, попросите модель идти по порядку и дать сводку в конце, чтобы не утонуть в деталях.
Промпт 6. Сверка резерва с прошлым периодом и анализ динамики
Резкое изменение суммы резерва между отчётными датами это сигнал, который стоит проверять отдельно. Иногда изменение закономерно (выросли зарплаты), иногда это ошибка (в прошлый раз забыли взносы).
Ты анализируешь динамику резерва на отпуска между отчётными датами.

У меня есть данные по двум периодам [период 1] и [период 2]:
- итоговая сумма резерва
- количество сотрудников в расчёте
- сумма резерва без взносов и отдельно взносы
- средний резерв на одного сотрудника

Задача:
1. Посчитай изменение итога в рублях и процентах.
2. Разложи изменение на факторы: изменение численности, изменение
   дней на сотрудника, изменение среднего заработка, изменение
   взносов.
3. Оцени, какие факторы объясняют большую часть изменения.
4. Если изменение больше 20%, а численность и зарплаты изменились
   незначительно, отметь это как аномалию и предложи, что проверить
   в первую очередь.

Считай в коде, покажи расчёт факторов. Выведи вывод одним абзацем,
чтобы его можно было показать главбуху.
Данные по периодам:
[вставить таблицы]
Такая сверка ловит системные ошибки, которые «сидят» в файле несколько периодов. Если в прошлом квартале забыли взносы, динамика покажет резкий рост резерва в этом квартале при стабильной численности, и это станет поводом разобраться, а не «принять как есть».
Промпт 7. Обратный поиск: от расхождения к строке
Когда итоги не сходятся, а где именно, непонятно, работает обратный поиск: модель берёт ваш итог, независимый итог и ищет строки, которые объясняют разницу.
У меня есть два итога резерва на отпуска за [период]:
- мой файл: [сумма]
- независимый пересчёт: [сумма]
- расхождение: [сумма и процент]

У меня есть оба файла построчно (мой расчёт и пересчёт).

Задача: найти, какие именно строки объясняют расхождение.
1. Сопоставь строки двух файлов по номеру сотрудника.
2. Для каждой строки посчитай разницу в рублях.
3. Отсортируй строки по размеру расхождения, покажи топ-10.
4. Для каждой из топ-строк объясни вероятную причину: разные дни,
   разный средний заработок, пропущенная строка, разные взносы.
5. Посчитай, сколько процентов общего расхождения объясняют топ-10
   строк.

Выведи таблицу: номер сотрудника, мой расчёт, пересчёт, разница,
вероятная причина. В конце вывод, в каком блоке (дни, заработок,
взносы) сосредоточено большинство расхождений.
Файлы:
[прикрепить оба]
Этот промпт экономит больше всего времени, потому что убирает просмотр всех 150 строк вручную. Модель сразу показывает, где сосредоточены расхождения, и вы идёте проверять конкретные места, а не «всё подряд».
Промпт 8. Генерация проводок по резерву
Когда резерв посчитан и проверен, встаёт вопрос проводок. Модель помогает сформировать проводки и проверить, что счета затрат соответствуют подразделениям.
Ты бухгалтер, формируешь проводки по начислению резерва на отпуска
по ПБУ 8/2010.

У меня есть резерв по подразделениям за [период]:
[вставить таблицу: подразделение, сумма резерва]

Сформируй проводки: Дт счёт затрат Кт 96. Счёт затрат укажи по
подразделению:
- производственные подразделения: 20
- общехозяйственные: 26
- коммерческие: 44

Проверь:
1. Суммы проводок в сумме равны итоговому резерву.
2. Счета затрат соответствуют типу подразделения.
3. Нет ли дублей проводок по одному подразделению.
4. Если резерв начисляется ежемесячно, а не разово, предложи
   разбивку по месяцам.

Выведи таблицу проводок: счёт Дт, счёт Кт, подразделение, сумма.
В конце сверь итог с общей суммой резерва.
Данные:
[вставить таблицу]
Про начисление резерва и его рекуррентный характер я подробно рассказываю в статье про рекуррентные проводки и их автоматизацию, там же есть промпты для равномерного списания и корректировок.
Промпт 9. Объяснение расхождения руководству
Когда расхождение найдено и причина ясна, нужно коротко и понятно объяснить ситуацию собственнику или аудитору. Модель помогает сформулировать объяснение без канцелярита.
Ты финансовый директор, объясняешь собственнику изменение резерва
на отпуска за [период].

Вводные:
- резерв вырос/уменьшился на [сумма] или [процент]
- причина 1: [например, рост зарплат на 8%]
- причина 2: [например, в прошлом периоде не начислены взносы,
  сейчас ошибка исправлена]
- влияние на прибыль: [сумма]

Напиши объяснение на 150-200 слов для собственника:
1. Что произошло с резервом и почему.
2. Это разовая корректировка или устойчивый тренд.
3. Как это влияет на прибыль и денежный поток.
4. Что будет дальше.

Тон: спокойный, конкретный, без канцелярита и без длинных
конструкций. Объясни так, будто собственник не бухгалтер.
Такое объяснение полезно не только для коммуникации, но и как самопроверка: если вы не можете объяснить расхождение одним понятным абзацем, значит, вы сами не до конца понимаете причину, и стоит копнуть глубже.
Промпт 10. Ежемесячный регламент проверки
Последний промпт превращает разовую проверку в регламент. Он фиксирует методологию и порядок действий, чтобы каждый месяц проверка проходила одинаково и ничего не забывалось.
Составь ежемесячный регламент проверки расчёта резерва на отпуска
для бухгалтерии на основе следующей методологии:

1. Балансовый метод по ПБУ 8/2010.
2. Формула: неиспользованные дни х средний дневной заработок
   (заработок за 12 месяцев / 12 / 29,3) + страховые взносы 30%
   и взнос на травматизм [процент].
3. Проверка в три этапа: слепой пересчёт в отдельном чате,
   проверка трёх блоков отдельно, аудит динамики с прошлым периодом.
4. Порог внимания: расхождение больше 0,1% от суммы резерва.

Оформи регламент так:
- частота и сроки (за N дней до отчётной даты)
- пошаговый порядок действий с указанием промптов
- ответственный за каждый шаг
- что делать при расхождении больше порога
- что фиксировать по итогам проверки в заметку

Формат: таблица шагов + краткие инструкции к каждому.
Такой регламент можно положить в папку бухгалтерии и передавать новому сотруднику. Он документирует методологию лучше, чем «файл, который настроил прежний бухгалтер», и снимает проблему контроля версий, о которой я писала в разделе про ошибки Excel.
Промпт 11. Проверка компенсации за неиспользованный отпуск при увольнении
Увольнения напрямую влияют на резерв: сотрудник уходит, дни ему компенсируются, и из базы резерва он выпадает. Если компенсация посчитана неверно, остаток дней в резерве тоже будет неверным, а вы будете искать причину не там.
Ты проверяешь расчёт компенсации за неиспользованный отпуск при
увольнении сотрудников за [период].

У меня есть данные по уволенным:
- количество неиспользованных дней отпуска на дату увольнения
- заработок за 12 месяцев до увольнения
- сумма выплаченной компенсации

Проверь для каждого уволенного:
1. Компенсация = неиспользованные дни х средний дневной заработок,
   где средний заработок считается по Постановлению Правительства
   № 540 от 24.04.2025.
2. Не забыты ли страховые взносы на сумму компенсации.
3. Корректно ли посчитаны дни: за последний рабочий год дни
   пропорциональны отработанным месяцам.
4. Не остался ли уволенный в базе резерва (он не должен
   продолжать учитываться в расчёте).

Выведи таблицу: номер сотрудника, дни, средний заработок,
компенсация, взносы, признак «учтён в резерве или нет».
Считай в коде на Python и покажи ход расчёта по 2-3 примерам.
Данные:
[вставить таблицу]
Эта проверка особенно актуальна при высокой текучке, когда база резерва меняется каждый месяц. Если компенсации посчитаны неверно, весь резерв «плывёт», а вы будете искать причину в среднем заработке, хотя она лежит в днях уволенных. Вместе с промптом 1 и промптом 3 эта проверка закрывает весь жизненный цикл дней отпуска: накопление, использование и компенсацию при уходе.
Сводная таблица ниже связывает каждый тип ошибки с промптом, который её ловит. Держите её под рукой, когда разбираете расхождения, она экономит время на поиск нужного промпта.
| Тип ошибки | Где живёт | Какой промпт ловит | Признак в данных |
|---|---|---|---|
| Забытые страховые взносы | Файл или методология | Промпт 4 | Итог ровно равен «дни х заработок» без надбавки |
| Неверный коэффициент 29,3 вместо 29,4 | Расчёт модели | Промпт 2 | Средний заработок завышен примерно на 0,34% |
| Неполный период для среднего заработка | Расчёт модели | Промпт 2 | Сумма заработка соответствует периоду короче 12 месяцев |
| Годовая премия включена целиком в один месяц | Расчёт модели | Промпт 2 | Средний заработок одного месяца резко выше остальных |
| Смещение строк при копировании формул | Файл Excel | Промпт 5 | Остатки дней у сотрудников подозрительно «похожи» на соседние |
| Пропущенные сотрудники | Файл или модель | Промпт 1 и 3 | Число строк в пересчёте больше, чем в вашем файле |
| Устаревшая ставка взносов в справочнике | Файл Excel | Промпт 4 и 5 | Итоговый процент взносов не совпадает с актуальным |
| Подтверждение собственной ошибки | Самопроверка модели | Промпт 1 в слепом режиме | Модель говорит «всё верно» без показа хода расчёта |
| Чужая методология (интервалы вместо балансового) | Модель | Промпт 1 с явной методологией | Сумма совпадает с методом интервалов, а не с балансовым |
Эту таблицу удобно хранить рядом с регламентом проверки. Когда расхождение найдено, сначала смотрите на признак, потом на промпт, и только потом на сами цифры.
Кейсы: три истории с цифрами
Теория ошибок хороша, но работает она только на реальных цифрах. Ниже три кейса из практики учениц школы. Имена и отрасль обезличены, суммы и время округлены: порядок цифр соответствует тому, что встречается в моей практике, у вас масштаб может отличаться.
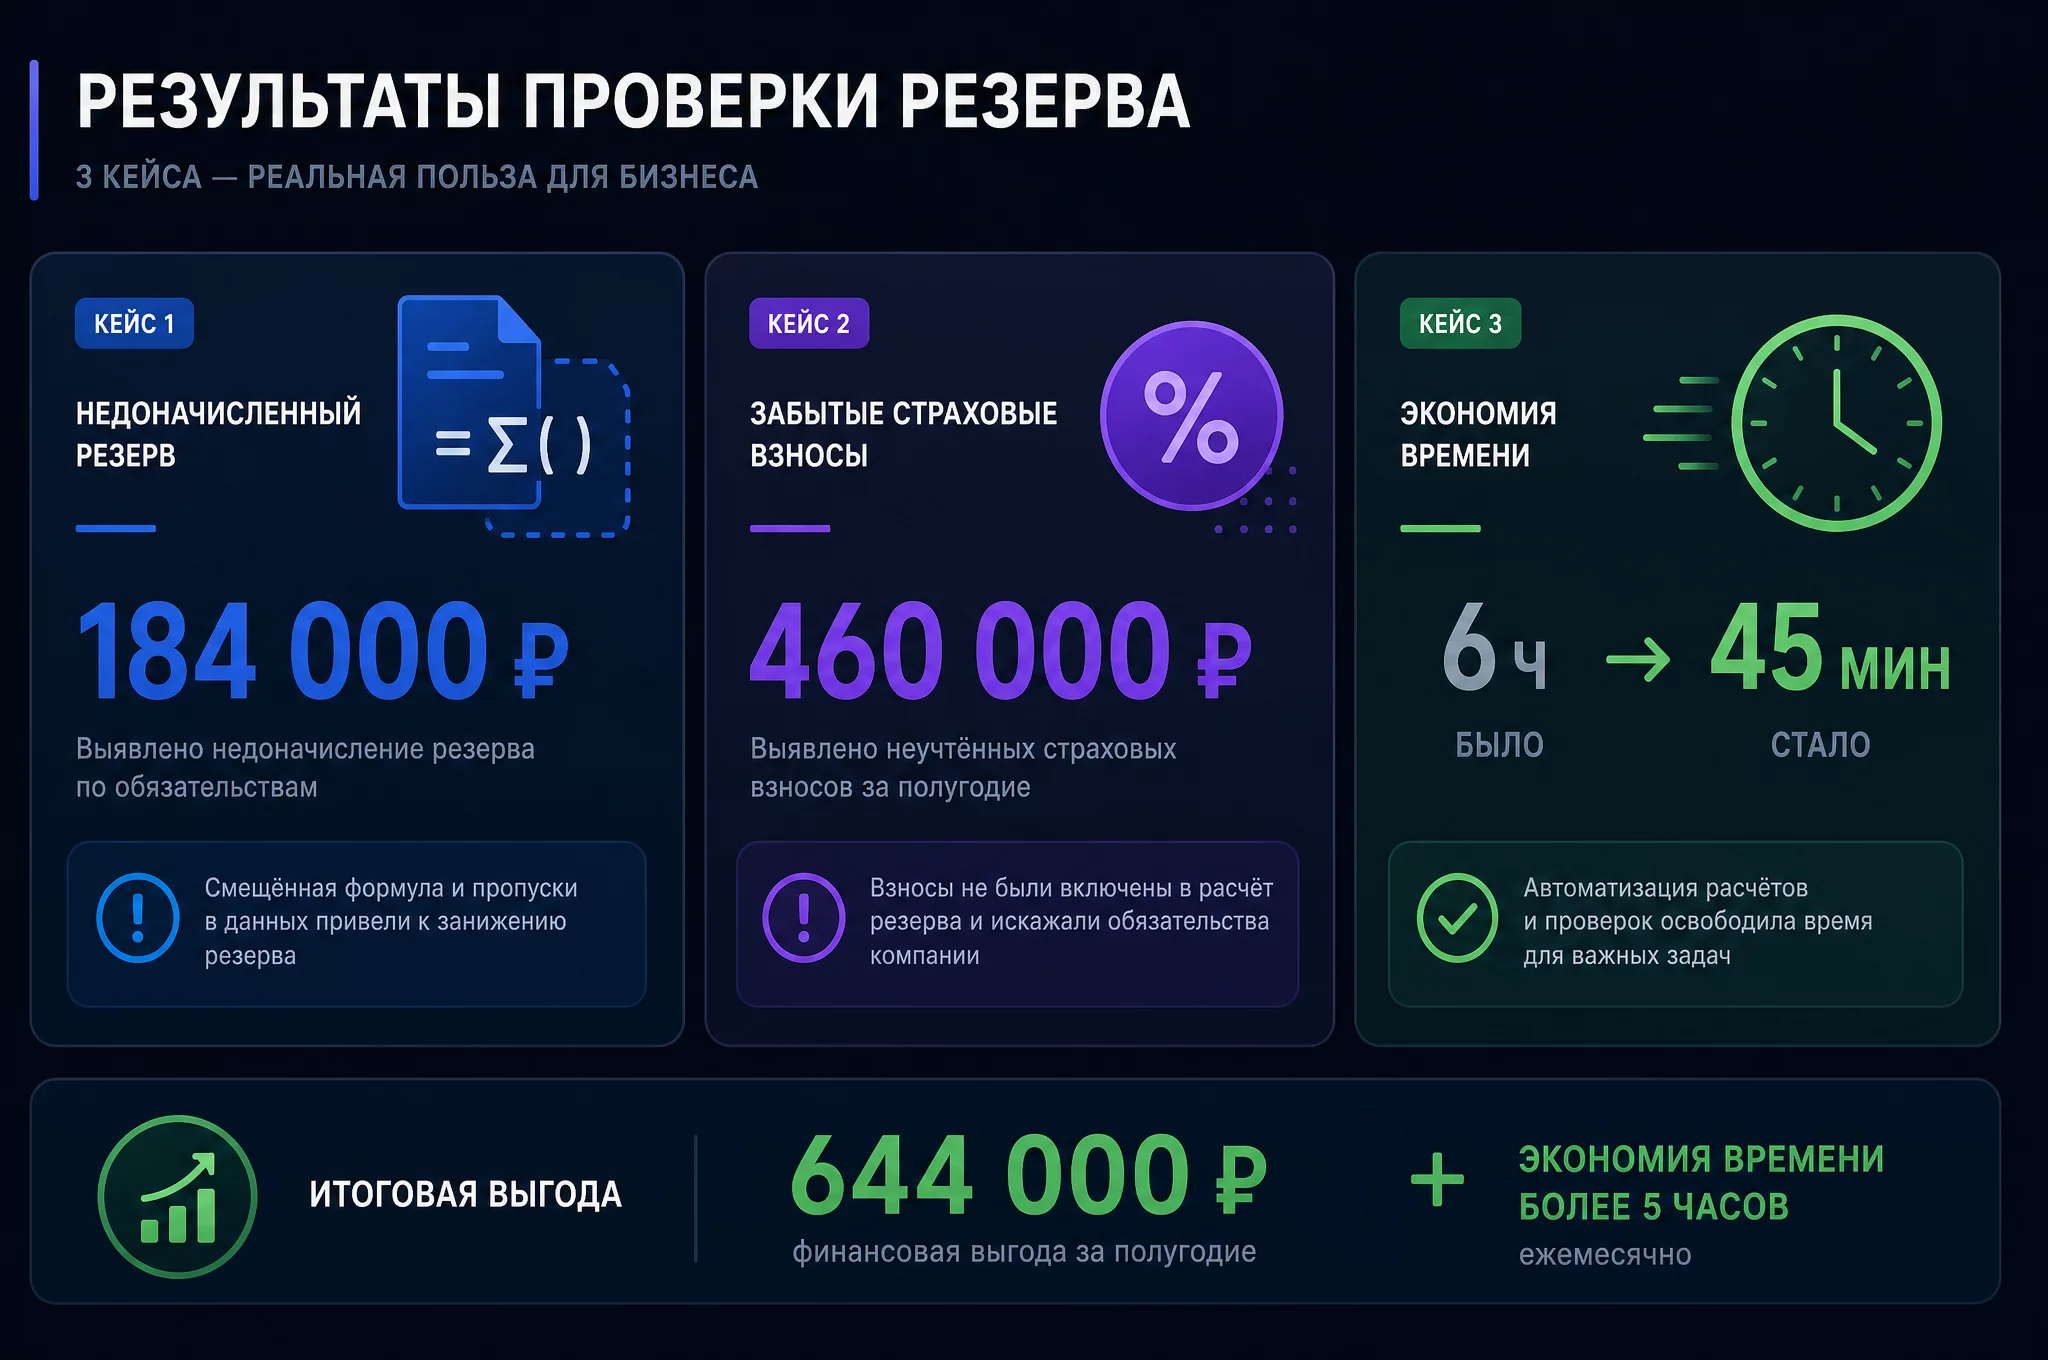
Кейс 1. Торговая компания, недоначисленный резерв на сотни тысяч рублей
Финансовый директор торговой компании со штатом около 60 человек обратилась с жалобой: «резерв каждый квартал не сходится на десятки тысяч, аудитор задаёт вопросы». Расчёт жил в Excel-файле, который настроил уволившийся несколько лет назад бухгалтер.
Было: квартальный пересчёт резерва занимал несколько часов, из них половина уходила на ручную сверку файла с выгрузкой из кадровой системы. Расхождение каждый раз «списывали на округление».
Что сделали: выгрузили из кадровой системы актуальные остатки дней и заработок за 12 месяцев по всем сотрудникам, обезличили данные и запустили слепой пересчёт в чистом чате по промпту 1. Затем сравнили результат с файлом через промпт 7.
Стало: пересчёт показал расхождение на сотни тысяч рублей за квартал. Обратный поиск локализовал причину: при копировании формул в файле строки сместились на несколько рядов, и части сотрудников одного подразделения резерв считался по чужим остаткам дней. В файле визуально всё выглядело ровно, поэтому ошибку не замечали годами. Исправление заняло меньше часа, после чего аудиторская проверка прошла без вопросов. Сама проверка через нейросеть заняла около часа вместо нескольких часов ручной сверки.
Кейс 2. Производственная компания, забытые страховые взносы
Главбух производственной компании со штатом более сотни человек попросила нейросеть проверить уже готовый расчёт резерва за полугодие. Первая модель в чате подтвердила: «расчёт верный». Что-то в этой уверенности смутило, и главбух запустила слепой пересчёт в отдельном чате.
Было: резерв считался в Excel, в формулах стояло простое произведение дней на средний заработок. Блок страховых взносов в файле отсутствовал полностью, хотя учётная политика требовала его начисления.
Что сделали: слепой пересчёт по промпту 1 показал сумму на десятки процентов больше файла. Промпт 4 для проверки взносов подтвердил: весь блок взносов отсутствует, а в первой модели самопроверка «подтвердила» неверный файл, потому что сравнивала его со своим таким же неполным расчётом.
Стало: в учёте доначислили резерв на сотни тысяч рублей за полугодие. Ошибка жила в файле несколько кварталов, и прошлые периоды пришлось пересматривать. Цена вопроса оказалась заметно больше, чем «пара тысяч на округлении», на которые её списывали. Урок из кейса: если итог подозрительно ровный и модель сразу говорит «всё верно», это повод запустить слепой пересчёт, а не повод успокоиться.
Кейс 3. Сеть кафе, сокращение времени проверки с целого дня до часа
В небольшой сети кафе со штатом около сотни человек резерв считался ежемесячно, потому что текучка персонала была высокой, и остатки дней менялись постоянно. На расчёт и проверку уходило до двух рабочих дней главбуха, и она уже подумывала отказаться от ежемесячного расчёта в пользу квартального.
Было: ежемесячная ручная проверка резерва занимала больше рабочего дня. Файл почти на сто строк просматривался вручную, каждая строка сверялась с кадровой выгрузкой.
Что сделали: настроили три промпта: слепой пересчёт, проверку дней, проверку среднего заработка. Методологию зафиксировали в регламенте (промпт 10). Раз в месяц главбух выгружает данные, запускает три проверки и разбирает флаги.
Стало: полный цикл занимает около часа, из них большая часть это выгрузка данных и разбор нескольких флагов. За первые месяцы проверка дополнительно нашла несколько ошибок, которые в прежнем режиме ушли бы в отчётность: неверно перенесённые дни у сотрудниц, устаревшая ставка взноса на травматизм в справочнике и задвоение компенсации при увольнении в одном из месяцев. Экономия времени порядка рабочего дня в месяц при ежемесячном расчёте.
Чек-лист: как проверять резерв через нейросеть
Собираю весь процесс в один чек-лист, который можно распечатать и повесить над столом. Пять шагов, каждый с конкретным действием.
Шаг 1. Подготовьте исходные данные. Выгрузите из кадровой системы и Excel-файла три списка: остатки неиспользованных дней, заработок за 12 месяцев с разбивкой по месяцам и суммы, исключаемые из расчёта. Обезличьте: номера вместо ФИО, без паспортных данных и СНИЛС.
Шаг 2. Запустите слепой пересчёт в новом чате. Не показывайте модели ваш итог. Дайте только данные и методологию через промпт 1. Получите независимую сумму и построчную таблицу.
Шаг 3. Сравните два итога. Ваш файл и слепой пересчёт. Если расхождение меньше 0,1% и объясняется округлением копеек, расчёт можно считать согласованным. Если больше, идёте к шагу 4.
Шаг 4. Проверьте три блока по отдельности. Дни (промпт 3), средний заработок (промпт 2), взносы (промпт 4). Ошибка покажет себя в одном из трёх, а не размажется по общей сумме. Для быстрой локализации используйте промпт 7 с топ-10 строк расхождения.
Шаг 5. Зафиксируйте результат. Причину каждого расхождения запишите в заметку: что нашли, чья это ошибка (файл, методология, модель), что исправили. Через месяц эта заметка станет картой типовых ошибок именно вашей компании, и проверка будет занимать ещё меньше времени.
Если вы работаете с нейросетью только начинаете и хотите понять общую картину, я разбирала системные ошибки работы с нейросетями в статье 5 ошибок финансиста в нейросетях, там же есть универсальный каркас промпта, который подходит к любой задаче.
Как обезличить данные и что можно загружать в ChatGPT
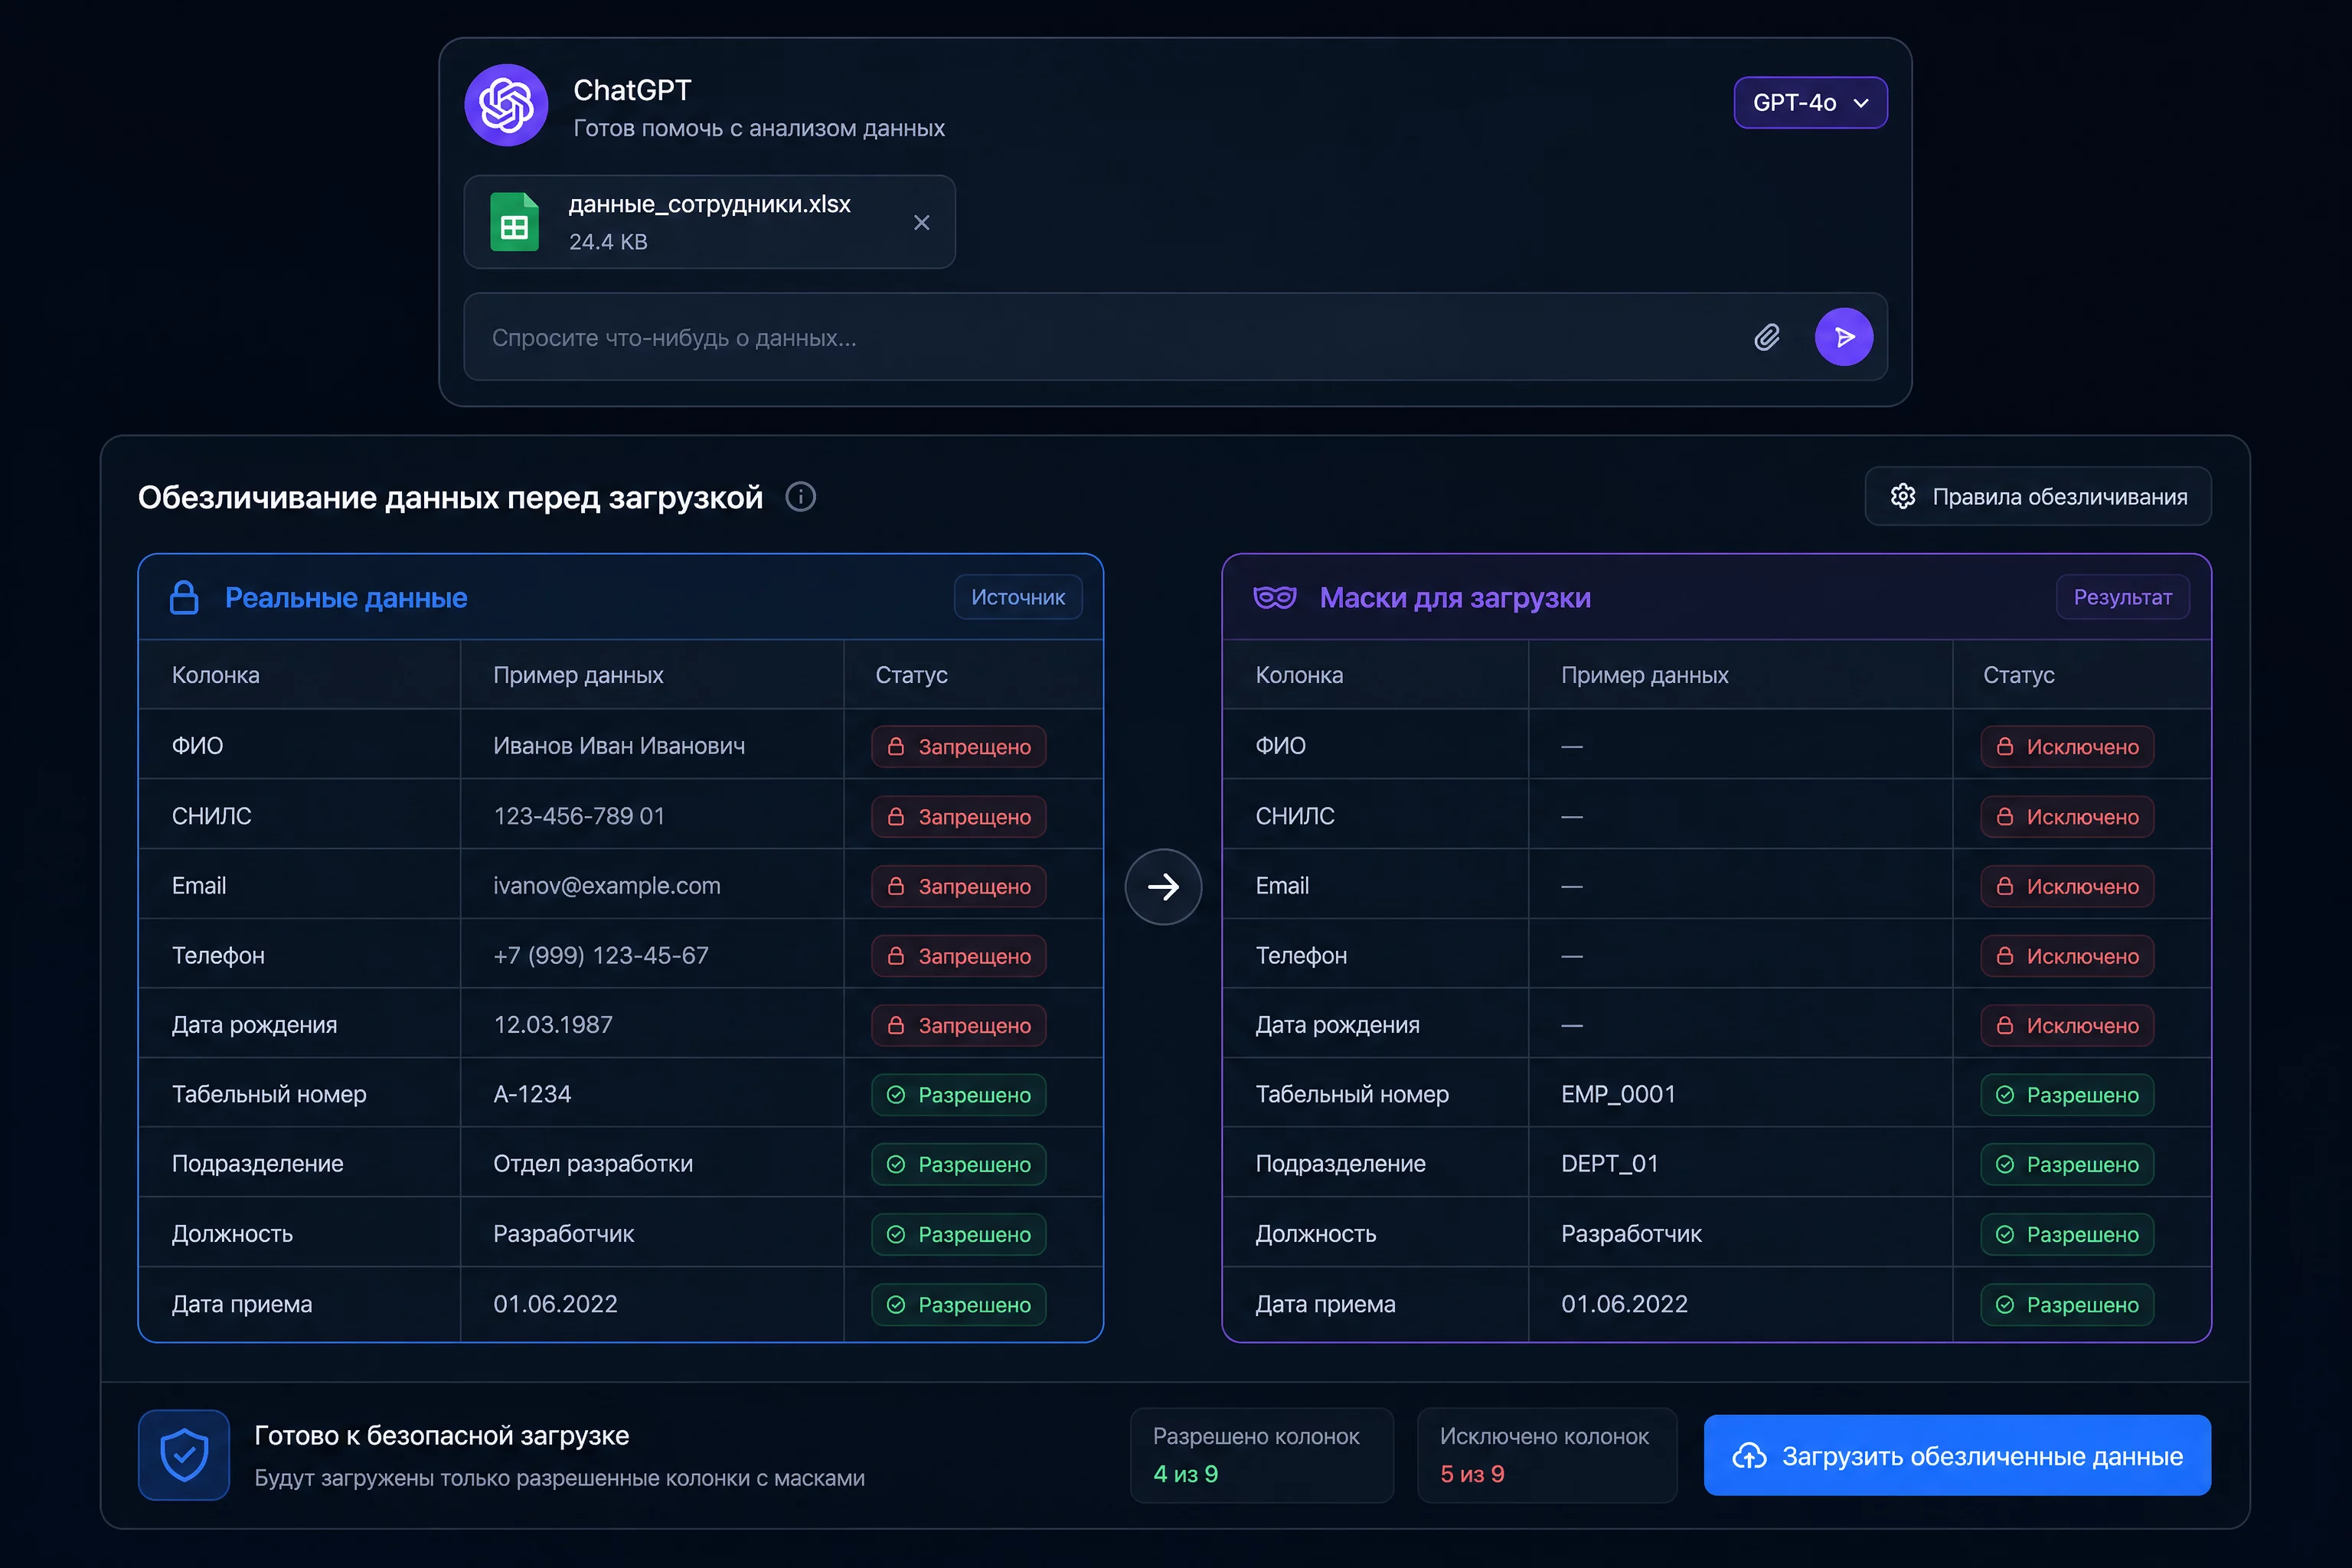
Перед загрузкой данных по зарплате и отпускам в публичную нейросеть нужно решить, что грузить можно, а что нельзя. Звучит как формальность, но на практике это вопрос юридической безопасности, а не предпочтений.
Для проверки резерва достаточно четырёх колонок: номер сотрудника, подразделение, неиспользованные дни, заработок за период. ФИО не нужно вообще, для расчёта логики они ничего не дают. Пример справочника замен:
| Что есть в данных | Что грузим в ChatGPT |
|---|---|
| Иванова Анна Петровна | Сотрудник 001 |
| Отдел продаж, цех № 2 | Подразделение 1, Подразделение 2 |
| Оклад 95 000 рублей | Заработок 95 000 |
| СНИЛС, паспорт, ИНН | Не грузим вообще |
| Номер банковской карты | Не грузим вообще |
| Комментарии о сотруднике из кадровой системы | Удаляем |
Правило простое: если колонка не участвует в расчёте, она не должна попадать в файл для нейросети. Номера хватает для обратной сверки с вашим файлом, а после проверки вы возвращаете номера к ФИО в своей таблице по тому же справочнику.
Отдельно про чувствительность. Зарплатные данные относятся к персональным данным, поэтому соблюдайте четыре правила:
- В настройках ChatGPT отключите использование данных для обучения модели, соответствующая опция есть в разделе приватности.
- Не загружайте сканы приказов на отпуск, больничные и документы с подписями, в них слишком много лишнего и они не нужны для расчёта.
- Для компаний с высокими требованиями к конфиденциальности используйте корпоративный тариф, где данные по умолчанию не используются для обучения.
- Если компания работает с гостайной или банковской тайной, публичные нейросети не подходят в принципе, рассматривайте корпоративные решения или локальные модели.
Обезличивание занимает 10-15 минут на файл в 100-200 строк: добавляете колонку с номерами, удаляете лишнее, прогоняете проверку. После ответа модели возвращаете номера к реальным сотрудникам по той же таблице соответствия. Подробный шаблон правил работы с данными, включая случаи с NDA, я собрала в статье про AI-политику финансового отдела.
Типичные ошибки при внедрении проверки через ChatGPT
Самый честный раздел статьи: как люди обычно ломают то, что должно работать. Все ошибки ниже я видела в реальных внедрениях.
Ошибка 1. Проверка и расчёт в одном чате. Бухгалтер загружает файл, просит пересчитать, потом «проверь ещё раз» и получает подтверждение собственного расчёта. Это ловушка самопроверки из раздела выше. Лечение одно: два разных чата.
Ошибка 2. Отсутствие требования считать в коде. Без фразы «считай в коде на Python» модель оценивает таблицу на глаз и незаметно врёт в арифметике. Это самое дешёвое и самое эффективное улучшение промпта.
Ошибка 3. Проверка без методологии. Модели дали файл, но не сказали, какой метод закреплён в учётной политике. Модель применила метод интервалов, получила другую сумму и «нашла ошибку» там, где её нет. Методологию нужно передавать явно, как в промпте 1.
Ошибка 4. Доверие первому ответу. Получили «расчёт верный» и успокоились. Из трёх кейсов выше в двух именно такой сценарий чуть не увёл ошибку в отчётность. Первый ответ модели это гипотеза, а не заключение, до тех пор, пока не выполнен слепой пересчёт.
Ошибка 5. Загрузка чувствительных данных без обезличивания. ФИО, СНИЛС, оклады в открытом виде в публичной нейросети. Для проверки логики расчёта достаточно номеров и сумм. Правила работы с данными я разбирала в статье про AI-политику финансового отдела, там есть готовый шаблон, что можно загружать и что нельзя.
Ошибка 6. Исправление файла на основе ответа модели без разбора. Модель показала расхождение, бухгалтер «поправил» цифру в файле, не поняв причину. Через месяц ошибка вернулась, потому что причина была в смещении формул, а не в конкретном значении. Любое исправление должно начинаться с причины, а не с цифры.
Что остаётся за человеком: границы доверия
Нейросеть находит расхождения, показывает пункты методологии и объясняет причины. Но финальное решение всегда остаётся за главбухом, и это не формальность. Есть зоны, где модель объективно не может решать.
Выбор методологии. Компания может применять балансовый метод или метод интервалов, и это решение закреплено в учётной политике. Модель может посчитать по любому методу, но выбрать за компанию она не вправе, и это решение человека.
Оценка существенности. Расхождение на 0,1% для одной компании это копейки, для другой существенная корректировка. Существенность определяется внутренними стандартами и здравым смыслом, а не математикой модели.
Спорные случаи в данных. Сотрудник в отпуске без сохранения содержания, частичная занятость, длительный больничный: формальные правила для таких случаев есть, но их применение к конкретному человеку требует суждения и знания кадровой истории.
Нормативка. Модель может ссылаться на устаревшие нормы или перепутать коэффициенты. Любую норму из ответа модели проверяйте в первоисточнике: КонсультантПлюс, Гарант, официальные документы. Модель в 2026 году отличный помощник, но не замена правовой базы.
Ответственность. Подпись под отчётностью ставит человек, и отвечает за неё тоже человек. Нейросеть не несёт ответственности за цифры, которые она помогла проверить. Это стоит помнить, когда кажется, что «модель подтвердила, значит, можно сдавать».
Перед тем как подписать отчётность с проверенным резервом, задайте себе пять вопросов:
- Я могу объяснить причину каждого расхождения между файлом и пересчётом? Если нет, проверка не закончена, расхождение «на округление» это не объяснение.
- Методология в промпте совпадает с учётной политикой компании? Модель должна посчитать ровно тем методом, который закреплён в политике.
- Нормы из ответа модели проверены в первоисточнике? Ставки взносов, коэффициент 29,3, сроки, ссылки на ПБУ 8/2010.
- Все ли три блока проверены отдельно: дни, средний заработок, взносы? Совпадающий итог не заменяет проверку блоков.
- Данные были обезличены до загрузки и возвращены после? В чате не осталось лишней информации о сотрудниках.
Пять «да» на эти вопросы и есть финальная граница доверия. Модель сделала пересчёт и нашла расхождения, вы проверили её логику и приняли решение. Так выглядит ответственность в связке человек плюс нейросеть в 2026 году.
Ровно та же логика работает в более широком контуре внутреннего аудита через ChatGPT: нейросеть усиливает человека, а не заменяет его. Она берёт на себя механический пересчёт и поиск аномалий, а суждения и решения остаются за специалистом.
Заключение: связка Excel и ChatGPT вместо спора, что лучше
Вернёмся к вопросу из заголовка: где нейросеть ошибается чаще. Короткий ответ: нейросеть ошибается в контексте, а не в арифметике, если промпт требует счёта в коде. Она путает 29,3 и 29,4, забывает страховые взносы, применяет чужую методологию и, главное, подтверждает собственные ошибки при самопроверке.
Но тот же ChatGPT отлично ловит ошибки Excel, которые живут в файлах годами: смещённые формулы, жёстко прописанные значения, устаревшие ставки, пропущенные строки. Ошибки двух инструментов почти не пересекаются, и это делает связку «Excel хранит, нейросеть проверяет» такой эффективной.
Ключевое правило, которое стоит вынести из статьи: расчёт и проверка это два разных чата. Слепой пересчёт с нуля по исходным данным, отдельная проверка каждого из трёх блоков и разбор расхождений по топ-строкам, вот весь процесс. На штат до 100 человек он занимает около часа вместо нескольких часов ручной сверки, в моей практике порядок цифр обычно именно такой.
Начните с малого: возьмите последний расчёт резерва, подготовьте данные, запустите слепой пересчёт по промпту 1 и сравните с файлом. Даже если расхождение окажется нулевым, вы получите документированную методологию и независимую проверку, которую можно показать аудитору. А если расхождение найдётся, вы только что нашли деньги, которые уходили молча.
Если хотите разобраться глубже, не только с резервом, а со всей картой задач, которые нейросети закрывают в работе финансиста и бухгалтера, подписывайтесь на наши каналы:
- @findir_pro, 45 000 подписчиков, основной канал школы «Финансовый директор | Мастер CFO»
- «АИ с Софьей и Натали», 13 000 подписчиков, канал про нейросети для финансистов
- MAX, 5 000+ подписчиков, актуальные новости и практика применения AI в финансах
800+ выпускников курса «AI-навыки финансиста» уже внедрили такие сценарии проверки в свою ежедневную работу. Следующий расчёт резерва можно проверить по-новому уже в этом месяце.
Частозадаваемые вопросы
Смотрите блок FAQ в начале статьи: там собраны ответы про формулу резерва, типовые ошибки нейросети, безопасность данных, выбор модели и границы доверия. Если ваш вопрос не нашёлся, напишите в комментарии или в наш канал, разберу отдельно.